
Resumen
Gemini 4 Argon no está incluido en el nivel gratuito de la Gemini API, y una suscripción a Google AI Pro por sí sola no proporciona acceso al API de Argon. Google AI Ultra puede ofrecer acceso a través de productos Gemini seleccionados, mientras que el uso de la API de pago se factura por separado. CometAPI ofrece una ruta de API independiente sin exigir que cada usuario final tenga una suscripción a Google AI Pro o Ultra. Sus tarifas publicadas sin caché para entrada y salida son de $1.60 y $8 por millón de tokens, en comparación con las tarifas Estándar introductorias de Google de $2 y $10.
Acceso y tarifas principales del proveedor verificadas el 16 de octubre de 2026.
Conclusiones clave
- Precio introductorio: $2 / 1M tokens de entrada y $10 / 1M tokens de salida; a partir del 1 de diciembre, las tarifas se duplican.
- Entrada en caché: descuento del 95% por caché implícita en aciertos elegibles; el mínimo de caché es de 4,096 tokens de prompt.
- La facturación de salida incluye tokens de razonamiento; entrada, razonamiento y salida visible comparten un presupuesto de 1,048,576 tokens.
- Separe las suscripciones de la app de Gemini de los derechos de Antigravity y del acceso al API de pago. La ausencia de un modelo en un producto no demuestra que todas las rutas de acceso estén indisponibles.
- CometAPI proporciona una ruta de API independiente con tarifas publicadas de entrada y salida sin caché más bajas. Las aplicaciones pueden atender a varios usuarios finales con una sola cuenta de CometAPI sin exigir que cada usuario mantenga una suscripción a Google AI Pro o Ultra; siguen aplicando límites de cuota, saldo, tarifa y concurrencia a nivel de cuenta.
¿Cuáles son los límites actuales de acceso a Gemini 4 Argon de Google?
La primera decisión es dónde necesita Argon: una app interactiva, un entorno local de programación o una integración de API. El anuncio de acceso para desarrolladores de Google diferencia el acceso de pago a la Gemini API del acceso para suscriptores Ultra en AI Studio y Antigravity. No interprete una restricción de suscripción de Antigravity como un requisito de comprar Ultra para cada flujo de trabajo de API de pago.
Para una aplicación de API, CometAPI proporciona una ruta alternativa de cuenta y facturación. Esto puede ser útil cuando desea evaluar Argon junto con otros modelos sin comprar una suscripción de consumidor de Google para ese fin. No cambia los derechos de acceso dentro de las apps de Google y no debe describirse como uso ilimitado.
¿Cuánto cuesta la API de Gemini 4 Argon?
Las tarifas Estándar de Gemini 4 Argon de Google aplican hasta el 30 de noviembre de 2026, con tarifas más altas a partir del 1 de diciembre. Todos los montos a continuación son USD por millón de tokens salvo que se indique lo contrario. Batch, Flex y Priority tienen tarifas separadas.
| Categoría de facturación (USD / 1M tokens) | Estándar de Google: hasta 30 nov 2026 | Estándar de Google: desde 1 dic 2026 | API de Gemini 4 Argon en CometAPI |
|---|---|---|---|
| Entrada | $2.00 | $4.00 | $1.60 |
| Entrada en caché | $0.10 | $0.20 | $0.16 |
| Salida, incluido el razonamiento | $10.00 | $20.00 | $8.00 |
Las tarifas de CometAPI se verificaron el 14 de octubre de 2026. Sus precios publicados de entrada y salida están un 20% por debajo de las tarifas Estándar introductorias de Google. La cifra de entrada en caché proviene de la calculadora de costos de CometAPI; confirme la tarifa activa de la cuenta y la elegibilidad de caché antes de basarse en ella. El cambio de precios de Google en diciembre no determina las tarifas futuras de CometAPI; verifique las tarifas que se muestran en su cuenta de CometAPI al presupuestar.
A estas tarifas, 200,000 tokens de entrada sin caché más 60,000 tokens de salida facturables cuestan $0.80 a través de CometAPI, en comparación con $1.00 a través de Google durante el período introductorio. Este ejemplo calculado excluye herramientas y reintentos.
¿Cuánto cuesta Gemini 4 Argon en cargas de trabajo realistas?
Los siguientes escenarios son ejemplos calculados, no uso medido del modelo. La entrada no está en caché; la salida incluye tanto razonamiento como texto visible. Una solicitud de agente de programación con 200,000 tokens de entrada y 60,000 tokens de salida facturables cuesta $1.00 durante el período introductorio y $2.00 después. La misma carga repetida 1,000 veces cuesta $1,000 o $2,000 antes de reintentos, herramientas e impuestos.
| Solicitud de ejemplo | Tokens de entrada sin caché | Tokens de salida facturables | Precio intro | Precio estándar |
|---|---|---|---|---|
| Respuesta breve asistente | 5K | 1K | $0.02 | $0.04 |
| Análisis de documentos | 100K | 10K | $0.30 | $0.60 |
| Agente de programación complejo | 200K | 60K | $1.00 | $2.00 |
| Flujo de investigación | 500K | 100K | $2.00 | $4.00 |
| Solicitud de decodificación larga | 100K | 500K | $5.20 | $10.40 |
Fórmula: Cost = (tokens de entrada sin caché × tarifa de entrada + tokens de entrada en caché × tarifa de caché + tokens de salida facturables × tarifa de salida) / 1,000,000. Los ejemplos anteriores son ilustrativos y suponen ausencia de caché.
¿Cómo puede reducir los costos de la API de Gemini 4 Argon?
Caché implícita y prefijos de prompt reutilizados
La caché reduce el gasto de entrada reutilizada, no el precio total de la solicitud. Para el ejemplo de 200K de entrada / 60K de salida, un acierto completo de caché de entrada elegible reduce el costo introductorio de entrada de $0.40 a $0.02. El costo total por tokens se vuelve $0.62 en lugar de $1.00: una reducción del 38%, aunque el descuento de entrada sea del 95%. Si el 50% de los tokens de entrada provienen de caché, la misma solicitud cuesta $0.81: 100,000 tokens de entrada en caché × $0.10 / 1M + 100,000 tokens de entrada sin caché × $2 / 1M + 60,000 tokens de salida facturables × $10 / 1M = $0.01 + $0.20 + $0.60. Aquí, 50% se refiere específicamente al volumen de tokens de entrada. Trátelos como escenarios y use el uso observado de tokens en caché para la previsión.
Google habilita la caché implícita para prompts de al menos 4,096 tokens y no admite la creación de caché explícita para Argon. Preserve prefijos de prompt reutilizables, pero presupueste la entrada sin caché hasta que los aciertos observados justifiquen una estimación menor.
Niveles de razonamiento y gasto de salida
Una respuesta visible breve aún puede conllevar un costo de salida sustancial porque el razonamiento es facturable. Comience con razonamiento medio, luego pruebe niveles inferiores y superiores en tareas representativas. Controle tanto la calidad como el uso total de salida; elija el nivel de razonamiento más bajo que cumpla sus criterios de aceptación.
Dado que razonamiento y salida visible comparten el límite de respuesta, un valor bajo de max_output_tokens puede dejar espacio insuficiente para la respuesta final. Compare la finalización exitosa de tareas en cada nivel de razonamiento antes de reducir el tope de salida.
Controles operativos para los costos de Gemini 4 Argon
- Use límites de salida realistas y evite generaciones innecesariamente largas.
- Reutilice prefijos de prompt compartidos cuando sean elegibles para caché implícita.
- Envíe tareas sencillas a modelos menos costosos, reservando Argon para los casos difíciles.
- Registre tokens facturables totales, fallos, reintentos y costo por tarea exitosa.
- Evalúe la economía a tarifas pospromocionales antes de comprometer un despliegue grande.
¿Cómo puede acceder a Gemini 4 Argon?
Elija acceso a la app de Gemini para trabajo interactivo personal y una ruta de API de pago para aplicaciones y agentes automatizados. Argon está excluido del nivel gratuito de la Gemini API; una suscripción a Google AI Pro por sí sola no otorga acceso a la API de Argon. Los derechos de las apps Pro y Ultra son independientes de la facturación por tokens de la API, y Ultra no es necesario para la API de pago de Gemini.
| Ruta de acceso | Acceso a Argon | Facturación / derechos |
|---|---|---|
| App de Gemini | Suscriptores Pro y Ultra elegibles | Suscripción y límites de la app |
| Google AI Studio | Suscriptores Ultra elegibles o usuarios de API de pago | Depende de la ruta de acceso |
| Gemini API | Proyectos de pago elegibles | Facturación de API basada en uso |
| Google Antigravity | Suscriptores Ultra elegibles | Derechos específicos del producto |
| CometAPI | Cuentas de CometAPI compatibles | Tarifas y condiciones de CometAPI |
Integración directa con la API de Gemini 4 Argon
Los desarrolladores pueden integrar Gemini 4 Argon directamente a través de un proyecto elegible de la Gemini API de pago. El ID del modelo es gemini-4-argon. Esta ruta está pensada para aplicaciones, agentes automatizados y flujos de trabajo de producción que requieren acceso directo a la API de Google, facturación basada en uso y funciones oficiales del API.
El nivel gratuito de la Gemini API no incluye Argon. El acceso a la app de Google AI Pro tampoco proporciona automáticamente acceso al API ni créditos de API. Los desarrolladores deben configurar la facturación y la elegibilidad para el proyecto asociado con sus credenciales de API.
Los errores de autenticación, facturación o elegibilidad deben resolverse para el proyecto que posee la clave antes de reintentar; cambiar solo una suscripción de consumidor no configura la facturación del API.
Acceso mediante CometAPI para Gemini 4 Argon
Los desarrolladores pueden acceder a la API de Gemini 4 Argon en CometAPI a través de una cuenta y una clave de API separadas. Las ventajas prácticas son la facturación de API independiente, el acceso a varios modelos a través de un proveedor y las tarifas de entrada/salida publicadas comparadas arriba. Esta ruta no requiere comprar Google AI Pro o Ultra como suscripción de consumidor.
El acceso basado en cuenta no es una promesa de capacidad sin restricciones. Confirme la disponibilidad del modelo, el saldo, los límites de tarifa y concurrencia, las regiones compatibles, la caché, los controles de razonamiento y los informes de uso para su cuenta de CometAPI. El acceso a la API tampoco desbloquea Argon dentro de la app de Gemini o Antigravity.
Comience con una solicitud pequeña a través del proveedor elegido, verifique los campos de modelo y uso devueltos y, luego, establezca un límite de gasto antes de aumentar el tráfico.
¿Vale la pena el costo de Gemini 4 Argon?
Gemini 4 Argon es un candidato para tareas exigentes de razonamiento, programación, investigación y contexto largo. Su valor depende de si mejora la finalización exitosa de tareas o reduce los reintentos lo suficiente como para justificar el gasto de tokens. Use las especificaciones y los benchmarks publicados a continuación para identificar cargas de trabajo a probar, luego evalúe calidad y costo con sus propios prompts, herramientas y ruta de acceso.
Especificaciones de Gemini 4 Argon
| Especificación | Gemini 4 Argon |
|---|---|
| ID del modelo | gemini-4-argon |
| Desarrollador | Google DeepMind |
| Tipo de modelo | Modelo multimodal orientado al razonamiento |
| Ventana unificada de entrada + razonamiento + salida | Hasta 1,048,576 tokens combinados |
| Niveles de razonamiento | Bajo / medio / alto |
| Nivel de razonamiento predeterminado | Medio |
| Compatibilidad con salidas largas | Ejecución en segundo plano; el máximo está sujeto al presupuesto compartido |
| Caché de contexto | Implícita; prompts elegibles ≥ 4,096 tokens |
| Caché explícita | No compatible |
El límite de un millón de tokens se comparte entre entrada, razonamiento y salida generada. En la Interactions API, generar más de 65,536 tokens requiere tanto background=True como generation_config.max_output_tokens por encima de 65,536. Establecer background=True por sí solo no eleva el límite de salida predeterminado. La GenerateContent API también admite continuación del lado del cliente para decodificaciones largas
Gemini 4 Argon vs GPT-6 Astra vs Claude Opus 5.5: benchmarks publicados
Los siguientes valores coinciden con los resultados de evaluación publicados por Google. Son resultados publicados por el proveedor, compilados de múltiples fuentes de evaluación, en lugar de una nueva comparación controlada realizada para este artículo.
| Benchmark publicado | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 |
|---|---|---|---|
| Vals Index | 68.9% | 63.1% | 67.0% |
| AutomationBench | 51.3% | 41.4% | 42.5% |
| Vals Finance Agent v2 | 65.4% | 53.5% | 58.6% |
| DeepSWE v1.1 | 77.9% | 74.1% | 74.2% |
| FrontierSWE v2 | 55.0% | 65.5% | 62.3% |
| Terminal-bench 4.0 | 57.4% | 58.2% | 66.4% |
| GraphWalks 256K–1M, BFS F1 | 84.2% | 71.8% | 66.8% |
| LVBench | 91.7% | 87.5% | 83.7% |
Condiciones de evaluación y comparabilidad
La metodología de evaluación de Google usa la Gemini API en el ajuste de razonamiento más alto salvo que se especifique lo contrario, generalmente con pass@1. DeepSWE usa mini-swe para Argon; las cifras de la competencia provienen de tablas de clasificación o system cards. GraphWalks 256K–1M usa 200 problemas. LVBench se ejecuta sin herramientas, con 1 FPS para Gemini, 800 fotogramas para GPT-6 Astra y 600 para Opus 5.5. Los resultados de Vals provienen de Vals AI; AutomationBench usa la tabla de clasificación de conjunto privado de Zapier. Estas diferencias limitan la comparabilidad directa.
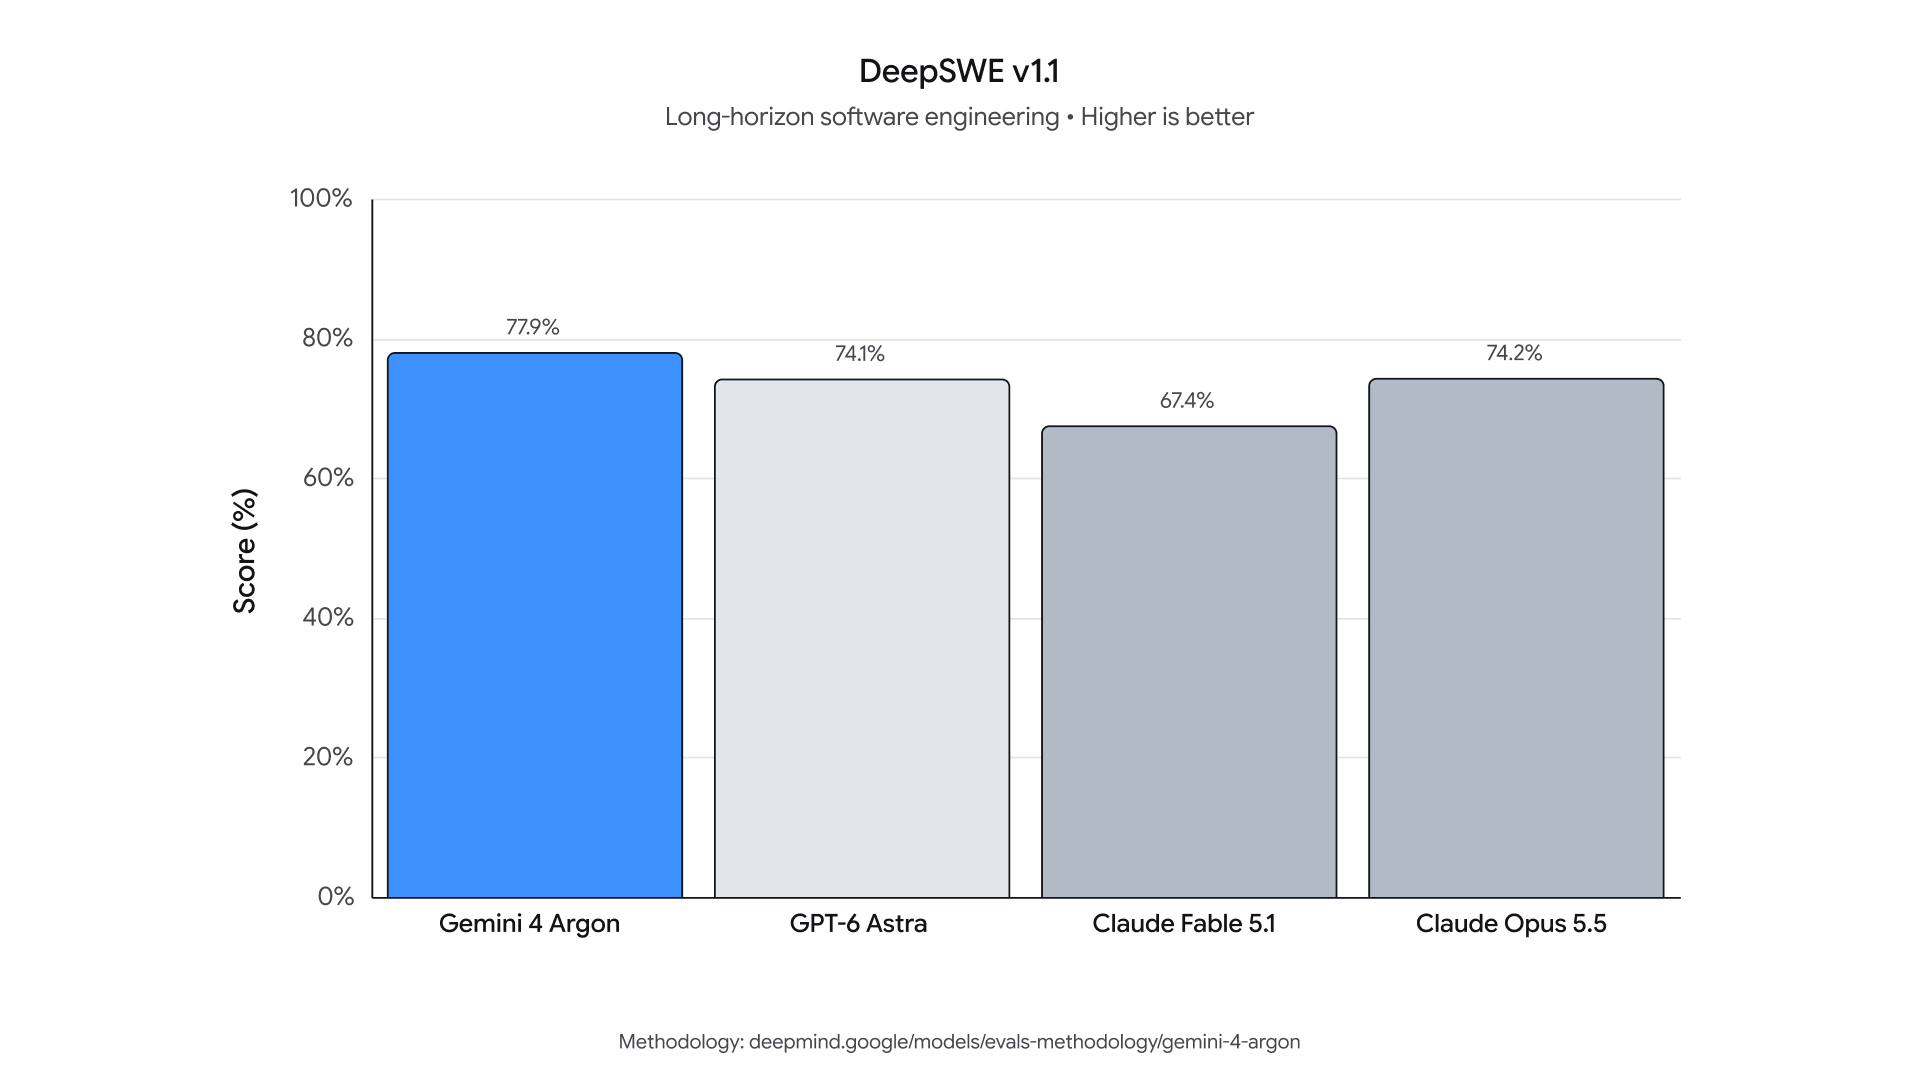
El gráfico oficial de DeepSWE v1.1 de Google muestra, de izquierda a derecha, Gemini 4 Argon (77.9%), GPT-6 Astra (74.1%), Claude Fable 5.1 (67.4%) y Claude Opus 5.5 (74.2%). La tabla anterior selecciona tres de estos modelos; la imagen oficial incluye los cuatro.
Implicaciones de rendimiento para los usuarios de Gemini 4 Argon
Interpretación: Argon lidera en las filas seleccionadas de Vals Index, AutomationBench, agente financiero y contexto largo; no lidera en FrontierSWE ni en Terminal-bench. Dado que los arneses de evaluación y los prompts pueden variar, use estos resultados como evidencia direccional y ejecute pruebas específicas de su carga de trabajo.
Para adquisiciones, mida el costo de una tarea exitosa junto con precisión, latencia, reintentos y uso de tokens. Un puntaje publicado más alto no establece un costo de producción más bajo bajo sus prompts, herramientas o ruta de acceso.
Elegir Gemini 4 Argon o un modelo más económico
Pruebe Argon en tareas difíciles de razonamiento, programación y contexto largo donde menos reintentos o una mayor tasa de finalización puedan justificar un mayor gasto de tokens. Para clasificación rutinaria, extracción y resumen de alto volumen, pruebe primero modelos de menor costo.
Compare el costo total por tarea exitosa, incluidos tokens de razonamiento, uso de caché, llamadas a herramientas y reintentos. Elija el modelo y la ruta de acceso que cumplan sus requisitos de calidad a un costo aceptable.
Preguntas frecuentes
¿Son Gemini 4 Argon Batch y Flex más baratos que Standard?
Las tarifas de tokens de Argon Batch y Flex de Google son $1 de entrada y $5 de salida por millón de tokens hasta el 30 de noviembre de 2026, aumentando a $2 y $10 después. La entrada en caché es $0.05, aumentando a $0.10. Estas son opciones de procesamiento separadas, así que valide sus restricciones operativas frente a su carga de trabajo antes de reemplazar una integración Standard.
Estime el uso de Standard, Batch y Flex por separado utilizando las tarifas aplicables de cada opción, luego sume los subtotales para un presupuesto de carga de trabajo mixta.
¿Las estimaciones de tokens de Gemini 4 Argon incluyen cargos de búsqueda?
No. La aritmética de tokens por sí sola excluye servicios facturados por separado. El cargo por Search grounding de Google es de $14 por 1,000 consultas tras la asignación mensual compartida de 5,000 solicitudes para modelos Gemini 3 y posteriores. Una solicitud enviada puede emitir más de una consulta de búsqueda, así que controle el uso real de grounding por separado en lugar de asumir que un prompt de usuario equivale a una consulta facturable.
¿Cómo debo presupuestar Gemini 4 Argon a través del cambio de precio?
Divida el uso previsto de tokens en los períodos introductorio y estándar, luego aplique las tarifas de cada período. Por ejemplo, 10 millones de tokens de entrada sin caché más 1 millón de tokens de salida cuestan $30 con tarifas Estándar introductorias o $60 después. Si la mitad de ese volumen cae en cada período, la estimación por tokens es $45. Agregue herramientas y costos de reintentos por separado, y use las tarifas pospromoción para un presupuesto en estado estable.
¿Por qué una respuesta de Gemini 4 Argon puede detenerse antes de completarse?
El tope de salida incluye tanto el razonamiento como el texto visible. Un prompt exigente puede agotar esa asignación antes de que la respuesta final esté completa. Para respuestas largas, la ejecución en segundo plano continúa la generación en saltos hasta la finalización o el límite configurado; aún necesita un valor adecuado de max_output_tokens. Verifique el estado de finalización y el uso y luego ajuste la profundidad de razonamiento o el tope en lugar de enviar repetidamente la misma solicitud con presupuesto insuficiente.
Conclusión
Elija el acceso a Gemini 4 Argon según el flujo de trabajo y luego compare el costo de completar una tarea útil. Los derechos de la app de Google y de Antigravity difieren del acceso a la API de pago. CometAPI ofrece una ruta de API separada con precios de entrada/salida publicados un 20% por debajo de las tarifas Estándar introductorias de Google, lo que la convierte en una opción práctica para una evaluación pequeña y presupuestada. Valide los límites de la cuenta y las funciones necesarias, controle los tokens de razonamiento y los reintentos, y escale solo cuando la calidad y el costo total cumplan sus necesidades.