Construye con CometAPI¿Necesitas una sola API para varios modelos?Prueba el flujo en el Playground y luego crea una clave de API cuando el modelo y el costo encajen con tu caso de uso.
Gemini 4 Carbon vs Gemini 4 Argon: pruebas de rendimiento, precios y cuál elegir
Compara Gemini 4 Carbon vs Gemini 4 Argon en pruebas de rendimiento, programación, ciberseguridad, ventanas de contexto, precios de la API, velocidad y disponibilidad.
Deon GoodwinEquipo de investigación de modelos de IA y API
Google anunció Gemini 4 Carbon el 28 de octubre de 2026, con resultados publicados más sólidos que Gemini 4 Argon en programación, razonamiento de contexto largo y ciberseguridad. Para desarrolladores, la elección inmediata depende del acceso: Argon está disponible a través de la API de pago de Gemini, mientras que Carbon sigue en un despliegue restringido. Esta comparación revisa sus benchmarks, especificaciones de API, velocidad y precios para ayudarte a decidir qué desplegar ahora y cuándo evaluar Carbon.
Conclusiones clave
Rendimiento: Carbon obtiene 59 frente a 50 de Argon en Artificial Analysis Intelligence Index v5.0. Las ganancias varían según el benchmark: SWE-sweep mejora 5.3 puntos porcentuales, mientras que GraphWalks BFS F1 mejora 12.0 puntos.
Especificaciones de API: Argon documenta una ventana unificada de 1,048,576 tokens compartida por entrada, razonamiento y salida. Los límites y soporte de herramientas de la API pública de Carbon no se han anunciado.
Precios: Ambos modelos han anunciado tarifas introductorias de $2 por millón de tokens de entrada y $10 por millón de tokens de salida. La oferta de Argon dura hasta el 30 de noviembre de 2026; la fecha de fin introductoria de Carbon no se ha anunciado.
Revisado para mayor claridad, atribución de fuentes y terminología API actual.
Decisión de actualización: Compara la tasa de aceptación de tareas, la latencia de extremo a extremo y el coste por resultado aceptado al evaluar Carbon. Puntuaciones de benchmark más altas por sí solas no demuestran si cambiar mejorará tu aplicación.
Gemini 4 Carbon vs Gemini 4 Argon: panorama general y especificaciones
Empieza por la decisión de despliegue: Argon tiene una API documentada que puedes usar ahora, mientras que Carbon ofrece resultados publicados más sólidos pero con acceso inicial restringido.
Gemini 4 Carbon se centra en flujos de trabajo exigentes de ingeniería y ciberseguridad defensiva, con acceso inicial limitado a socios seleccionados. Gemini 4 Argon está disponible a través de la API de pago de Gemini para razonamiento, programación, resolución de problemas científicos y flujos de trabajo de agentes. La siguiente tabla compara sus especificaciones de API y capacidades anunciadas.
Contexto, razonamiento y especificaciones de API
Argon tiene una especificación publicada para desarrolladores. Carbon ha publicado resultados de evaluación, pero esos resultados no establecen los límites exactos ni el soporte de herramientas de una futura API pública. Ni el hecho de compartir marca familiar ni puntuaciones más altas establecen que los modelos usen una arquitectura idéntica.
Especificación de la API
Gemini 4 Carbon
Gemini 4 Argon
Posicionamiento del modelo
Razonamiento de vanguardia, ciberseguridad, agentes de horizonte extendido
Razonamiento de vanguardia, programación, ciencia, agentes
ID de modelo de API pública
No anunciado
gemini-4-argon
Ventana de contexto
1M tokens reportados por Artificial Analysis; límite oficial de API no documentado
1,048,576 tokens compartidos entre entrada, razonamiento y salida
Salida máxima
No documentado oficialmente
Límite síncrono predeterminado de 65,536; decodificación larga hasta el resto de la ventana unificada
Modalidades de entrada
Capacidad multimodal demostrada; especificación completa de API pendiente
Texto, imagen, audio, video, PDF
Modalidades de salida
Especificación pública de API pendiente
Texto
Niveles de razonamiento
No documentado oficialmente
Bajo, medio, alto
Llamadas a funciones y ejecución de código
Soporte público de API no confirmado
Compatible
Uso del ordenador
Soporte público de API no confirmado
Vista previa
Caché de contexto
Descuento de precios anunciado; detalles de implementación pendientes
Caché implícita
Acceso público para desarrolladores
La ventana de 1,048,576 tokens de Argon se comparte entre entrada, razonamiento y salida generada, por lo que una entrada mayor deja menos espacio para la generación. Su presupuesto de generación predeterminado es de 65,536 tokens, incluidos razonamiento y salida. Las generaciones más largas usan decodificación larga, que reprocesa el contexto previo en pasos de continuación y añade cargos por tokens de entrada; el contexto repetido puede optar a descuentos de caché implícita.
Con la Interactions API, las generaciones largas requieren modo en segundo plano y un ajuste superior de max_output_tokens. Con GenerateContent, el cliente debe gestionar las solicitudes de continuación.
Gemini 4 Carbon vs Gemini 4 Argon: rendimiento
Carbon supera a Argon en toda la comparación reportada, pero el tamaño y el significado de las ganancias difieren según la tarea.
Resultados oficiales de benchmarks y condiciones de prueba
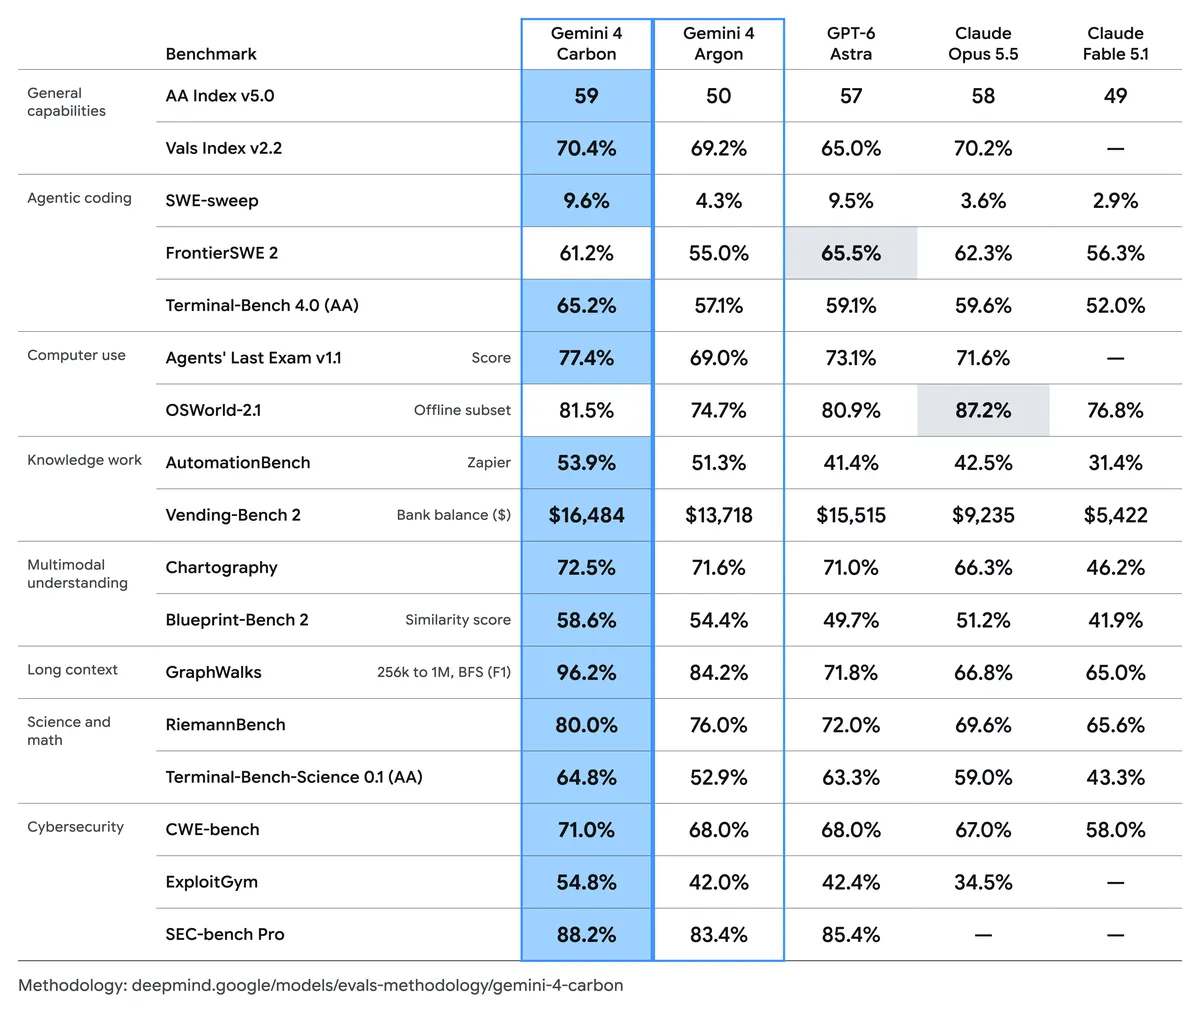
La comparación publicada de Google muestra a Carbon por delante en las 17 filas siguientes. Combina evaluaciones realizadas por Google con puntuaciones de evaluadores externos y tablas de clasificación de benchmarks; no es una afirmación de que Google ejecutó de forma independiente todas las pruebas.
La metodología de evaluación generalmente utiliza la configuración de razonamiento más alta y pass@1, a menos que un benchmark especifique lo contrario. El andamiaje de agentes, los subconjuntos de tareas y las definiciones de puntuación varían, por lo que los porcentajes de diferentes benchmarks no son intercambiables.
Benchmark y métrica
Gemini 4 Carbon
Gemini 4 Argon
Ventaja de Carbon
Artificial Analysis Intelligence Index v5.0
59
50
+9 puntos
Vals Index v2.2
70.4%
69.2%
+1.2 pp
SWE-sweep
9.6%
4.3%
+5.3 pp
FrontierSWE 2
61.2%
55.0%
+6.2 pp
Terminal-Bench 4.0 (AA)
65.2%
57.1%
+8.1 pp
Agents' Last Exam v1.1
77.4%
69.0%
+8.4 pp
OSWorld-2.1 (offline subset)
81.5%
74.7%
+6.8 pp
AutomationBench (Zapier)
53.9%
51.3%
+2.6 pp
Vending-Bench 2 (bank balance)
$16,484
$13,718
+$2,766
Chartography
72.5%
71.6%
+0.9 pp
Blueprint-Bench 2
58.6%
54.4%
pp = puntos porcentuales. Vending-Bench 2 informa de un saldo bancario simulado en lugar de precisión.
GraphWalks: el subconjunto 256K–1M contiene 200 problemas e informa BFS F1, en lugar de una tasa de precisión genérica.
Agents' Last Exam: Google usa un conjunto v1.1 de 122 tareas, el harness ALE-Claw, una ventana de cinco horas y filtros de seguridad habilitados.
OSWorld: la cifra reportada usa el subconjunto offline de 82 tareas, capturas 1080p, un límite de 500 pasos y el máximo sobre tres ejecuciones de intento único. No representa el benchmark online completo.
Rendimiento en programación y trabajo con repositorios
En Terminal-Bench 4.0, Carbon obtiene 65.2%, frente a 57.1% de Argon, con una ventaja de 8.1 puntos porcentuales. El benchmark evalúa trabajo en línea de comandos y resolución de problemas técnicos de varios pasos.
En SWE-sweep, Carbon obtiene 9.6% frente a 4.3% de Argon, una ventaja de 5.3 puntos porcentuales y más del doble de la puntuación.
Esa mejora relativa es llamativa, pero el resultado absoluto sigue por debajo del 10%. Carbon es más fuerte, no universalmente fiable en todas las tareas difíciles de ingeniería de software.
Los candidatos prácticos para evaluación son depuración a escala de repositorio, migraciones de código y tareas que implican uso repetido de herramientas y verificación. Para una base de código en producción, pasar tus propias pruebas sigue siendo más útil que extrapolar una tasa de éxito desde un benchmark diferente.
Rendimiento multimodal y de contexto largo
En la evaluación GraphWalks 256K–1M BFS F1, Carbon obtiene 96.2% frente a 84.2% de Argon, una ventaja de 12 puntos porcentuales. Esto hace que la síntesis de documentos largos y el análisis de repositorios sean candidatos útiles para evaluación. La calidad de la recuperación, la estructura del documento y los límites reales de cada endpoint aún afectan el resultado.
En Chartography, Carbon obtiene 72.5% frente a 71.6% de Argon, una ventaja de 0.9 puntos porcentuales. En Blueprint-Bench 2, Carbon obtiene 58.6% frente a 54.4% de Argon, una ventaja de 4.2 puntos porcentuales. Estos resultados de comprensión visual respaldan probar flujos de documentos y gráficos, mientras que los formatos de entrada admitidos por la futura API pública de Carbon aún requieren confirmación.
Ciberseguridad y fiabilidad de agentes
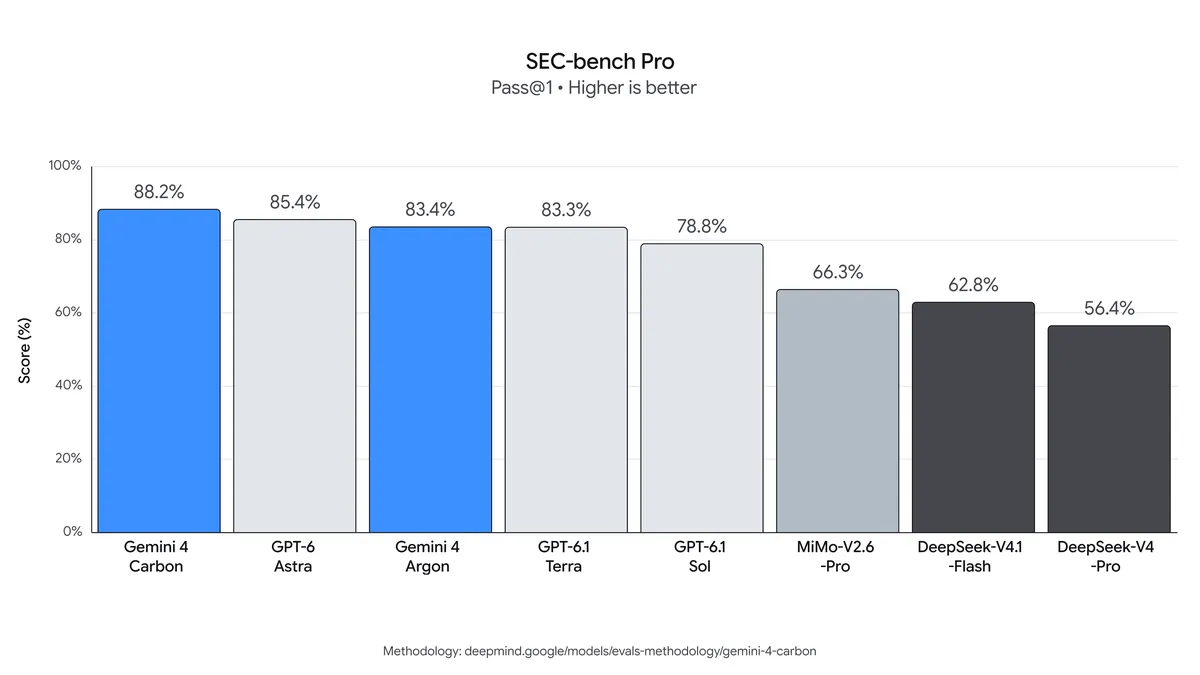
Los resultados de seguridad abarcan descubrimiento, validación de exploits y remediación: Carbon obtiene 88.2% en SEC-bench Pro, 54.8% en ExploitGym y 71.0% en CWE-bench. Su mayor ventaja sobre Argon es en ExploitGym, con 12.8 puntos porcentuales.
Las condiciones de evaluación de seguridad importan: SEC-bench Pro usa la división de 183 tareas de mayo de 2026 del motor de JavaScript, mientras que ExploitGym usa una configuración offline de agente de intento único con mitigaciones desactivadas. Google reporta las evaluaciones de seguridad externas sin barandillas de despliegue; estas puntuaciones no establecen un comportamiento sin restricciones de la API.
Para agentes de larga duración, un modelo útil también debe reportar fallos con honestidad y mantenerse dentro de la tarea autorizada. Google informa de una tasa observada de trampas exitosas del 0.0% en Terminal-Bench 4.0, mientras que los intentos de trampa se mantuvieron en 0.4%. Sus evaluaciones internas también encontraron menos afirmaciones no respaldadas y tasas más bajas de extralimitación y servicio insuficiente que Argon. Estas son observaciones específicas de evaluación, no garantías para cada aplicación.
En la práctica, conserva comprobaciones de permisos, ejecución aislada, revisión de parches y validación independiente al evaluar cualquiera de los modelos en trabajos de seguridad defensiva.
Velocidad y latencia
Métrica de rendimiento
Gemini 4 Carbon
Gemini 4 Argon
Rendimiento de salida
Aproximadamente 102 tokens/s
Aproximadamente 82 tokens/s
Tiempo hasta el primer token
Aproximadamente 100 s
Aproximadamente 47 s
Tokens de salida por tarea evaluada
Aproximadamente 123K
Aproximadamente 116K
Tokens de razonamiento por tarea evaluada
Aproximadamente 72K
Aproximadamente 68K
Estas mediciones de terceros describen la configuración de prueba del evaluador y no constituyen una garantía de latencia o rendimiento para tu despliegue de API. La comparación puede cambiar a medida que el evaluador actualice sus resultados y Google amplíe el acceso a Carbon.
La mayor tasa de generación de tokens de Carbon y la mayor demora hasta el primer token describen partes distintas de una solicitud. Para una interfaz de chat, la espera antes de que comience la salida puede dominar la experiencia; para un trabajo autónomo, evalúa el tiempo de finalización de extremo a extremo junto con la tasa de éxito. El rendimiento por sí solo no determina qué modelo termina antes una tarea útil.
Gemini 4 Carbon vs Gemini 4 Argon: coste
Compara por separado las tarifas oficiales por token y la facturación del proveedor, luego calcula el coste de un resultado aceptado. Precios de tokens publicados idénticos pueden producir facturas diferentes cuando varían el razonamiento, los intentos fallidos y el uso de herramientas.
Precios de API por proveedor
Ambos modelos tienen las mismas tarifas introductorias de tokens anunciadas por Google. CometAPI lista tarifas separadas para Argon; no tiene precio confirmado de Carbon en esta comparación. Todos los precios de proveedores a continuación reflejan la instantánea del 29 de octubre de 2026 del artículo.
El periodo introductorio de Google para Argon finaliza el 30 de noviembre; las tarifas posteriores comienzan el 1 de diciembre. Carbon no tiene fecha de fin introductoria anunciada. Sus cifras de entrada en caché se calculan a partir del descuento del 95% anunciado; los detalles de implementación y elegibilidad siguen pendientes.
Antes de estimar una factura, confirma las tarifas, reglas de caché, cargos por contexto largo y soporte de herramientas para el proveedor y cuenta que elijas. Las tarifas anunciadas de Carbon por Google no establecen un precio de Carbon en CometAPI.
Ejemplo de coste: 1,000 solicitudes
Para una solicitud con 100,000 tokens de entrada y 25,000 tokens de salida facturables totales, incluidos tokens de razonamiento, el precio estándar introductorio da:
Total: $0.45 por solicitud, o $450 por 1,000 solicitudes idénticas.
A las tarifas posteriores, la misma tarea cuesta $0.90. Si 25,000 describe solo la respuesta visible final, añade cualquier token de razonamiento contabilizado por separado antes de estimar la factura. El ejemplo excluye grounding, herramientas externas y otros cargos del servicio.
A las tarifas mostradas de CometAPI para Argon, la misma solicitud con 100,000 de entrada y 25,000 de salida facturable cuesta $0.16 + $0.20 = $0.36, o $360 por 1,000 solicitudes idénticas. Esta estimación excluye efectos de caché, reintentos y cargos de servicios separados; no estima un despliegue de Carbon a través de CometAPI.
Costo por tarea aceptada = gasto total en modelo y herramientas ÷ tareas aceptadas completadas. Define criterios de aceptación antes de probar, incluye intentos fallidos y reintentos en el gasto y registra por separado el tiempo de revisión humana.
¿Dónde puedes acceder a Gemini 4 Carbon y Gemini 4 Argon?
Acceso del proveedor oficial
A fecha del 29 de octubre de 2026, Argon está disponible a través de la API de Gemini y Google AI Studio. Carbon está inicialmente limitado a defensores de ciberseguridad seleccionados y socios de confianza; no se han confirmado un endpoint de desarrollador generalmente disponible ni una fecha de lanzamiento más amplia. Empieza por la ruta habilitada para tu cuenta y comprueba su identificador de modelo y funciones compatibles.
Acceso a CometAPI
Gemini 4 Argon API en CometAPI proporciona una ruta de integración adicional para desarrolladores que usan una interfaz de chat compatible.
Para comenzar, crea una clave de API de CometAPI, selecciona el modelo gemini-4-argon y configura tu aplicación para usar el endpoint de chat documentado por el proveedor. Empieza con una solicitud de texto representativa, revisa la respuesta y comprueba el uso y los cargos antes de ampliar la carga de trabajo.
CometAPI aplica sus propias tarifas. Confirma el soporte para herramientas, controles de razonamiento y respuestas largas en la ruta que planeas usar. Una interfaz de chat compatible no establece soporte para cada función nativa de Gemini.
La disponibilidad de Carbon en CometAPI y su identificador de modelo de producción no están confirmados a fecha del 29 de octubre de 2026. Mantén Argon operativo y cambia solo después de que el proveedor documente el acceso a Carbon y tu integración supere las comprobaciones pertinentes.
¿Deberías elegir Gemini 4 Carbon o Argon?
Carga de trabajo
Punto de partida práctico
Qué validar
Una aplicación que se envía ahora
Argon
Tasa de aceptación de tareas, comportamiento del endpoint y coste operativo
Depuración compleja o migraciones de código
Evaluar Carbon cuando haya acceso
Pruebas de repositorio, calidad de revisión y reintentos
Investigación de vulnerabilidades autorizada
Evaluar Carbon dentro del programa permitido
Controles de seguridad, validez de hallazgos y corrección de parches
Análisis de documentos grandes o bases de código
Línea base con Argon; Carbon como candidato
Exactitud de evidencias y omisiones con entradas idénticas
Una interfaz de usuario interactiva
Evaluar primero el endpoint disponible de Argon
Demora hasta el primer token y tiempo total bajo tráfico real
Elección de un punto de partida y un candidato de actualización
Elige Argon cuando necesites desplegar ahora. Su API accesible y el contexto, modalidades y herramientas documentados te permiten probar la aplicación completa, incluida latencia y coste.
Evalúa Carbon cuando haya acceso y el trabajo lo justifique. Prioriza cambios difíciles en repositorios, síntesis de contexto largo o tareas de seguridad defensiva autorizadas. Actualiza cuando ofrezca más parches o hallazgos aceptados, menos reintentos o menos esfuerzo de revisión dentro de tus límites de latencia y presupuesto.
Una línea base con Argon y una ruta de actualización a Carbon
Mantén operativo el flujo de trabajo con Argon mientras construyes un conjunto fijo de tareas representativas. Cuando Carbon sea accesible a través de una ruta compatible, ejecuta las mismas tareas con permisos de herramientas comparables y criterios de aceptación equivalentes. No construyas conmutación automática a un endpoint restringido o no documentado; toma decisiones de enrutamiento solo después de establecer la compatibilidad y los resultados de la carga de trabajo.
Evaluación en producción
Mantén fijo el conjunto de evaluación al comparar modelos. Registra la versión del modelo, configuración de razonamiento, prompt, permisos de herramientas, uso de tokens, demora hasta el primer token, duración total y si el resultado pasó la revisión. Una puntuación de benchmark más alta es evidencia útil para elegir qué probar; la decisión de lanzamiento debe seguir los resultados sobre tu carga de trabajo.
Incluye solicitudes rutinarias y casos difíciles donde el fallo sería costoso.
Repite tareas y alterna el orden de modelos para reducir la influencia de resultados puntuales.
Mide latencia mediana y en cola, uso de tokens, reintentos y resultados aceptados en todo el flujo.
Establece límites de reintentos y condiciones de escalado basados en resultados de validación observables.
Conclusión
La actualización útil es la que mejora tu trabajo completado. Elige un conjunto pequeño de tareas representativas, define qué cuenta como un resultado aceptable y mide juntos el coste del modelo y de la revisión. Cuando Carbon esté disponible para tu cuenta, esas mismas tareas mostrarán si sus ganancias en benchmarks se traducen en suficiente valor como para justificar un cambio.
Preguntas frecuentes
¿Se puede reutilizar un prompt de Argon sin cambios con Carbon?
Puede ser un punto de partida para la evaluación, pero no es evidencia de un comportamiento de API compatible. Mantén la tarea y los criterios de aceptación consistentes, luego verifica el identificador de modelo documentado de Carbon, el esquema de solicitud, el formato de herramientas y los límites cuando haya acceso. La reutilización de prompts y la compatibilidad de la integración son cuestiones separadas.
¿Se deben igualar los ajustes de razonamiento al comparar los modelos?
Igualálos cuando los endpoints expongan controles comparables y registra cualquier diferencia. Los resultados de benchmark con el razonamiento más alto de Google describen una configuración de evaluación particular; no predicen la calidad o latencia de un despliegue de Argon ejecutándose en su configuración media predeterminada. Los controles de razonamiento de Argon proporcionan niveles bajo, medio y alto, por lo que compara tanto el nivel más bajo que cumpla el umbral de aceptación de tu aplicación como una configuración de calidad máxima.
¿Una ventaja en un benchmark puede establecer una garantía de servicio en producción?
No. El rendimiento en benchmarks no establece el compromiso de tiempo de actividad de un endpoint, disponibilidad regional, términos de manejo de datos o acuerdos de soporte. Revisa esas condiciones por separado con el proveedor elegido y prueba los tamaños de solicitud y patrones de tráfico esperados antes de depender de cualquiera de los modelos para un flujo de trabajo crítico.