Construye con CometAPI¿Necesitas una sola API para varios modelos?Prueba el flujo en el Playground y luego crea una clave de API cuando el modelo y el costo encajen con tu caso de uso.
Capa gratuita de Gemini API 2026: modelos gratuitos, límites y guía de precios
Consulta qué modelos de la API de Gemini son gratuitos en 2026, comprende los límites de RPM, TPM y RPD, la configuración de Python y la orientación sobre facturación, y compara los precios de Google con los de CometAPI.
Deon GoodwinEquipo de investigación de modelos de IA y API
El nivel gratuito de la API de Gemini está disponible en octubre de 2026 para modelos seleccionados, incluidos Gemini 3.8 Flash, Gemini 3.6 Flash, Gemini 3.5 Flash-Lite y Gemini 3.1 Flash-Lite. Puedes empezar sin configurar la facturación, pero la cuota disponible para tu proyecto determina cuánto puedes ejecutar realmente.
Empieza con Gemini 3.8 Flash para experimentos exigentes de programación y razonamiento, o con un modelo Flash-Lite para extracción y clasificación rutinarias. Antes de usar datos reales de clientes, revisa los términos de datos aplicables. Si necesitas capacidad de pago, compara las tarifas nativas de Google con el acceso facturado por separado de CometAPI.
Puntos clave
Gemini 3.8 Flash es la opción Flash más reciente aquí cubierta, con entrada multimodal y esfuerzo de razonamiento ajustable.
Gemini 3.6 Flash sigue siendo una opción admitida para integraciones existentes; Gemini 3.5 Flash-Lite y Gemini 3.1 Flash-Lite están orientados a cargas más ligeras.
Gemini 4 Argon requiere acceso de API de pago. La disponibilidad gratuita en otro producto de Google no establece la elegibilidad gratuita para la API.
Revisado para mayor claridad, atribución de fuentes y terminología API actual.
Revisa las cuotas en AI Studio. La ventana de contexto de un modelo es diferente de la asignación de solicitudes y tokens de tu proyecto.
Compara las vías de acceso. La cuota gratuita de Google y los precios, créditos y límites de cuenta de CometAPI son independientes.
¿La API de Gemini es gratuita en 2026?
Google ofrece tokens de entrada y salida gratuitos para modelos seleccionados de la API de Gemini, sujetos a cuotas a nivel de proyecto. Puedes empezar sin habilitar la facturación. Es un nivel gratuito basado en cuotas, no un crédito promocional único.
La distinción importante es que Google AI Studio, la API de Gemini y las suscripciones de consumo de Gemini son experiencias de acceso separadas. Que un modelo esté disponible en una interfaz no implica que esté disponible gratuitamente a través de otra.
¿Qué modelos de la API de Gemini son gratuitos en octubre de 2026?
Los cuatro modelos siguientes son puntos de partida útiles para aplicaciones de texto y multimodales. No constituyen una lista exhaustiva de todos los endpoints con elegibilidad gratuita. Sigue los enlaces de los modelos para explorar el acceso de CometAPI; las especificaciones de Google están vinculadas debajo de la tabla.
Los cuatro aceptan entrada de texto, imagen, video, audio y PDF, y producen texto. Su límite de entrada publicado es de 1,048,576 tokens, con hasta 65,536 tokens de salida. Estos límites del modelo no garantizan que tu proyecto gratuito pueda enviar una solicitud de ese tamaño.
Audio, embeddings y generación de imágenes: acceso y límites
Google también lista acceso gratuito para algunos modelos especializados, como Gemini 3.8 Live, Gemini 3.8 Flash TTS y Gemini Embedding 2. Revisa la entrada de precios para el modelo y el endpoint exactos antes de integrar: comprender una imagen o un clip de audio es una capacidad distinta de generar una imagen o una respuesta de voz.
Los métodos de API, formatos de solicitud y límites varían según la capacidad. Consulta la documentación del modelo y la operación específica que planeas usar.
El acceso gratuito no se extiende a todos los modelos de Gemini ni a todos los endpoints de generación. Gemini 4 Argon requiere acceso de API de pago, mientras que los endpoints premium de generación de imágenes y video tienen sus propias reglas de elegibilidad. Antes de integrar una función, verifica el modelo y la operación exactos en lugar de asumir que comparten la misma asignación gratuita.
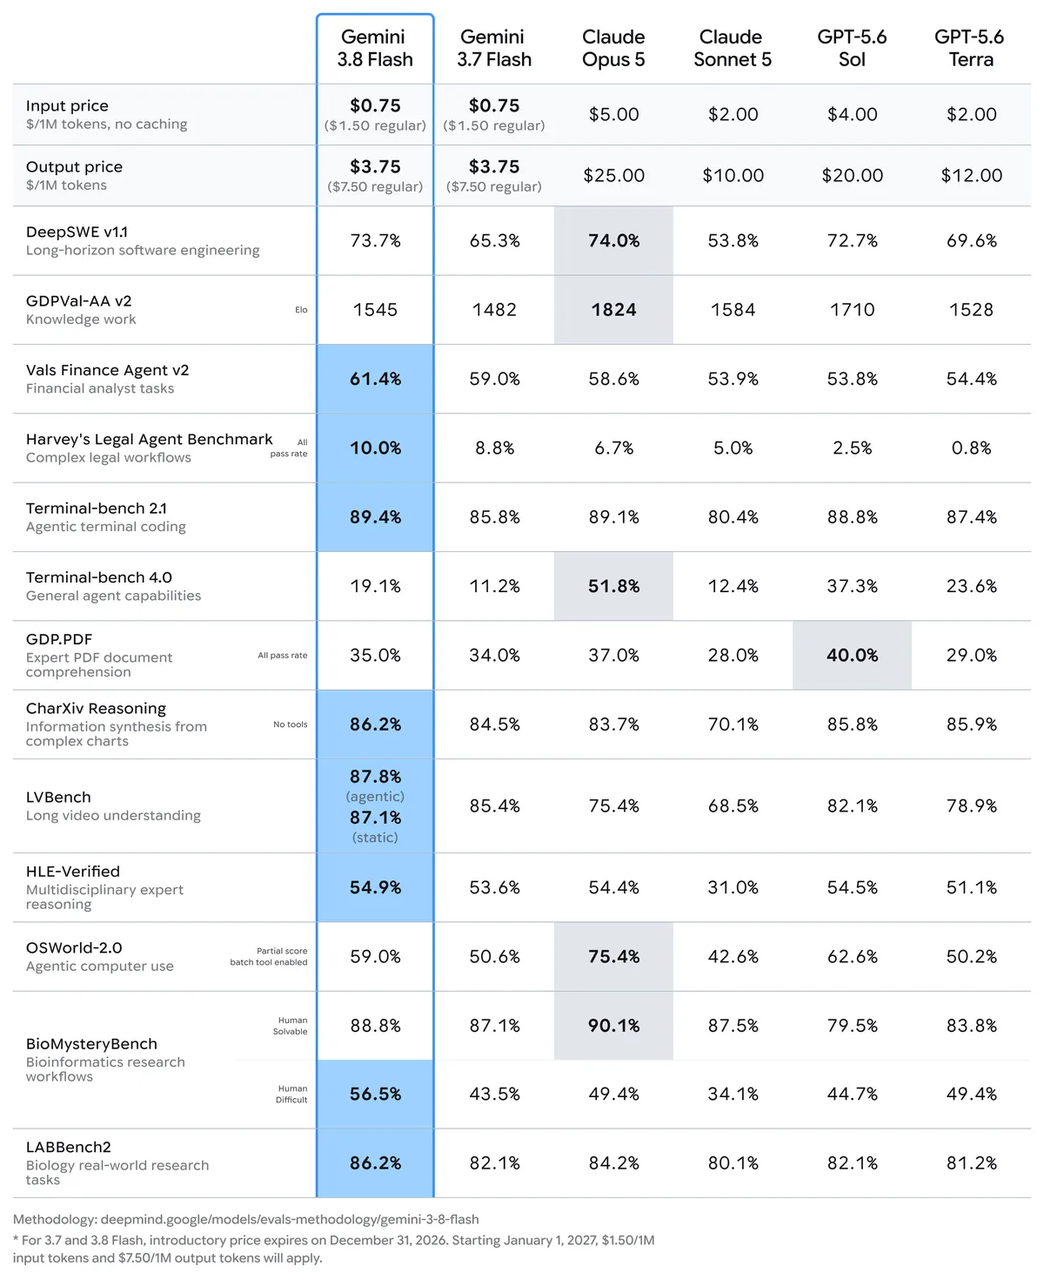
¿Cómo se desempeña Gemini 3.8 Flash?
La evaluación publicada por Google compara Gemini 3.8 Flash con Gemini 3.7 Flash y otros modelos. Reporta 73.7% en DeepSWE v1.1, frente a 65.3% para 3.7 Flash, un aumento de 8.4 puntos porcentuales. En HLE-Verified, la puntuación reportada sube de 53.6% a 54.9%.
Usa estos resultados para elegir un modelo que probar y luego evalúalo con ejemplos de tu propia aplicación. Para un extractor de documentos, los campos correctos y un formato de salida estable pueden importar más que un benchmark de programación. Para un asistente de programación, mide si el cambio propuesto funciona, cuánto tarda y cuántos tokens consume.
¿Cuáles son los límites de tasa del nivel gratuito de la API de Gemini en 2026?
La mayor idea errónea sobre el nivel gratuito de Gemini es que todas las cuentas reciben el mismo número fijo de solicitudes.
Abre Google AI Studio, elige el proyecto detrás de tu clave de API y revisa los límites activos para tu modelo seleccionado. La guía de límites de tasa de Google explica las dimensiones de cuota; el panel muestra la asignación que aplica a tu cuenta.
RPM (requests per minute): limita cuántas solicitudes puedes enviar cada minuto. Vigila las ráfagas cortas y los workers en paralelo que envían demasiadas solicitudes a la vez.
TPM (input tokens per minute): limita el volumen de tokens de entrada que puedes enviar cada minuto. Prompts grandes, historiales de conversación y documentos pueden consumir esta asignación incluso cuando el recuento de solicitudes es bajo.
RPD (requests per day): limita tu recuento total de solicitudes diarias. Planifica tu carga de trabajo en torno a la asignación diaria y su hora de restablecimiento.
Un límite de entrada de un millón de tokens describe el tamaño máximo de entrada admitido por el modelo. No garantiza que un proyecto del nivel gratuito tenga suficiente capacidad de TPM para enviar un millón de tokens en una sola solicitud. La capacidad de contexto y la capacidad por límites de tasa deben evaluarse por separado.
Las cuotas diarias de solicitudes se restablecen a medianoche, hora del Pacífico. Varias claves en un mismo proyecto comparten sus límites de uso, por lo que crear otra clave no añade capacidad. Pueden aplicarse otros límites a modelos u operaciones especializados.
Cómo manejar errores 429 de la API de Gemini
Lee el cuerpo del error antes de reintentar. En la Interactions API actual, un 429 puede distinguir entre un límite de solicitudes o tokens a corto plazo y una cuota diaria agotada. Para un límite a corto plazo, desacelera la cola y usa reintentos exponenciales con “jitter”. Para agotamiento diario, espera al restablecimiento o cambia el plan de capacidad de la aplicación. Un 503 señala indisponibilidad temporal del servicio. Consulta la referencia de errores de la API de Google.
¿Cómo se comparan los precios de Google y CometAPI?
Cuándo comienza la facturación de la API de Gemini
Agotar tu cuota gratuita no cambia automáticamente tu proyecto a uso de pago. Sin una cuenta de facturación activa, las solicitudes que exceden la asignación gratuita disponible encuentran restricciones de acceso o capacidad en lugar de cargos estándar por tokens de pago.
Para usar capacidad de pago, debes vincular la facturación. Si tu cuenta está asignada a un plan prepago, también debes añadir créditos, empezando por 5 USD o el equivalente local. Revisa tu plan asignado y los controles de gasto en AI Studio antes de actualizar. Los saldos y el cómputo de uso pueden actualizarse con retraso, por lo que un saldo prepago mostrado no es un tope de gasto instantáneo.
El crédito de bienvenida de Google Cloud de 300 USD es independiente del nivel gratuito de la API de Gemini. Las cuentas abiertas después del 2 de marzo de 2026 no pueden usar ese crédito para cargos de la API de Gemini o de AI Studio. Revisa la guía de facturación para las reglas que aplican a tu cuenta.
Precios por token de Google y CometAPI
La tabla compara los precios estándar por token de Google con las tarifas publicadas de CometAPI verificadas el 26 de octubre de 2026. Todos los importes son USD por un millón de tokens; la salida incluye razonamiento facturable cuando corresponda. La entrada y salida gratuitas de Google aplican solo a solicitudes elegibles dentro de la asignación del proyecto.
Los precios introductorios de Flash de Google anteriores finalizan el 31 de diciembre de 2026; 3.8 Flash y 3.6 Flash pasan entonces a $1.50 en entrada y $7.50 en salida. El precio introductorio de Argon finaliza el 30 de noviembre de 2026, tras lo cual pasa a $4 en entrada y $20 en salida. Las tarifas de CometAPI deben verificarse de forma independiente cuando cambien esas promociones. Herramientas, caché, almacenamiento, impuestos y otros servicios pueden añadir cargos.
Un ejemplo de carga pequeña
Supongamos que envías 1,000 solicitudes de texto, cada una con 2,000 tokens de entrada y 500 tokens de salida. Eso son dos millones de tokens de entrada y medio millón de tokens de salida. A las tarifas anteriores, Gemini 3.8 Flash cuesta $3.375 a través de Google, o aproximadamente $3.38, y $2.70 a través de CometAPI. Una carga de trabajo elegible del nivel gratuito de Google cuesta $0 solo si encaja en las cuotas disponibles. Estas son estimaciones de coste por tokens, no facturas medidas.
¿Cómo empezar a usar el nivel gratuito de la API de Gemini?
Necesitas una cuenta y región de Google aptas, una clave de API y Python con pip disponible. El siguiente ejemplo sigue la guía de inicio actual de Google y usa la Interactions API.
Crear una clave e instalar el SDK
En Google AI Studio, copia o crea una clave de API para un proyecto que no haya habilitado la facturación de pago. Instala el SDK y luego establece la clave en tu entorno de terminal. Guarda la clave en tu servidor en lugar de incrustarla en código del navegador.
pip install -U google-genai
En macOS o Linux:
export GEMINI_API_KEY="your_api_key"
En Windows PowerShell:
$env:GEMINI_API_KEY="your_api_key"
Enviar una solicitud y comprobar el resultado
from google import genai

client = genai.Client()
interaction = client.interactions.create(
    model="gemini-3.8-flash",
    input="Explain vector databases in 100 words."
)
print(interaction.output_text)
Guárdalo como un archivo de Python y ejecútalo desde el mismo entorno. Una solicitud exitosa imprime una breve explicación. Luego verifica el panel de uso de AI Studio para confirmar el proyecto y el modelo que reciben el tráfico. Si falla, inspecciona el código de error y verifica la clave, el acceso al modelo, la cuota y el estado de facturación antes de cambiar el código.
¿Cómo pueden los desarrolladores acceder a los modelos de la API de Gemini a través de CometAPI?
CometAPI ofrece una vía de acceso separada para los modelos de Gemini admitidos y otros proveedores de IA.
Elige esta vía cuando una interfaz compartida entre proveedores simplifique tu aplicación. Usa una clave de CometAPI con su endpoint y luego verifica el ID de modelo admitido y los límites de cuenta. La cuota gratuita de Google no se transfiere a este servicio. El siguiente ejemplo usa la interfaz compatible con OpenAI documentada por CometAPI.
pip install -U openai
Configura COMETAPI_KEY en tu entorno usando el mismo método específico de la shell mostrado arriba y luego ejecuta:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1"
)
response = client.chat.completions.create(
    model="gemini-3.8-flash",
    messages=[{
        "role": "user",
        "content": "Summarize the benefits of RAG."
    }]
)
print(response.choices[0].message.content)
Antes del despliegue, confirma que el ID de modelo previsto esté admitido por tu cuenta de CometAPI. No se garantiza que los identificadores nativos de Google y los alias específicos del proveedor coincidan para todos los modelos.
¿Qué restricciones de privacidad se aplican al nivel gratuito de la API de Gemini?
Según los Términos de servicio adicionales de la API de Gemini de Google, los prompts y salidas de servicios no pagos pueden usarse para mejorar los productos de Google, y revisores humanos pueden examinarlos. No envíes información sensible, confidencial ni personal a servicios no pagos. Los servicios de API de pago tienen términos de uso de datos diferentes.
Las normas regionales importan: las disposiciones de uso de datos de servicios pagos aplican a cierto uso no pago en el EEE, Suiza y el Reino Unido, pero poner un cliente de API a disposición de usuarios en esas regiones requiere Servicios de pago. Son condiciones independientes. Revisa los términos vigentes para tus usuarios y despliegue antes del lanzamiento.
¿Cómo optimizar el uso del nivel gratuito de la API de Gemini?
Construye en torno a la cuota que has medido. Mantén un pequeño conjunto de tareas representativas y registra el éxito de la tarea, la latencia, los tokens de entrada y salida, y los reintentos. Luego cambia una parte de la carga de trabajo a la vez:
Encamina por dificultad. Prueba Flash-Lite en la extracción rutinaria y usa un modelo más grande solo donde mejore el resultado.
Recorta la entrada. Envía la sección relevante del documento y el historial de conversación necesario en lugar de reenviar todo repetidamente.
Controla la generación. Solicita una longitud de salida útil y ajusta el esfuerzo de razonamiento solo donde el modelo y la API lo admitan.
Reutiliza el trabajo. Almacena resultados repetidos de la aplicación y verifica la elegibilidad de caché específica del modelo antes de asumir que la caché de la API es gratuita.
Gestiona la concurrencia con presupuesto. Mantén los workers detrás de una cola compartida para que las tareas independientes no creen una ráfaga evitable.
Por último, monitoriza la calidad además del consumo. Un modelo más barato que falle con frecuencia o requiera varios intentos puede generar más trabajo que uno ligeramente más caro que acierte al primer intento.
Una métrica interna útil de evaluación es:
Coste efectivo por tarea exitosa = Coste total de inferencia / Número de tareas exitosas
Para la experimentación con el nivel gratuito, una métrica operativa adicional es tareas exitosas por ventana de cuota disponible.
Preguntas frecuentes
¿Cómo puedo saber si un problema de cuota se debe a ráfagas de solicitudes o a documentos grandes?
Compara las marcas de tiempo de los fallos con el recuento de solicitudes y el volumen de tokens de entrada. Una ráfaga de prompts cortos apunta a la frecuencia de solicitudes; unos pocos documentos largos pueden agotar la capacidad de tokens incluso con RPM bajos. En la Interactions API, inspecciona el código de error legible por máquina y distingue el agotamiento de la cuota diaria de un límite a corto plazo. Registra el uso de tokens y la concurrencia de workers juntos para poder cambiar la parte relevante de la cola.
¿Qué debo hacer si una solicitud expira después de enviarla?
Un timeout no siempre indica si una operación remota se completó. Para una interacción de la que tienes un ID, verifica su estado antes de iniciar otra tarea costosa. Pon un ID de tarea a nivel de aplicación alrededor de tu flujo de trabajo y desduplica acciones posteriores, especialmente correos, escrituras en base de datos y llamadas a herramientas. Un reintento de generación de texto no debería repetir silenciosamente una acción empresarial. La documentación de Interactions describe la recuperación de interacciones y los estados de ejecución.
¿Cómo debo comparar Flash y Flash-Lite para extracción de documentos?
Usa los mismos documentos, campos requeridos y reglas de aceptación para ambos modelos. Incluye escaneos ruidosos, campos faltantes y valores ambiguos. Puntúa la precisión factual de los campos y la validez de la salida, luego cuenta reintentos y correcciones manuales. Un modelo que produce menos tokens aún puede consumir más esfuerzo si sus errores requieren otra solicitud. Mantén un conjunto de documentos reservado para que los cambios de prompt no se juzguen solo sobre ejemplos ya ajustados.
¿Qué debo verificar antes de cambiar una aplicación de Google a CometAPI?
Prueba el endpoint exacto, ID de modelo, formato de mensajes y funciones que usa tu aplicación. Una solicitud compatible de chat-completions no establece soporte idéntico para archivos, herramientas, caché o configuraciones de razonamiento. Compara los campos de uso devueltos y el manejo de errores, además de la respuesta de texto, y revisa las políticas de datos del intermediario y del proveedor de origen. Comienza con una carga de trabajo pequeña y no sensible antes de mover el resto de tu tráfico.
¿Cómo puedo mantener estable una integración a medida que cambian los modelos y los precios?
Mantén los IDs de modelo, la configuración del endpoint y las suposiciones de precio en configuración. Registra el modelo y la fecha con los resultados de evaluación, monitoriza avisos de desaprobación y vuelve a ejecutar tareas representativas antes de cambiar un modelo. Configura alertas presupuestarias y revisita las tarifas promocionales antes de sus fechas de finalización. Mantén un fallback probado para cargas esenciales en lugar de asumir que una cuota gratuita o un alias de modelo en particular seguirá disponible indefinidamente.
Conclusión
El nivel gratuito de la API de Gemini es una forma útil de validar una aplicación antes de pagar por capacidad. Elige un modelo para la tarea, mide la cuota disponible para tu proyecto y revisa los términos de datos antes de usar entradas de producción.
Para un primer experimento, realiza una solicitud pequeña y confírmala en AI Studio. Luego mide una carga de trabajo representativa. Si la capacidad gratuita se convierte en la restricción, compara la API de pago de Google con CometAPI usando los mismos prompts, requisitos de calidad y costes completos por tokens.
Modelo
ID de modelo
Un uso inicial práctico
Gemini 3.8 Flash
gemini-3.8-flash
Programación compleja, razonamiento y flujos con herramientas
Gemini 3.6 Flash
gemini-3.6-flash
Aplicaciones Flash existentes y automatización general
Gemini 3.5 Flash-Lite
gemini-3.5-flash-lite
Análisis de documentos y tareas ligeras de agentes
Gemini 3.1 Flash-Lite
gemini-3.1-flash-lite
Clasificación, traducción y extracción sencilla
Modelo
Entrada/salida gratuita de Google
Entrada/salida de pago de Google
Entrada/salida en CometAPI
Gemini 3.8 Flash
Gratis
$0.75 / $3.75
$0.60 / $3.00
Gemini 3.6 Flash
Gratis
$0.75 / $3.75
$0.60 / $3.00
Gemini 3.5 Flash-Lite
Gratis
$0.30 / $2.50
Consulta la cotización actual del catálogo
Gemini 3.1 Flash-Lite
Gratis
$0.25 / $1.50
$0.20 / $1.20
Gemini 4 Argon
No disponible
$2.00 / $10.00
$1.60 / $8.00
Capa gratuita de Gemini API 2026: modelos gratuitos, límites y guía de precios - CometAPI