
TL;DR
GLM-5.3 Flash es la mejor opción predeterminada para la mayoría de las cargas de trabajo en producción: añade entrada visual nativa y una ventana de contexto de 1M de tokens, mientras que su precio estándar de lista es drásticamente menor. GLM-5.3 sigue siendo la opción más sólida cuando la máxima profundidad de codificación, el razonamiento de largo alcance difícil o el rendimiento en ciberseguridad importan más que el coste por unidad.
Esto no es una historia de modelo pequeño versus modelo grande. Flash es un MoE de 320B total/18B activos entrenado desde una nueva base multimodal con atención híbrida dispersa y lineal. El modelo insignia es un MoE de 744B total/40B activos cuyos avances en GLM-5.3 provienen del post-entrenamiento a escala sobre la base GLM-5.2.
Conclusiones clave
- Elija Flash para codificación multimodal, comprensión de documentos, agentes de navegador o GUI, automatización de alto volumen y aplicaciones sensibles al coste.
- Elija el modelo insignia para las tareas de ingeniería más difíciles a escala de repositorio, razonamiento más profundo asistido por herramientas y seguridad defensiva.
- Ambos modelos admiten contexto de 1M tokens, razonamiento siempre activo, function calling, streaming y despliegue con pesos abiertos.
- En benchmarks informados por Z.ai, el insignia lidera DeepSWE, NL2Repo, HLE con herramientas y Agents’ Last Exam; Flash lidera AutomationBench, Toolathlon y GDPval-AA v2.
- Pruebas independientes otorgan al insignia un mayor Índice de Inteligencia y salida más rápida, mientras que Flash logra ligeramente mejor tiempo al primer token y un coste mixto muy inferior.
GLM-5.3 Flash vs GLM-5.3 de un vistazo
| Dimensión | GLM-5.3 Flash | GLM-5.3 | Resultado práctico |
|---|---|---|---|
| Posicionamiento | Modelo eficiente de codificación y agentes multimodal nativo | Modelo insignia de razonamiento en texto, codificación, agentes de largo alcance, ciberseguridad | Dependiente de la carga de trabajo |
| Tamaño del modelo | 320B total / 18B activos | 744B total / 40B activos | Flash activa un 55% menos de parámetros |
| Modelo base | Nueva base multimodal entrenada con 30T tokens | Misma base que GLM-5.2; mejoras por post-entrenamiento | Rutas de desarrollo diferentes |
| Entrada / salida | Entradas de texto + visuales / salida de texto | Entrada de texto / salida de texto | Flash para flujos visuales |
| Contexto / salida máxima | 1M / 128K | 1M / 128K | Empate |
| Esfuerzo de razonamiento | bajo, alto, máximo; razonamiento siempre habilitado | bajo, alto, máximo; razonamiento siempre habilitado | Empate |
| Índice de Inteligencia independiente | 57 | 60 con esfuerzo máximo | GLM-5.3 |
| Velocidad de salida independiente | 50.2 tokens/s | 76.6 tokens/s | GLM-5.3 en la API probada |
| Precio oficial de lista de entrada/salida | $0.15 / $0.50 por 1M tokens | $1.40 / $4.40 por 1M tokens | Flash |
| Mejor encaje | Enrutamiento por defecto, agentes multimodales, escala | Tareas complejas de texto y seguridad de máxima importancia | Usar enrutamiento selectivo |
Fuentes: Documentación de modelos de Z.ai y comparación de Artificial Analysis.
¿Qué es GLM-5.3 Flash?
Z.ai posiciona Flash como el primer modelo multimodal nativo de la serie GLM-5. Tiene 320B parámetros totales y 18B activos, pero “Flash” no debe interpretarse como “pequeño”. El checkpoint completo sigue siendo un modelo muy grande; su eficiencia proviene de activar un subconjunto más pequeño de expertos y rediseñar la pila de atención.
Su modelo base se entrenó en un corpus multimodal de 30 billones de tokens. La visión nativa se integra en el ciclo de codificación, lo que permite que el modelo inspeccione capturas de pantalla, interfaces renderizadas, gráficos, maquetas de página y otros feedbacks visuales antes de refinar su siguiente acción.
Especificaciones de GLM-5.3 Flash
| Especificación | GLM-5.3 Flash |
|---|---|
| Desarrollador | Z.ai / Zhipu AI |
| ID del modelo | glm-5.3-flash |
| Tipo de modelo | Mezcla de Expertos (MoE) multimodal nativa |
| Parámetros totales / activos | 320B / 18B |
| Capas | 45 |
| Arquitectura | Atención híbrida dispersa + atención lineal; mHC; MTP |
| Corpus de entrenamiento | Corpus de preentrenamiento multimodal de 30T tokens |
| Modalidades de entrada | Entradas de texto y visuales, incluyendo imágenes y flujos de video/archivos compatibles |
| Modalidad de salida | Texto |
| Contexto / salida máxima | 1M / 128K tokens |
| Razonamiento | Siempre habilitado; esfuerzo bajo, alto, máximo |
| Herramientas | Function calling, llamadas de herramientas en streaming, flujos estructurados |
| Pesos / licencia | Pesos abiertos; Apache-2.0 en el repositorio oficial |
Fuentes: Documentación de Flash de Z.ai y el repositorio oficial de GLM-5.
¿Qué es GLM-5.3?
El modelo insignia está optimizado para ingeniería de software compleja, agentes de largo alcance y ciberseguridad. Z.ai afirma que utiliza la misma base que GLM-5.2; la mejora proviene del post-entrenamiento a escala en lugar de un nuevo preentrenamiento.
El repositorio oficial lista el checkpoint con 744B parámetros totales y 40B activos. En comparación con Flash, activa más del doble de parámetros por token y asigna más capacidad al razonamiento multietapa difícil.
Especificaciones de GLM-5.3
| Especificación | GLM-5.3 |
|---|---|
| Desarrollador | Z.ai / Zhipu AI |
| ID del modelo | glm-5.3 |
| Tipo de modelo | Modelo insignia de texto con Mezcla de Expertos |
| Parámetros totales / activos | 744B / 40B |
| Modelo base | Base GLM-5.2; todas las mejoras de GLM-5.3 provienen del post-entrenamiento |
| Entrada / salida | Texto / texto |
| Contexto / salida máxima | 1M / 128K tokens |
| Razonamiento | Siempre habilitado; esfuerzo bajo, alto, máximo |
| Herramientas | Function calling, llamadas de herramientas en streaming, caché de contexto, salida estructurada |
| Enfoque principal | Codificación compleja, agentes de largo alcance, ingeniería, ciberseguridad |
| Pesos / licencia | Pesos abiertos bajo la licencia GLM-5.3; código del repositorio de soporte bajo Apache-2.0. |
Fuentes: documentación del modelo insignia de Z.ai y el repositorio oficial de GLM-5.
Arquitectura: por qué Flash es más barato sin ser pequeño
Flash alterna bloques de atención lineal con bloques de atención dispersa y utiliza mHC alrededor de componentes de atención y MoE. Su mecanismo IndexPool comprime cuatro vectores clave de indexación en uno. Z.ai informa de 3.01× menos cómputo de atención por capa y una caché KV 4.44× más pequeña por capa que el modelo insignia a una secuencia de 1M tokens.
Estas son comparaciones a nivel de arquitectura, no multiplicadores garantizados de latencia extremo a extremo. La velocidad real de la API también depende del hardware, cuantización, batching, longitud del razonamiento, software de servicio y carga del proveedor.
Arquitectura de atención híbrida de GLM-5.3-Flash y comparación de cómputo/caché para contexto largo.
Fuente: Documentación oficial de arquitectura de Z.ai
Rendimiento en benchmarks: dónde gana cada modelo
La comparación más clara separa los benchmarks informados por el proveedor de las mediciones independientes de API. Incluso cuando los nombres de los benchmarks coinciden, las versiones del arnés, las configuraciones de herramientas, la gestión del contexto y el esfuerzo de razonamiento pueden diferir. La tabla siguiente utiliza los valores más cercanos en la evaluación del modelo insignia y la evaluación de Flash, tratando pequeñas diferencias como direccionales más que definitivas.
| Benchmark | GLM-5.3 Flash | GLM-5.3 | Puntuación más alta | Qué evalúa |
|---|---|---|---|---|
| Terminal-Bench 2.1 | 84.3 | 88.2 | GLM-5.3 | Codificación en terminal y con agentes |
| DeepSWE v1.1 | 63.4 | 66.9 | GLM-5.3 | Ingeniería de software |
| NL2Repo | 56.3 | 58.0 | GLM-5.3 | Generación de repositorios |
| Toolathlon Verified | 78.4 | 73.0 | Flash | Uso de herramientas |
| AutomationBench | 48.8 | 48.2 | Casi empate / Flash | Automatización de uso de computadora |
| Agents’ Last Exam | 26.3 | 28.5 | GLM-5.3 | Razonamiento de largo alcance en agentes |
| HLE with tools | 55.3 | 62.5 | GLM-5.3 | Razonamiento difícil asistido por herramientas |
| GDPval-AA v2 | 1773 Elo | 1769 Elo | Casi empate / Flash | Trabajo profesional de conocimiento |
Fuentes: evaluación del modelo insignia y evaluación de Flash. Compare de forma direccional porque los entornos de evaluación pueden diferir.
Codificación e ingeniería de repositorios
El modelo insignia tiene el techo de rendimiento más alto. Supera a Flash en 3.5 puntos en DeepSWE y 1.7 puntos en NL2Repo. En Z.ai Code Bench v1.0, con ambos modelos evaluados usando Claude Code 2.1.207, el insignia alcanza 34.5% con esfuerzo máximo, mientras que Flash alcanza 29.0% — una ventaja de 5.5 puntos.
Aun así, Flash es lo bastante competitivo como para ser el primer modelo evaluado para mantenimiento rutinario de repositorios, generación de pruebas, depuración, refactorización y agentes de codificación de alto volumen. Escale únicamente las tareas más difíciles o trayectorias fallidas al modelo insignia.
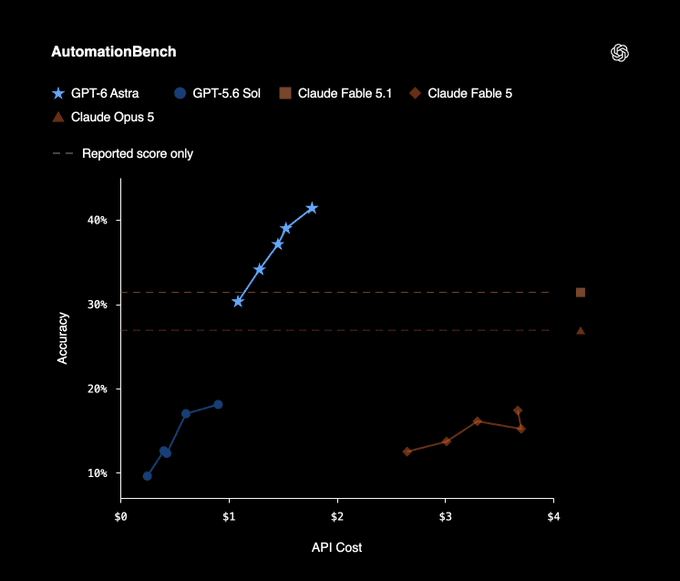
Evaluación de seis benchmarks de Z.ai para GLM-5.3-Flash y otros modelos de codificación/agentes.
Fuente: Documentación oficial de Flash de Z.ai
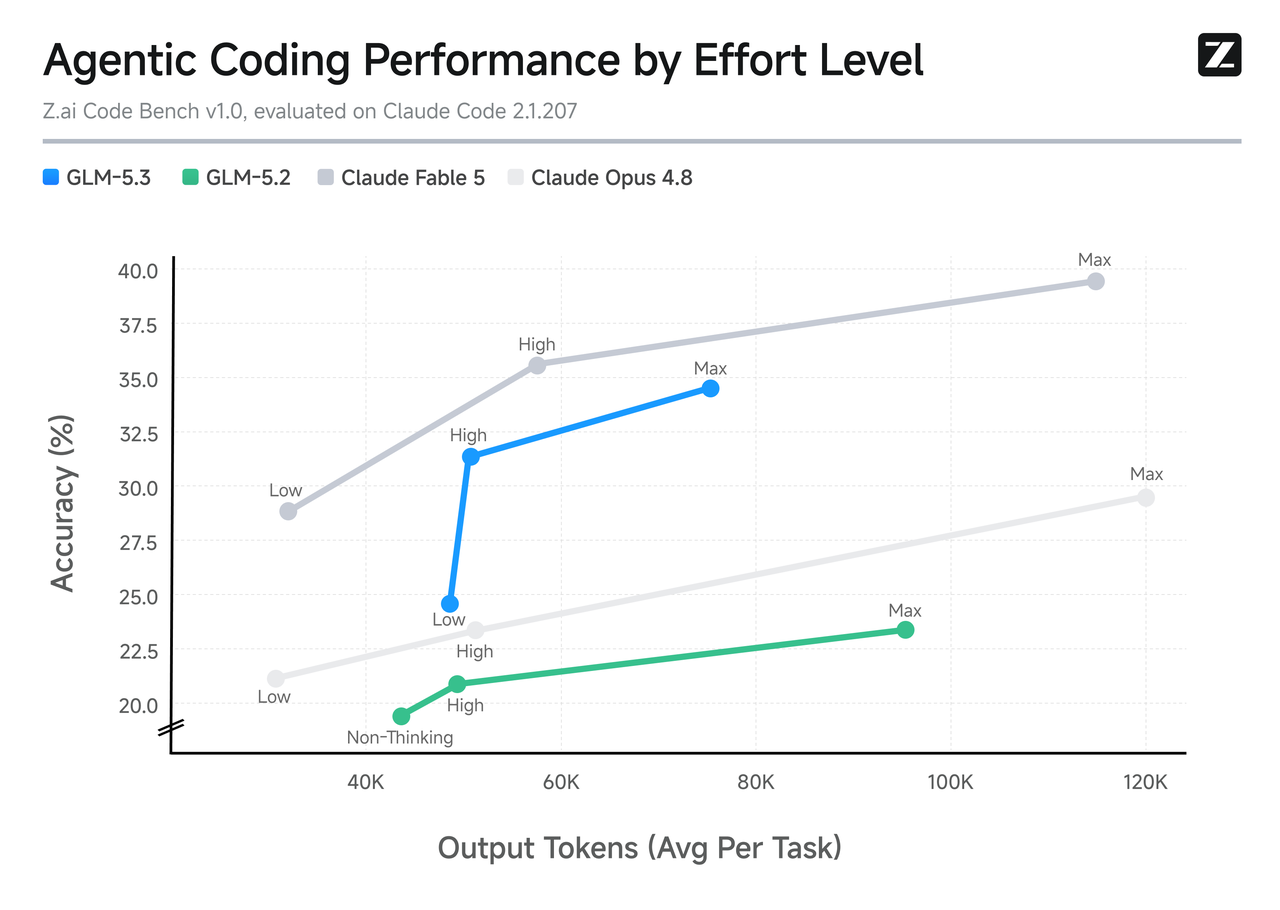
Precisión de codificación con agentes y uso de tokens de salida de GLM-5.3 a través de niveles de esfuerzo de razonamiento.
Fuente: Documentación oficial del modelo insignia
Uso de herramientas, automatización y trabajo de conocimiento
Flash no es uniformemente más débil. Anota 78.4 en Toolathlon Verified frente a 73.0 del insignia, y supera ligerísimamente en AutomationBench 48.8 a 48.2. Está esencialmente empatado en GDPval-AA v2. Esto hace que Flash sea especialmente atractivo cuando la tarea consiste menos en una única cadena de razonamiento extremadamente difícil y más en coordinar herramientas de manera fiable a través de muchas solicitudes económicas.
Inteligencia, velocidad y latencia independientes
| Medición independiente | GLM-5.3 Flash | GLM-5.3 (máx.) | Resultado |
|---|---|---|---|
| Artificial Analysis Intelligence Index | 57 | 60 | GLM-5.3 |
| Velocidad de salida | 50.2 tokens/s | 76.6 tokens/s | GLM-5.3 |
| Tiempo al primer token | 1.49 s | 1.61 s | Flash |
| Ventana de contexto | 1M | 1M | Empate |
| Precio mixto en comparación de AA | $0.10 / 1M tokens | $0.90 / 1M tokens | Flash |
Fuente: comparación de API emparejada de Artificial Analysis.
El resultado independiente añade una corrección importante a la suposición de “Flash significa más rápido”. Flash responde un poco antes, pero el endpoint del modelo insignia probado genera tokens más rápido una vez que comienza la salida. Trate estas mediciones como instantáneas específicas del proveedor, no como propiedades inmutables del modelo.
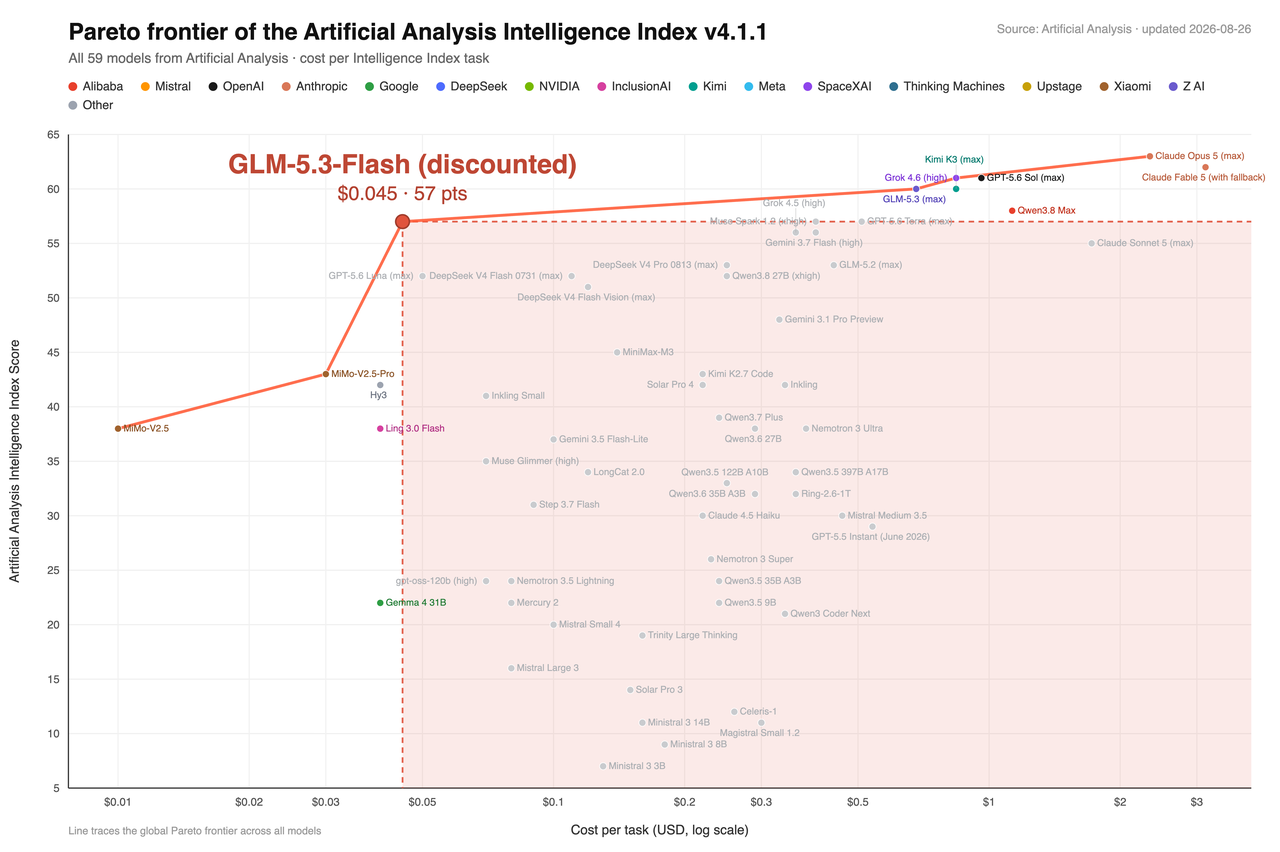
Frontera coste–inteligencia de Artificial Analysis reproducida en la documentación oficial de Flash de Z.ai.
Fuente: Documentación oficial de Flash de Z.ai
Multimodalidad: Flash tiene la ventaja clara
Flash acepta entradas visuales y las integra en flujos de trabajo con agentes. Puede inspeccionar capturas de pantalla, imágenes de página, gráficos, estados de interfaz, grabaciones de pantalla y archivos compatibles, luego usar la evidencia visual mientras codifica u opera herramientas. El modelo insignia actualmente admite solo entrada de texto.
- Frontend y diseño a código: Flash puede inspeccionar una captura de referencia y validar la implementación renderizada.
- Documentos y flujos de Office: Flash puede razonar sobre estructura de página, gráficos, maquetación y colocación de imágenes.
- Navegador y uso de computadora: Flash puede combinar estado visual con llamadas a herramientas y correcciones iterativas.
- Trabajo de repositorio solo-texto: el modelo insignia sigue siendo preferible cuando la entrada es código y texto y la tarea requiere máxima profundidad de razonamiento.
Contexto largo y controles de razonamiento
GLM-5.3 Flash admite una ventana de contexto de 1M tokens y hasta 128K tokens de salida; GLM-5.3 proporciona los mismos límites. Ambos mantienen el razonamiento habilitado y aceptan niveles de esfuerzo bajo, alto y máximo. Z.ai recomienda máximo para codificación difícil y reproducción de benchmarks.
La capacidad de contexto, por tanto, no es el diferenciador principal. La diferencia es cuán económicamente sirve cada modelo secuencias largas y cuánta capacidad de razonamiento puede aportar a las tareas más difíciles. Flash es arquitectónicamente más barato en contexto largo; el modelo insignia tiene el techo de calidad más alto.
Ciberseguridad: GLM-5.3 es el especialista
La ciberseguridad es la capacidad más distintiva del modelo insignia. Z.ai informa 84.5 en CyberGym y 54.4 en ExploitBench. Bajo presupuestos normalizados de dos y seis horas, completó 105 y 130 tareas de ExploitGym.
Flash no tiene un énfasis de lanzamiento equivalente ni una suite cibernética pública comparable. Para revisión de código, desarrollo seguro y descubrimiento autorizado de vulnerabilidades, use el modelo insignia como modelo principal y mantenga aprobación humana, herramientas aisladas, registros de auditoría y controles de divulgación en el flujo de trabajo.
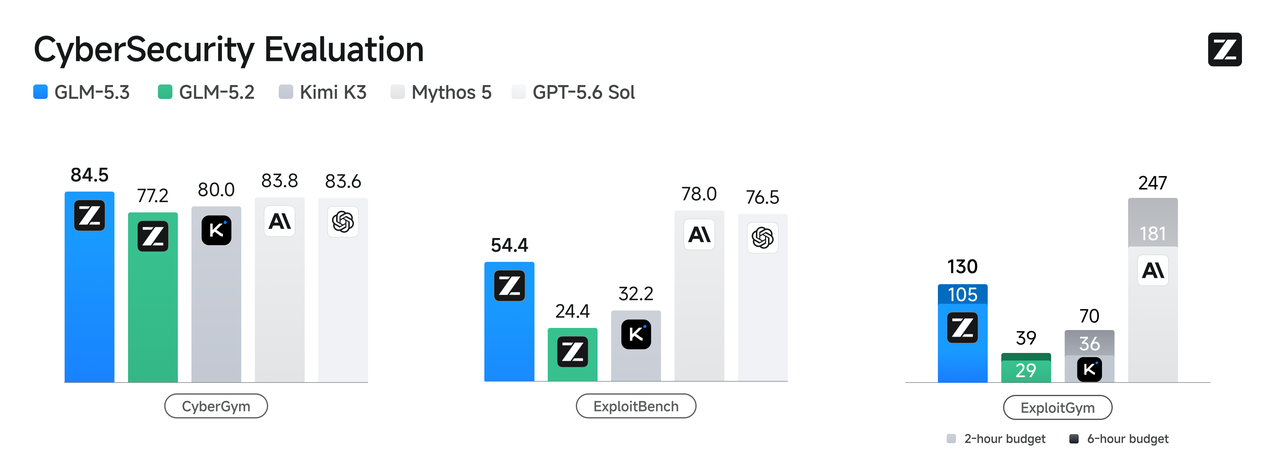
Rendimiento de GLM-5.3 en descubrimiento de vulnerabilidades y benchmarks de explotación.
Fuente: Documentación oficial de ciberseguridad de Z.ai
Coste e implementación
Precios de API
Z.ai lista Flash a $0.15 por millón de tokens de entrada y $0.50 por millón de tokens de salida antes de promociones, frente a $1.40 y $4.40 para el modelo insignia.
| Ruta de acceso | Entrada Flash | Flash en caché | Salida Flash | 5.3 entrada | 5.3 en caché | 5.3 salida |
|---|---|---|---|---|---|---|
| Lista estándar de Z.ai | $0.15 | $0.03 | $0.50 | $1.40 | $0.26 | $4.40 |
| Tarifa promocional de Flash | $0.075 | $0.015 | $0.25 | $1.40 | $0.26 | $4.40 |
| Ruta CometAPI | $0.06 | Consulte la ruta en vivo | $0.20 | $1.12 | Consulte la ruta en vivo | $3.528 |
Los precios están en USD por 1M tokens. Fuentes: precios de Z.ai, ruta de Flash y ruta de GLM-5.3. Las promociones pueden cambiar.
Ejemplo de coste mensual
Para una carga de trabajo que usa 100M tokens de entrada y 20M tokens de salida, las tarifas actuales de CometAPI producen un estimado de $10.00 para Flash frente a $182.56 para el modelo insignia, antes de efectos de caché o cargos de herramientas. En este ejemplo, Flash reduce la factura de tokens aproximadamente un 94.5%.
| Componente de coste | GLM-5.3 Flash | GLM-5.3 |
|---|---|---|
| Coste de entrada | 100 × $0.06 = $6.00 | 100 × $1.12 = $112.00 |
| Coste de salida | 20 × $0.20 = $4.00 | 20 × $3.528 = $70.56 |
| Total | $10.00 | $182.56 |
Pesos abiertos y autoalojamiento
Ambos modelos tienen checkpoints descargables en FP8 y BF16. Los pesos de GLM-5.3 Flash se publican bajo la licencia MIT. GLM-5.3 usa la licencia separada GLM-5.3, que requiere revisión de seguridad antes del uso comercial por operadores de Model-as-a-Service cuyos ingresos agregados superen los US$10 mil millones en cualquier período consecutivo de 12 meses. El repositorio GLM-5 en GitHub está bajo licencia Apache-2.0.
Flash es más fácil de servir que el modelo insignia, pero no es un modelo para GPU de consumo. El checkpoint de 320B, los componentes multimodales, la caché KV y el contexto de 1M siguen requiriendo infraestructura seria. El autoalojamiento es más atractivo cuando el control de datos, el servicio personalizado o una utilización alta sostenida justifican el coste operativo.
¿Qué modelo debería elegir?
¿Elegir GLM-5.3 Flash si?
- Necesita comprensión de imágenes, capturas de pantalla, gráficos, documentos, navegador o GUI.
- Ejecuta agentes de codificación de alto volumen, flujos de investigación o automatización empresarial.
- Quiere un fuerte desempeño en uso de herramientas y trabajo profesional al menor coste por token.
- Necesita una ventana de contexto de 1M pero no quiere la economía del modelo insignia en cada solicitud.
- Planea autoalojar y 320B/18B es más práctico que 744B/40B.
¿Elegir GLM-5.3 si?
- Está resolviendo las tareas de ingeniería más difíciles a escala de repositorio.
- Su evaluación recompensa el razonamiento más profundo más que el bajo coste unitario.
- Necesita el resultado más fuerte en DeepSWE, HLE con herramientas o Agents’ Last Exam.
- Está construyendo flujos de trabajo de seguridad defensiva o descubrimiento de vulnerabilidades autorizados.
- Una mayor tasa de éxito puede compensar una prima por token de aproximadamente un orden de magnitud.
Matriz de decisión por caso de uso
| Carga de trabajo | Modelo inicial recomendado | Por qué |
|---|---|---|
| Chat y automatización de alto volumen | GLM-5.3 Flash | Coste mucho menor; uso de herramientas sólido |
| Codificación visual y depuración de UI | GLM-5.3 Flash | Entrada visual nativa |
| Análisis de documentos, gráficos y Office | GLM-5.3 Flash | Flujos profesionales multimodales |
| Mantenimiento rutinario de repositorios | Comience con Flash | Escale tareas fallidas o inusualmente duras |
| Ingeniería difícil a escala de repositorio | GLM-5.3 | Techo de codificación más alto |
| Investigación de largo alcance con herramientas | GLM-5.3 | Resultado más fuerte en HLE con herramientas |
| Seguridad defensiva y descubrimiento de vulnerabilidades | GLM-5.3 | Entrenamiento y benchmarks cibernéticos dedicados |
| Autoalojamiento sensible al coste | GLM-5.3 Flash | Huella activa y total más pequeña |
| Carga de trabajo mixta incierta | Enrutamiento híbrido | Flash por defecto; escalado al insignia |
Una mejor estrategia de producción: enrutar, no reemplazar
Para la mayoría de los equipos, el diseño más sólido no es una elección exclusiva. Use Flash como ruta predeterminada y escale solo tareas con alta complejidad, validación fallida, sensibilidad de seguridad o un valor económico esperado que justifique la prima del modelo insignia.
- Envíe tareas visuales, rutinarias y de alto volumen a Flash.
- Mida tasa de aceptación, tokens, latencia, fallos de herramientas e intervención humana.
- Escale tareas de texto fallidas o de alto riesgo al modelo insignia.
- Encamine el trabajo sensible a seguridad mediante autorizaciones adicionales y controles de sandbox.
- Optimice por coste por resultado aceptado en lugar de solo ranking de benchmark o precio.
Cómo probar ambos modelos a través de CometAPI
CometAPI lista la ruta de GLM-5.3 Flash y la ruta de GLM-5.3 detrás de la misma URL base compatible con OpenAI. Cree una clave de API y luego ejecute la misma tarea de texto a través de ambos IDs de modelo. Para una prueba justa, mantenga fijos el prompt, el esfuerzo de razonamiento, las definiciones de herramientas, la salida máxima y la rúbrica de aceptación.
Python
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)

models = ["glm-5.3-flash", "glm-5.3"]

for model in models:
    response = client.chat.completions.create(
        model=model,
        messages=[
            {
                "role": "user",
                "content": "Review this migration plan and identify its three highest-risk assumptions.",
            }
        ],
    )
    print(model, response.choices[0].message.content)
Para evaluación multimodal, use la documentación de la ruta de Flash en vivo para verificar el esquema de contenido de imagen compatible. La comparación con el modelo insignia debe usar un equivalente solo de texto porque no acepta entrada visual.
Limitaciones de esta comparación
- Varios puntajes de codificación y agentes son informados por el proveedor. La reproducción independiente puede usar herramientas, prompts y ajustes de inferencia diferentes.
- Nombres de benchmarks coincidentes no garantizan versiones de arnés o estrategias de gestión de contexto idénticas.
- Reducciones a nivel de arquitectura en cómputo de atención y caché KV no predicen directamente la latencia de API.
- Precios, promociones, disponibilidad del modelo, límites de tasa y capacidades de ruta pueden cambiar; verifique páginas de modelo en vivo antes del despliegue.
- Pesos abiertos no hacen que ningún checkpoint sea barato de autoalojar a contexto completo.
- La capacidad de ciberseguridad es de doble uso y requiere autorización, sandboxing, registros, revisión experta y divulgación responsable.
Conclusión
GLM-5.3 Flash es la opción práctica por defecto. Conserva el contexto largo, añade visión nativa, rinde fuerte en uso de herramientas y trabajo profesional, y cambia la economía lo suficiente como para habilitar un despliegue mucho más amplio. GLM-5.3 es el modelo de escalado especializado: más caro, solo texto, pero más fuerte en las tareas de codificación, razonamiento y ciberseguridad más difíciles.
El veredicto final es, por tanto, basado en la carga de trabajo: comience con Flash, mida la tasa real de aceptación y enrute al modelo insignia solo cuando su capacidad extra de razonamiento produzca suficientes resultados adicionales exitosos como para justificar la prima.
Preguntas frecuentes
¿GLM-5.3 Flash es mejor que GLM-5.3?
No de forma universal. Flash es mejor en precio, multimodalidad y varios benchmarks de herramientas/automatización. El modelo insignia es más fuerte en las cargas de trabajo más difíciles de codificación, razonamiento asistido por herramientas y ciberseguridad.
¿GLM-5.3 Flash es un modelo pequeño?
No. Tiene 320B parámetros totales y activa 18B por token. Es más eficiente que el insignia de 744B/40B, pero aún requiere hardware sustancial para autoalojamiento.
¿Cuál modelo es más barato?
Flash es dramáticamente más barato. El precio estándar de lista de Z.ai es aproximadamente una décima parte del precio del modelo insignia, y las rutas actuales de CometAPI muestran una brecha aún mayor mientras la promoción esté activa.
¿Cuál modelo es más rápido?
Depende de la métrica y del proveedor. Artificial Analysis midió un tiempo ligeramente menor al primer token para Flash pero mayor velocidad de salida para el modelo insignia.
¿Qué modelo admite imágenes?
Flash admite entrada visual nativa. El modelo insignia actualmente admite solo entrada de texto.
¿Ambos modelos admiten contexto de 1M tokens?
Sí. Flash admite 1M de contexto y hasta 128K de salida; el modelo insignia proporciona los mismos límites.
¿Cuál modelo es mejor para codificación?
Use Flash para agentes de codificación rutinarios y de alto volumen. Use el modelo insignia para las tareas de ingeniería más difíciles a escala de repositorio o cuando el coste del fallo sea mayor que la diferencia de precio.
¿Cuál modelo es mejor para ciberseguridad?
El modelo insignia. Z.ai lo entrenó y evaluó específicamente para descubrimiento de vulnerabilidades y razonamiento de cadenas de explotación. Úselo solo en entornos autorizados y controlados.
¿Ambos modelos se pueden autoalojar?
Sí. El repositorio de Z.ai lista checkpoints descargables y frameworks de servicio compatibles, pero ambos siguen siendo proyectos de infraestructura de gran envergadura.
¿Cuál es la mejor estrategia de despliegue?
Use Flash como ruta por defecto y escale tareas de texto difíciles, fallidas o sensibles a seguridad al modelo insignia. Mida el coste por resultado aceptado.