
TL;DR
GLM 5.4 es un nombre utilizado por la comunidad para un posible sucesor en la familia GLM de Z.ai. A 14 de octubre de 2026, la documentación oficial del modelo y los registros de lanzamiento revisados para este artículo no establecen un lanzamiento, una hoja de especificaciones ni un identificador de API de GLM-5.4. Union Alpha es una pista de rumor, mientras que un lanzamiento en octubre es una posibilidad basada en la cadencia. La pregunta útil es si una versión futura mejora la fiabilidad en codificación y el costo por tarea completada; los modelos GLM existentes proporcionan la base para esa evaluación.
Puntos clave
- Estado de lanzamiento: Las fuentes oficiales revisadas el 14 de octubre de 2026 no confirman GLM-5.4; no se ha establecido una fecha exacta de lanzamiento.
- Evidencia de rumores: La asociación de Union Alpha con GLM-5.4 sigue sin verificarse, y el compendio citado no identifica una publicación de atribución original.
- Línea de base de rendimiento: Los resultados existentes de GLM-5.3 son un contexto útil, pero no son mediciones de GLM-5.4.
- Arquitectura: GLM-5.3-Flash demuestra una dirección distinta en eficiencia y multimodalidad; que GLM-5.4 herede esto es una cuestión abierta.
- Acción para desarrolladores: Evalúe los modelos disponibles ahora y exija IDs de modelo verificados, compatibilidad y mediciones a nivel de tarea antes de actualizar.
¿Se ha lanzado GLM 5.4?
GLM 5.4 es un nombre no oficial para un posible sucesor de GLM. El índice de documentación oficial y los registros de lanzamiento revisados el 14 de octubre de 2026 identifican modelos GLM existentes pero no establecen un lanzamiento de producto GLM-5.4. Se trata de una verificación con fecha, no de la prueba de que no exista desarrollo privado.
Dos vías de desarrollo documentadas explican por qué un posible sucesor atrae atención.
Z.ai confirma que GLM-5.3 reutiliza el modelo base GLM-5.2 y obtiene sus mejoras a través de posentrenamiento. GLM-5.3-Flash, en cambio, utiliza un nuevo modelo base multimodal y una arquitectura de atención híbrida. Estos hechos describen modelos existentes, no un diseño de GLM-5.4 divulgado.
En términos prácticos, una vía mejora un modelo existente mediante entrenamiento adicional, mientras que la otra rediseña la arquitectura para reducir costos de cómputo y soportar nuevas capacidades.
Un futuro GLM-5.4 podría construirse sobre cualquiera de las dos direcciones, pero aún no existe evidencia suficiente para determinar qué enfoque seleccionará Z.ai.
¿Qué tan fiables son los rumores y filtraciones de GLM-5.4?
Información confirmada
La base técnica confirmada proviene de GLM-5.3 y GLM-5.3-Flash, no de GLM-5.4. El nombre GLM-5.4, las especificaciones finales, la fecha de lanzamiento y los resultados de benchmarks permanecen sin confirmar en las fuentes oficiales revisadas para este artículo.
Informes de la comunidad / filtraciones
Una publicación en X del 8 de octubre de 2026 de @NFT_Chen atribuye una posible dirección de desarrollo GLM-5.4/5.5 a comentarios de Tang Jie. La publicación describe tres prioridades de escalado: ampliar el preentrenamiento, reforzar el posentrenamiento mediante SFT, RLHF y RLVR, y extender el razonamiento y la ejecución de agentes a tareas más difíciles y largas.
El autor interpreta la siguiente dirección como agentes autónomos más prolongados y auto-mejora recursiva (RSI). Es un relato comunitario de una charla, no un anuncio de lanzamiento de Z.ai. Los nombres de versión y las afirmaciones de desarrollo permanecen atribuidos a la publicación; no establecen una fecha de lanzamiento, una arquitectura final, un conteo de parámetros ni una capacidad demostrada de auto-mejora para GLM-5.4.
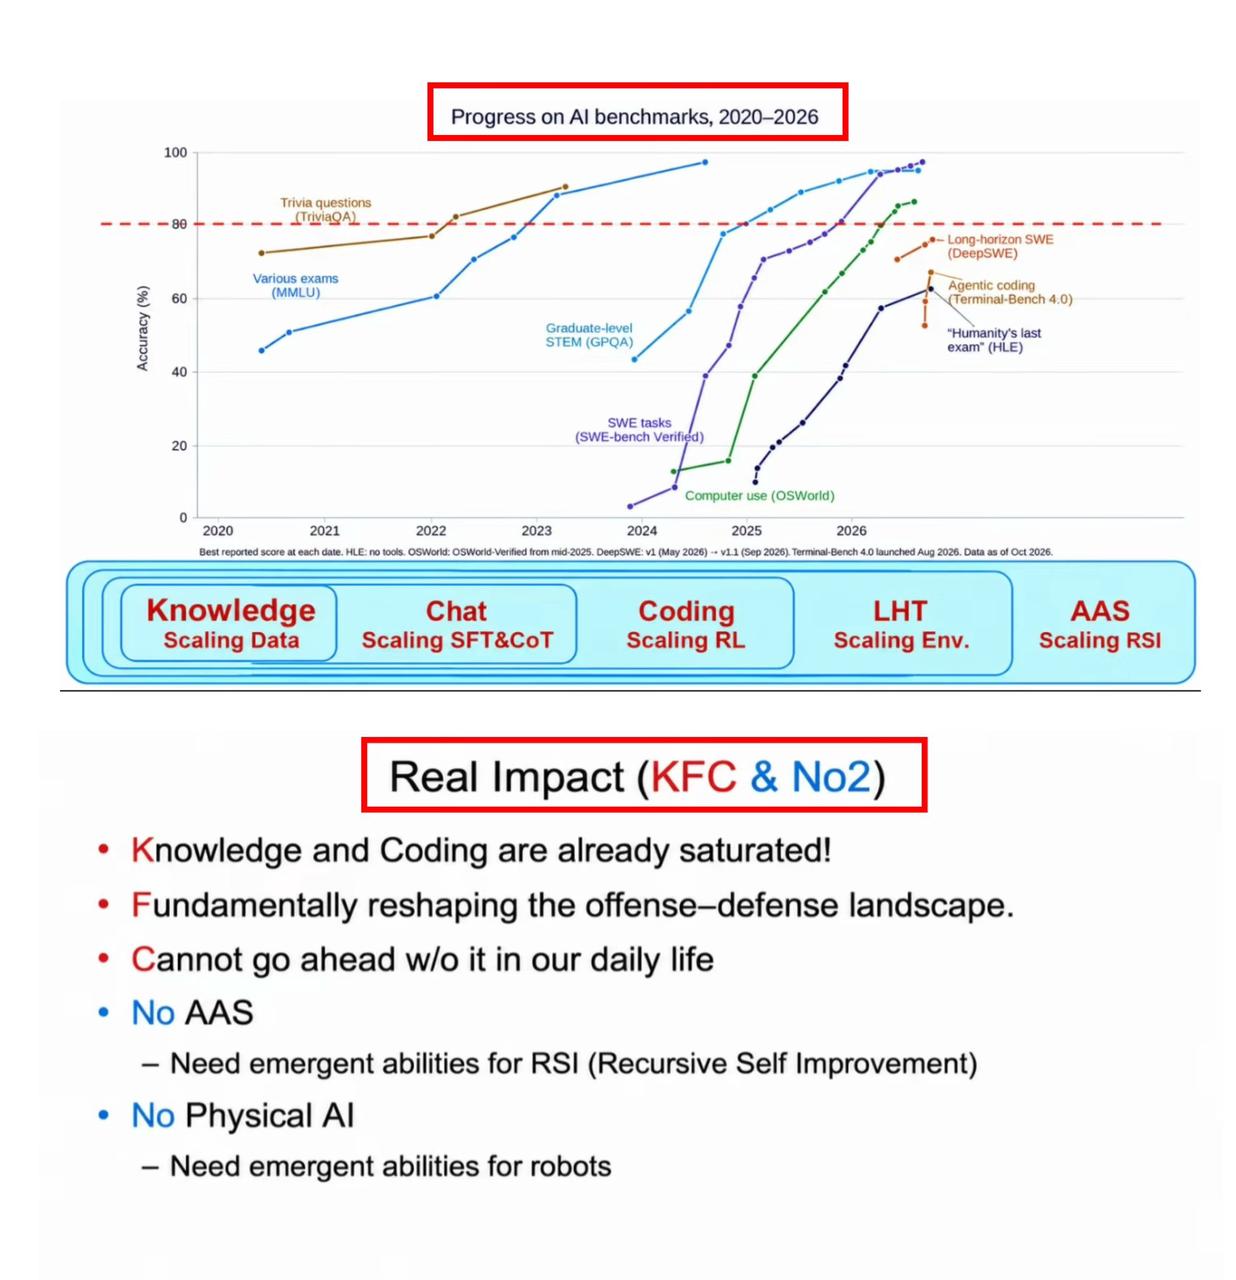
Imagen de diapositiva de presentación adjunta a la publicación original en X de @NFT_Chen, 8 de octubre de 2026. Trata el progreso en benchmarks y la RSI como dirección futura; no es un informe de benchmark de GLM-5.4.
Fotografía de la charla adjunta a la publicación original en X de @NFT_Chen, 8 de octubre de 2026.
Análisis
Un análisis útil de rumores pregunta qué observación cambiaría la conclusión. Un identificador oficial de modelo, un anuncio de lanzamiento o un mapeo divulgado desde un alias anónimo fortalecerían materialmente el caso. Un patrón de nombres similar o un intervalo de lanzamientos por sí solos no pueden hacerlo. Especulaciones anteriores sobre otros números de versión futuros de GLM no establecen especificaciones para GLM-5.4.
¿Cuándo podría lanzarse GLM 5.4?
La cronología de notas de lanzamiento de Z.ai registra GLM-5 el 12 de febrero, GLM-5.1 el 7 de abril, GLM-5.2 el 16 de junio, GLM-5.3 el 18 de agosto y GLM-5.3-Flash el 26 de agosto de 2026. Estas son fechas registradas en las notas; no deben confundirse con todos los anuncios de investigación o fechas de disponibilidad por proveedor.
La progresión aproximada de dos meses de las versiones principales hace de octubre una ventana analítica razonable a observar. No establece un lanzamiento en octubre, un día específico ni siquiera el próximo nombre de versión. Sin una fuente de pronóstico rastreable y su metodología, una predicción exacta para el 20 o 23 de octubre implicaría más precisión de la que permite la evidencia.
Un lanzamiento posterior, un nombre diferente o una variante de producto separada sigue siendo posible. Los desarrolladores deben planificar en torno a APIs disponibles actualmente en lugar de una estimación de calendario.
¿Cuáles son las especificaciones esperadas de GLM 5.4?
No hay una hoja de especificaciones fiable de GLM-5.4 disponible. En lugar de asignar hardware rumoreado y parámetros de modelo a un producto no lanzado, es más informativo comparar los modelos GLM documentados más recientes e identificar lo que sigue siendo desconocido.
| Especificación | GLM-5.3 | GLM-5.3-Flash | GLM-5.4 |
|---|---|---|---|
| Lanzamiento | 18 de agosto de 2026 | 26 de agosto de 2026 | No anunciado |
| Base del modelo | Base GLM-5.2; posentrenamiento extra | Nueva base multimodal | Desconocido |
| Arquitectura | Fundación MoE | MoE; atención híbrida dispersa-lineal | Desconocido |
| Soporte de contexto | Contexto de API documentado de 1M | 1M | Desconocido |
| Multimodalidad nativa | Entrada solo de texto | Entradas de texto, imagen, video y archivos | Desconocido |
| Énfasis principal | Programación, agentes, ciberseguridad | Eficiencia, programación, multimodalidad | Desconocido |
| Benchmarks publicados | Disponibles | Disponibles | No disponible |
| Pesos del modelo | Publicados | Publicados | No disponible |
La tabla informa capacidades documentadas de modelos existentes. Las entradas de GLM-5.4 siguen siendo desconocidas en lugar de heredar valores de cualquiera de sus predecesores. El contexto de evaluación de un modelo, la ventana de contexto de la API y la longitud máxima de salida son límites distintos.
El resumen de la arquitectura de GLM-5.3-Flash reporta 320B parámetros totales, 18B parámetros activados y atención híbrida dispersa-lineal. Estas son especificaciones divulgadas de Flash y no deben asignarse a GLM-5.4.
Codificación agéntica como posible dirección de mejora
La codificación agéntica es una de las áreas más creíbles a observar. GLM-5.3 ya demostró que escalar el posentrenamiento puede mejorar sustancialmente el rendimiento en tareas de ingeniería multietapa. Sus desarrolladores enfatizaron trabajo con repositorios complejos, horizontes de ejecución más largos y una mejor resolución de problemas impulsada por herramientas.
Un modelo futuro podría ampliar estas capacidades mediante una mejor interacción con el entorno, una planificación más fiable y menos llamadas a herramientas fallidas.
La evaluación más útil no se limitaría a medir el porcentaje de preguntas de codificación respondidas correctamente. Mediría si un agente puede completar tareas complicadas de extremo a extremo, incluyendo depuración, pruebas, revisión y recuperación tras fallos.
Arquitectura multimodal eficiente como posible dirección
GLM-5.3-Flash proporciona un punto de referencia arquitectónico para el desarrollo futuro, mientras que ninguna fuente oficial revisada establece su uso en GLM-5.4.
Z.ai describe un corpus de preentrenamiento multimodal de 30T tokens como parte del diseño orientado a la eficiencia de GLM-5.3-Flash. Esto describe la escala de datos de entrenamiento de un modelo existente y no es un compromiso de la hoja de ruta para GLM-5.4.
El resumen oficial de Flash reporta 3.01× menos cómputo de atención y 4.44× menores requisitos de caché KV frente a GLM-5.3 bajo la comparación indicada. Estos son resultados de eficiencia a nivel de componente, no una garantía de aceleración en aplicación o descuento en la API.
Son mejoras de ingeniería significativas, pero no hay confirmación de que GLM-5.4 herede la misma arquitectura. Un modelo de próxima generación más grande podría priorizar el máximo rendimiento en razonamiento, mientras que una variante Flash separada podría continuar optimizando latencia y costo.
GLM 5.4 vs GLM-5.3 vs GLM-5.3-Flash
Línea base de benchmarks de GLM-5.3
Los datos de benchmarks disponibles respaldan un análisis de la trayectoria de rendimiento de GLM-5.3, no una medición directa de GLM-5.4. Los valores a continuación son evaluaciones reportadas por Z.ai de modelos existentes. No han sido reproducidos de forma independiente para este artículo y no miden GLM-5.4. Cada benchmark utiliza su propio conjunto de tareas y método de puntuación; las diferencias de puntuación no deben interpretarse como ganancias equivalentes entre tareas.
| Benchmark y metodología | GLM-5.2 | GLM-5.3 | GLM-5.3-Flash | Diferencia GLM-5.3 vs GLM-5.2 |
|---|---|---|---|---|
| Terminal Bench 3.0 | 4.6 | 28.3 | No reportado en la comparación citada de Flash | +23.7 puntos |
| DeepSWE v1.1 | 46.2 | 66.9 | 63.4 | +20.7 puntos |
| AutomationBench v1.0.6 | 26.2 | 48.2 | 48.8 | +22.0 puntos |
| CyberGym | 77.2 | 84.5 | No reportado en la comparación citada de Flash | +7.3 puntos |
| ExploitBench | 24.4 | 54.4 | No reportado en la comparación citada de Flash | +30.0 puntos |
| HLE with Tools | 54.7 | 62.5 | 55.3 | +7.8 puntos |
| GDPval-AA v2 | 1508 | 1769 | No reportado en la comparación citada de Flash | +261 Elo |
| Toolathlon Verified | 59.9 | No reportado en la comparación citada de GLM-5.3 | 78.4 | No disponible |
La tabla combinada coloca lado a lado los resultados de modelos existentes; no contiene mediciones de GLM-5.4. Un valor no reportado no es una puntuación de cero. Mantenga presentes las condiciones de evaluación de cada benchmark y trate las diferencias de GDPval-AA como Elo y no como puntos porcentuales.
Metodología: DeepSWE v1.1 usa mini-swe-agent, temperature 0.95, top_p 1.0, un tiempo de espera de seis horas y un contexto de 400K. AutomationBench usa la v1.0.6. HLE with Tools usa temperature 1.0, top_p 0.95, un límite de generación de 163,840 tokens y un límite de contexto de 300K con gestión de contexto. GDPval-AA v2 utiliza una escala Elo, por lo que su diferencia no es una ganancia en puntos porcentuales.
Para CyberGym y ExploitBench, Z.ai reporta Claude Code 2.1.207 con max reasoning effort, sin herramientas web, temperature 1.0, top_p 1.0 y un límite de salida de 128,000 tokens. CyberGym reporta pass@1 de una sola ejecución en 1,507 tareas con tiempo de espera ilimitado por tarea. ExploitBench usa hasta 300 rondas de interacción y promedia la cobertura sobre 41 tareas en tres revisiones. Las notas al pie de la tarjeta del modelo proporcionan los detalles del entorno específicos del benchmark.
Metodología de Flash: DeepSWE usa mini-swe-agent, 400K de contexto y seis horas de tiempo de espera; AutomationBench usa la v1.0.6. Toolathlon Verified informa pass@1 promediado sobre tres ejecuciones independientes mediante el servicio oficial de evaluación. HLE usa los ajustes de muestreo y gestión de contexto descritos arriba. Consulte la metodología de la tarjeta del modelo de Flash. Estos resultados de benchmarks no establecen la latencia ni el costo en producción.
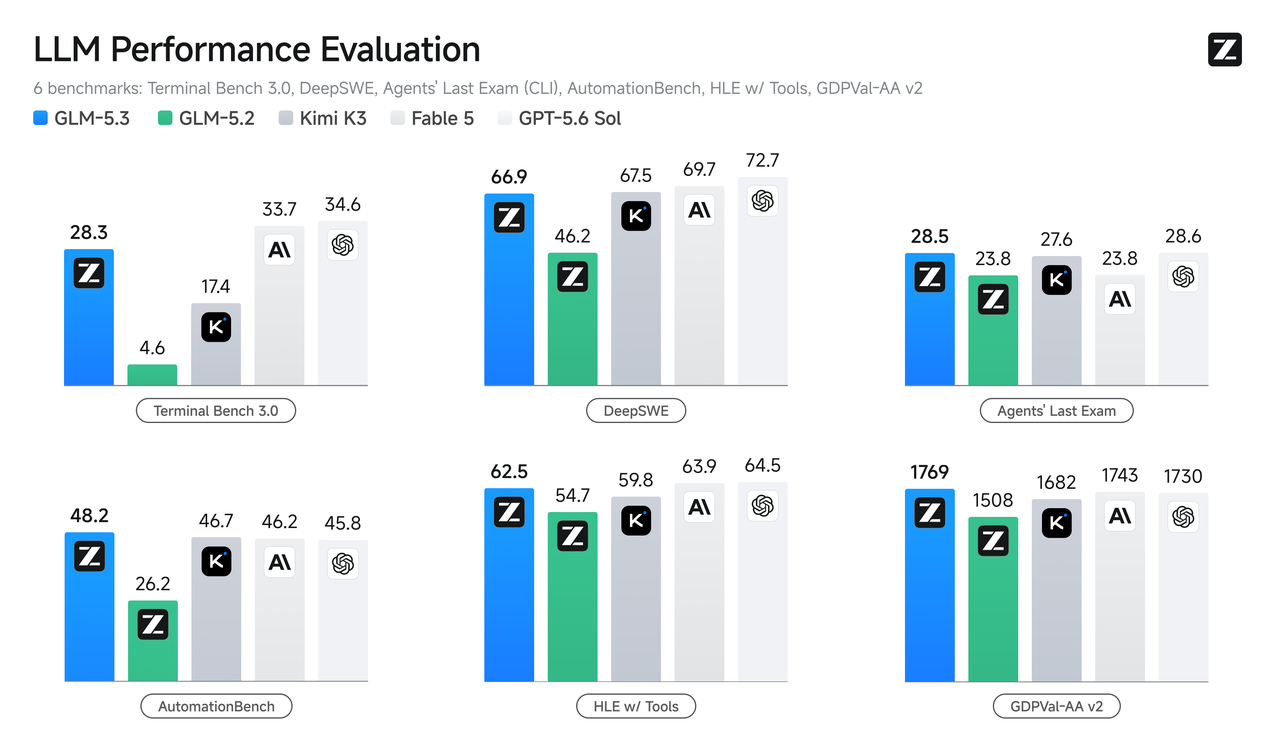
Gráfico oficial de rendimiento de GLM-5.3, reproducido del anuncio de benchmarks de Z.ai. La imagen muestra evaluaciones de modelos predecesores; no contiene resultados de GLM-5.4.
Las mayores mejoras aparecen en tareas que requieren interacción sostenida con un entorno. Terminal Bench 3.0 aumentó de 4.6 a 28.3, mientras que ExploitBench mejoró de 24.4 a 54.4.
Estas ganancias sugieren que el posentrenamiento y los entornos orientados a agentes pueden alterar drásticamente el rendimiento de un modelo sin cambiar su arquitectura base subyacente. Sin embargo, no deben extrapolarse a una predicción numérica para GLM-5.4.
Capacidades y adecuación para producción
Para producción, GLM-5.3 es la referencia más sólida para codificación compleja, ingeniería de largo horizonte y evaluación de ciberseguridad. GLM-5.3-Flash añade entradas visuales nativas y enfatiza el uso eficiente de herramientas. Las ofertas existentes GLM-5.2, GLM-5.3 y Flash proporcionan una línea de base; no se ha establecido una capacidad o disponibilidad equivalente de GLM-5.4 en las fuentes revisadas para este artículo.
Los modelos documentados admiten hasta 1M de contexto, pero ese límite no garantiza un contexto utilizable idéntico ni un rendimiento de tarea idéntico en cada endpoint. Elija entre ellos utilizando cargas de trabajo representativas y costo por tarea completada con éxito.
Un futuro GLM-5.4 tendría que ofrecer una mejora medible para justificar la migración. Mejorar la precisión en benchmarks mientras se duplican los costos de finalización de tareas puede no ser atractivo para despliegues en producción. Por el contrario, una ganancia modesta en precisión y sustancialmente menos llamadas a herramientas podría ser valiosa a escala.
Compare el éxito de las tareas, los tokens de entrada y salida, la latencia, las llamadas a herramientas fallidas y el costo por tarea exitosa bajo el mismo arnés de evaluación. Las descripciones cualitativas de modelos no son una prueba controlada cara a cara.
¿Cuál es el estado actual de la API de GLM-5.4 en CometAPI?
CometAPI ha creado una página dedicada al modelo GLM 5.4 con una entrada de identificador de modelo estable. Sin embargo, la página aún etiqueta el modelo como “Próximamente” y lo describe como un modelo previo al lanzamiento. Los desarrolladores deben verificar el ID real del modelo, el acceso a la cuenta, la disponibilidad del endpoint, los parámetros soportados, los límites de contexto y la tarificación antes de intentar su uso en producción.
Para una integración documentada actualmente, utilice un modelo GLM disponible como GLM-5.2 o GLM-5.3. La página de GLM-5.4 de CometAPI debe tratarse actualmente como una entrada de catálogo previa al lanzamiento hasta que el ID del modelo y el endpoint se confirmen como invocables.
Preparación para la integración con la API de GLM 5.4
La preparación más práctica es evitar acoplar la lógica de la aplicación a una sola versión de modelo. Un identificador de modelo configurable facilita evaluar actualizaciones sin reescribir la canalización de solicitudes.
Mantenga configurable el identificador de modelo y use un modelo GLM disponible para establecer una línea de base funcional. Antes de cambiar a GLM-5.4, confirme un ID de modelo invocable, acceso a la cuenta, parámetros de solicitud soportados, límites de contexto y salida, comportamiento de streaming y compatibilidad de llamadas a herramientas. Mantenga lista una opción de reversión.
Cuando GLM-5.4 esté oficialmente disponible, verifique el ID de modelo, los parámetros soportados, los límites de contexto y la compatibilidad del endpoint. Ejecute los modelos antiguo y nuevo contra el mismo conjunto de evaluación, rastreando la tasa de éxito, la latencia, los tokens de salida, los fallos de llamadas a herramientas y el costo por ejecución exitosa.
¿Cómo podría ser la tarifa de la API de GLM 5.4?
No se ha anunciado un precio oficial de API para GLM-5.4. Por lo tanto, sería engañoso publicar una tarifa específica de tokens de entrada o salida como si fuera una filtración auténtica.
La familia GLM actual ilustra por qué el tamaño del modelo por sí solo es insuficiente para predecir precios. GLM-5.3-Flash introdujo optimizaciones arquitectónicas diseñadas para ofrecer inteligencia competitiva a un costo de inferencia sustancialmente menor.
La comparación del Artificial Analysis Intelligence Index v4.1.1 de Z.ai reporta una puntuación de 57 a un costo estimado con descuento de $0.045 por tarea para GLM-5.3-Flash. Este costo de evaluación no es una tarifa de tokens de entrada/salida y no predice la tarificación de GLM-5.4.
La futura tarificación de GLM-5.4 podría depender de la arquitectura, el esfuerzo de razonamiento, descuentos por tokens en caché, la infraestructura de hosting y las variantes. Para la planificación de producción, el costo por tarea completada con éxito suele ser más valioso que la tarifa más baja de tokens de entrada.
¿Deberían los desarrolladores esperar a GLM 5.4?
Para la mayoría de los desarrolladores, esperar un modelo no anunciado es innecesario. Los modelos GLM existentes proporcionan capacidades documentadas de codificación y agentes que pueden probarse en aplicaciones reales.
Los equipos que construyen asistentes de programación o agentes de ingeniería multietapa pueden establecer una línea de base con GLM-5.3. Las aplicaciones que enfatizan la comprensión visual, el contexto largo y llamadas repetidas eficientes pueden evaluar GLM-5.3-Flash.
Construya un arnés de evaluación ahora y reserve un espacio de comparación futura para GLM-5.4. Cuando esté disponible, su lanzamiento importará si mejora los resultados que cuentan para una aplicación concreta.
Los investigadores deben observar nueva arquitectura fundacional, cambios en benchmarks de largo horizonte y fiabilidad de extremo a extremo. Las empresas deben priorizar disponibilidad, costo, latencia, compatibilidad y calidad en datos representativos de producción.
Conclusión
GLM 5.4 es un siguiente paso plausible en la familia de modelos en rápida evolución de Z.ai, pero su narrativa actual sigue siendo más especulativa que confirmada.
Union Alpha es una pista de identidad no verificada, y la cadencia de lanzamientos solo avala una hipótesis temporal amplia. Ninguna establece una fecha de lanzamiento. Las fuentes oficiales revisadas el 14 de octubre de 2026 proporcionan una base para modelos existentes más que un lanzamiento confirmado de GLM-5.4.
Lo verificable es el progreso ya logrado por GLM-5.3 y GLM-5.3-Flash. Ganancias significativas en codificación agéntica, evaluación de ciberseguridad y eficiencia de inferencia establecen una línea de base exigente para cualquier sucesor.
La pregunta clave es si Z.ai puede ofrecer ejecución autónoma fiable, razonamiento más sólido y un costo competitivo por tarea completada. Hasta que aparezcan especificaciones y benchmarks oficiales, GLM-5.4 debe tratarse como un lanzamiento potencial, no como un producto disponible.
Preguntas frecuentes
¿Cómo puedo verificar un listado de API de GLM 5.4?
Compruebe que el proveedor suministra un identificador de modelo invocable, un endpoint soportado, condiciones de acceso y precios actuales. Luego compare la identidad con un anuncio o documentación oficial de Z.ai. Un listado de proveedor puede establecer la oferta de ese proveedor, pero no autentica por sí mismo el desarrollador subyacente de un modelo anónimo.
¿Qué comprobaciones de compatibilidad importan antes de una migración a GLM 5.4?
Valide parámetros de solicitud, ajustes de razonamiento, esquema de llamadas a herramientas, salida estructurada, comportamiento de streaming, límites de contexto y salida máxima en su endpoint real. Incluya pruebas negativas para parámetros no soportados y mantenga el modelo existente disponible para reversión. La compatibilidad con OpenAI describe una interfaz; no garantiza un comportamiento de modelo idéntico.
¿Cómo debo evaluar GLM 5.4 para agentes de programación?
Utilice un conjunto fijo de tareas representativas de repositorio con las mismas herramientas, permisos, tiempo de espera y arnés para ambos modelos. Cuente cambios probados exitosos, recuperación ante fallos de herramientas, uso de tokens, latencia y costo total. Registre cada ejecución y repita las tareas lo suficiente como para exponer la variabilidad en lugar de promocionar un ejemplo favorable.
¿Qué justificaría esperar a GLM 5.4?
Esperar es razonable solo cuando una capacidad próxima documentada aborda un requisito que los modelos disponibles no pueden cumplir y el retraso encaja en su cronograma de entrega. Con solo un rumor, construya sobre un modelo disponible y mantenga configurable la selección de modelo. Defina los umbrales de capacidad y costo que una versión posterior debe cumplir antes de reemplazar su línea de base.