Construye con CometAPI¿Necesitas una sola API para varios modelos?Prueba el flujo en el Playground y luego crea una clave de API cuando el modelo y el costo encajen con tu caso de uso.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: Pruebas de rendimiento, características y precios
Compare GPT-6.1 Terra y DeepSeek V4.1 Flash en pruebas de referencia, programación, visión, contexto, precios de la API y acceso a CometAPI, para determinar cuál es mejor.
lesileEquipo de investigación de modelos de IA y API
TL;DR: GPT-6.1 Terra es el punto de partida más sólido cuando la calidad de razonamiento y los flujos de trabajo visuales complejos importan más; DeepSeek V4.1 Flash resulta atractivo cuando la prioridad es el costo por token, la velocidad de generación o el autoalojamiento. Esta comparación utiliza la actualización de DeepSeek del 17 de octubre, Flash-1017.
DeepSeek Flash-1017 tiene precios por token más bajos, pero el costo de una tarea completada también depende de la longitud del razonamiento, los reintentos y las llamadas a herramientas.
La comparación a continuación abarca arquitectura, contexto, razonamiento, programación, visión, velocidad, precios y despliegue. Los precios y las páginas de evaluación en vivo se verificaron el 28 de octubre de 2026.
Conclusiones clave
Terra encabeza la comparación independiente citada del Intelligence Index, lo que la convierte en la primera candidata lógica para tareas exigentes de razonamiento.
Revisado para mayor claridad, atribución de fuentes y terminología API actual.
DeepSeek tiene precios por token listados más bajos. Compare la latencia de extremo a extremo y el costo por tarea exitosa, incluidos las tarifas en horas pico, el uso de caché, los tokens de razonamiento y los reintentos.
Evalúe la programación por los parches aceptados y los flujos de trabajo visuales por las tareas completadas. Las puntuaciones de benchmarks publicados aportan evidencia útil, pero las configuraciones de prueba difieren.
Terra es un modelo propietario alojado. DeepSeek ofrece pesos descargables con licencia MIT para autoalojamiento, con costos de hardware y operación a considerar.
CometAPI proporciona una interfaz de texto compartida para probar ambos modelos. Verifique la versión de modelo resuelta y el soporte para herramientas, controles de razonamiento y salida estructurada antes de implementar.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: Visión general y especificaciones
Las principales diferencias de especificaciones se refieren a los límites de salida, los controles de razonamiento, las llamadas a herramientas y el despliegue. La siguiente tabla resume los dos modelos.
Arquitectura propietaria; recuento de parámetros no divulgado
552B MoE codificador–decodificador causal; aproximadamente 8B parámetros activos para entrada y 16B para salida
Ventana de contexto
1,050,000 tokens
1M tokens
Salida máxima
128,000 tokens
384K tokens
Modalidades de entrada
Texto, imágenes
Texto, imágenes
Modalidades de salida
Texto
Texto
Controles de razonamiento
none, low, medium, high, xhigh, max
Conmutador de pensamiento; low, high, max en Chat Completions
Llamada a herramientas
Compatible a través del Responses API
Compatible; el comportamiento depende del endpoint y del modo de pensamiento
Pesos abiertos
No
Sí, licencia MIT
Arquitectura y versiones del modelo
Terra utiliza una arquitectura propietaria cuyo recuento de parámetros no se divulga públicamente. DeepSeek-V4.1-Flash utiliza una arquitectura MoE codificador–decodificador causal, con diferentes presupuestos de parámetros activos para el procesamiento de entrada y la generación de salida.
La versión V4.1 Flash de DeepSeek describe una columna vertebral de mezcla de expertos (MoE) codificador–decodificador causal de 552B parámetros, con aproximadamente 8B parámetros activos durante el procesamiento de entrada y 16B durante la generación de salida. La actualización del 17 de octubre mejora sus resultados publicados en programación, agentes y visión.
A lo largo de este artículo, Flash-1017 se refiere a ese checkpoint de octubre. Un alias genérico del API puede apuntar posteriormente a otra versión, por lo que un registro de evaluación debe incluir la versión del modelo realmente servida.
Caché KV y requisitos de despliegue
DeepSeek informa una huella global de caché KV de aproximadamente 890 bytes por token, alrededor de una cuarta parte de la de DeepSeek-V4-Flash. Esto mejora la eficiencia de la caché, aunque el autoalojamiento sigue requiriendo recursos sustanciales para los pesos del modelo. Terra está disponible mediante servicios alojados, mientras que los pesos descargables de DeepSeek ofrecen una opción adicional de autoalojamiento.
Controles de razonamiento y llamadas a herramientas
Ambos modelos admiten flujos de trabajo de agentes, pero los controles de razonamiento y los requisitos de llamadas a herramientas difieren. El soporte de llamadas a herramientas de Terra documentado utiliza el Responses API. La ficha del modelo de DeepSeek describe un esfuerzo de razonamiento numérico de 1 a 100; los controles del API alojado deben verificarse por separado. Al cambiar de modelo, adapte los parámetros de razonamiento y las definiciones de herramientas al endpoint seleccionado.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: Rendimiento
La comparación a continuación cubre razonamiento, programación, visión y tareas de largo contexto. Las evaluaciones independientes y los benchmarks reportados por los proveedores se identifican por separado, con resultados interpretados junto con sus configuraciones de modelo y marcos de agentes.
Razonamiento y conocimiento
Artificial Analysis reporta una puntuación de 51 para GPT-6.1 Terra (Max) y 32 para DeepSeek Flash-1017 (Max) en el Intelligence Index v5.0, en las configuraciones citadas, a fecha del 28 de octubre de 2026. El índice combina nueve evaluaciones.
La mayor puntuación agregada de Terra respalda probarla primero para tareas exigentes de razonamiento. Para cargas de trabajo más acotadas, DeepSeek puede seguir siendo la mejor opción si cumple la precisión requerida a un menor costo por tarea exitosa.
Benchmarks oficiales de programación y agentes
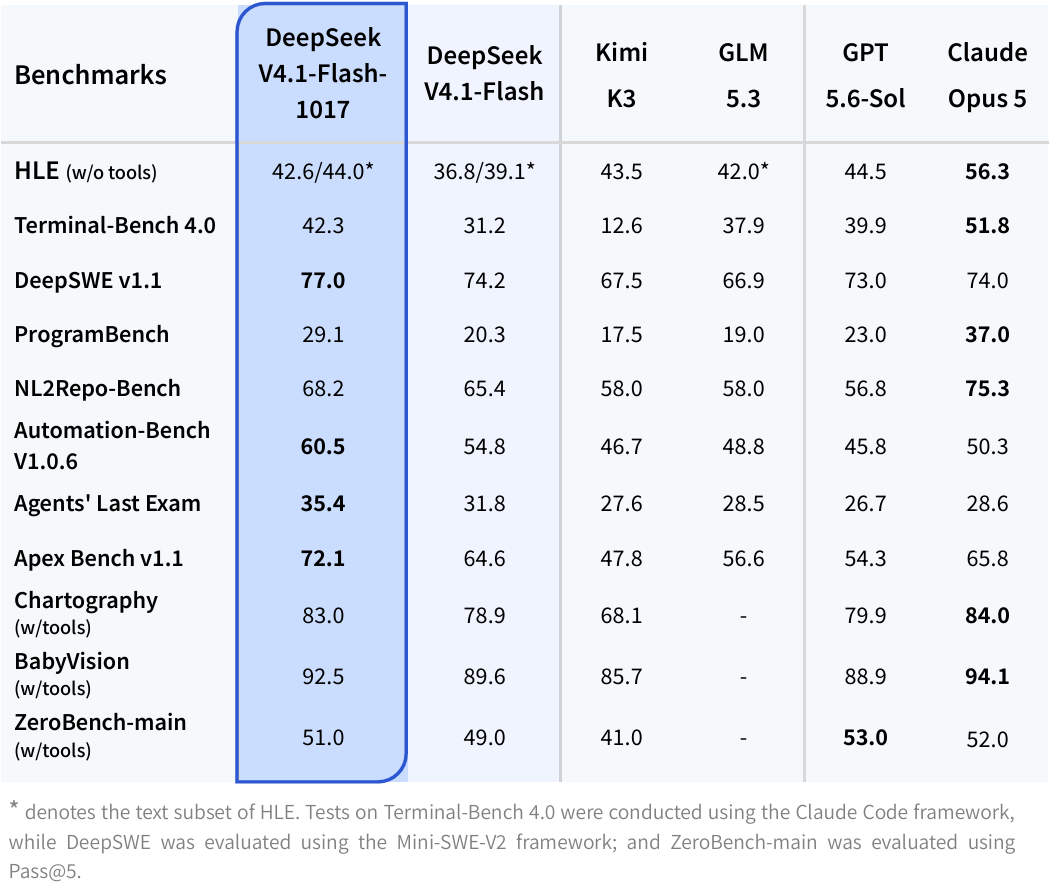
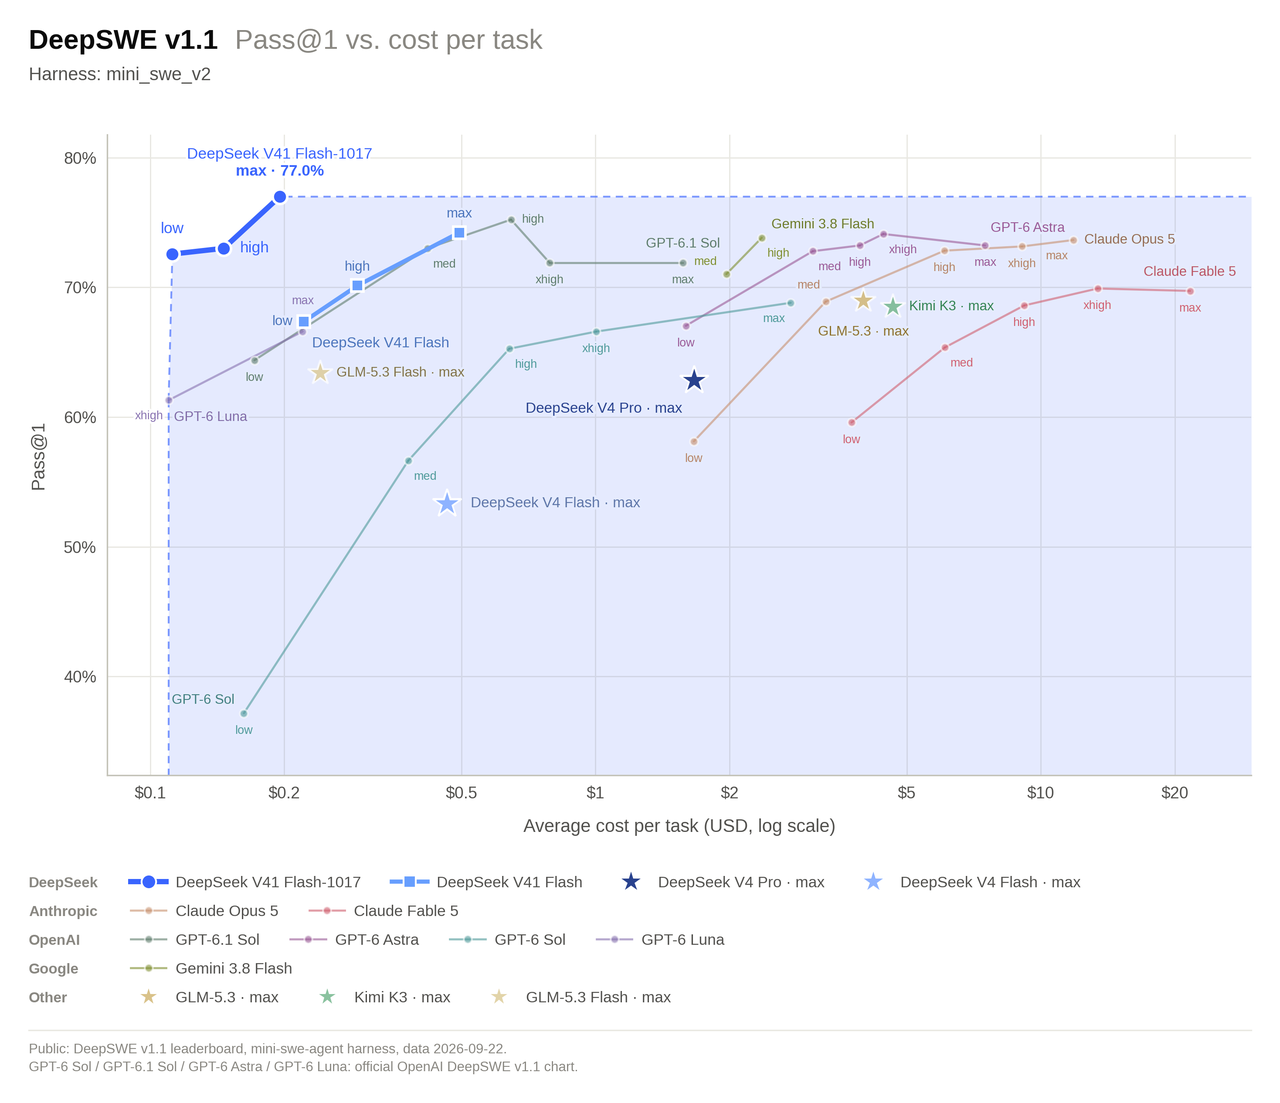
Terminal-Bench 4.0 y DeepSWE v1.1 aportan evidencia sobre el desempeño en programación y agentes. Al comparar resultados de proveedores, identifique la versión exacta del modelo, la configuración de razonamiento, el framework de agente y la métrica de puntuación; las diferencias en estos ajustes pueden afectar materialmente las puntuaciones.
Para trabajo práctico de programación, compare si cada modelo produce parches que superen las pruebas existentes, preserven las interfaces públicas, manejen casos límite y eviten cambios no relacionados. La confiabilidad de las llamadas a herramientas y la recuperación tras errores de ejecución también afectan cuánto trabajo puede completar un agente.
Los precios por token listados más bajos de DeepSeek lo convierten en un candidato útil para mantenimiento repetitivo de repositorios con criterios de aceptación claros. Para cambios complejos, compare ambos modelos por parches aceptados, costo total de la tarea y tiempo de corrección humana.
Visión y uso del ordenador
Ambos modelos aceptan entradas de imagen, pero la comprensión de imágenes y la interacción con el escritorio requieren capacidades diferentes. El material de lanzamiento de Terra de OpenAI menciona MMMU-Pro y OSWorld 2.1, mientras que la ficha del modelo de DeepSeek reporta tareas visuales como Chartography y BabyVision, con ajustes asistidos por herramientas.
Para extracción de documentos, compare la precisión de campos, el texto omitido y la estructura de tablas. Para automatización de escritorio, compare flujos de trabajo completados, acciones incorrectas y recuperación tras cambios en la interfaz. Un modelo que describa con precisión una captura de pantalla aún puede tener dificultades para operar la aplicación que muestra.
Elija según el flujo de trabajo: la precisión de extracción es lo más importante en el procesamiento de documentos, mientras que las acciones confiables y la recuperación pesan más en agentes de uso del ordenador. Compare el costo solo después de que ambos modelos cumplan el umbral de calidad requerido.
Razonamiento y recuperación de largo contexto
Ambos modelos admiten flujos de trabajo con documentos largos, pero la capacidad de contexto por sí sola no determina la calidad de recuperación. Compárelos sobre la misma colección de documentos, colocando evidencia importante cerca del inicio, la mitad y el final.
Evalúe la precisión de las respuestas, los pasajes de apoyo, la consistencia entre documentos y la completitud de la respuesta. Para investigación y análisis documental, prefiera el modelo que recupere y conecte de forma fiable la evidencia relevante dentro de sus requisitos de latencia y costo.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: Velocidad
Rendimiento de salida y tiempo de finalización de tareas
La latencia merece un tratamiento separado de la calidad de razonamiento.
En las páginas de Artificial Analysis del 28 de octubre, la velocidad de salida de Flash-1017 (Max) es de 173.4 tokens por segundo, mientras que la velocidad de salida de Terra (Max) es de 90.9. Esas mediciones describen las configuraciones servidas al evaluador, no tasas garantizadas en todos los proveedores.
Un modelo que genera tokens más rápido aún puede tardar más en terminar si produce más razonamiento, espera herramientas o reintenta. Mida el tiempo hasta el primer token, el tiempo total de finalización y la latencia de tareas aceptadas por separado.
Latencia interactiva en su ruta de API
Para un producto interactivo, pruebe prompts cortos y largos con concurrencia realista y registre la latencia mediana y del percentil 95. Mantenga región, ruta de API, caché de prompts, configuraciones de razonamiento y política de reintentos en los resultados. Ese registro le dirá más sobre la experiencia del usuario que una sola cifra de tokens por segundo.
GPT-6.1 Terra vs DeepSeek V4.1 Flash: Costo
El precio es una de las diferencias más claras entre estos modelos.
La lista de tarifas de Terra y la política de precios de DeepSeek arrojan las siguientes tarifas de primera parte verificadas el 28 de octubre de 2026. Todos los precios son dólares estadounidenses por millón de tokens.
Tarifas oficiales del API
Categoría de tokens
GPT-6.1 Terra Estándar
DeepSeek Flash fuera de pico
DeepSeek Flash en pico
Entrada, fallo de caché
$1.00
$0.15
$0.30
Entrada, acierto de caché
$0.05
$0.003
$0.006
Salida
$5.00
$0.60
$1.20
La tarifación en pico de DeepSeek aplica de lunes a viernes, 01:00–04:00 y 06:00–10:00 UTC, excluyendo los festivos públicos de China. Eso corresponde a 09:00–12:00 y 14:00–18:00 en hora estándar de China (UTC+8). Otros periodos usan las tarifas fuera de pico.
Para solicitudes de Terra por encima de 272,000 tokens de entrada, OpenAI especifica tarifas 2× para entrada y entrada en caché y 1.5× para salida en toda la solicitud. Compare esas condiciones con el tamaño real de sus prompts antes de tratar el precio base como el precio efectivo.
Tarifas de CometAPI
Tarifa base de CometAPI por 1M de tokens
GPT-6.1 Terra API
DeepSeek V4.1 Flash API
Entrada sin caché
$0.80
$0.12
Salida
$4.00
$0.48
Entrada en caché
No especificado por separado
$0.0024
Multiplicador basado en tiempo
No especificado en precios base
2× durante las ventanas en pico listadas
CometAPI lista las ventanas de pico de DeepSeek como de lunes a viernes, 01:00–04:00 y 06:00–10:00 UTC. Su programación listada no establece la misma excepción por festivos que la política de primera parte de DeepSeek. Verifique las condiciones de facturación de la ruta seleccionada para su tiempo de ejecución previsto.
Ejemplo de costo con tokens fijos
Considere una solicitud que consume 100,000 tokens de entrada sin caché y genera 10,000 tokens de salida.
Si esos son los totales de tokens facturados completos, el cargo por tokens es de $0.150 para Terra, $0.021 para DeepSeek fuera de pico o $0.042 para DeepSeek en pico. La reducción fuera de pico es del 86%. El ejemplo excluye tarifas adicionales de herramientas, infraestructura y reintentos; cualquier token de razonamiento contado por separado también debe entrar en el cálculo.
Con las tarifas base listadas de CometAPI, los mismos 100,000 de entrada y 10,000 de salida cuestan $0.120 para Terra o $0.0168 para Flash. Aplicando el multiplicador de 2× en pico listado da $0.0336 para Flash. Estos son cálculos solo de tokens usando los conteos indicados, no mediciones de una tarea real.
Cuando una salida adicional elimina la ventaja del precio por token
Mantenga la entrada sin caché en 100,000 tokens y la salida total facturada de Terra en 10,000 tokens. La factura estándar por tokens de Terra es entonces de $0.150. Flash alcanza la misma factura con 225,000 tokens de salida facturados fuera de pico, o 100,000 en tarifas de pico. Esta aritmética aísla el volumen de salida; la caché, la entrada repetida, las tarifas de herramientas y los reintentos cambian la comparación.
Costo por tarea exitosa
Evalúe un lote fijo de tareas y divida todo el gasto facturado del API y herramientas entre el número de tareas que pasan sus verificaciones de aceptación. Cuente también el gasto de los intentos fallidos. Informe la tasa de éxito junto con este costo para que un modelo no se vea recompensado simplemente por completar solo los trabajos más fáciles.
Costo por tarea exitosa = Costo total de API y herramientas / Tareas completadas con éxito
¿Cuál debería elegir: GPT-6.1 Terra o DeepSeek-V4.1-Flash?
Elija según los requisitos de calidad de la tarea, los objetivos de costo y las necesidades de despliegue. Use los resultados de benchmarks anteriores para decidir qué modelo probar primero.
Caso de uso
Candidata inicial
Qué debería decidir la elección
Razonamiento exigente
GPT-6.1 Terra
Precisión y trabajo correctivo en tareas difíciles representativas
Agentes de programación
Probar ambos
Parches aceptados, pruebas de regresión, fallos de herramientas y costo total
Flujos de trabajo visuales complejos
GPT-6.1 Terra
Flujos completados y recuperación tras errores de interfaz
Extracción de texto o imágenes de alto volumen
DeepSeek Flash-1017
Si la precisión de extracción cumple el umbral requerido
Recuperación en documentos largos
Probar ambos
Recuperación de evidencia y precisión de respuestas en distintas posiciones de entrada
Autoalojamiento
DeepSeek Flash-1017
Hardware disponible, costos operativos y control sobre los pesos
Aplicaciones interactivas
Probar ambos
Latencia mediana y en cola en la ruta del proveedor seleccionada
Cuándo elegir GPT-6.1 Terra
Priorice la evaluación de Terra cuando el razonamiento complejo sea central para la tarea. Para flujos de trabajo exigentes de visión o uso del ordenador, inclúyala en el conjunto de pruebas y mida tareas completadas, errores y recuperación.
La cuestión clave es si Terra reduce los intentos fallidos y la corrección manual lo suficiente como para justificar su mayor precio por token.
Cuándo elegir DeepSeek-V4.1-Flash
Empiece con DeepSeek-V4.1-Flash para tareas repetitivas y de alto volumen con criterios de aceptación claros y objetivos de costo estrictos. Elíjalo si las salidas cumplen sus requisitos de calidad a un menor costo por tarea exitosa.
Los pesos con licencia MIT de DeepSeek también lo convierten en la opción relevante cuando el autoalojamiento es un requisito. Incluya los costos de hardware y operación en esa decisión.
Cuándo probar ambos modelos
Pruebe ambos cuando la calidad de programación, la confiabilidad de herramientas, la latencia o la precisión en documentos largos sea crítica. Use tareas representativas con las mismas entradas, herramientas, límites de ejecución y criterios de aceptación.
Compare la tasa de finalización exitosa, el costo total por tarea exitosa, la latencia de extremo a extremo y el tiempo de corrección humana. Registre la versión del modelo y las configuraciones de razonamiento para que los resultados sean reproducibles.
Una configuración híbrida puede iniciar tareas rutinarias con DeepSeek y escalar fallos seleccionados a Terra. Mida el costo y la tasa de finalización del flujo completo para confirmar que la llamada adicional al modelo merece la pena.
¿Dónde puede acceder a GPT-6.1 Terra y DeepSeek V4.1 Flash?
Use el API alojado de OpenAI para Terra o el API alojado de DeepSeek para Flash. Confirme el identificador de modelo actual, los límites de cuenta y el endpoint compatible antes de la integración. Los pesos descargables de Flash-1017 proporcionan una opción separada de autoalojamiento.
Acceso a través de CometAPI
CometAPI ofrece una interfaz compatible con OpenAI que puede simplificar el desarrollo de aplicaciones multi-modelo.
Use GPT-6.1 Terra API y DeepSeek V4.1 Flash API con un cliente de texto compartido, y añada controles específicos de modelo solo después de verificar el soporte de la ruta.
Compare respuestas de texto a través de CometAPI
Para probar ambos modelos con un solo cliente de texto, use el SDK de Python de OpenAI con su clave de CometAPI y el endpoint https://api.cometapi.com/v1. Mantenga la clave en una variable de entorno, luego envíe el mismo prompt a las rutas gpt-6.1-terra y deepseek-v4.1-flash y compare las respuestas devueltas y el uso de tokens.
Por ejemplo, pida a cada modelo que revise un flujo de pagos que reintenta solicitudes con tiempo de espera agotado sin una clave de idempotencia y registra cuerpos de solicitud completos. Compare cuán claramente las respuestas identifican riesgos de confiabilidad y privacidad y explican soluciones prácticas. Un prompt compartido facilita inspeccionar las respuestas, pero una solicitud de texto por defecto no iguala los presupuestos de razonamiento ni establece un ranking de desempeño. Confirme el checkpoint servido por cada ruta antes de tratar un resultado como evidencia sobre Flash-1017.
Conclusión
GPT-6.1 Terra ofrece el resultado agregado de razonamiento más sólido actualmente, mientras que DeepSeek Flash-1017 combina precios por token más bajos, generación de salida más rápida medida y despliegue con pesos abiertos. La elección útil es el modelo que cumple sus requisitos de calidad y latencia al menor costo total.
Comience con una carga de trabajo representativa, mantenga constante el entorno de herramientas y los criterios de aceptación, y compare el costo de las finalizaciones exitosas. Una integración de texto compartida con CometAPI puede facilitar esa evaluación, mientras que las funciones específicas de cada modelo aún requieren su propia configuración.
Preguntas frecuentes
¿Por qué la misma tarea puede producir facturaciones de tokens diferentes con Terra y Flash-1017?
Un prompt de texto no necesariamente se convierte en el mismo número de tokens en dos modelos. Las respuestas generadas y la longitud del razonamiento también pueden diferir. Compare el uso informado por cada ruta para tareas idénticas, incluidos los tokens de razonamiento en caché y facturables cuando se informen, en lugar de aplicar ambas listas de precios a un mismo conteo de tokens estimado.
¿Pueden GPT-6.1 Terra y DeepSeek V4.1 Flash compartir una caché de prompts?
Puede reutilizar el texto del prompt en su aplicación, pero no asuma que una caché creada para un modelo o proveedor reduce la factura del otro. La elegibilidad y la contabilidad de la caché son específicas de la ruta. Verifique los campos de uso de cada respuesta y pruebe solicitudes repetidas antes de incorporar ahorros en un pronóstico.
¿Cómo debo validar la salida estructurada de Terra y Flash-1017?
Defina los campos y tipos requeridos en su aplicación antes de elegir un modelo. Si una ruta ofrece salida en JSON o restringida por esquema, verifique el modo exacto que admite, luego analice la respuesta y valídela contra su esquema. Trate los campos faltantes, valores inválidos, salida truncada y rechazos como resultados separados. El JSON válido por sí solo no establece que los hechos extraídos sean correctos.