Construye con CometAPI¿Necesitas una sola API para varios modelos?Prueba el flujo en el Playground y luego crea una clave de API cuando el modelo y el costo encajen con tu caso de uso.
GPT-6.1 Terra vs. GPT-6.1 Sol: pruebas de rendimiento, precios y cuál elegir
Compare GPT-6.1 Terra y GPT-6.1 Sol en benchmarks oficiales, capacidad de razonamiento, precios de la API y cargas de trabajo prácticas, con un ejemplo en Python de CometAPI.
lesileEquipo de investigación de modelos de IA y API
Empieza con GPT-6.1 Terra para tareas de alto volumen, verificables y sensibles al costo. Evalúa GPT-6.1 Sol para codificación compleja, uso de herramientas en múltiples pasos y flujos de trabajo donde los fallos son costosos. Una práctica predeterminada es usar primero Terra y escalar a Sol cuando fallen pruebas o verificaciones de validación predefinidas.
Key Takeaways
Precios estándar de tokens: En OpenAI Standard, Terra cuesta $1 por millón de tokens de entrada y $5 por millón de tokens de salida; Sol cuesta $2 y $10, respectivamente.
Rendimiento específico por tarea: Con esfuerzo de razonamiento máximo, Terra lidera ligeramente en Agents’ Last Exam v1 y Terminal-Bench-Science 0.1, mientras que Sol lidera en Terminal-Bench 4.0 y OSWorld 2.1.
Capacidad de contexto compartida: Ambos modelos ofrecen una ventana de contexto de 1.05 millones de tokens y aceptan entradas de texto e imagen.
Controles de razonamiento diferentes: Terra permite desactivar el razonamiento con ; Sol requiere al menos esfuerzo de razonamiento .
Revisado para mayor claridad, atribución de fuentes y terminología API actual.
none
low
El costo operativo importa: Compare el gasto por tarea completada con éxito, incluyendo reintentos y llamadas a herramientas, y registre por separado los costos de revisión humana.
GPT-6.1 Terra vs GPT-6.1 Sol: Overview and Specifications
El siguiente panorama general resume las compensaciones. Las secciones detalladas explican la evidencia, los supuestos de facturación y los límites detrás de cada elección.
Factor de decisión
GPT-6.1 Terra
GPT-6.1 Sol
Carga de trabajo inicial
Trabajo visual rutinario y agentes repetibles
Codificación compleja y razonamiento profesional sostenido
Contexto y modalidades
Misma capacidad total de contexto; entrada de texto e imagen
Misma capacidad total de contexto; entrada de texto e imagen
Control de razonamiento
Incluye opción de razonamiento desactivado
Requiere al menos bajo esfuerzo de razonamiento
Patrón de rendimiento publicado
Rendimiento de menor costo en tareas de agentes repetibles
Más fuerte en varias pruebas difíciles de codificación y escritorio
Acceso a la API
OpenAI y CometAPI
OpenAI y CometAPI
GPT-6.1 Terra: flujos de trabajo eficientes para visión y agentes
OpenAI presentó GPT-6.1 Terra el 26 de octubre de 2026. Combina razonamiento visual, uso de computadoras y generación de texto de propósito general para flujos de trabajo profesionales rutinarios. Sus tarifas de tokens más bajas lo convierten en un punto de partida útil cuando las tareas son frecuentes y los resultados pueden verificarse.
GPT-6.1 Sol: codificación compleja y razonamiento profesional
GPT-6.1 Sol se lanzó el 29 de septiembre de 2026. Está orientado a trabajos exigentes de codificación y profesionales. Evalúalo cuando un repositorio desconocido, una larga cadena de acciones dependientes o correcciones costosas hagan valiosa una mayor capacidad de razonamiento.
Contexto, razonamiento y especificaciones de API
Especificación
GPT-6.1 Terra
GPT-6.1 Sol
Fecha de lanzamiento oficial
26 de octubre de 2026
29 de septiembre de 2026
ID de modelo de API
gpt-6.1-terra
gpt-6.1-sol
Ventana de contexto
1,050,000 tokens
1,050,000 tokens
Fecha límite de conocimiento
1 de junio de 2026
30 de abril de 2026
Entrada / salida
Texto e imágenes / texto
Texto e imágenes / texto
Esfuerzo de razonamiento
none, low, medium, high, xhigh, max
low, medium, high, xhigh, max
Esfuerzo de razonamiento predeterminado
medium
medium
API features: Ambos modelos admiten Structured Outputs, streaming y Batch API. Tool calling utiliza Responses API y no se admite el fine-tuning. Verifica que el proveedor y el endpoint que elijas ofrezcan las funciones que tu aplicación necesita.
Ambos modelos permiten hasta 128,000 tokens de salida dentro de una ventana de contexto de 1,050,000 tokens. Reservar la asignación completa de salida deja 922,000 tokens para el resto del intercambio, incluyendo tu entrada, instrucciones del sistema e historial de herramientas. Esto es un cálculo de planificación, no un límite de entrada fijo separado.
Architecture disclosure: Las especificaciones públicas del modelo vinculadas no proporcionan suficiente detalle interno de arquitectura para una comparación confiable. La capacidad de contexto y los ajustes de razonamiento no deben tratarse como evidencia del número de parámetros o de la arquitectura.
Reasoning controls: La configuración none de Terra es útil para transformaciones y extracción sencillas. Para la primera comparación, usa la misma configuración de razonamiento admitida en ambos modelos y luego ajusta cada modelo en función de la calidad y latencia que requiera tu carga de trabajo.
Ambos modelos tienen la misma capacidad de contexto publicada, pero eso no implica una precisión de recuperación o calidad de razonamiento de largo contexto idénticas. La selección del modelo debe considerar por tanto la calidad del razonamiento, la eficiencia del flujo de trabajo, el costo y el rendimiento de recuperación específico de la tarea.
GPT-6.1 Terra vs GPT-6.1 Sol: Performance
Los resultados reportados muestran un panorama mixto: Terra lidera ligeramente en algunas evaluaciones de agentes y codificación científica, mientras que Sol obtiene puntajes más altos en codificación general en terminal, automatización de escritorio y visión. Las comparaciones a continuación separan los resultados de lanzamiento de OpenAI de evaluaciones independientes y explican qué puede—y no puede—indicar cada una sobre el rendimiento en producción.
Official Benchmark Results and Test Conditions
Los siguientes resultados provienen de las evaluaciones de lanzamiento de Terra por parte de OpenAI. Se muestra Terra con esfuerzo de razonamiento medium y máximo; Sol se muestra con esfuerzo máximo. La última columna compara solo las configuraciones de esfuerzo máximo.
OSWorld usa la evaluación offline 2.1. La prueba de factualidad utiliza prompts internos de OpenAI diseñados para inducir errores. Son resultados reportados por el proveedor a partir de configuraciones de evaluación específicas, más que mediciones de tu carga de trabajo de producción.
Benchmark
GPT-6.1 Terra (medium)
GPT-6.1 Terra (max)
GPT-6.1 Sol (max)
Comparación a esfuerzo máximo
Agents’ Last Exam v1
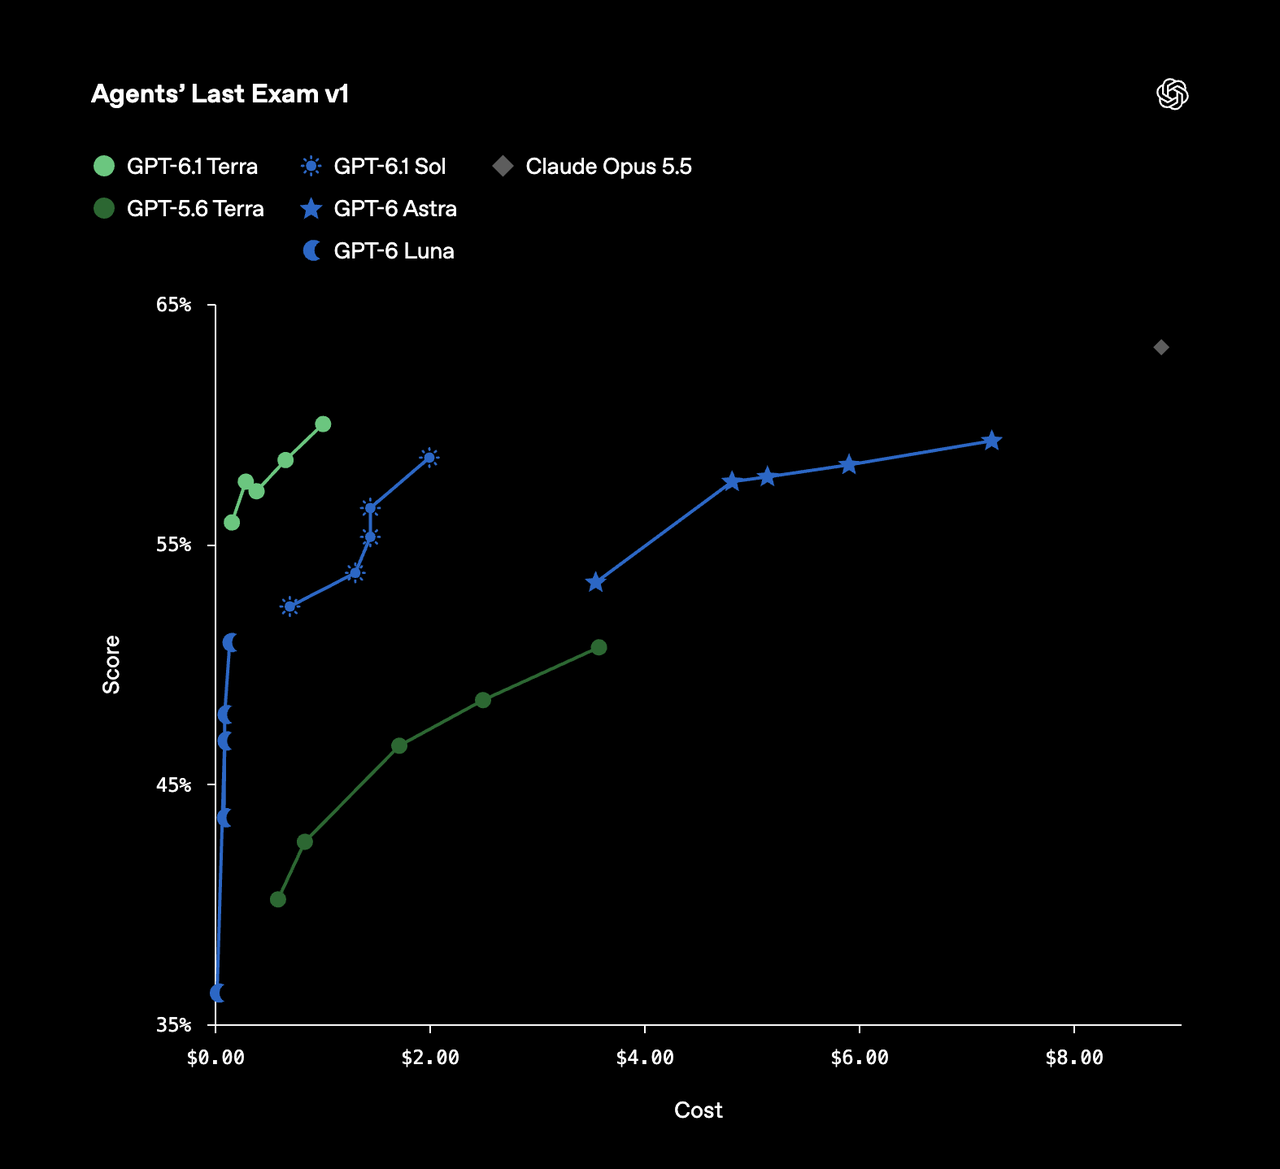
57.60%
60.00%
58.60%
Terra +1.4 pp
MMMU-Pro (Vision)
84.60%
85.50%
86.30%
Sol +0.8 pp
OSWorld 2.1, offline
66.70%
74.20%
78.00%
Sol +3.8 pp
Terminal-Bench 4.0
35.80%
50.30%
55.90%
Sol +5.6 pp
Terminal-Bench-Science 0.1
34.30%
58.30%
57.00%
Terra +1.3 pp
Tasa de errores fácticos en prompts difíciles
10.10%
4.30%
4.40%
Terra 0.1 pp inferior
Todos los puntajes son porcentajes; las diferencias se expresan en puntos porcentuales (pp). Solo la tasa de errores fácticos es mejor cuanto menor. La diferencia de 0.1 puntos en la tasa de error por sí sola no establece una ventaja de fiabilidad significativa.
Para ingeniería de software, la ventaja de Sol en Terminal-Bench y la ligera ventaja de Terra en Terminal-Bench-Science sugieren que los resultados dependen del tipo de tarea de codificación. Para flujos de trabajo de aplicaciones, el mayor puntaje de Sol en OSWorld respalda evaluarlo para automatización de escritorio, mientras que el resultado de Terra en Agents’ Last Exam lo convierte en candidato para tareas de agentes profesionales. Ningún patrón establece un ganador universal.
El andamiaje de agentes, el acceso a herramientas y la configuración del entorno pueden afectar estos resultados. Usa las cifras para identificar candidatos para pruebas y luego valídalos frente a los cambios de repositorio y los flujos de trabajo de aplicación que realmente necesitas completar.
El gráfico de Agents’ Last Exam v1 de OpenAI traza los puntajes frente a los costos estimados por tarea en diferentes configuraciones del modelo. Añade una perspectiva de eficiencia de costos a la tabla anterior; los costos representados son específicos de la configuración de evaluación.
Independent Intelligence and Coding Evaluations
La evaluación de Artificial Analysis del 26 de octubre sitúa a Terra cuatro puntos por debajo de Sol en su Intelligence Index con esfuerzo de razonamiento máximo. Su Coding Agent Index v2.0 le asigna a Terra 48 y a Sol 54. Son evaluaciones separadas con sus propios métodos y escalas de puntuación; no deben combinarse numéricamente con los resultados de los benchmarks de OpenAI.
El mismo análisis identifica las configuraciones low y medium de Terra como particularmente eficientes en costo en la evaluación de inteligencia. Esto respalda probar configuraciones prácticas junto con ajustes de esfuerzo máximo. Los costos de evaluación siguen siendo específicos de la configuración de la prueba y no deben tratarse como estimaciones del gasto de tu aplicación.
Speed and Latency: Task Completion vs. Token Generation
OpenAI informa que Terra completa las tareas evaluadas de Agents’ Last Exam más de tres veces más rápido que Sol. Es una medición de tareas de extremo a extremo que incluye razonamiento e interacciones con software. No implica un throughput de tokens de salida tres veces mayor ni el mismo aumento de velocidad para cada solicitud de API.
Para aplicaciones interactivas, distingue el tiempo hasta el primer token, que mide la espera antes de que comience la salida, de los tokens de salida por segundo, que miden cuán rápido continúa la respuesta. Para agentes, prioriza el tiempo de finalización de extremo a extremo, incluyendo llamadas a herramientas, reintentos y recuperación.
Compara ambos modelos usando los mismos prompts, herramientas, configuración de razonamiento admitida y criterios de aceptación. Registra la latencia junto con el éxito de la tarea: una respuesta más rápida tiene valor limitado si requiere más corrección o no completa el flujo de trabajo.
Vision and Long-Context Performance: What the Results Establish
La ventaja de 0.8 puntos porcentuales de Sol en MMMU-Pro a esfuerzo máximo es un resultado de visión reportado, más que una garantía de mejor desempeño en cada flujo de trabajo visual. Prueba etiquetas pequeñas, escaneos de baja calidad, diagramas densos y diseños desconocidos usando entradas representativas.
Las evaluaciones anteriores no establecen qué modelo es mejor en recuperación o razonamiento de largo contexto. Aunque ambos tengan la misma capacidad de contexto publicada, la capacidad por sí sola no demuestra precisión de recuperación ni memoria a través de sesiones. Prueba si cada modelo puede localizar y usar evidencia relevante en tus documentos y mantén explícitamente el estado de la aplicación a través de las solicitudes.
GPT-6.1 Terra vs GPT-6.1 Sol: Cost
Los precios de tokens son el punto de partida para comparar costos. Reintentos, tokens de razonamiento, llamadas a herramientas y revisión humana también afectan cuánto gastas para completar con éxito una tarea.
Las siguientes tarifas están en USD por millón de tokens y precios.
Proveedor y categoría de tokens
GPT-6.1 Terra
GPT-6.1 Sol
OpenAI Standard — entrada
$1.00
$2.00
OpenAI Standard — entrada en caché
$0.05
$0.10
OpenAI Standard — salida
$5.00
$10.00
OpenAI Standard — escritura en caché de 30 minutos
$1.25
$2.50
OpenAI Standard — escritura en caché de 12 horas
$2.50
$5.00
CometAPI — entrada ordinaria
$0.80
$1.60
CometAPI — salida ordinaria
$4.00
$8.00
OpenAI API Pricing
Las tarifas estándar listadas de Terra son la mitad de las de Sol en estas categorías. Los cargos reales dependen de la configuración de la solicitud: solicitudes de largo contexto, niveles de procesamiento, procesamiento regional y uso de herramientas pueden tener términos diferentes. Consulta la documentación de precios aplicable de OpenAI antes de estimar costos de producción.
CometAPI Pricing
CometAPI es una ruta de acceso de terceros con su propio precio y disponibilidad de funciones. Sus tarifas listadas de entrada y salida ordinarias se muestran por separado a continuación.
A estas tarifas, los precios de entrada y salida ordinarios de CometAPI son un 20% inferiores a las tarifas de OpenAI Standard anteriores. Confirma los precios actuales, los cargos por largo contexto, el soporte de caché y la disponibilidad de herramientas para tu cuenta antes del despliegue.
Example Cost for 1,000 Requests
Supón que una aplicación realiza 1,000 solicitudes, cada una usando 2,000 tokens de entrada no almacenados en caché y 500 tokens de salida facturables. Esto produce un total de 2 millones de tokens de entrada y 500,000 tokens de salida.
Para 1,000 solicitudes, cada una usando 2,000 tokens de entrada no almacenados en caché y 500 tokens de salida facturables, los costos estimados son:
Terra vía OpenAI: $2.00 por entrada y $2.50 por salida, totalizando $4.50.
Sol vía OpenAI: $4.00 por entrada y $5.00 por salida, totalizando $9.00.
Terra vía CometAPI: $1.60 por entrada y $2.00 por salida, totalizando $3.60.
Sol vía CometAPI: $3.20 por entrada y $4.00 por salida, totalizando $7.20.
Estos cálculos usan las tarifas ordinarias listadas arriba, sin un descuento de Batch API. Excluyen escrituras en caché, cargos separados por herramientas y reintentos. Cualquier token de razonamiento facturado como salida debe incluirse en el total de salida.
Effective Cost per Successful Task
En este artículo, una tarea exitosa es aquella que pasa las verificaciones de calidad, esquema cuando aplica y finalización sin corrección humana adicional.
Precios más bajos de tokens no siempre producen costos operativos menores. Los ahorros de Terra pueden reducirse si necesita más intentos, tokens de razonamiento o intervención humana. Las tarifas más altas de Sol pueden justificarse si completa más tareas con éxito en el primer intento.
Costo efectivo de modelo y herramientas por tarea exitosa = gasto total en modelo y herramientas en todos los intentos ÷ número de tareas exitosas.
Registra por separado los costos de revisión y corrección humanas. Elige el modelo que cumpla tu objetivo de calidad al menor costo combinado, en lugar de comparar solo los precios de tokens.
Which Model Should You Choose: GPT-6.1 Terra or GPT-6.1 Sol?
Elige en función de la complejidad de la tarea, la calidad verificable de la salida y el costo total de finalización. Terra es un punto de partida útil para flujos de trabajo rutinarios; vale la pena evaluar Sol cuando el razonamiento difícil o los fallos costosos justifican un gasto adicional.
When to Choose GPT-6.1 Terra
Comienza con Terra para extracción de alto volumen, redacción de documentos, correspondencia de catálogos y flujos de trabajo de aplicaciones predecibles. Estas tareas son buenos candidatos cuando los resultados pueden verificarse contra documentos fuente, campos obligatorios o reglas de validación automatizadas.
Elige Terra cuando cumpla tus objetivos de precisión y finalización dentro del presupuesto permitido de reintentos y revisión humana. Las tarifas de tokens más bajas ofrecen poco beneficio si los fallos repetidos borran los ahorros.
When to Choose GPT-6.1 Sol
Evalúa Sol para depuración difícil, cambios en repositorios que involucren muchas dependencias y flujos de trabajo de escritorio con largas cadenas de acciones dependientes.
Elige Sol cuando las pruebas muestren que produce más parches aceptados, pasa más pruebas o requiere menos corrección manual. Su mayor costo en tokens se justifica cuando esas mejoras reducen el costo total de completar el trabajo.
When to Use Terra First and Escalate to Sol
Un flujo de trabajo híbrido puede usar Terra para el intento inicial y escalar a Sol cuando fallen comprobaciones predefinidas. Basa el escalamiento en resultados observables más que en la confianza del modelo por sí sola.
Por ejemplo, un flujo de trabajo de generación de código podría:
Pedir a Terra que produzca el cambio solicitado.
Ejecutar las pruebas y verificaciones de validación pertinentes.
Escalar a Sol si el cambio no supera esas verificaciones o queda fuera de la capacidad verificada de Terra.
Enviar los casos no resueltos a revisión humana una vez agotado el presupuesto de reintentos.
Al escalar, conserva la solicitud original, el contexto relevante, la salida fallida y los resultados de validación. Registra el uso de ambos modelos para que la comparación de costos incluya el flujo de trabajo completo.
Production Evaluation Checklist
Antes de seleccionar un modelo predeterminado o desplegar un flujo de trabajo de escalamiento:
Usa tareas representativas: Incluye solicitudes rutinarias y casos donde el fallo sea costoso.
Mantén las comparaciones controladas: Usa instrucciones, evidencias, herramientas y criterios de aceptación comparables. Registra IDs de modelo, endpoints, configuraciones de razonamiento y fechas de prueba.
Mide resultados aceptados: Verifica precisión, validez de esquema cuando aplique, resultados de pruebas y finalización sin corrección manual.
Mide tiempo y gasto: Rastrea latencia mediana y de cola, tokens facturados, llamadas a herramientas, reintentos y esfuerzo de revisión humana.
Repite la comparación: Ejecuta las tareas varias veces y alterna el orden de los modelos para reducir la influencia de resultados fortuitos.
Define límites operativos: Establece presupuestos de reintentos, disparadores de escalamiento y requisitos de aprobación humana antes del despliegue.
Compara el flujo de trabajo completo: Incluye intentos no exitosos y costos de escalamiento al calcular el gasto por tarea exitosa.
Where Can You Access GPT-6.1 Terra and GPT-6.1 Sol?
Official Provider Access
Ambos modelos están disponibles a través de la OpenAI API. Para solicitudes de texto, Chat Completions está soportado; las llamadas a herramientas requieren Responses API. Confirma los parámetros admitidos del modelo, los límites de tu cuenta y las herramientas disponibles en la ruta que pretendes usar.
CometAPI Access
Para usar cualquiera de los modelos a través de CometAPI, sigue su quickstart guide para configurar el SDK compatible con OpenAI. Proporciona tu clave de CometAPI de forma segura mediante la variable de entorno COMETAPI_KEY y establece la URL base en https://api.cometapi.com/v1. Elige gpt-6.1-terra o gpt-6.1-sol como identificador de modelo y confirma que la ruta esté habilitada para tu cuenta.
Para una primera comparación, asigna a ambos modelos las mismas tareas representativas y usa esfuerzo de razonamiento medium. Mantén consistentes las instrucciones y los criterios de aceptación, repite cada tarea y alterna el orden de los modelos. Compara resultados exitosos, tiempo transcurrido, tokens facturados y reintentos en lugar de juzgar cualquiera de los modelos a partir de una sola respuesta.
Conclusion
Empieza con GPT-6.1 Terra para flujos de trabajo frecuentes y verificables donde los precios de tokens más bajos y la finalización más rápida importan. Evalúa GPT-6.1 Sol cuando la codificación difícil, el uso de herramientas de múltiples pasos o los fallos costosos hagan valiosa una mayor capacidad de razonamiento. La elección final debe basarse en el costo por tarea aceptada bajo un conjunto de evaluación representativo, no en el precio ni en un solo benchmark.
Para muchas aplicaciones, el siguiente paso útil es una pequeña prueba representativa con condiciones de aprobación claras y una ruta de escalamiento acotada. Deja que el resultado medido determine el modelo, en lugar de basarte en el precio o en un solo benchmark.
GPT-6.1 Terra vs. GPT-6.1 Sol: pruebas de rendimiento, precios y cuál elegir - CometAPI