
Actualización del lanzamiento de Grok 4.7: de las predicciones a la disponibilidad oficial
Información verificada: 16 de octubre de 2026.
Grok 4.7 se lanzó oficialmente el 21 de septiembre de 2026. Las referencias anteriores a un lanzamiento el 12 de septiembre fueron estimaciones previas al lanzamiento y no deben considerarse la fecha real de lanzamiento.
El anuncio oficial de lanzamiento describe mejoras en programación, trabajo de conocimiento, tareas de mayor duración y verificación de los propios resultados del modelo. Confirma la disponibilidad a través de la API de Grok, Cursor y Grok Build. Para conocer el ID de modelo exacto de la API, las funciones compatibles, los límites de contexto y los precios actuales, consulte la documentación oficial de Grok 4.7.
Los resultados oficiales muestran un progreso medible respecto a Grok 4.6. Por ejemplo, la comparación de lanzamiento reporta una puntuación de 37.6% en Terminal-Bench 4.0 para Grok 4.7 con esfuerzo xhigh, frente al 20.3% para Grok 4.6 con esfuerzo high. Estos son resultados reportados por el proveedor bajo las configuraciones de evaluación indicadas; el rendimiento en aplicaciones dependerá de los prompts, las herramientas, el esfuerzo de razonamiento y la dificultad de la tarea.
Para los desarrolladores, la pregunta útil ahora es si Grok 4.7 completa sus cargas de trabajo de forma más fiable y económica. Pruébelo en cambios de repositorio, creación de documentos y flujos de trabajo con herramientas de varios pasos, midiendo la finalización exitosa, la latencia, los reintentos y el costo total de la tarea.
Fuente: Anuncio oficial del lanzamiento de Grok 4.7.
Puntos clave
- La fecha prevista del 12 de septiembre se infiere de la cuenta regresiva de diez días de Musk, no de un anuncio de calendario publicado por separado por xAI.
- Las declaraciones sobre escala de 2.1T y datos de SpaceX son afirmaciones previas al lanzamiento; los parámetros activos, el enrutamiento, la arquitectura y la metodología de entrenamiento no se han publicado.
- Grok 4.6 ya muestra resultados sólidos en trabajo de conocimiento y capacidades de agente, incluido un 61.3% en FrontierCode v1.1 (Extended), pero queda por detrás del modelo de comparación más fuerte en varias evaluaciones difíciles de programación.
- Grok 4.7 debe juzgarse por la tasa de tareas aceptadas, la fiabilidad en horizontes largos, la eficiencia de tokens, la latencia y el costo por resultado exitoso, no solo por el número de parámetros.
- CometAPI integrará Grok 4.7 tan pronto como xAI lance oficialmente el modelo y el acceso al endpoint de producción esté disponible; los desarrolladores deben validar el ID de modelo en vivo, el precio y el comportamiento de respuesta antes de migrar.
¿Qué es Grok 4.7?
Grok 4.7 es el sucesor anunciado de Grok 4.6 y se espera que continúe el enfoque de xAI en programación, ingeniería, agentes de larga duración y trabajo profesional de conocimiento. La evidencia pública actualmente consiste en declaraciones de los fundadores y una cuenta regresiva de lanzamiento, más que en un paquete técnico de lanzamiento completo.
La distinción más importante es entre tres objetos: el modelo Grok 4.7 anunciado, las señales previas al lanzamiento que describen su posible escala y entrenamiento, y la línea base de producción de Grok 4.6. Los desarrolladores deben tratar a Grok 4.7 como un candidato de evaluación próximo hasta que xAI publique la documentación final y una solicitud de producción sea exitosa contra el endpoint lanzado.
Fecha de lanzamiento y cronología de Grok 4.7
¿Cuándo se espera el lanzamiento de Grok 4.7?
La declaración de Musk del 2 de septiembre de que el modelo llegaría en diez días apunta aproximadamente al 12 de septiembre de 2026
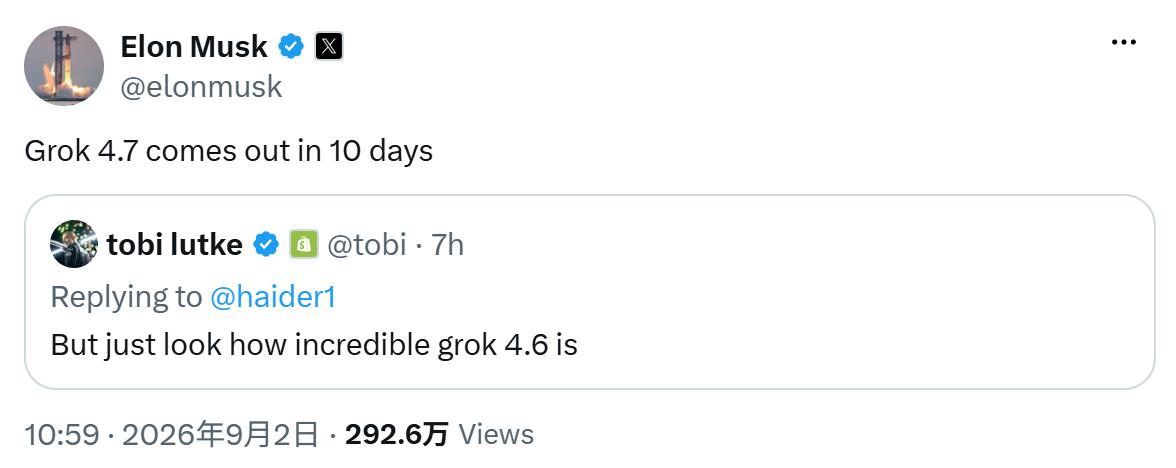
Fuente: Elon Musk en X, 2 de septiembre de 2026
Cronología del lanzamiento de Grok 4.7
| Fecha | Señal pública | Interpretación |
|---|---|---|
| Finales de julio de 2026 | Musk describió un modelo de aproximadamente 2.1T, con mayor eficiencia de tokens y un servicio algo más lento. | Expectativas de escala y eficiencia declaradas por el fundador. |
| 12 de agosto de 2026 | Se describió que el entrenamiento inicial estaba completo; el entrenamiento suplementario incluía, supuestamente, datos sustanciales de SpaceX. | Una actualización del progreso de entrenamiento, no una confirmación de lanzamiento. |
| 2 de septiembre de 2026 | “Grok 4.7 sale en 10 días.” | La cuenta regresiva de lanzamiento público más clara hasta ahora. |
| 12 de septiembre de 2026 | Fecha de calendario derivada de la cuenta regresiva. | Objetivo esperado; la disponibilidad final aún requiere un aviso de lanzamiento de xAI y un endpoint funcional. |
Especificaciones de Grok 4.7: información confirmada vs no confirmada
La forma más útil de leer la información actual de Grok 4.7 es separar las declaraciones directas de los fundadores de las especificaciones que xAI no ha publicado. La nueva publicación confirma solo el nombre del modelo y una cuenta regresiva de lanzamiento; no añade parámetros técnicos ni resultados de benchmarks.
| Especificación | Estado actual de Grok 4.7 | Nivel de evidencia |
|---|---|---|
| Momento del lanzamiento | Alrededor del 12 de septiembre, inferido de la cuenta regresiva de diez días del 2 de septiembre | Objetivo anunciado por el fundador |
| Escala del modelo | Aproximadamente 2.1T parámetros | Declarado por el fundador |
| Entrenamiento inicial | Descrito como completado para el 12 de agosto | Declarado por el fundador |
| Entrenamiento suplementario | Incluye datos sustanciales de la empresa SpaceX | Declarado por el fundador |
| Calidad relativa | Afirmado como significativamente mejor que Grok 4.6 | Afirmación no verificada |
| Eficiencia de tokens | Afirmada mejora respecto a Grok 4.6 | Afirmación no verificada |
| Velocidad de servicio | Se espera algo más lenta | Declarado por el fundador |
| Ventana de contexto | No publicada por xAI | Desconocido |
| Modalidades de entrada/salida | No publicadas por xAI | Desconocido |
| ID de modelo final de la API | No confirmado en la documentación de xAI | Desconocido |
| Precios oficiales | No publicados por xAI | Desconocido |
| Benchmarks oficiales | Ninguno publicado para Grok 4.7 | Desconocido |
La afirmación de aproximadamente 2.1T parámetros no revela parámetros activos, esparsidad, enrutamiento por expertos, costo de inferencia ni cómputo efectivo de entrenamiento. El conteo de parámetros por sí solo no puede establecer la calidad en producción.
Por qué la señal de entrenamiento con SpaceX puede importar más que 2.1T
La revelación más consecuente puede ser el suplemento de datos de la empresa SpaceX. Un corpus de ingeniería de alta calidad podría mejorar el razonamiento técnico, el diseño, la depuración, la optimización y el trabajo de agentes de largo horizonte, donde la distribución de tareas y la calidad posterior al entrenamiento a menudo importan más que la escala bruta.
Esta dirección es consistente con la estrategia de modelos publicados de xAI. El informe de entrenamiento de Grok 4.6 describe una carrera de entrenamiento suplementaria más larga con datos de ingeniería de alta calidad, seguida de ajuste supervisado y aprendizaje por refuerzo en programación, STEM, desarrollo web, optimización de kernel y diseño asistido por computadora.
Eso hace que la afirmación de Grok 4.7 sea técnicamente plausible, no probada. Una ventaja real debería hacerse visible tras el lanzamiento en pruebas de ingeniería reproducibles, tasas de finalización de tareas, latencia y costo por resultado exitoso.
Grok 4.7 vs Grok 4.6 en rendimiento: lo que muestra la línea base
Aún no existen puntuaciones oficiales de Grok 4.7. El punto de comparación responsable es la evaluación de Grok 4.6 publicada por xAI. La visión general completa del modelo aparece en el análisis en profundidad de Grok 4.6 de CometAPI; la tabla siguiente conserva solo las filas de benchmarks más relevantes para la toma de decisiones.
| Evaluación oficial | Grok 4.6 High | Grok 4.5 High | GPT-5.6 Sol Max | Claude Fable 5 Max |
|---|---|---|---|---|
| AA Intelligence Index | 61 | 56 | 61 | 62 |
| GDPVal-AA v2 | 1753 | 1526 | 1728 | 1741 |
| CursorBench v3.2 | 69.9% | 66.7% | 67.2% | 70.5% |
| DeepSWE v1.1 | 65.9% | 54.0% | 73.0% | 70.0% |
| FrontierCode v1.1 (Extended) | 61.3% | 56.6% | 60.6% | 63.6% |
| Terminal-Bench v3.0 | 26.0% | 15.7% | 34.6% | 34.1% |
Resultado de base: Grok 4.6 demuestra una ventaja real sobre Grok 4.5 en cada fila mostrada. Igual a GPT-5.6 Sol en el índice general de inteligencia, lidera este grupo en GDPVal-AA v2 y supera ligeramente a GPT-5.6 Sol en FrontierCode. Sus principales brechas publicadas siguen siendo DeepSWE y Terminal-Bench.
Estos resultados fijan un estándar concreto para Grok 4.7. Si el modelo más grande y el entrenamiento suplementario orientado a ingeniería se transfieren a producción, el avance esperado sería un mayor rendimiento en programación a nivel de repositorio y en tareas de terminal sin perder la fortaleza de Grok 4.6 en trabajo de conocimiento. Un objetivo ambicioso creíble es volverse competitivo con el Claude Fable 5.1 lanzado en programación y flujos de trabajo de agentes de larga duración. Eso es una previsión para probar, no una afirmación actual de benchmarks.
Grok 4.7 vs Grok 4.6 : avances esperados y orientación de actualización
Las señales filtradas y declaradas por los fundadores sugieren cinco áreas donde Grok 4.7 puede mejorar. Dado que xAI no ha publicado datos de evaluación finales, cada expectativa debe convertirse en una prueba de aceptación medible.
Programación a nivel de repositorio
Grok 4.6 ya es fuerte en CursorBench y FrontierCode, pero sus resultados en DeepSWE y Terminal-Bench dejan un margen visible de mejora. Grok 4.7 debe demostrar mayor aceptación de parches, menos regresiones y mejor recuperación en línea de comandos en los mismos repositorios antes de reemplazar a 4.6.
Fiabilidad de agentes en horizontes largos
La señal de datos de SpaceX y la dirección de entrenamiento de agentes de xAI sugieren un enfoque en trabajo de ingeniería multietapa. Mida flujos de trabajo completados, llamadas a herramientas fallidas, reintentos, intervenciones humanas y recuperación tras errores, no solo la calidad del texto final.
Trabajo de conocimiento y razonamiento técnico
Grok 4.6 ya lidera el conjunto de comparación en GDPVal-AA v2. Grok 4.7 debería preservar esa ventaja mientras mejora la transferencia a revisiones de diseño, síntesis de investigación, depuración, optimización y otras tareas técnicas complejas.
Eficiencia de tokens
Un modelo más grande aún puede ser más barato por tarea exitosa si alcanza resultados correctos en menos pasos. Compare tokens de entrada totales, entrada en caché, tokens de salida, reintentos y costo para el mismo resultado aceptado.
Compensaciones en el servicio
Si Grok 4.7 es más lento, las mejoras de calidad deben superar la latencia. Registre el tiempo hasta el primer token, el rendimiento sostenido, el tiempo de pared para completar la tarea, la tasa de errores y el costo bajo concurrencia realista.
Benchmarks de Grok 4.7: 5 pruebas para verificar una mejora real sobre Grok 4.6
- Éxito en ingeniería de software: medir incidencias resueltas, pruebas aprobadas, tasa de regresión y aceptación de parches en repositorios representativos.
- Fiabilidad de agentes en horizontes largos: rastrear flujos de trabajo completados, fallos en llamadas a herramientas, reintentos, recuperación e intervenciones humanas en ejecuciones de varios pasos.
- Transferencia a ingeniería del mundo real: probar diseño, depuración, optimización, razonamiento científico y tareas relacionadas con CAD con criterios de calificación divulgados.
- Eficiencia de tokens por tarea exitosa: comparar tokens totales y gasto necesarios para alcanzar el mismo resultado aceptado.
- Latencia y costo bajo carga de producción: evaluar tiempo hasta el primer token, rendimiento, tiempo de pared, tasa de errores y costo con concurrencia realista.
Qué deben hacer los desarrolladores antes del 12 de septiembre y cómo encaja CometAPI
Lista de verificación previa al lanzamiento
- Construya un conjunto de evaluación fijo a partir de flujos de trabajo reales de programación, investigación, ingeniería y agentes.
- Ejecútelo contra Grok 4.6 y registre la tasa de éxito, reintentos, llamadas a herramientas, latencia, tokens y costo total.
- Mantenga la selección de modelo configurable y evite codificar de forma rígida un identificador provisional de Grok 4.7.
- Supervise las notas de lanzamiento de xAI y la página del modelo en CometAPI para confirmar la disponibilidad.
- Tras el lanzamiento, verifique contexto, modalidades, controles de razonamiento, precios, límites de tasa y alcance del despliegue.
- Reproduzca el mismo conjunto de evaluación antes de desviar tráfico de producción.
CometAPI proporciona una capa de API unificada para acceder a múltiples proveedores de modelos de IA a través de una sola cuenta y patrón de integración. Ya está disponible una página de seguimiento de Grok 4.7. CometAPI integrará Grok 4.7 tan pronto como xAI lo lance oficialmente y el acceso al endpoint de producción esté disponible.
Hasta ese momento, trate cualquier identificador, precio o campo de capacidad previo al lanzamiento como provisional. Antes de enviar tráfico de producción, confirme que la ruta esté activa, que una solicitud real sea exitosa, que el modelo devuelto sea la versión prevista y que el precio actual sea visible en la consola.
Perspectiva de precios de Grok 4.7 vs Grok 4.6
La tarifa estándar publicada de Grok 4.6 es de $2 por 1 millón de tokens de entrada y $6 por 1 millón de tokens de salida por debajo del umbral de contexto largo. Las notas de lanzamiento de xAI listan tarifas más altas para solicitudes por encima de 200,000 tokens de prompt. Los precios de Grok 4.7 no se han anunciado oficialmente.
| Base de precios publicada | Entrada / 1M | Salida / 1M | Estado |
|---|---|---|---|
| Grok 4.6, prompt < 200K | $2 | $6 | Publicado |
| Grok 4.6, prompt > 200K | $4 | $12 | Nivel de contexto largo publicado |
| Grok 4.7 | No anunciado | No anunciado | Confirmar tras el lanzamiento oficial |
Tres direcciones de precios siguen siendo plausibles: paridad con Grok 4.6 para acelerar la adopción, una tarifa premium si el costo de servicio es sustancialmente mayor, o tarifas separadas por longitud de contexto y velocidad. Estos son escenarios de planificación, no un pronóstico de xAI.
Lista de verificación previa al lanzamiento
- Construya un conjunto de evaluación fijo a partir de flujos de trabajo reales de programación, investigación, ingeniería y agentes.
- Ejecútelo contra Grok 4.6 y registre la tasa de éxito, reintentos, llamadas a herramientas, latencia, tokens y costo total.
- Mantenga la selección de modelo configurable y evite codificar de forma rígida un identificador provisional de Grok 4.7.
- Supervise las notas de lanzamiento de xAI y la página del modelo en CometAPI para confirmar la disponibilidad.
- Tras el lanzamiento, verifique contexto, modalidades, controles de razonamiento, precios, límites de tasa y alcance del despliegue.
- Reproduzca el mismo conjunto de evaluación antes de desviar tráfico de producción.
Grok 4.7: qué observar a continuación
Cuatro eventos convertirían la cuenta regresiva actual en un lanzamiento de producto verificable: una publicación oficial de lanzamiento de xAI; documentación del modelo que cubra contexto, modalidades y controles de razonamiento; precios finales de la API e identificadores de modelo; y benchmarks o evaluaciones de producción reproducibles.
La pregunta de lanzamiento más útil no es si 2.1T suena grande. Es si Grok 4.7 completa tareas difíciles de ingeniería y de agentes de forma más fiable, y a un mejor costo por resultado exitoso, que la línea base publicada.
Preguntas frecuentes
¿Cuándo se espera el lanzamiento de Grok 4.7?
La cuenta regresiva de diez días del 2 de septiembre de Musk apunta aproximadamente al 12 de septiembre de 2026. Es un objetivo inferido, no una fecha de calendario publicada por separado por xAI.
¿Ya se lanzó Grok 4.7?
Grok 4.7 ha sido adelantado/anunciado públicamente pero aún no ha recibido un paquete completo oficial de documentación de API/modelo.
¿Grok 4.7 es un modelo de 2.1 billones de parámetros?
Musk lo ha descrito como de aproximadamente 2.1T parámetros. xAI aún no ha publicado un documento de arquitectura que confirme parámetros activos o detalles de enrutamiento.
¿Será Grok 4.7 mejor que Grok 4.6?
Musk ha afirmado una mejora sustancial, pero no existe una tabla oficial de benchmarks de Grok 4.7. Trate la afirmación como no verificada hasta que haya resultados reproducibles disponibles.
¿Grok 4.7 estará disponible a través de CometAPI?
Ya existe una página de seguimiento de CometAPI, pero la disponibilidad final, el identificador, los precios y los formatos compatibles deben confirmarse tras el lanzamiento oficial.
Conclusión
La historia de Grok 4.7 ha pasado de una estimación amplia a principios de septiembre a una cuenta regresiva concreta. La última declaración de Musk apunta aproximadamente al 12 de septiembre de 2026, mientras que publicaciones anteriores describen un modelo de alrededor de 2.1T y un entrenamiento suplementario con datos sustanciales de la empresa SpaceX.
Son señales de prelanzamiento inusualmente específicas, pero no constituyen una ficha del modelo, un conjunto de benchmarks o un contrato de API. Los desarrolladores deben mantener a Grok 4.6 como la línea base medible, preparar una evaluación controlada ahora y esperar a que xAI y CometAPI confirmen el acceso de producción antes de tomar decisiones de migración o presupuesto.