
TL;DR
Grok 4.7 y Xiaomi MiMo-V2.6 llegaron con solo un día de diferencia, pero representan dos enfoques distintos hacia la IA de frontera. Grok 4.7 enfatiza una pila de agentes propietaria y estrechamente integrada para programación y trabajo profesional con conocimiento, mientras que MiMo-V2.6-Pro combina pesos abiertos, una ventana de contexto más grande, comprensión multimodal nativa y precios de API agresivos.
SpaceXAI posiciona Grok 4.7 como su modelo de frontera para programación, tareas con agentes y trabajo de conocimiento con una ventana de contexto de 500K tokens y esfuerzo de razonamiento configurable.
Xiaomi posiciona MiMo-V2.6-Pro como un buque insignia multimodal con contexto de 1M con pesos abiertos y compatibilidad con comprensión de texto, imagen, audio y video.
En pocas palabras: Grok 4.7 es el producto de agentes gestionados más integrado verticalmente; MiMo-V2.6-Pro ofrece a los desarrolladores mayor control de implementación y un precio por token bruto mucho más bajo. La mejor opción depende de la carga de trabajo más que de una única puntuación de benchmark.
Conclusiones clave
- Grok 4.7 está diseñado para programación de largo horizonte y agentes profesionales. En la evaluación publicada por el proveedor de SpaceXAI, obtiene 46.3% en CursorBench 4.0, 71.0% en DeepSWE v1.1 con esfuerzo alto y 1,657 en AA Briefcase v1.1.
- MiMo-V2.6-Pro es inusualmente competitivo para un modelo abierto. Xiaomi publica los pesos del modelo e informa resultados cercanos a sistemas propietarios de frontera en varios benchmarks de programación y agentes, pero las puntuaciones entre proveedores no son directamente intercambiables.
- MiMo tiene la ventaja en contexto y multimodalidad. MiMo-V2.6-Pro admite una ventana de contexto de 1M tokens y comprensión de texto, imagen, audio y video, frente a los 500K de Grok 4.7 con entrada de texto e imagen.
- MiMo es sustancialmente más barato en tokens de API brutos. El precio oficial estándar es de $0.435/$0.87 por millón de tokens de entrada/salida sin caché para MiMo-V2.6-Pro frente a $2/$6 para Grok 4.7.
- La arquitectura de implementación es la compensación decisiva. Grok ofrece la pila de herramientas alojadas de primera parte más sólida; los pesos abiertos de MiMo permiten implementación privada, servicio personalizado y un control de infraestructura más profundo.
Grok 4.7 vs MiMo-V2.6-Pro de un vistazo
| Dimension | Grok 4.7 | MiMo-V2.6-Pro |
|---|---|---|
| Release | 21 de septiembre de 2026 | 22 de septiembre de 2026 |
| Access and control | API propietaria y ecosistema de agentes gestionados | Pesos abiertos, opción de autoalojamiento y acceso por API |
| Performance evidence | Fortaleza reportada por el proveedor en programación y tareas de agentes de larga duración; validar en el mismo arnés de tareas | Fortaleza reportada por el proveedor en razonamiento, programación y tareas multimodales; validar en el mismo arnés de tareas |
| Distinctive strengths | Herramientas de primera parte, flujos de trabajo gestionados y agentes conectados a la web/X | Control de la implementación, contexto de 1M tokens y comprensión de texto/imagen/audio/video |
| Context window | 500K tokens | 1M tokens |
| Input modalities | Texto e imagen | Texto, imagen, audio y video |
| Official standard uncached input / output per 1M tokens | $2 / $6 | $0.435 / $0.87 |
| Reasoning | Bajo a xHigh | Razonamiento profundo |
| Open weights | No | No |
| Best fit | Flujos de trabajo gestionados de programación y agentes | Implementación privada, entrada multimodal y menor costo bruto por token |
¿Qué es Grok 4.7?
SpaceXAI lanzó oficialmente Grok 4.7 el 21 de septiembre de 2026 como su modelo más capaz para programación y trabajo con conocimiento. El lanzamiento es relevante porque los informes previos mezclaban hechos confirmados con afirmaciones filtradas sobre la arquitectura. La documentación final del lanzamiento no publica el conteo total o activo de parámetros, por lo que las estimaciones previas no deben tratarse como especificaciones oficiales.
Según la publicación oficial, Grok 4.7 usa un modelo base nuevo y más grande que Grok 4.6 y fue entrenado con una etapa de aprendizaje por refuerzo más larga, ponderada hacia problemas que llevan muchas horas en completarse.
Los modelos optimizan capas diferentes de la pila. Grok 4.7 ofrece un entorno gestionado más rico alrededor del modelo; MiMo-V2.6-Pro expone más del modelo y la capa de implementación a los desarrolladores.
Para prompts por encima de 200K tokens, SpaceXAI aplica precios de contexto alto. La categoría publicada es de $4 por millón de tokens de entrada, $1 por millón de tokens de entrada en caché y $12 por millón de tokens de salida.
Cambios en Grok 4.7
El cambio más significativo es el objetivo de entrenamiento, no solo un número de benchmark más alto. SpaceXAI afirma que su mezcla de aprendizaje por refuerzo se desplazó hacia tareas más largas, de varias horas, mientras que el modelo fue entrenado para verificar su propio trabajo con más cuidado y para entender de forma nativa el arnés de Grok Bot. Esa combinación apunta a la ejecución real de agentes: mantener estado, usar herramientas, verificar el trabajo intermedio y conservar la coherencia a lo largo de trayectorias de tareas extensas.
Rendimiento de Grok 4.7
| SpaceXAI-published benchmark | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| CursorBench 4.0 | 46.3% | 40.4% | 41.7% | 51.8% |
| DeepSWE v1.1 | 71.0%* | 65.2% | 72.7% | 70.0% |
| EEBench | 64.0% | 53.0% | 39.4% | 56.4% |
| AA Briefcase v1.1 | 1,657 | 1,546 | 1,487 | 1,678 |
| Terminal-Bench 4.0 | 38.0% | 20.3% | 37.3% | 57.9% |
| Harvey Legal Agent Benchmark | 19.6% | 15.8% | 2.5% | 6.7% |
| HealthBench Professional | 56.7% | 48.5% | 60.5% | 62.1% |
SpaceXAI marca la evaluación de Grok 4.7 en DeepSWE como de esfuerzo alto. Son evaluaciones publicadas por el proveedor y deben interpretarse según el arnés y los ajustes de razonamiento documentados.
SpaceXAI presenta las gráficas del lanzamiento como contenido web nativo en la página oficial del anuncio; la tabla anterior preserva los valores de benchmark divulgados sin sustituirlas por una gráfica redibujada.
¿Qué es Xiaomi MiMo-V2.6?
Xiaomi lanzó oficialmente y de forma abierta MiMo-V2.6 el 22 de septiembre de 2026. La familia incluye MiMo-V2.6-Pro y MiMo-V2.6-Flash, con una opción Pro-UltraSpeed para cargas sensibles a la latencia. Para una comparación directa con Grok 4.7, MiMo-V2.6-Pro es el buque insignia adecuado.
Los materiales oficiales de Xiaomi documentan por separado pesos abiertos, entrada multimodal nativa y precios de API. Esta combinación hace que MiMo-V2.6 sea relevante más allá de las tablas de líderes.
MiMo-V2.6 vs MiMo-V2.5: ¿Qué se mejoró?
El titular arquitectónico no es simplemente un checkpoint más grande. La publicación pública de Xiaomi se centra fuertemente en el post-entrenamiento y Live RL. Según las notas oficiales de la versión, Pro y Flash completaron cada uno 30 pasos de aprendizaje por refuerzo y, en conjunto, generaron aproximadamente 750,000 trayectorias; los costos divulgados de la etapa RL fueron aproximadamente $2.62 millones para Pro y $850,000 para Flash.
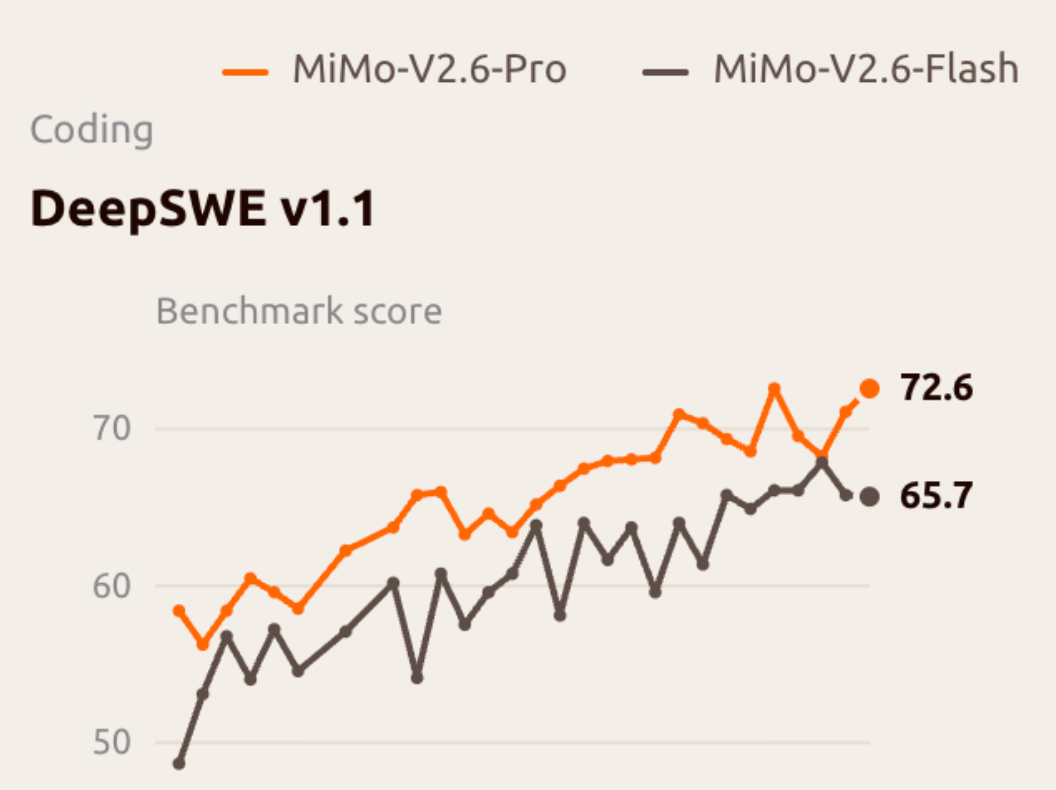
Un detalle de benchmark requiere manejo cuidadoso: la curva de Live RL de Xiaomi muestra que MiMo-V2.6-Pro alcanza alrededor de 72.6 en DeepSWE v1.1 durante la ejecución de entrenamiento, mientras que la tabla de comparación final reporta 71.9. Estas cifras se refieren a contextos de evaluación diferentes y no deben fusionarse silenciosamente.
Grok 4.7 vs MiMo-V2.6-Pro: Comparación de benchmarks
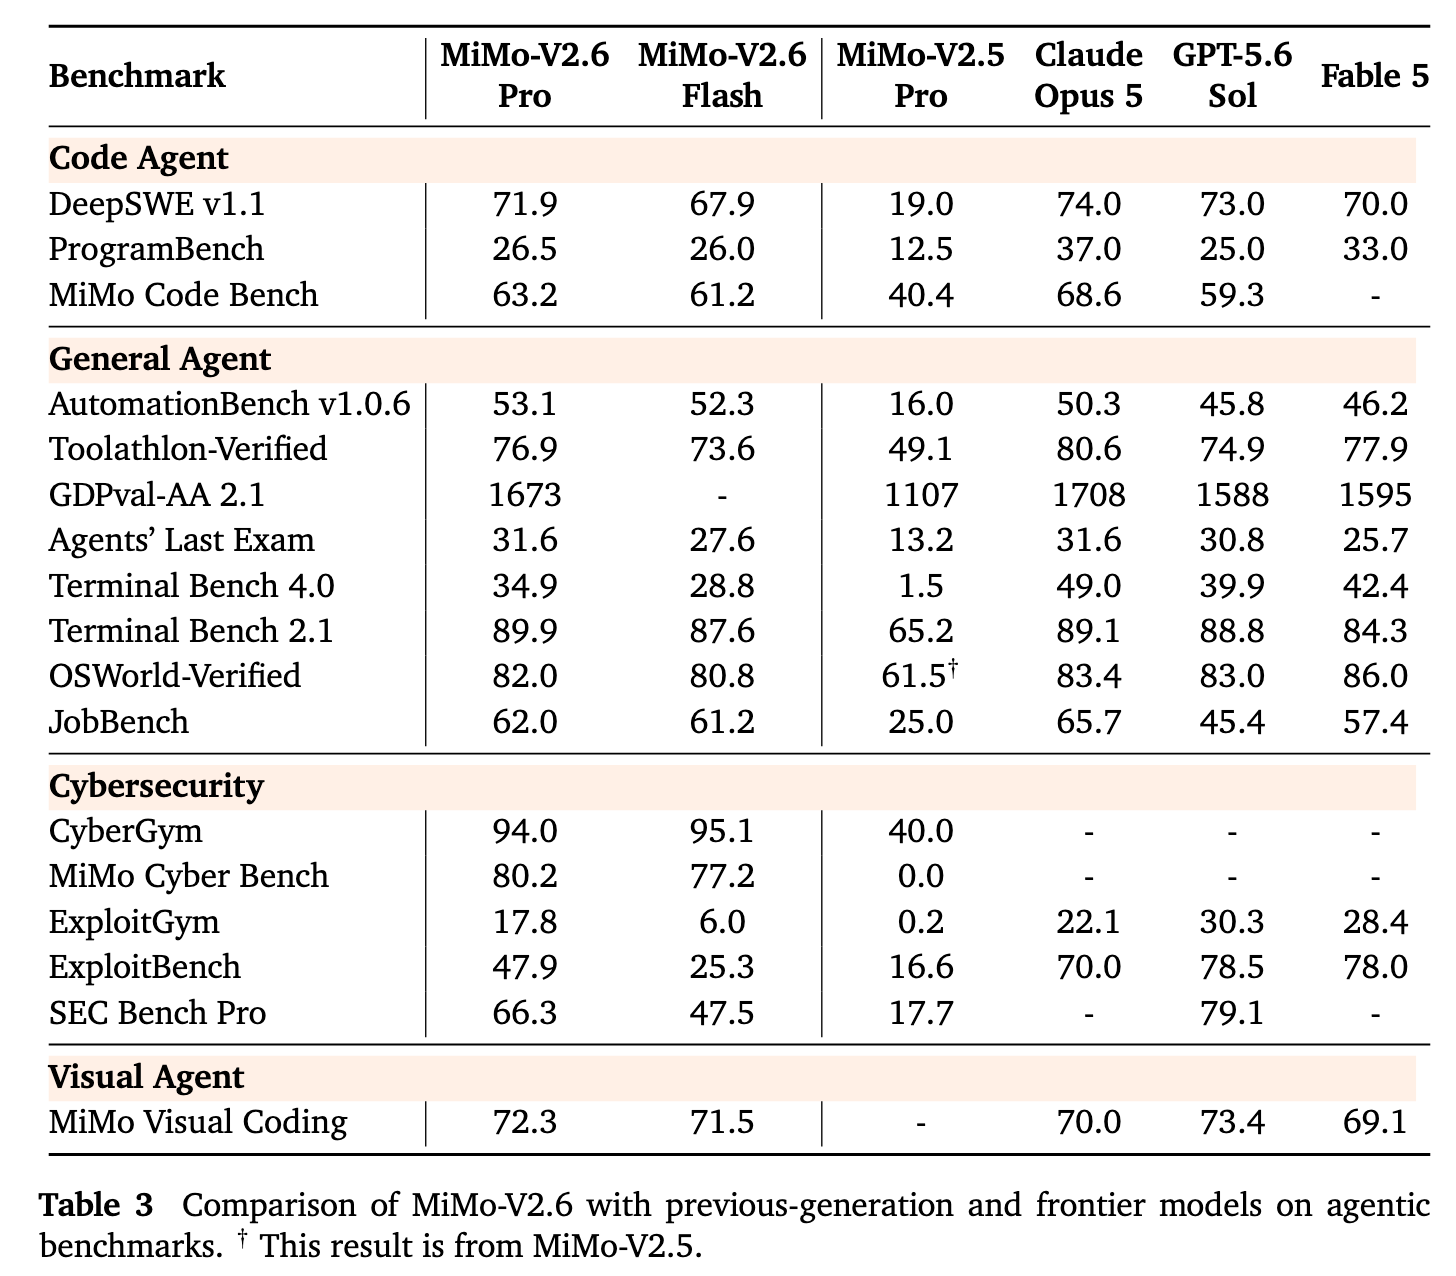
Las comparaciones directas de benchmarks requieren cautela. Los proveedores no siempre usan arneses, presupuestos de razonamiento, checkpoints o configuraciones de herramientas idénticos. Incluso cuando los nombres de los benchmarks coinciden, pequeñas diferencias en la puntuación pueden ser menos significativas de lo que parecen. La comparación más segura es separar las mediciones genuinamente alineadas de la evidencia direccional.
Artificial Analysis Intelligence Index
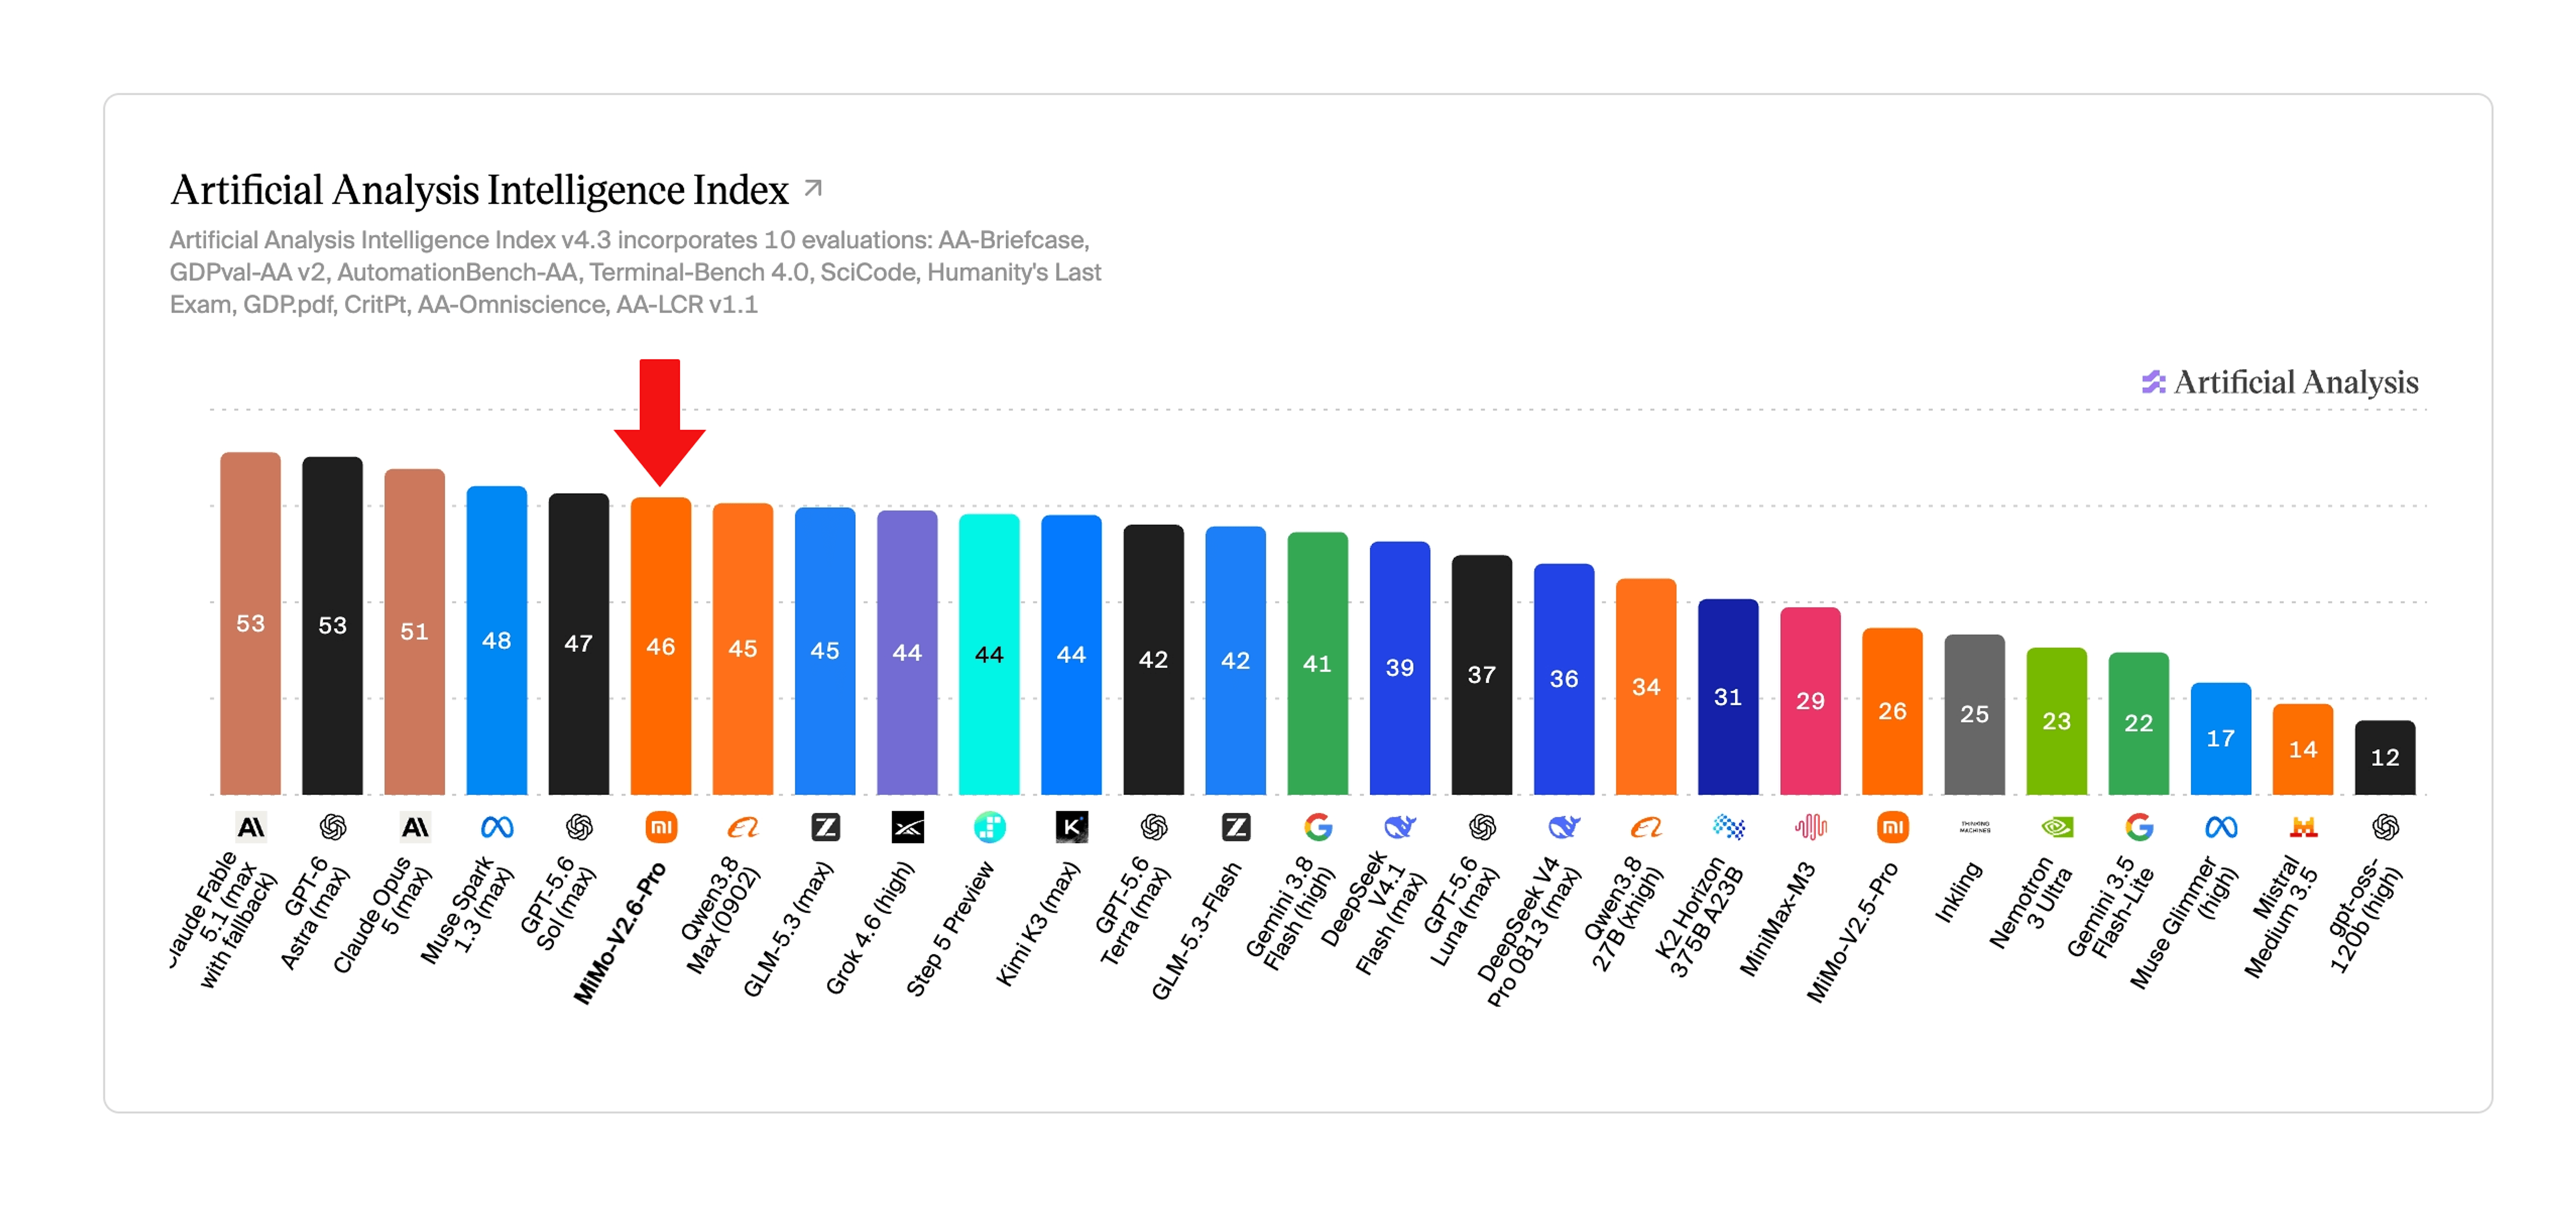
Xiaomi reporta 46.32 para MiMo-V2.6-Pro en el índice compuesto de Artificial Analysis. Cualquier comparación con Grok debe vincularse al snapshot exacto de Artificial Analysis y a la configuración del modelo utilizada; no debe presentarse una afirmación de igualdad redondeada sin esa fuente.
Rendimiento en programación y agentes
| Benchmark | Grok 4.7 — SpaceXAI | MiMo-V2.6-Pro — Xiaomi | Interpretación |
|---|---|---|---|
| DeepSWE v1.1 | 71.0* | 71.9** | Cercanos numéricamente; las ejecuciones y configuraciones publicadas difieren |
| GDPval-AA | Ver gráfica de SpaceXAI | 1,673 | Solo direccional a menos que los arneses estén alineados |
| AA Briefcase | 1,657 | Ver gráfica de Xiaomi | Usar los valores reportados por el proveedor con el contexto de la fuente |
| Terminal-Bench 4.0 | 38.0 | 34.9 | Dirección similar; el arnés importa |
| Context window | 500K | 1M | MiMo admite más contexto de trabajo |
* SpaceXAI reporta DeepSWE de Grok 4.7 con esfuerzo alto. ** La tabla de comparación final de Xiaomi reporta 71.9; su curva de entrenamiento Live RL alcanza aproximadamente 72.6. Estas cifras provienen de contextos de evaluación distintos.
Adecuación al flujo de trabajo de programación
Para programación, la distinción depende de si “programación” significa resolución de problemas de repositorio en bruto o una experiencia completa de agente de programación gestionado. En DeepSWE v1.1, las cifras publicadas son lo suficientemente cercanas como para que una brecha inferior a un punto no deba decidir por sí sola la selección en producción.
La ventaja de Grok 4.7 es mayor en la capa superior. Está integrado con Grok Build, disponible en Cursor, diseñado para entender de forma nativa el arnés de Grok Bot y emparejado con herramientas de primera parte para ejecución de código y búsqueda.
La ventaja de MiMo-V2.6-Pro es mayor en la capa inferior. Los pesos abiertos lo hacen práctico para construir un asistente de programación privado, personalizar el servicio, aplicar controles de residencia de datos o experimentar con un arnés de agentes propietario.
Para equipos que eligen entre ambos, una prueba A/B de producción en repositorios representativos será más informativa que un solo benchmark público de programación.
Grok 4.7 vs MiMo-V2.6-Pro: Diferencias de capacidad multimodal
Esta es una de las diferencias más claras. Grok 4.7 acepta entradas de texto e imagen y produce texto. La plataforma más amplia de Grok ofrece productos multimedia por separado, pero no deben confundirse con la superficie de modalidades del propio modelo grok-4.7.
MiMo-V2.6-Pro admite comprensión de texto, imagen, audio y video. Combinado con una ventana de contexto de 1M tokens, esto amplía el rango de flujos de trabajo que pueden manejarse en un solo contexto de modelo.
- Análisis de capturas de pantalla y código en la misma tarea
- Comprensión de video con instrucciones adjuntas
- Procesamiento de audio de formato largo
- Agentes de uso de computadora con retroalimentación visual
- Asistentes de investigación multimodal
- Extracción y QA multimodal a gran escala
Grok 4.7 vs MiMo-V2.6-Pro: Comparación de precios de API
| Official API pricing | Grok 4.7 | MiMo-V2.6-Pro |
|---|---|---|
| Input / 1M tokens | $2.00 | $0.435 |
| Cached input / 1M | $0.50 | $0.0036 |
| Output / 1M | $6.00 | $0.87 |
| Long-context surcharge | Sí, por encima de 200K tokens de prompt | No hay una categoría estándar comparable publicada |
| Open-weight/self-host option | No | Sí |
A precio de lista, MiMo-V2.6-Pro es varias veces más barato tanto en entrada normal como en salida generada, con una diferencia especialmente grande para el contexto en caché. Esto puede afectar materialmente la economía de agentes que procesan repetidamente repositorios, documentos largos o contexto persistente.
Importante sobre precios: la ventana de contexto de 500K de Grok 4.7 no significa que todo el contexto se facture a la tarifa estándar. Las solicitudes por encima de 200K tokens de prompt se cobran a la categoría de contexto largo.
Al 24 de septiembre de 2026, CometAPI lista Grok 4.7 a $1.60 en entrada y $4.80 en salida por 1M de tokens, frente a los $2.00 y $6.00 oficiales. Lista MiMo-V2.6-Pro a $0.348 en entrada y $0.696 en salida, frente a los $0.435 y $0.87 oficiales. Esas tarifas estándar listadas están un 20% por debajo de las oficiales correspondientes. Los precios y la elegibilidad pueden cambiar; confirme las páginas de modelos en vivo antes de presupuestar.
El precio por token no es idéntico al costo por tarea completada. Los modelos de razonamiento pueden consumir volúmenes de tokens distintos, usar diferentes números de llamadas a herramientas y requerir tasas de reintento diferentes. La evaluación en producción debe, por tanto, rastrear costo por tarea completada, latencia y tasa de éxito en conjunto.
Grok 4.7 vs MiMo-V2.6-Pro: Acceso y disponibilidad
La diferencia de acceso es sencilla: Grok 4.7 está disponible a través de la API y flujos de trabajo gestionados de Grok, mientras que sus pesos de modelo no se ofrecen para autoalojamiento. MiMo-V2.6-Pro está disponible a través de la API y como pesos abiertos, dando a los equipos una ruta adicional de autoalojamiento.
La disponibilidad es independiente de la flexibilidad de licencia o implementación. Al 24 de septiembre de 2026, ambos modelos también tienen páginas de catálogo en vivo en CometAPI. Los equipos deben confirmar el endpoint, la región, los límites de tasa y la elegibilidad de la cuenta antes del despliegue en producción; que un modelo esté listado no garantiza la misma disponibilidad o niveles de servicio para todas las cuentas.
| Availability question | Grok 4.7 | MiMo-V2.6-Pro |
|---|---|---|
| Official API | Disponible a través de xAI | Disponible a través de Xiaomi MiMo |
| CometAPI catalog | Listado como disponible | Listado como disponible |
| Self-hosted weights | No disponibles | Opción de pesos abiertos |
| Operational check | Confirmar acceso de cuenta, región, límites de tasa y disponibilidad de herramientas | Confirmar acceso de cuenta, preparación del endpoint y requisitos de autoalojamiento |
Pesos abiertos y acceso propietario
Que MiMo-V2.6-Pro sea de pesos abiertos cambia la comparación más que una brecha de un punto en un benchmark. Crea opciones para implementación privada, ajuste del motor de inferencia, post-entrenamiento personalizado, controles de residencia de datos e integración de infraestructura más profunda.
Grok 4.7 toma la compensación opuesta: menos control sobre los internos del modelo a cambio de un servicio gestionado y operado continuamente y un ecosistema de primera parte estrechamente integrado. Para muchas organizaciones, los requisitos de gobernanza e infraestructura determinarán la lista corta antes que el rendimiento en benchmarks.
Cómo usar las APIs de Grok 4.7 y MiMo V2.6 en CometAPI
Los desarrolladores pueden acceder a la API de Grok 4.7 en CometAPI mediante un flujo de API unificado, reduciendo la necesidad de mantener integraciones específicas por proveedor.
Para equipos que hagan benchmarks de múltiples modelos de frontera, una capa de API unificada es especialmente útil porque los mismos prompts de producción, arnés de pruebas, contabilidad de tokens y código de aplicación pueden reproducirse entre modelos con menos variables de integración.
CometAPI ahora lista MiMo-V2.6-Pro como disponible, con disponibilidad de API confirmada el 22 de septiembre de 2026. Revise el catálogo en vivo y el acceso de la cuenta antes del uso en producción.
Con ambas páginas de modelo listadas como disponibles, una prueba A/B a nivel de aplicación puede mantener tan consistentes como sea posible los prompts, herramientas, ajustes de razonamiento y criterios de éxito, y luego comparar finalización de tarea, latencia, uso de tokens y modos de falla.
Grok 4.7 vs MiMo-V2.6-Pro: Ajuste del modelo por caso de uso
| Requirement | Model fit / evaluation guidance |
|---|---|
| First-party web and X search | Grok 4.7 |
| Managed long-running agents | Grok 4.7 |
| Grok Build / Cursor workflows | Grok 4.7 |
| 1M-token context | MiMo-V2.6-Pro |
| Native audio/video understanding | MiMo-V2.6-Pro |
| Open weights, self-hosting, and model control | MiMo-V2.6-Pro |
| Lowest raw API token cost | MiMo-V2.6-Pro |
| Repository coding | Evaluar ambos en repositorios representativos |
| Professional knowledge agents | Evaluar ambos en tareas de producción |
La decisión debe, por tanto, enmarcarse en torno a la arquitectura de la carga de trabajo. Grok 4.7 está diseñado para hacer más capaz una pila de agentes gestionados; MiMo-V2.6-Pro está diseñado para hacer la inteligencia de alta gama más barata, más multimodal y más controlable.
¿Cuál deberías elegir?
Elige Grok 4.7 si quieres una experiencia de agente gestionado con búsqueda web y X de primera parte, ejecución de código nativa y menos infraestructura que operar. Es la opción más práctica para equipos que valoran una pila de herramientas integrada y flujos de trabajo profesionales o de programación de larga duración.
Elige MiMo-V2.6-Pro si necesitas pesos abiertos, implementación privada, una ventana de contexto de 1M tokens, comprensión nativa de audio y video o precios de API sustancialmente más bajos. Es la opción más sólida cuando el control de implementación, la cobertura multimodal y la eficiencia de costos son las restricciones principales.
Si la elección aún no está clara, ejecuta ambos modelos en las mismas tareas representativas con prompts, herramientas, presupuestos de razonamiento, tiempos de espera y políticas de reintento idénticos. Selecciona el modelo que ofrezca la mejor combinación de tasa de finalización, latencia, costo total por tarea exitosa y esfuerzo de revisión humana.
Conclusión
Grok 4.7 vs MiMo V2.6 es revelador porque la inteligencia bruta ya no es el único diferenciador significativo. Ambos modelos ocupan una banda de alta capacidad similar en las evaluaciones públicas actuales, pero sus estrategias de producto divergen marcadamente.
Grok 4.7 combina una ventana de contexto de 500K, razonamiento configurable, entrenamiento sólido para agentes de largo horizonte y una pila madura de búsqueda y ejecución de primera parte. MiMo-V2.6-Pro combina una ventana de 1M de contexto, entradas multimodales nativas, pesos abiertos y precios de API muy por debajo de muchos sistemas propietarios de frontera.
Para los desarrolladores, la cuestión práctica es menos “¿qué puntuación de benchmark es más alta?” y más “¿dónde debería vivir la inteligencia?”. Un ecosistema de agentes gestionados y una pila de modelos abierta y personalizable resuelven problemas operativos distintos. La elección correcta es la que mejor se ajusta a la carga de trabajo de producción, las restricciones de infraestructura y el modelo de costos.
Preguntas frecuentes
¿Grok 4.7 es un modelo de 2.1 billones de parámetros?
Una cifra de aproximadamente 2.1T circuló antes del lanzamiento, pero la documentación final de SpaceXAI para Grok 4.7 no publica el conteo total o activo de parámetros. La afirmación confirmada es que Grok 4.7 usa un modelo base más grande que Grok 4.6.
¿MiMo-V2.6 es de código abierto?
Xiaomi lanzó MiMo-V2.6 como una familia de modelos abiertos con pesos descargables y recursos de investigación asociados. En la planificación de producción, los equipos deben revisar igualmente la licencia exacta del modelo y los términos de redistribución para su uso previsto.
¿Cuánto cuesta Grok 4.7 vs MiMo-V2.6-Pro por tarea de agente completada?
Normaliza el conjunto de tareas, prompts, permisos de herramientas, política de reintentos y criterios de éxito. Rastrea tokens totales de entrada, entrada en caché, razonamiento y salida, llamadas a herramientas, latencia, reintentos y tiempo de revisión humana. El precio bruto por token es solo un componente del costo por tarea completada.
¿Qué tan fiables son las comparaciones de benchmarks entre Grok 4.7 y MiMo-V2.6-Pro?
Usa el mismo repositorio o conjunto de tareas, arnés de agentes, herramientas, presupuesto de razonamiento, tiempo de espera, política de reintentos y rúbrica de puntuación. Reporta intervalos de confianza o variación por ejecuciones repetidas, y mantén separadas las cifras publicadas por los proveedores de los resultados internos.
¿Grok 4.7 cobra más por prompts de contexto largo?
SpaceXAI documenta tarifas más altas cuando los tokens del prompt superan los 200K. Dado que la categoría superior se aplica a la solicitud, los equipos que usen repositorios grandes o contexto persistente del agente deben modelar explícitamente ese umbral.