
Ejecutar Qwen3.8-Max localmente ya es posible, pero la frase “Qwen 3.8 Max local” necesita una aclaración importante. El producto Max alojado por Alibaba y el checkpoint descargable están estrechamente relacionados, pero no son productos idénticos.
Qwen lanzó por primera vez el servicio Max alojado a principios de agosto de 2026 y liberó Qwen3.8-2.4T-A95B como pesos abiertos el 12 de agosto de 2026. Ese checkpoint es el modelo que realmente despliega en su propia infraestructura.
Esto no es un tutorial típico de “Ollama en un PC gaming”. El checkpoint sin cuantizar es un modelo Mixture-of-Experts de 2,4 billones de parámetros, y la receta actual de vLLM dimensiona sus pesos BF16 en 4.45 TiB. Incluso las variantes de coma flotante de 4 bits orientadas a producción ocupan aproximadamente 1.3–1.5 TiB de pesos.
Respuesta rápida: el autoalojamiento completo de clase Qwen 3.8 Max es un despliegue de centro de datos. Un punto de partida práctico para producción es un checkpoint FP4 en 8× B300 o 8× MI355X; las implementaciones con H200 necesitan más GPU. Para una estación de trabajo normal, use Qwen3.8-27B.
Qwen 3.8 Max vs. el modelo abierto que realmente despliega
El checkpoint descargable Qwen3.8-2.4T-A95B se describe oficialmente como un modelo de lenguaje causal de 2.4T parámetros con unos 95B parámetros activados por token. El servicio Max alojado añade capacidades de capa de producto que no están presentes en el checkpoint abierto actual.
| Especificación | Servicio alojado Qwen3.8-Max | Checkpoint abierto Qwen3.8-2.4T-A95B |
|---|---|---|
| Parámetros totales | 2.4T | 2.4T |
| Parámetros activos | ~95B | ~95B |
| Arquitectura | MoE disperso | MoE disperso |
| Entrada | Texto, imagen, video | Texto |
| Contexto | Contexto gestionado de 1M | 262,144 nativo; extensible a ~1.01M |
| Comportamiento de razonamiento | Opciones de razonamiento gestionado/sin razonamiento | Requiere razonamiento; esfuerzo de razonamiento configurable |
| Herramientas integradas | Disponibles en el servicio gestionado | La aplicación debe proporcionar herramientas |
| Autoalojamiento | No se requiere gestión de pesos | Sí; checkpoint abierto |
El producto alojado expone entrada de texto, imagen y video con un contexto de 1,000,000 tokens. En cambio, el checkpoint abierto es solo de texto y tiene un contexto nativo de 262,144 tokens. Esta diferencia importa si su aplicación depende de entrada multimodal o de herramientas integradas gestionadas.
Arquitectura y especificaciones de Qwen 3.8
CometAPI ya cubre los antecedentes del modelo en What is Qwen3.8 Max, así que esta guía de despliegue mantiene la discusión de arquitectura centrada en los detalles que afectan a memoria, paralelismo y servicio.
| Especificación relevante para despliegue | Qwen3.8-2.4T-A95B |
|---|---|
| Parámetros totales / activados | 2.4T / ~95B por token |
| Disposición de capas | 92 capas: 69 Gated DeltaNet + 23 atención completa |
| Enrutamiento MoE | 512 expertos enrutados; 10 enrutados + 1 compartido activo |
| Cabezas de atención completa | 64 de consulta / 4 de clave-valor |
| Contexto nativo | 262,144 tokens |
| Contexto extendido | Hasta aproximadamente 1,010,000 tokens |
| Predicción de múltiples tokens | Compatible |
| Modalidad del checkpoint abierto | Solo texto |

Arquitectura híbrida oficial de Qwen utilizada en la guía de despliegue de Qwen3.8 de SGLang.
No interprete “95B de parámetros activos” como una huella de memoria de un modelo de 95B. La activación dispersa reduce el cómputo por token, pero el sistema de servicio sigue necesitando acceso al conjunto completo de pesos de expertos.
Instantánea de benchmarks de Qwen 3.8 Max
Dado que la visión general existente de Qwen3.8 Max en CometAPI ya analiza benchmarks en detalle, este artículo usa solo un subconjunto relevante para despliegue de la tabla oficial de benchmarks de la model card de Qwen.
| Benchmark | Qwen3.8-Max | Qwen3.7-Max | GPT-5.6 Sol (max) |
|---|---|---|---|
| Terminal Bench 2.1 | 86.6 | 74.5 | 88.8 |
| SWE-bench Pro | 67.7 | 60.6 | 64.6 |
| PaperBench | 93.0 | 64.8 | 90.5 |
| FrontierSWE | 73.5 | 40.7 | — |
| CoWorkBench | 74.8 | 64.6 | 71.5 |
| GPQA Diamond | 92.6 | 92.4 | 94.1 |
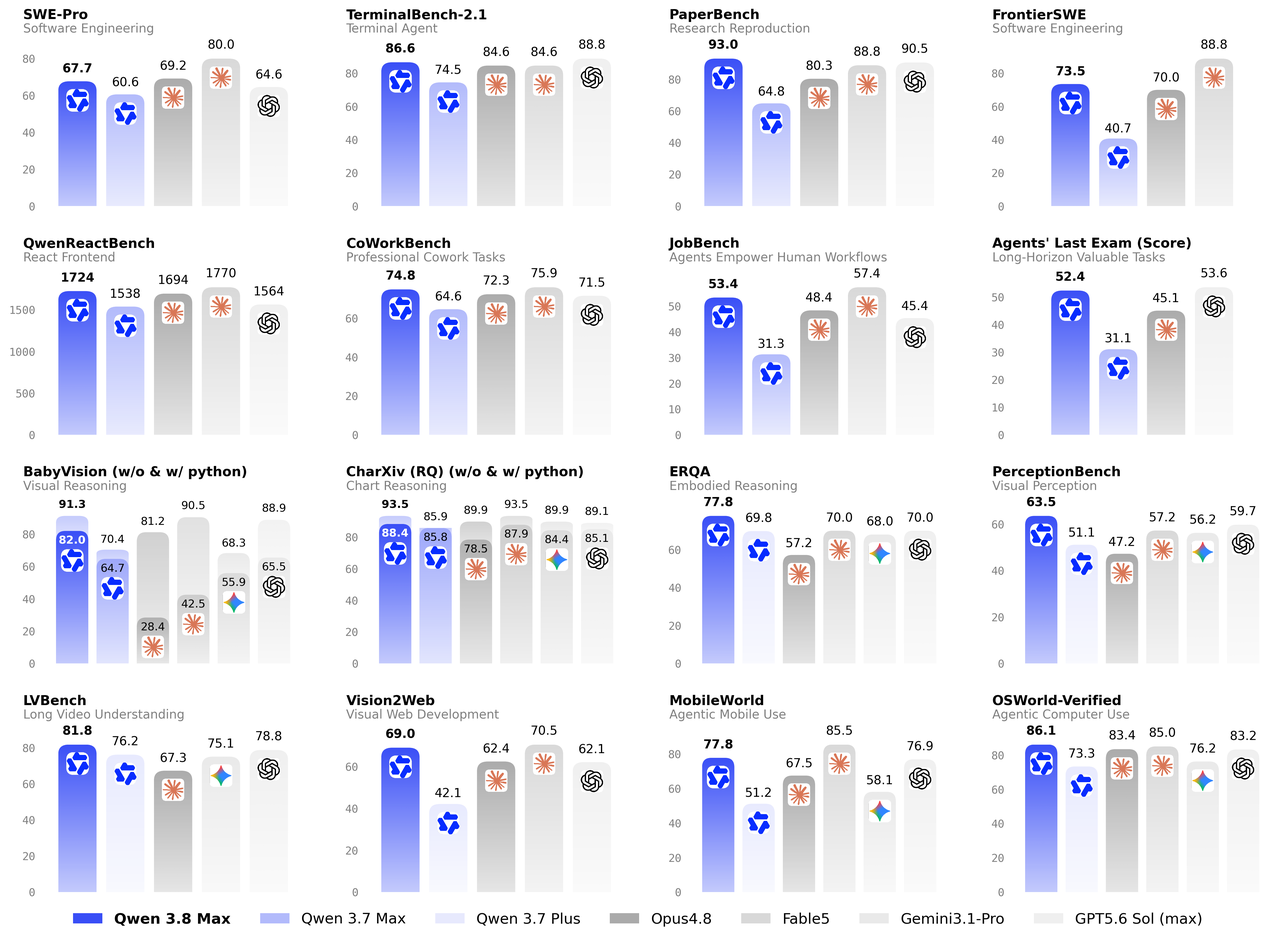
Gráfico oficial de rendimiento de Qwen3.8 publicado por el equipo de Qwen.
Las mayores mejoras reportadas frente a Qwen3.7-Max en este subconjunto son PaperBench y FrontierSWE. Qwen3.8-Max también supera a GPT-5.6 Sol en SWE-bench Pro y PaperBench, mientras que GPT-5.6 Sol se mantiene por delante en Terminal Bench 2.1. Para decisiones de despliegue, trate estos como contexto de capacidades; las mediciones de memoria y rendimiento de servicio a continuación son más relevantes operativamente.
Las tablas de benchmarks no son clasificaciones universales. Los harnesses, timeouts, límites de contexto, acceso a herramientas y cuantización pueden cambiar los resultados. Evalue exactamente el checkpoint, la precisión, el motor de servicio y la distribución de prompts que planea usar.
¿Qué hardware necesita Qwen3.8 para un despliegue local?
Requisitos de GPU para Qwen3.8-2.4T-A95B
Esta es la pregunta clave de despliegue. La receta actual de vLLM para Qwen3.8 publica las huellas de los checkpoints y recuentos de GPU realistas con margen de ejecución, lo cual es más útil que estimar VRAM solo a partir del conteo de parámetros.
| Precisión | Huella de pesos | B300 (268 GB) | MI355X (288 GB) | H200 (141 GB) | Mejor ajuste |
|---|---|---|---|---|---|
| BF16 | 4.45 TiB | 24 GPUs | 24 GPUs | 48 GPUs | Fidelidad máxima / investigación |
| FP8 | 2.27 TiB | 16 GPUs | 16 GPUs | 32 GPUs | Producción de alta fidelidad |
| MXFP4 | 1.45 TiB | — | 8 GPUs | 16 GPUs | Despliegue práctico en AMD |
| NVFP4 W4A4 | 1.32 TiB | 8 GPUs | — | 16 GPUs | Despliegue práctico en NVIDIA |
Para la mayoría de organizaciones que realmente necesitan Qwen3.8 autoalojado, FP4 es el punto de partida práctico. La configuración destacada en NVIDIA es NVFP4 W4A4 en 8× B300; la ruta correspondiente en AMD es MXFP4 en 8× MI355X.
Un servidor con 8× H200 no es suficiente para estos despliegues de modelo completo recomendados. La receta oficial dimensiona H200 en 16 GPUs para FP4, 32 para FP8 y 48 para BF16.
Requisitos de VRAM para Qwen3.8-27B
Qwen3.8-27B es la alternativa práctica a nivel estación de trabajo. La memoria de pesos en bruto es aproximadamente 54 GB en BF16, 27 GB en FP8 y 13.5 GB a 4 bits. La sobrecarga en tiempo de ejecución y la caché KV aumentan el requisito real, especialmente con longitudes de contexto grandes.
| Precisión | Memoria de pesos aproximada | Guía práctica de despliegue |
|---|---|---|
| BF16 | ~54 GB | Use una GPU de 64–80 GB, según contexto y sobrecarga de servicio. |
| FP8 / INT8 | ~27 GB | Una GPU de 40–48 GB ofrece un margen de ejecución más práctico. |
| 4 bits | ~13.5 GB | Una GPU de consumo de 20–24 GB puede ser viable en contextos moderados. |
Estas cifras son estimaciones de planificación derivadas del conteo de parámetros. Confirme el checkpoint exacto, formato de cuantización, motor de servicio, longitud de contexto y configuración de la caché KV antes de dimensionar el hardware de producción.
¿Puede Qwen3.8 ejecutarse en GPUs de consumo?
El modelo completo Qwen3.8-2.4T-A95B no es práctico en GPUs de consumo ordinarias, incluso con cuantización agresiva. Un proyecto comunitario ha demostrado una compilación UD-Q1_0 fuertemente comprimida de 397 GB en cuatro sistemas DGX Spark, pero esa vía es una cuantización extrema experimental más que una base para servicio sensible a la calidad.
Para una estación de trabajo o laboratorio doméstico, el modelo más adecuado es Qwen3.8-27B, cuyos pesos abiertos se publicaron el 14 de agosto de 2026. El modelo es órdenes de magnitud más fácil de alojar y es la opción correcta si “local” significa una sola estación de trabajo en lugar de un clúster de GPU.
Antes de instalar Qwen 3.8 Max
Planifique la infraestructura antes de ejecutar un comando de instalación. Necesita Linux, una pila de aceleración compatible, suficiente almacenamiento local o compartido para el checkpoint, interconexiones de GPU de alto ancho de banda y, al cruzar nodos, una red diseñada para inferencia distribuida. La receta de vLLM actualmente recomienda vLLM nightly y Transformers 5.4.0 o superior.
bash
uv venv
source .venv/bin/activate

uv pip install -U vllm \
  --extra-index-url https://wheels.vllm.ai/nightly

uv pip install -U "transformers>=5.4.0"
Cómo desplegar Qwen 3.8 FP8 con vLLM
FP8 es una elección sensata cuando quiere un checkpoint proporcionado por Qwen y puede costear infraestructura multinodo. El checkpoint oficial es Qwen/Qwen3.8-2.4T-A95B-FP8.
Para un despliegue de dos nodos y 16 GPU de clase B300, ejecute el nodo cabecera con:
bash
export HEAD_ADDR="10.0.0.10"

vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --tensor-parallel-size 16 \
  --nnodes 2 \
  --node-rank 0 \
  --master-addr "$HEAD_ADDR" \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3
On the worker node, use the same topology with a different node rank and no API server:
bash
export HEAD_ADDR="10.0.0.10"

vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --tensor-parallel-size 16 \
  --nnodes 2 \
  --node-rank 1 \
  --master-addr "$HEAD_ADDR" \
  --headless \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3
No copie el ejemplo de 16 GPU en servidores H200 sin redimensionar la topología. La misma variante FP8 está actualmente dimensionada en 32× H200 en la receta de vLLM.
Cómo ejecutar Qwen 3.8 en un servidor con 8× B300
Para NVIDIA Blackwell, la configuración más práctica de modelo completo es NVFP4. vLLM valida actualmente NVFP4 W4A4 con paralelismo de tensores a través de ocho GPUs B300.
bash
vllm serve Inferact/Qwen3.8-2.4T-A95B-NVFP4 \
  --tensor-parallel-size 8 \
  --max-model-len 262144 \
  --kv-cache-dtype fp8 \
  --reasoning-parser qwen3 \
  --enable-auto-tool-choice \
  --tool-call-parser qwen3_coder
La compilación NVFP4 de Inferact es un checkpoint cuantizado en lugar del artefacto BF16 original de Qwen. Valide la calidad del modelo con su propio conjunto de aceptación antes de tratarlo como un reemplazo equivalente de BF16 o FP8.
Cómo desplegar Qwen 3.8 con SGLang
SGLang añadió soporte Day-0 para Qwen3.8 el 12 de agosto y es especialmente atractivo para servicio de alto rendimiento, caché de prefijo, paralelismo de expertos, decodificación especulativa y desagregación de prefill/decodificación.
bash
SGLANG_ENABLE_MOE_DEFERRED_FINALIZE=1 \
SGLANG_FLASHINFER_MNNVL_CUTEDSL_AR_FUSION=1 \
sglang serve \
  --trust-remote-code \
  --model-path RadixArk/Qwen3.8-2.4T-A95B-NVFP4 \
  --tp-size 8 \
  --context-length 200000 \
  --preferred-sampling-params '{"top_k": 20}' \
  --attention-backend trtllm_mha \
  --linear-attn-prefill-backend flashinfer \
  --linear-attn-decode-backend flashinfer \
  --reasoning-parser qwen3 \
  --tool-call-parser qwen3_coder \
  --host 0.0.0.0 \
  --port 30000
SGLang informa 346 tokens/s de salida con tamaño de lote 1 en TP8 B300 con MTP, y un rendimiento agregado sustancialmente mayor en disposiciones de servicio desagregadas. Trate esos números como mediciones de la pila de servicio, no como benchmarks de calidad del modelo.
Probar el endpoint local compatible con OpenAI
Tanto vLLM como SGLang exponen APIs compatibles con OpenAI, lo que facilita la integración en aplicaciones.
python
from openai import OpenAI

client = OpenAI(
    api_key="EMPTY",
    base_url="http://localhost:8000/v1",
    timeout=3600,
)

response = client.chat.completions.create(
    model="Qwen/Qwen3.8-2.4T-A95B-FP8",
    messages=[
        {
            "role": "user",
            "content": "Design a fault-tolerant Redis architecture for three regions."
        }
    ],
    temperature=1.0,
    top_p=0.95,
    max_tokens=8192,
)

print(response.choices[0].message.content)
La model card oficial recomienda temperature=1.0, top_p=0.95 y top_k=20 como parámetros de muestreo base. Para trabajo agentivo, deje suficiente presupuesto de salida para el razonamiento en lugar de dimensionar max_tokens solo para la respuesta final visible.
Habilitar la ventana de contexto de 1M
El checkpoint abierto Qwen3.8-2.4T-A95B tiene un contexto nativo de 262,144 tokens y puede ampliarse a aproximadamente 1.01M. La receta de vLLM documenta el siguiente patrón:
bash
VLLM_ALLOW_LONG_MAX_MODEL_LEN=1 \
vllm serve Qwen/Qwen3.8-2.4T-A95B-FP8 \
  --max-model-len 1010000 \
  --hf-overrides '{"max_position_embeddings": 1010000}' \
  --reasoning-parser qwen3 \
  ...
No haga de 1M el valor por defecto solo porque sea compatible. Contextos máximos más grandes reservan más capacidad de caché y pueden reducir drásticamente la concurrencia. Ajuste --max-model-len al trabajo real.
¿Cómo mejorar el rendimiento de inferencia de Qwen3.8?
Use MTP-3 para reducir la latencia de un solo usuario
Qwen3.8 incluye Predicción de múltiples tokens. En las mediciones publicadas por vLLM, MTP-3 mueve la salida por usuario de 130 a 307 tok/s para FP8 TP16 y de 133 a 304 tok/s para NVFP4 TP8.
bash
--speculative-config '{"method":"mtp","num_speculative_tokens":3}'
Use fastsafetensors para un arranque más rápido
Para modelos a escala de terabytes, el tiempo de arranque importa. En una medición de vLLM, la carga de pesos cayó de 545 s a 306 s con fastsafetensors y carga perezosa.
bash
--load-format fastsafetensors \
--safetensors-load-strategy lazy
Use paralelismo de expertos para aumentar el rendimiento concurrente
Para alta concurrencia, Qwen3.8 se beneficia de disposiciones con paralelismo de expertos porque tiene 512 expertos enrutados. vLLM informa hasta 3,200 tok/s/GPU totales para FP8 EP y hasta 4,300 tok/s/GPU totales para una configuración NVFP4 DEP16 optimizada.
Establezca --max-model-len para equilibrar VRAM y concurrencia
Establezca --max-model-len a la secuencia más larga que su carga realmente requiere. Un valor mayor reserva más capacidad de caché KV, aumenta la presión de memoria y puede reducir el número de solicitudes concurrentes incluso cuando los pesos del modelo ya caben.
Empiece con un percentil representativo de producción en lugar del contexto máximo anunciado del modelo. Haga pruebas de carga con el mismo formato de precisión, patrón de lotes y motor de servicio que usará en producción, y luego elévelo solo cuando solicitudes reales necesiten más contexto.
Despliegue local de Qwen 3.8 Max vs. API
Pesos abiertos no convierten automáticamente la inferencia local en algo económico. La decisión correcta depende de la utilización, la residencia de datos, el personal, los objetivos de disponibilidad y de si realmente necesita las funciones multimodales del modelo gestionado.
| Dimensión | Qwen3.8-2.4T-A95B autoalojado | Qwen3.8-Max vía CometAPI |
|---|---|---|
| Infraestructura | Servidor multi-GPU o clúster | Sin infraestructura GPU |
| Modalidad de entrada | Texto | Texto, imagen, video |
| Contexto | 262K nativo; ~1.01M extendido | 1M gestionado |
| Control de datos | Máximo | API en la nube |
| Operaciones | Usted se encarga del monitoreo, las actualizaciones y la HA | Gestionado por el proveedor |
| Mejor encaje | Residencia de datos, utilización sostenida, equipo de infraestructura | La mayoría de equipos de aplicaciones y cargas variables |
Si ya posee aceleradores adecuados y tiene una utilización consistentemente alta, el autoalojamiento puede justificarse. Si compraría un clúster solo para este modelo, Qwen3.8-Max en CometAPI suele ser la vía de menor fricción. La guía de API existente cubre la integración alojada, mientras que la guía de precios cubre el modelado de costos; por lo tanto, este artículo se centra en el despliegue local.
Problemas comunes en despliegues locales de Qwen 3.8
El servidor se queda sin memoria de GPU durante el arranque
Primero reduzca --max-model-len si el problema es la caché. Si los pesos en sí no caben, la reducción del contexto no resolverá la raíz del problema; cambie a un checkpoint de menor precisión validado o añada GPUs.
El paralelismo de tensores falla con un tamaño no válido
Qwen3.8 tiene 64 cabezas de atención en sus capas de atención completa, por lo que vLLM requiere que TP divida 64. Tamaños sencillos de TP son 1, 2, 4, 8, 16 y 32. Por lo tanto, la VRAM agregada bruta no es suficiente para elegir una topología.
El servidor tarda mucho en iniciar
Cargar de uno a varios terabytes de pesos más la JIT de kernels puede tomar minutos. Aumente VLLM_ENGINE_READY_TIMEOUT_S y sondee un endpoint real de inferencia en lugar de suponer una ventana de arranque corta.
El modelo local no puede procesar una imagen
Es lo esperado. El checkpoint abierto Qwen3.8-2.4T-A95B es solo de texto. Esta limitación es específica de Qwen3.8-2.4T-A95B. Qwen3.8-27B admite entrada visual cuando se cargan sus archivos de proyección de visión por separado.
El contexto de 1M reduce drásticamente el rendimiento
Reduzca --max-model-len a la secuencia más larga que su carga realmente necesita. La ventana de contexto más grande compatible no es necesariamente el mejor ajuste para producción; elija un límite de contexto que equilibre requisitos de carga, uso de la caché KV y concurrencia.
¿Pueden Ollama o LM Studio ejecutar Qwen 3.8 Max?
El ecosistema puede empaquetar pesos de Qwen3.8 fuertemente cuantizados para inferencia estilo llama.cpp, pero eso no debe confundirse con un flujo de trabajo normal de escritorio con Ollama. Una compilación cuantizada que ocupa cientos de gigabytes todavía requiere cientos de gigabytes de memoria accesible e implica concesiones significativas en calidad y rendimiento.
Para desarrollo local ordinario, Qwen3.8-27B es el objetivo adecuado. El modelo completo de 2.4T debe tratarse como un modelo para servidor/clúster incluso cuando cuantizaciones extremas de la comunidad lo hagan técnicamente arrancable en hardware inusual.
¿Qué método de despliegue debería elegir?
Para NVIDIA Blackwell, un despliegue NVFP4 en 8× B300 es actualmente el punto de partida más limpio para el modelo completo. Para AMD, 8× MI355X con MXFP4 es la configuración práctica correspondiente. Use FP8 cuando priorice la procedencia del checkpoint y la calidad frente al tamaño de la infraestructura, y BF16 solo cuando la fidelidad máxima justifique requisitos de memoria a escala multibastidor.
Para una estación de trabajo, use Qwen3.8-27B. Para equipos de aplicaciones que necesitan capacidades Max sin operar un clúster de GPU, use el modelo Qwen3.8-Max alojado en CometAPI.
Conclusión
Qwen3.8-Max ha cruzado una frontera importante desde su lanzamiento inicial por API: la familia Qwen de clase Max ahora tiene un checkpoint abierto de 2.4T que las organizaciones pueden operar íntegramente en su propia infraestructura.
Pero pesos abiertos no significan hardware de consumo. La huella BF16 de 4.45 TiB, el checkpoint FP8 de 2.27 TiB y las variantes FP4 de 1.3–1.5 TiB hacen de Qwen3.8-2.4T-A95B uno de los modelos abiertos más intensivos en infraestructura disponibles. La ventaja práctica es que vLLM y SGLang ya soportan la arquitectura, y FP4 hace factible un despliegue de un solo nodo con 8× B300 o 8× MI355X.
AutoalójelO cuando el control de datos, la utilización sostenida y la propiedad de la infraestructura justifiquen el clúster. En caso contrario, use la API Max gestionada —o Qwen3.8-27B cuando lo que realmente quiera sea un modelo Qwen sólido en una sola estación de trabajo.