
TL;DR
DeepSeek-V4.1-Flash tiene pesos abiertos y puede autoalojarse, pero “local” no significa “en una PC para gaming”. DeepSeek lo describe como un backbone de Mezcla de Expertos con 552B parámetros usando una arquitectura Codificador-Descodificador Causal, con solo 8B parámetros activos durante el prefill y 16B durante la generación. El modelo completo sigue siendo un objetivo de despliegue a escala frontera.
La receta actual de despliegue en vLLM sitúa el checkpoint aproximadamente en 511 GB en disco y cerca de 614 GB de VRAM mínima, haciendo que un servidor de clase 8×H200 o un sistema de gran memoria sean mucho más realistas que una estación de trabajo de consumo.
Para equipos que solo necesitan acceso y no control a nivel de pesos, la API DeepSeek V4.1 Flash en CometAPI es sustancialmente más simple que mantener un servidor de inferencia multi-GPU.
Puntos clave
- DeepSeek-V4.1-Flash usa un backbone MoE de 552B con 8B parámetros activos durante el prefill y 16B durante el decode; los parámetros activos no representan el requisito de memoria residente.
- Su contexto de 1,048,576 tokens y un caché KV global de 890 bytes por token reducen la presión del caché, pero los pesos del modelo siguen dominando la planificación de capacidad.
- El checkpoint oficial ocupa alrededor de 511 GB en disco. La receta de vLLM estima aproximadamente 614 GB de VRAM útil agregada como presupuesto mínimo para cargar el modelo y su overhead en tiempo de ejecución; es una estimación de base, no una garantía para todo tamaño de lote, longitud de contexto o configuración multimodal.
- vLLM es la vía más clara para servir en producción, mientras que SGLang apunta a inferencia distribuida avanzada; la ruta actual de Ollama es alojada en la nube en lugar de inferencia local completa.
- Autoalojar es más convincente para privacidad, operación air-gapped, investigación a nivel de pesos o utilización sostenida del clúster; la mayoría de desarrolladores encontrarán más simple usar una API alojada.
¿Qué es DeepSeek-V4.1-Flash? Arquitectura, parámetros y tamaño del modelo
DeepSeek lanzó oficialmente V4.1-Flash el 10 de septiembre de 2026 como el modelo más pequeño de su nueva familia de arquitecturas, con comprensión visual nativa. A pesar del nombre “Flash”, no es un modelo denso pequeño.
Su cambio arquitectónico clave es el diseño Codificador-Descodificador Causal (CED). El modelo divide el cómputo asimétricamente entre la ingesta del prompt y la generación de tokens, reduciendo el cómputo activo mientras conserva un pool de expertos muy grande.
| Especificación | DeepSeek-V4.1-Flash |
|---|---|
| Arquitectura | MoE multimodal con Codificador-Descodificador Causal |
| Parámetros del backbone | 552B |
| Parámetros activos, entrada | 8B |
| Parámetros activos, salida | 16B |
| Capas Transformer | 40: 20 codificador + 20 descodificador |
| Ventana de contexto | 1,048,576 tokens |
| Caché KV global | 890 bytes/token |
| Modalidades | Entrada de texto + imagen, salida de texto |
| Licencia de los pesos | MIT |
| Muestreo recomendado | Temperatura 1.0; top_p 0.95 o 1.0 |
| Pesos oficiales | Hugging Face |
| Opciones principales de servicio local | vLLM, SGLang, DeepSeek reference inference |
La distinción entre parámetros activos y parámetros residentes es esencial. El enrutamiento MoE reduce la cantidad de cómputo usado por token individual, pero el servidor aún necesita acceso a los pesos de expertos que podrían seleccionarse. Por eso un modelo “de 8B activos” todavía puede requerir cientos de gigabytes de almacenamiento y memoria de acelerador.
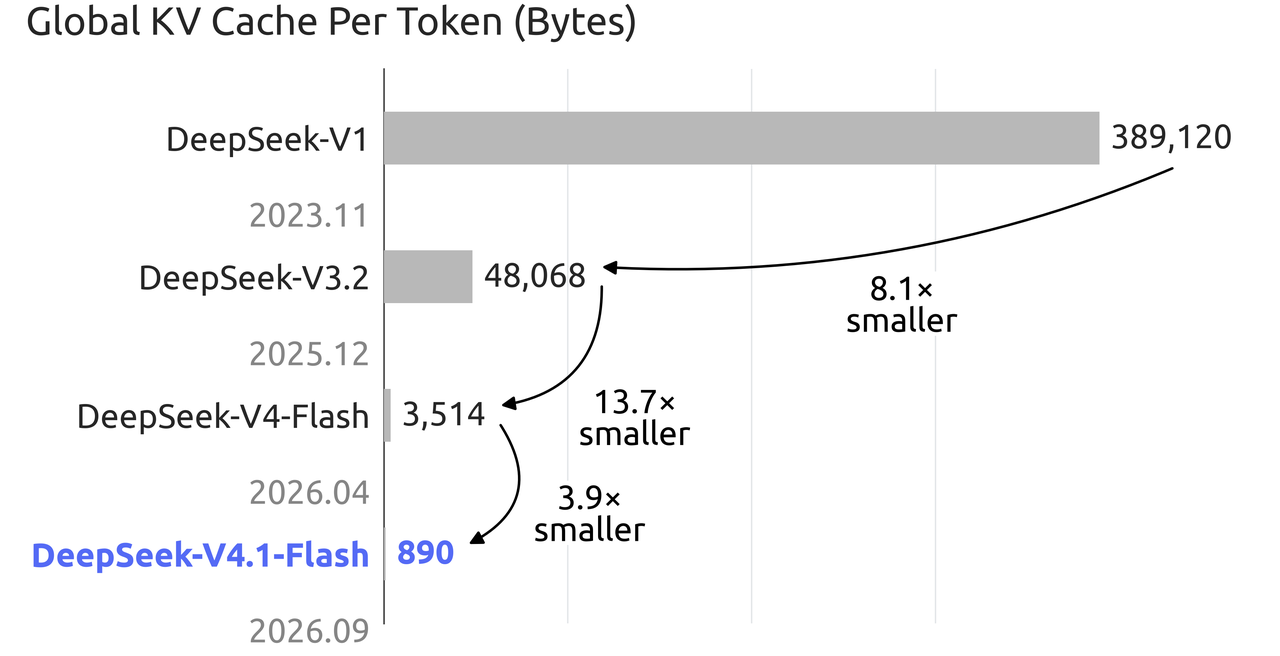
El gráfico oficial del caché KV de DeepSeek muestra que el caché global cae de 3,514 bytes por token en V4 Flash a 890 bytes por token en V4.1 Flash, una reducción de alrededor de 3.9×. Eso importa para inferencia de millón de tokens, pero no elimina el requisito de memoria mucho mayor creado por los propios pesos del modelo.
¿Qué tan bueno es DeepSeek-V4.1-Flash antes de desplegarlo?
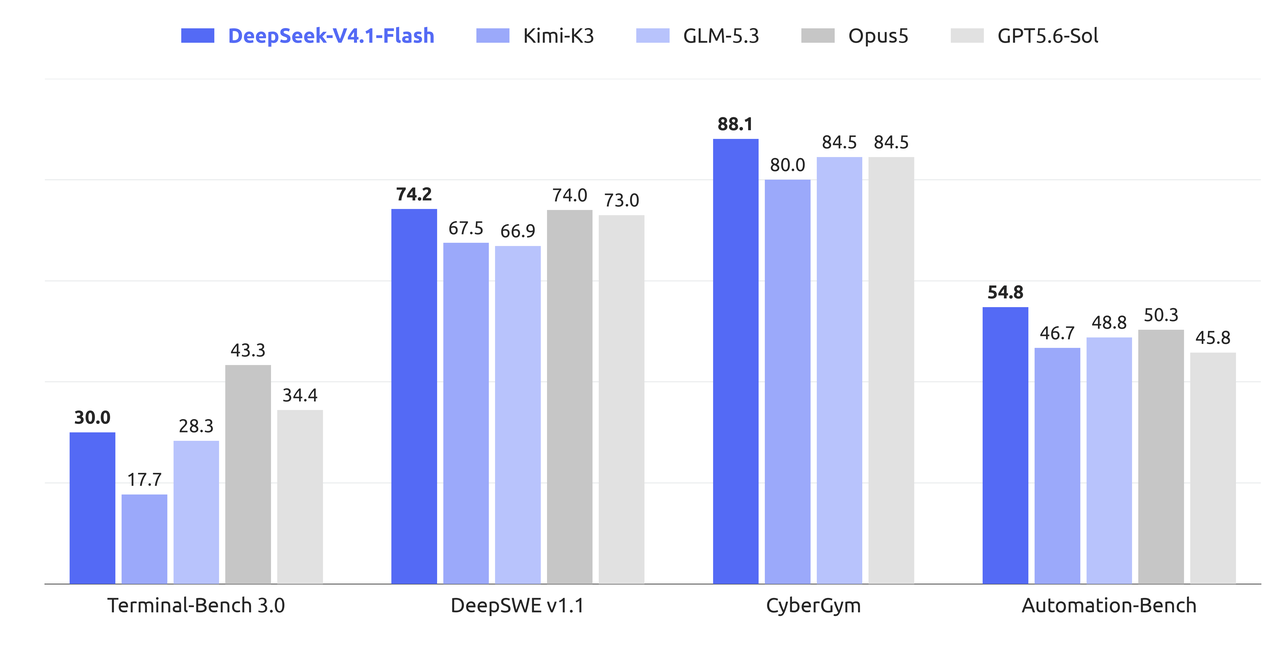
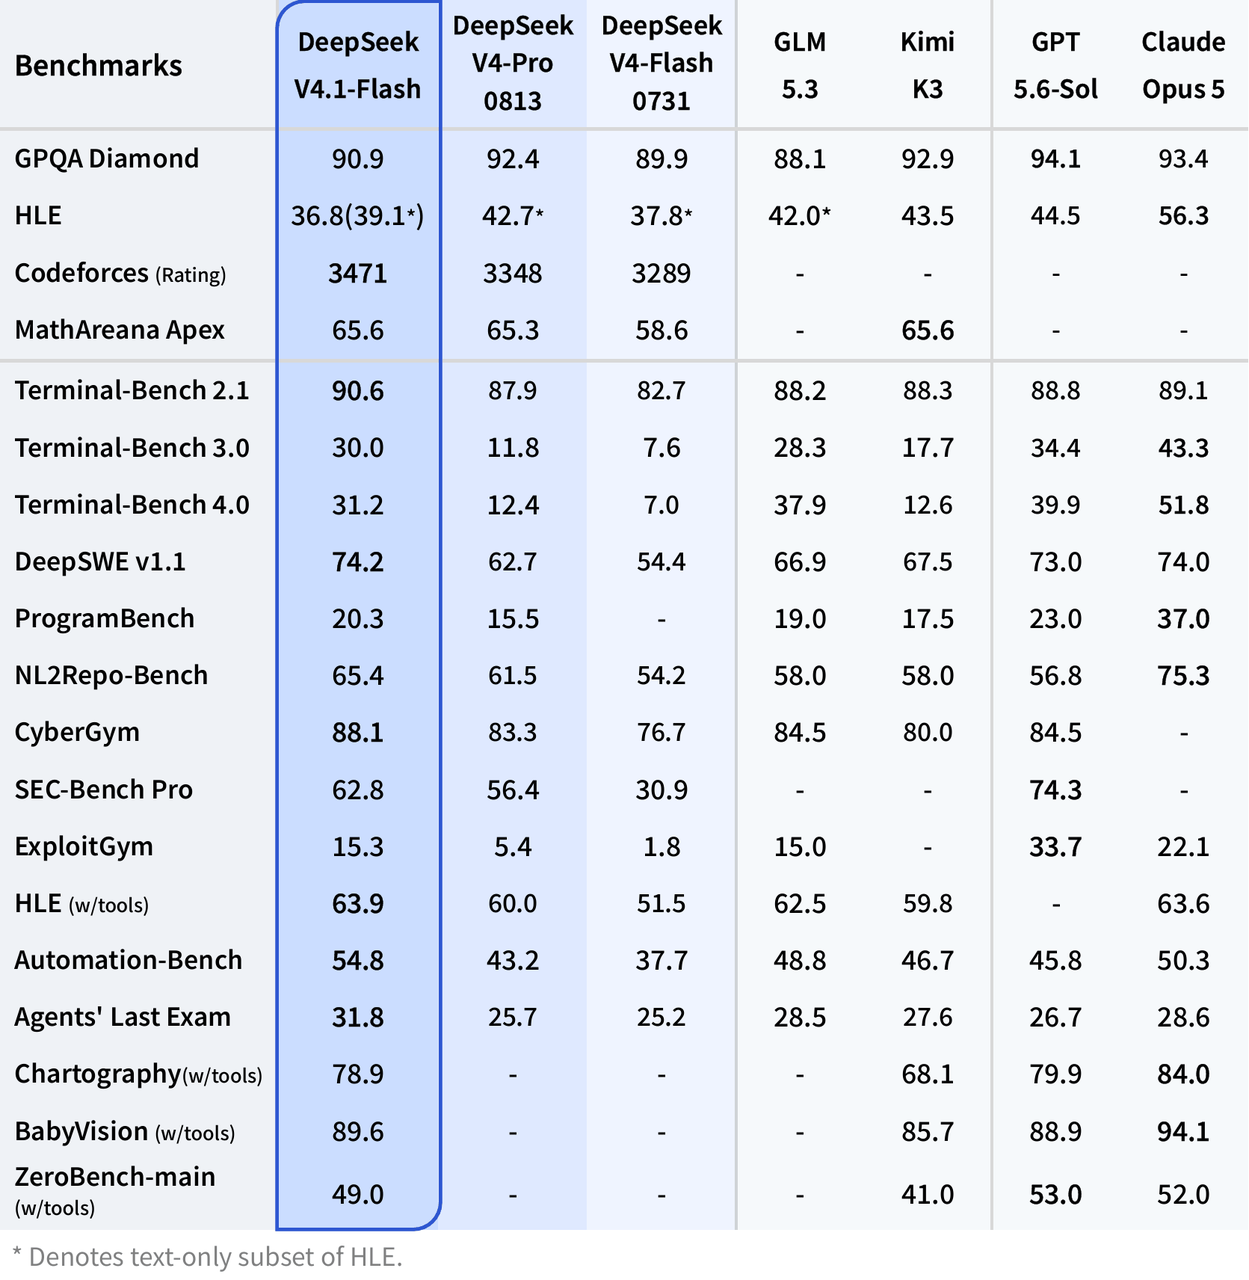
La tabla de benchmarks publicada por DeepSeek posiciona V4.1-Flash principalmente como una gran mejora en codificación agentiva, operación de terminal, automatización y cargas de trabajo de ingeniería de software. Estos son resultados de benchmarks reportados por el proveedor, por lo que deben tomarse como mediciones de referencia en lugar de rendimiento garantizado en aplicaciones.
Para reproducibilidad, la model card oficial recomienda temperatura 1.0 y top_p 0.95, mientras que el esfuerzo de razonamiento y los presupuestos de tokens varían según la evaluación. Las cifras a continuación son resultados de referencia ejecutados por el proveedor, no garantías de rendimiento neutrales al hardware; deben consultarse los detalles de cada harness de benchmark antes de reproducirlos.
| Benchmark | DeepSeek V4.1 Flash | DeepSeek V4 Pro 0813 | DeepSeek V4 Flash 0731 |
|---|---|---|---|
| GPQA Diamond | 90.9 | 92.4 | 89.9 |
| Codeforces Rating | 3471 | 3348 | 3289 |
| MathArena Apex | 65.6 | 65.3 | 58.6 |
| Terminal-Bench 2.1 | 90.6 | 87.9 | 82.7 |
| Terminal-Bench 3.0 | 30.0 | 11.8 | 7.6 |
| Terminal-Bench 4.0 | 31.2 | 12.4 | 7.0 |
| DeepSWE v1.1 | 74.2 | 62.7 | 54.4 |
| NL2Repo-Bench | 65.4 | 61.5 | 54.2 |
| CyberGym | 88.1 | 83.3 | 76.7 |
| Automation-Bench | 54.8 | 43.2 | 37.7 |
| Agents' Last Exam | 31.8 | 25.7 | 25.2 |
El patrón es más importante que cualquier puntuación individual. V4.1-Flash no lidera cada benchmark, pero el salto desde V4 Flash 0731 es especialmente grande en Terminal-Bench, DeepSWE, automatización y cargas de ciberseguridad. Esto hace que el despliegue local sea particularmente relevante para agentes de codificación privados, análisis a escala de repositorios, automatización interna e infraestructura de agentes en entornos air-gapped.
¿Realmente puedes ejecutar DeepSeek-V4.1-Flash localmente?
Sí, pero la palabra “localmente” necesita matices. La última receta de vLLM para DeepSeek-V4.1-Flash descompone el checkpoint en aproximadamente medio terabyte y recomienda un presupuesto de VRAM mucho mayor una vez incluido el overhead de ejecución.
| Componente | Tamaño aproximado almacenado |
|---|---|
| Expertos enrutados + DSpark | 259.5 GiB |
| Tablas Engram | 183.1 GiB |
| Atención, proyecciones densas y enrutadores | 6.9 GiB |
| Embeddings, cabeza LM y normalizaciones | 3.9 GiB |
| Escalas de bloque UE8M0 | 21.9 GiB |
| Checkpoint completo | ~476 GiB / ~511 GB |
| Presupuesto mínimo de VRAM recomendado por vLLM | ~614 GB |
La sorpresa clave es que V4.1-Flash ya está fuertemente comprimido internamente. Los pesos de expertos enrutados usan formatos de baja precisión, por lo que el checkpoint oficial no es simplemente un gran modelo en BF16 esperando una conversión fácil a 4 bits.
Requisitos de hardware de DeepSeek-V4.1-Flash
| Configuración de hardware | Estado práctico | Comentarios |
|---|---|---|
| 1× RTX 4090 / 5090 | No | Muy por debajo de la huella de memoria del modelo |
| 2–4 GPUs de consumo | No para el checkpoint oficial | La VRAM agregada sigue siendo insuficiente |
| Estación de trabajo de 128 GB | No | Los parámetros activos no determinan la memoria residente de los pesos |
| Estación de trabajo de 256 GB | No para la ruta oficial de servicio | Aún muy por debajo de la huella del checkpoint oficial |
| 512 GB de RAM + offload a GPU | Experimental | Territorio de comunidad/offload, no equivalente a servicio de producción verificado |
| 4× GPUs de centro de datos de gran memoria | Dependiente del hardware | Posible con aceleradores modernos suficientemente grandes; revisa la receta de runtime |
| 8× H200 | Sí, clase documentada | Alrededor de 1,128 GB de HBM agregada |
| Sistema clase GB200 NVL4 | Sí | vLLM cita que un tray de 768 GB encaja el modelo |
Importante: 8B de parámetros activos no significa 8 GB de VRAM. “Activos” describe cuánto de la red MoE participa en el cómputo de un token. El conjunto completo de expertos aún debe almacenarse en algún lugar accesible para el motor de inferencia.
¿Qué runtime deberías usar para DeepSeek-V4.1-Flash?
| Runtime | Estado actual de V4.1-Flash | Mejor uso |
|---|---|---|
| vLLM | Receta de despliegue actual disponible; imagen reciente requerida | Servicio de producción compatible con OpenAI |
| SGLang | Soportado a través de builds actuales de despliegue de DeepSeek-V4.1 | Inferencia distribuida de alto rendimiento |
| DeepSeek reference inference | Implementación oficial TP8 de referencia | Investigación y validación de la arquitectura |
| Transformers | Integración del modelo expuesta en Hugging Face | Desarrollo y experimentación; aún se requiere hardware |
| Ollama | La ruta de la librería oficial usa :cloud | Invocación en la nube conveniente, no equivalente a autoalojamiento |
Para autoalojar en producción, vLLM es actualmente el punto de partida más claro. La guía de despliegue de SGLang ofrece otra ruta soportada para inferencia distribuida avanzada.
Cómo ejecutar DeepSeek-V4.1-Flash localmente con vLLM
Esta es la ruta práctica para un servidor Linux multi-GPU.
Todos los ejemplos de comandos a continuación están reformateados como bloques de código específicos del lenguaje con descripciones concisas en inglés.
Paso 1: Comprueba tu entorno
- Linux.
- Docker.
- NVIDIA Container Toolkit.
- Varios cientos de gigabytes de espacio SSD libre.
- Una configuración multi-GPU compatible.
- Aproximadamente 614 GB de memoria de acelerador utilizable agregada para el perfil de servicio con pesos oficiales actual.
- Una red rápida si el modelo no está ya en caché localmente.
Paso 2: Descarga los pesos de DeepSeek-V4.1-Flash
Los pesos oficiales están alojados en el repositorio de Hugging Face de DeepSeek-V4.1-Flash bajo la licencia MIT.
python -m pip install -U huggingface_hub
hf download deepseek-ai/DeepSeek-V4.1-Flash
Asegúrate de que el sistema de archivos que contiene ~/.cache/huggingface tenga sustancialmente más de 511 GB libres. Los archivos temporales y artefactos adicionales del motor pueden aumentar el uso máximo de disco.
Paso 3: Inicia DeepSeek-V4.1-Flash con vLLM
Según la receta actual de vLLM, el soporte de DeepSeek-V4.1 requiere una imagen de vLLM lo suficientemente reciente. Una configuración inicial de ocho GPUs solo texto puede verse así:
docker run --rm \
  --gpus all \
  --ipc=host \
  -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -e VLLM_ENGINE_READY_TIMEOUT_S=3600 \
  vllm/vllm-openai:nightly \
  deepseek-ai/DeepSeek-V4.1-Flash \
  --host 0.0.0.0 \
  --port 8000 \
  --tensor-parallel-size 8 \
  --language-model-only \
  --tokenizer-mode deepseek_v41 \
  --tool-call-parser deepseek_v41 \
  --reasoning-parser deepseek_v41 \
  --enable-auto-tool-choice \
  --gpu-memory-utilization 0.90 \
  --max-model-len 131072
Aquí hay dos elecciones deliberadas. Primero, --language-model-only deshabilita el codificador de visión para cargas de trabajo solo de texto. En segundo lugar, empezar en 131,072 tokens es más seguro que habilitar inmediatamente el contexto completo de un millón de tokens. Una vez que el servidor sea estable, puedes incrementarlo:
--max-model-len 1048576
El ajuste apropiado de paralelismo tensorial depende de la topología del acelerador, así que no copies ciegamente --tensor-parallel-size 8 a cada servidor.
Paso 4: Prueba el endpoint local de DeepSeek-V4.1-Flash
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4.1-Flash",
    "messages": [
      {
        "role": "user",
        "content": "¿Cuánto es 17 * 19? Devuelve solo el entero."
      }
    ]
  }'
323
Paso 5: Invoca tu servidor local de DeepSeek-V4.1-Flash con Python
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local"
)

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4.1-Flash",
    messages=[
        {
            "role": "user",
            "content": "Explica la diferencia entre TCP y UDP en tres viñetas."
        }
    ],
    temperature=1.0,
    top_p=0.95
)

print(response.choices[0].message.content)
¿Cómo activas el modo de “pensamiento” de DeepSeek-V4.1-Flash localmente?
V4.1-Flash admite controles explícitos de razonamiento a través de su plantilla de chat. Un ejemplo es:
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="local"
)

response = client.chat.completions.create(
    model="deepseek-ai/DeepSeek-V4.1-Flash",
    messages=[
        {
            "role": "user",
            "content": "Encuentra el algoritmo más eficiente para este problema de planificación."
        }
    ],
    extra_body={
        "chat_template_kwargs": {
            "thinking": True,
            "reasoning_effort": 50
        }
    }
)

print(response.choices[0].message.content)
Si el modelo parece devolver poco o ningún contenido final con un valor pequeño de max_tokens, verifica si el modo de “pensamiento” está consumiendo el presupuesto de generación antes de suponer que el despliegue está roto.
¿Cómo ejecutas DeepSeek-V4.1-Flash con el código de referencia?
DeepSeek también incluye una implementación mínima de inferencia TP8 dentro del repositorio del modelo. Está pensada principalmente como código de referencia legible en lugar de un servidor de producción de alto rendimiento.
cd inference
python -m pip install -r requirements.txt
export HF_CKPT_PATH=/path/to/DeepSeek-V4.1-Flash-HF
export SAVE_PATH=/path/to/DeepSeek-V4.1-Flash-TP8
export MP=8

python convert.py \
  --hf-ckpt-path "${HF_CKPT_PATH}" \
  --save-path "${SAVE_PATH}" \
  --model-parallel "${MP}" \
  --expert-dtype fp4 \
  --tokenizer-path "${HF_CKPT_PATH}"
export CKPT_PATH=/path/to/DeepSeek-V4.1-Flash-TP8
export MP=8

torchrun --nproc-per-node "${MP}" generate.py \
  --ckpt-path "${CKPT_PATH}" \
  --config config.json \
  --interactive \
  --temperature 0.6
Esta ruta es útil para inspeccionar CED, enrutamiento MoE, memoria Engram, decodificación especulativa y detalles de implementación relacionados. Para servir en producción normal, vLLM o SGLang son más fáciles de operar.
¿Puedes ejecutar DeepSeek-V4.1-Flash localmente con Ollama?
No en el mismo sentido que ejecutar un modelo de 7B o 32B normal en Ollama. Ollama actualmente expone V4.1-Flash a través de:
ollama run deepseek-v4.1-flash:cloud
La parte importante es :cloud. La entrada actual de la librería de Ollama usa una ruta en la nube, por lo que este comando no equivale a descargar el modelo completo y realizar inferencia enteramente en tu máquina.
Despliegue local de DeepSeek-V4.1-Flash vs API: ¿qué tiene más sentido?
| Dimensión | DeepSeek-V4.1-Flash local | API alojada |
|---|---|---|
| Hardware inicial | Muy alto | Ninguno |
| Memoria del acelerador | ~614 GB objetivo práctico oficial | Gestionada por el proveedor |
| Control del modelo | Total | Limitado |
| Datos en las instalaciones | Sí | No |
| Modificación de pesos | Sí | No |
| Mantenimiento | Bajo tu responsabilidad | Gestionado por el proveedor |
| Complejidad de configuración | Alta | Baja |
| Escalado | Requiere infraestructura | Basado en API |
| Mejor para | Entornos air-gapped, privados, investigación, clústeres de alta utilización | La mayoría de los desarrolladores y aplicaciones de producción |
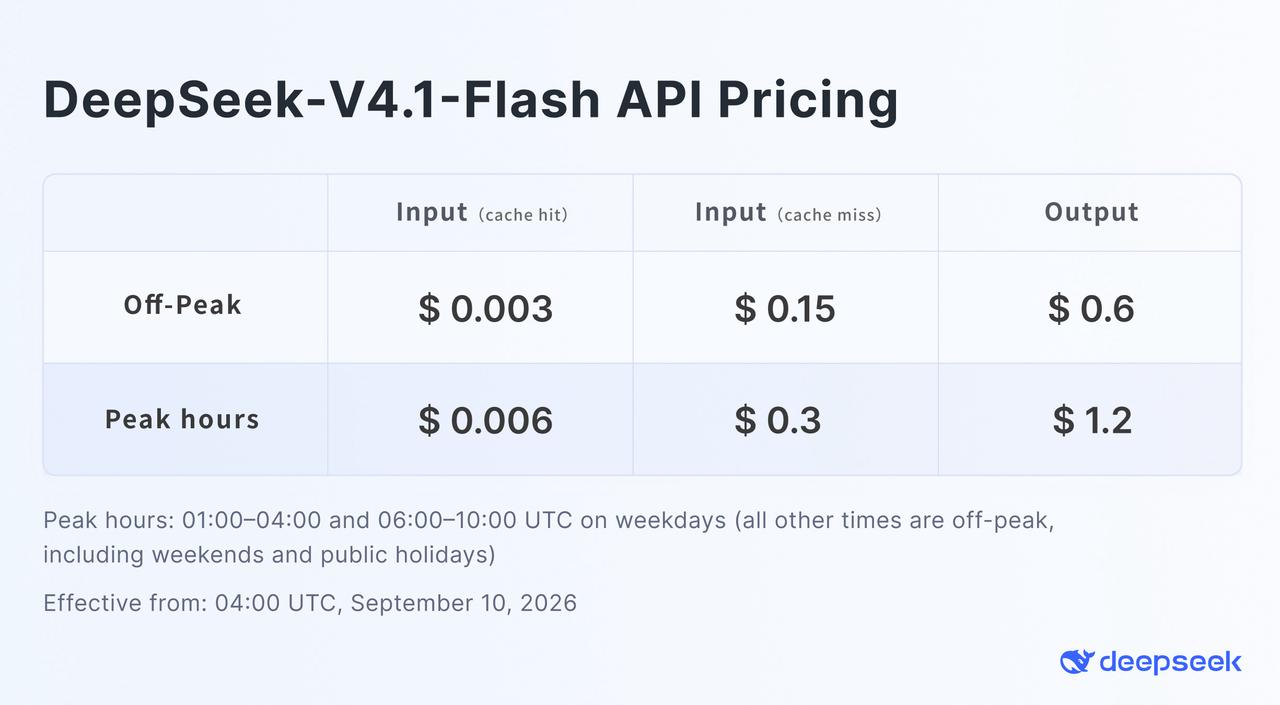
La tarificación oficial off-peak de DeepSeek se muestra en su gráfico de precios de V4.1-Flash. Para desarrolladores que no necesitan posesión física de los pesos, la API de DeepSeek V4.1 Flash en CometAPI proporciona una alternativa compatible con OpenAI.
El siguiente ejemplo usa el identificador de modelo de CometAPI. No es el identificador usado por la API oficial de DeepSeek.
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1"
)

response = client.chat.completions.create(
    model="deepseek-v4.1-flash",
    messages=[
        {
            "role": "user",
            "content": "Revisa esta función de Python e identifica posibles condiciones de carrera."
        }
    ]
)

print(response.choices[0].message.content)
La decisión práctica es sencilla: el despliegue local se vuelve convincente cuando la privacidad, la operación air-gapped, la experimentación a nivel de pesos, la utilización pesada predecible o los requisitos regulatorios superan el costo de la infraestructura. Para el desarrollo de aplicaciones ordinarias, un endpoint alojado evita cientos de gigabytes de gestión de modelo y la orquestación multi-GPU.
¿Qué problemas puedes encontrar al ejecutar DeepSeek-V4.1-Flash localmente?
El servidor se queda sin memoria antes de que comience la generación
El checkpoint completo, no la cifra de 8B/16B de parámetros activos, determina la mayor parte del requisito de memoria. Revisa el paralelismo tensorial, la utilización de memoria GPU, la carga de visión y la HBM disponible.
DeepSeek-V4.1-Flash tarda mucho en iniciar
Un checkpoint de medio terabyte requiere tiempo para descargarse, mapearse, inicializarse y fragmentarse. Tiempos de espera largos hasta que el motor está listo son normales para esta clase de modelo.
La respuesta está vacía o termina con finish_reason=length
El modo de “pensamiento” puede estar consumiendo el presupuesto de generación. Aumenta max_tokens, reduce el esfuerzo de razonamiento o desactiva el pensamiento para solicitudes simples.
Las llamadas a herramientas no se analizan correctamente
Asegúrate de que el servidor esté usando el tokenizer de DeepSeek V4.1, el analizador de tool-calls, el analizador de razonamiento y las flags de auto-tool-choice.
La entrada de visión no funciona
Si iniciaste con --language-model-only, deshabilitaste intencionalmente el codificador visual. Reinicia con soporte multimodal habilitado antes de probar imágenes.
¿Deberías ejecutar DeepSeek-V4.1-Flash localmente?
DeepSeek-V4.1-Flash es inusualmente interesante desde la perspectiva de autoalojamiento porque su arquitectura reduce sustancialmente el cómputo por token y el costo del caché KV, pero no convierte un modelo de pesos abiertos de frontera en un modelo de escritorio.
Para un laboratorio de investigación, una plataforma empresarial de IA, un stack de agentes de codificación privado o un entorno air-gapped, vLLM y SGLang hacen que el autoalojamiento sea técnicamente realista. Para un desarrollador con una o dos GPUs, no es un objetivo práctico de despliegue del modelo completo. En ese caso, usar DeepSeek V4.1 Flash a través de CometAPI brinda acceso al modelo sin convertir el servicio en un gran proyecto de infraestructura.
Preguntas frecuentes
¿DeepSeek-V4.1-Flash es de código abierto?
Sus pesos y repositorio se publican bajo la licencia MIT, que permite amplio uso, modificación y redistribución sujeto a los términos de la licencia.
¿Puedo ejecutar DeepSeek-V4.1-Flash en una RTX 4090 o RTX 5090?
No el modelo completo oficial. Una sola GPU de consumo tiene solo una fracción de la memoria requerida por el checkpoint completo.
¿8B de parámetros activos significa que DeepSeek-V4.1-Flash solo necesita 8 GB de VRAM?
No. La cifra de 8B describe los parámetros que participan durante el procesamiento del prompt. La red completa de expertos y el estado de soporte aún deben almacenarse y estar accesibles.
¿Cuánta VRAM necesita DeepSeek-V4.1-Flash?
La receta actual de vLLM usa alrededor de 614 GB como cifra de planificación para el checkpoint oficial más el overhead de ejecución. Las necesidades reales varían con el hardware, el tamaño de lote, el contexto, el soporte de visión y la configuración de servicio.
¿Qué tamaño tiene DeepSeek-V4.1-Flash en disco?
El desglose actual de vLLM sitúa el checkpoint en aproximadamente 476 GiB, o alrededor de 511 GB.
¿Puede DeepSeek-V4.1-Flash ejecutar un contexto de 1M de tokens localmente?
La arquitectura admite hasta 1,048,576 tokens, pero el uso de memoria práctico también depende del tamaño de lote, buffers de runtime, estado de visión y otros overheads.
¿Puedo ejecutar DeepSeek-V4.1-Flash localmente con Ollama?
La entrada actual de Ollama usa una ruta :cloud, que no es lo mismo que ejecutar los pesos completos enteramente en tu propia máquina.
¿Es mejor vLLM o SGLang para DeepSeek-V4.1-Flash?
Ambos apuntan a servicio de alto rendimiento. vLLM actualmente tiene una receta particularmente detallada específica de V4.1, mientras que SGLang también es adecuado para despliegues distribuidos avanzados.
¿Cuál es la forma más fácil de usar DeepSeek-V4.1-Flash sin hardware local?
Usar una API alojada. DeepSeek proporciona su propia API, mientras que CometAPI ofrece un endpoint de DeepSeek-V4.1-Flash compatible con OpenAI junto a otros modelos de IA.