Construye con CometAPI¿Necesitas una sola API para varios modelos?Prueba el flujo en el Playground y luego crea una clave de API cuando el modelo y el costo encajen con tu caso de uso.
Mistral Small 4 es un modelo de IA multimodal de pesos abiertos recientemente lanzado por Mistral AI (marzo de 2026) que combina capacidades de razonamiento, programación y visión en una sola arquitectura. Puede implementarse localmente mediante frameworks como Ollama, vLLM o llama.cpp (cuantizado), y requiere GPU (se recomiendan ≥24 GB de VRAM) o CPU de gama alta con cuantización. Su principal ventaja es su alto rendimiento con un costo de inferencia y una latencia significativamente menores, lo que lo hace ideal para aplicaciones de IA en el dispositivo.
AnnaEquipo de investigación de modelos de IA y API
Mistral Small 4 es un modelo de IA multimodal recién lanzado por Mistral AI (marzo de 2026) que unifica inferencia, razonamiento, programación y capacidades multimodales en una sola arquitectura. Cuenta con una ventana de contexto de 256K, un diseño Mixture-of-Experts (MoE) (~119B de parámetros totales, ~6.5B activos por token), y ofrece una inferencia más rápida (hasta un 40% menos de latencia) mientras supera a modelos abiertos comparables como GPT-OSS 120B en benchmarks.
Para ejecutarlo localmente, necesitas o , junto con frameworks como .
Revisado para mayor claridad, atribución de fuentes y terminología API actual.
GPU con mucha memoria (se recomiendan ≥48GB de VRAM)
despliegues cuantizados
Transformers, vLLM o Ollama
¿Qué es Mistral Small 4?
Un solo modelo para múltiples tareas
Mistral Small 4 se entiende mejor como un modelo “todoterreno”: combina las fortalezas de las familias anteriores de Mistral para instrucciones, razonamiento y programación en un solo modelo. En el propio lenguaje de lanzamiento de la empresa, Small 4 es el primer modelo de Mistral que unifica las capacidades de Magistral para razonamiento, Pixtral para tareas multimodales y Devstral para programación agéntica. Acepta entradas de texto e imagen, genera texto como salida y está pensado para chat, programación, flujos de trabajo agénticos, comprensión de documentos, investigación y análisis visual.
Por qué este lanzamiento importa
La importancia práctica es que Mistral Small 4 reduce la sobrecarga de cambiar entre modelos. En lugar de enviar un prompt a un modelo rápido de instrucciones, un segundo prompt a un modelo de razonamiento y un tercero a un modelo de visión, puedes usar un único endpoint y ajustar la opción reasoning_effort según sea necesario. Mistral dice explícitamente que reasoning_effort="none" ofrece respuestas rápidas y ligeras comparables al estilo de chat de Small 3.2, mientras que reasoning_effort="high" produce un razonamiento más profundo y más detallado, similar al de sus anteriores modelos Magistral.
Benchmarks de rendimiento de Mistral Small 4
Aspectos destacados del rendimiento
Métrica
Mistral Small 4
Arquitectura
MoE
Ventana de contexto
256K
Latencia
↓ hasta un 40%
Benchmarks de código
Supera a GPT-OSS 120B
Eficiencia de salida
20% menos tokens
👉 Esto lo hace ideal para sistemas de IA de nivel de producción.
Arquitectura (clave técnica)
Tipo de modelo: Mixture-of-Experts (MoE)
Parámetros totales: ~119B
Parámetros activos por token: ~6.5B
Experts: ~128 (4 activos por forward pass)
👉 Esta arquitectura permite inteligencia de modelo grande con coste de modelo pequeño, lo que la hace ideal para despliegue local en comparación con modelos densos.
Qué requisitos de despliegue deberías prever para Mistral Small 4
Infraestructura mínima y recomendada oficial
Mistral es inusualmente explícito aquí. La infraestructura mínima es 4x NVIDIA HGX H100, 2x NVIDIA HGX H200 o 1x NVIDIA DGX B200. Su configuración recomendada para un rendimiento óptimo es 4x HGX H100, 4x HGX H200 o 2x DGX B200. Esa es una señal clara de que la ruta totalmente oficial está orientada a máquinas de clase datacenter en lugar de a una sola GPU de consumo.
Qué significa eso en la práctica
Mistral Small 4 es open-weight y eficiente para su tamaño, pero sigue siendo un sistema MoE de 119B con una ventana de contexto de 256k. En despliegues reales, esa combinación significa que la presión de memoria aumenta rápidamente a medida que crece la longitud del contexto, y el rendimiento sostenido normalmente depende del paralelismo tensorial en múltiples GPU y de software de serving eficiente. Por eso se recomienda vLLM como motor principal de autodespliegue y exponer patrones de serving compatibles con OpenAI en lugar de configuraciones por defecto de una sola máquina del tipo “simplemente funciona”.
Configuración recomendada (profesional)
Componente
Recomendación
GPU
48GB–80GB VRAM (A100 / H100)
CPU
16–32 núcleos
RAM
128GB
Almacenamiento
SSD NVMe
Por qué el hardware importa
Porque:
Modelo de 119B parámetros (incluso siendo MoE)
Contexto grande (256K tokens)
Procesamiento multimodal
👉 Sin optimización, es demasiado pesado para GPU de consumo
Cómo ejecutar Mistral Small 4 localmente (paso a paso)
Paso 1) Obtener los pesos y aceptar las condiciones de acceso
vLLM obtiene los pesos desde Hugging Face por defecto, así que necesitas un token de acceso de Hugging Face con permiso READ y debes aceptar las condiciones en la ficha del modelo. Para una configuración local práctica, prepara una máquina Linux con drivers de NVIDIA, soporte de ejecución compatible con CUDA, Python y suficiente memoria GPU para el checkpoint seleccionado. Si ya tienes los artefactos en tu propio almacenamiento, puedes omitir la configuración de Hugging Face y apuntar vLLM a la ruta local en su lugar.
Paso 2) Usar el stack de servidor recomendado oficialmente
Se recomienda el autodespliegue mediante vLLM, que se describe como un framework de serving altamente optimizado capaz de exponer una API compatible con OpenAI. Su documentación de autodespliegue también menciona TensorRT-LLM y TGI como alternativas, pero vLLM es la ruta recomendada para esta familia de modelos.
Paso 3) Descargar la imagen Docker recomendada por Mistral o instalar vLLM manualmente
Mistral Small 4 recomienda usar una imagen Docker personalizada con las correcciones necesarias para tool calling y parsing de razonamiento, o instalar manualmente una compilación parcheada de vLLM. La ficha proporciona una imagen personalizada y señala que Mistral está trabajando con el equipo de vLLM para integrar los cambios upstream.
Un punto de partida práctico es:
docker pull mistralllm/vllm-ms4:latestdocker run -it mistralllm/vllm-ms4:latest
Paso 4) Servir el modelo
El comando de servidor recomendado por Mistral es:
Ese comando es la pista práctica más importante de toda la historia local: te dice que el modelo está pensado para ejecutarse con un backend GPU serio, una ventana de contexto larga y con los parsers específicos de Mistral para herramientas y razonamiento activados.
Paso 5) Conectar tu aplicación al endpoint local
Como vLLM expone una API REST compatible con OpenAI, normalmente puedes apuntar el código existente del SDK de OpenAI a http://localhost:8000/v1 y mantener la mayor parte de la lógica de tu aplicación sin cambios. El ejemplo de Mistral usa base_url="http://localhost:8000/v1" y una clave API vacía, que es un patrón común en desarrollo local.
from openai import OpenAIclient = OpenAI(api_key="EMPTY", base_url="http://localhost:8000/v1")resp = client.chat.completions.create( model="mistralai/Mistral-Small-4-119B-2603-NVFP4", messages=[{"role": "user", "content": "Summarize the document in five bullets."}], temperature=0.7, reasoning_effort="none",)print(resp.choices[0].message.content)
Paso 6) Ajustar para velocidad o calidad
Si estás probando el modelo localmente, se sugiere reasoning_effort="high" para prompts complejos y temperature=0.7 en ese modo, mientras que temperaturas más bajas son más apropiadas cuando el razonamiento está desactivado. La misma ficha también separa el checkpoint FP8 para la mejor precisión del checkpoint NVFP4 para mayor rendimiento y menor uso de memoria, por lo que la configuración correcta depende de si estás optimizando calidad, velocidad o huella de hardware.
Paso 7: Opcional – Ejecutarlo mediante Ollama (simplificado)
ollama run mistral-small-4
👉 Ideal para:
Desarrollo local
Configuración rápida
Mistral Small 4 vs GPT-OSS vs Qwen 3.5 (comparación completa)
Mistral Small 4: MoE de eficiencia extrema
119B parámetros totales
~6.5B activos por token
128 experts (4 activos)
Multimodal (texto + imagen)
👉 Idea clave: capacidad muy grande pero bajo cómputo por token
Esto ofrece:
Alto rendimiento
Baja latencia
Menor coste por inferencia
GPT-OSS: MoE práctico para despliegue
Versión 120B: ~117B total / 5.1B activos
Versión 20B: ~21B total / 3.6B activos
Solo texto
👉 Idea clave: hacer que modelos potentes encajen en hardware mínimo
Puede ejecutarse en una sola GPU H100
Sólido uso de herramientas / soporte de salida estructurada
Qwen 3.5: escalado de alta capacidad
Hasta 122B parámetros
Mayor número de parámetros activos (~20B+)
Multimodal + fuerte capacidad multilingüe
👉 Idea clave: maximizar la capacidad incluso si aumenta el coste de cómputo
Comparación de benchmarks de rendimiento
Categoría
Mistral Small 4
GPT-OSS (120B / 20B)
Qwen 3.5 (Plus / MoE)
Entrada / salida
Entrada de texto + imagen → salida de textoContexto: 256K tokens
Entrada de texto → salida de textoContexto: ~128K tokens
Entrada de texto + imagen + video → salida de textoContexto: hasta 1M tokens
Precio (API)
$0.15 /M input$0.60 /M output
Sin precio oficial de API (self-hosted)→ coste dependiente de la infraestructura
$0.40–0.50 /M input$2.40–3.00 /M output
Arquitectura
MoE (Mixture-of-Experts)119B total / 6.5B activos128 experts (4 activos)
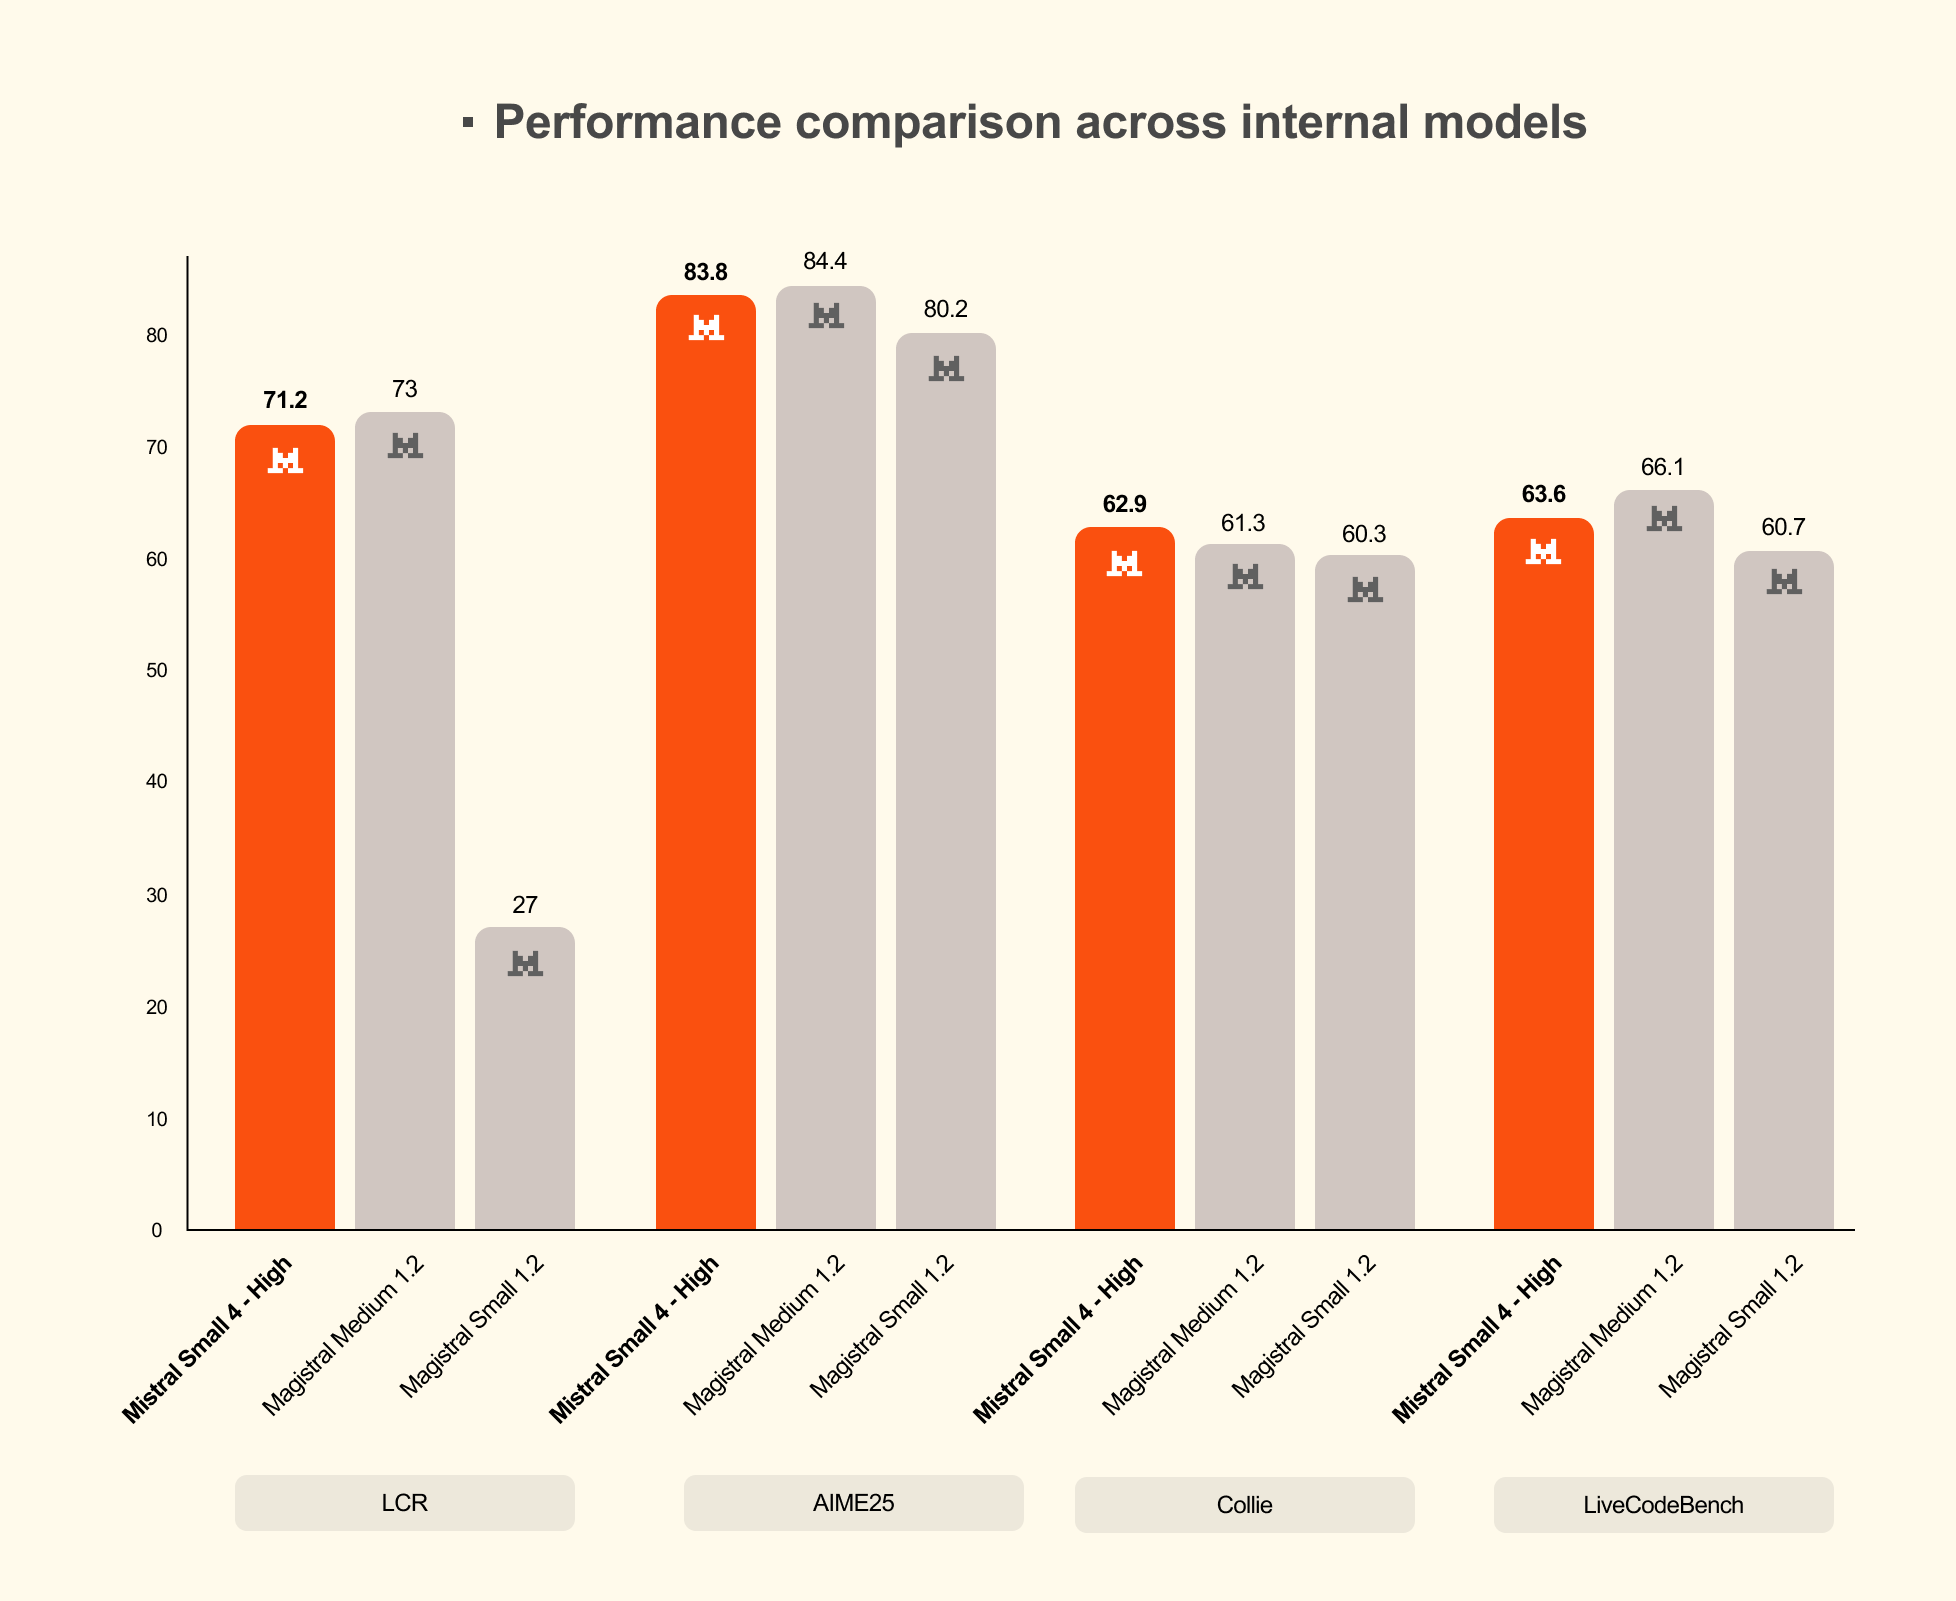
Con el razonamiento activado, Small 4 iguala o supera a GPT-OSS 120B en LCR, LiveCodeBench y AIME 2025, mientras genera salidas más cortas. Mistral cita un ejemplo en el que Small 4 obtiene 0.72 en AA LCR con solo 1.6K caracteres, mientras que resultados comparables de Qwen necesitaron 5.8K–6.1K caracteres, y afirma que Small 4 supera a GPT-OSS 120B en LiveCodeBench produciendo al mismo tiempo un 20% menos de salida.
¿Cuál es la mejor opción local?
Mi opinión: Mistral Small 4 es la mejor elección de “modelo único” si quieres un despliegue local o privado equilibrado con chat general sólido, programación, trabajo agéntico y soporte multimodal. GPT-OSS es la opción más clara si quieres un modelo abierto de OpenAI con una guía de serving local muy explícita, especialmente la versión más pequeña de 20B. Qwen3.5 es la familia más amplia, y es la que deberías mirar si lo que más te importa es la cobertura multilingüe, varios tamaños y opciones flexibles de serving local.
Si quieres acceder a estos mejores modelos open source usando APIs y no quieres cambiar de proveedor, entonces recomiendo CometAPI, ofrece GPT-oss-120B y Qwen 3.5 plus API etc.
En otras palabras, puedes consumir Small 4 como modelo alojado, o descargar los pesos y hacer self-hosting en tu propia infraestructura.
Conclusión
Small 4 encaja muy bien cuando necesitas un modelo open-weight, multimodal y capaz de razonar que pueda ser self-hosted, ajustado finamente e integrado en stacks de aplicaciones existentes al estilo OpenAI. Es especialmente atractivo para equipos que valoran el control del despliegue, la residencia de los datos y menores costes marginales por token, sin renunciar a un modelo moderno de propósito general.
¿Listo para acceder a Mistral Small 4? ¡Entonces entra en CometAPI!