Construye con CometAPI¿Necesitas una sola API para varios modelos?Prueba el flujo en el Playground y luego crea una clave de API cuando el modelo y el costo encajen con tu caso de uso.
Hy4 vs GPT-6.1 Terra: pruebas comparativas, precios de la API y qué modelo elegir
Compare Hy4 y GPT-6.1 Terra en programación, investigación, especificaciones oficiales de la API y precios de CometAPI. Encuentre el modelo adecuado para su carga de trabajo.
Deon GoodwinEquipo de investigación de modelos de IA y API
Hy4 es un punto de partida sólido para investigación financiera y generación de texto a gran escala; GPT-6.1 Terra es un punto de partida sólido para programación en terminal y depuración. Ambos aceptan texto e imágenes y admiten el uso de herramientas. Las diferencias más claras son el rendimiento por tarea, la capacidad de salida y el precio: Terra lidera la prueba de terminal que aparece abajo, mientras que Hy4 lidera las pruebas de finanzas e investigación y cuesta menos según las tarifas listadas en CometAPI.
Key Takeaways
Elija según la carga de trabajo: Hy4 para investigación y aplicaciones con mucha salida; Terra para programación en terminal y depuración.
Ambos ofrecen ventanas de contexto de aproximadamente un millón de tokens. Terra proporciona un presupuesto máximo de salida más grande.
Revisado para mayor claridad, atribución de fuentes y terminología API actual.
Terra lidera Terminal-Bench 4.0 por 10.10 puntos porcentuales; el modelo de Tencent lidera Finance Agent v2.1 por 8.74 puntos en los resultados de Vals AI.
El ejemplo de CometAPI de 10M tokens de entrada y 2M de salida cuesta $10.672 frente a $16.00 a las tarifas base mostradas.
Ajuste el endpoint, el comportamiento de herramientas y la configuración de razonamiento a su aplicación antes de cambiar de proveedor.
Especificaciones, instantáneas de benchmarks y precios verificados el 6 de noviembre de 2026.
Hy4 vs GPT-6.1 Terra: Specifications and Capabilities
Hy4 combina comprensión de texto e imagen con razonamiento y uso de herramientas, incluidos flujos de trabajo a través de interfaces de línea de comandos y gráficas. GPT-6.1 Terra admite razonamiento visual, uso del ordenador y escritura, con controles explícitos del esfuerzo de razonamiento y un mayor presupuesto de salida. La tabla siguiente compara especificaciones de Tencent y OpenAI.
Official API Specifications
Especificación
Hy4 · especificaciones oficiales de Tencent Cloud
GPT-6.1 Terra · especificaciones oficiales de OpenAI
Desarrollador
Tencent
OpenAI
ID del modelo API
hy4
gpt-6.1-terra
Entrada / salida
Texto e imágenes / texto
Texto e imágenes / texto
Ventana de contexto
1024K tokens (notación de Tencent)
1,050,000 tokens
Salida máxima
64K tokens (notación de Tencent)
128,000 tokens
Llamado a herramientas
Compatible (Function Calling)
Compatible; requiere Responses API
Salidas estructuradas
Compatible
Compatible
Aplicaciones principales
Ingeniería de software, análisis financiero y tareas de agente de larga duración
Razonamiento visual, uso de ordenador, escritura y tareas de código acotadas
Ambos modelos pueden trabajar con grandes colecciones de documentos y bases de código. Para prompts largos, reserve presupuesto también para la respuesta: Tencent indica una entrada máxima de 960K para Hy4. La pequeña diferencia en la capacidad de contexto anunciada es menos útil para la selección que la precisión con la que cada modelo usa su material.
Terra ofrece más espacio para una respuesta larga, con hasta 128,000 tokens de salida frente al límite publicado de 64K de Hy4. Esto ayuda cuando un informe o entrega de código debe caber en una sola respuesta. Los tokens de razonamiento también consumen el presupuesto de salida de Terra.
Reasoning Controls
Terra ofrece seis configuraciones de esfuerzo de razonamiento: none, low, medium, high, xhigh y max, con medium como predeterminada. Esto da a las aplicaciones una forma explícita de ajustar el esfuerzo de inferencia según la tarea. Una solicitud de clasificación y una tarea de depuración difícil no necesitan usar el mismo presupuesto.
El lanzamiento de Tencent describe razonamiento combinado con percepción visual y uso de herramientas, pero no define un control equivalente de seis niveles en ese anuncio. Trate los parámetros de razonamiento como específicos de cada endpoint: no copie el ajuste de esfuerzo de un proveedor en otra solicitud y suponga que tiene el mismo significado.
Hy4 vs GPT-6.1 Terra: Performance
Vals AI proporciona resultados directos para ambos modelos en tareas de código, finanzas, investigación legal e impuestos. Estas puntuaciones muestran dónde cada modelo es un candidato útil para su carga de trabajo.
Independent Benchmark Results and Test Conditions
Los siguientes resultados de Vals Index v2.2 se verificaron el 10 de noviembre de 2026. Puntuaciones más altas son mejores.
Benchmark o métrica
Hy4: resultados de Vals AI
GPT-6.1 Terra: resultados de Vals AI
Interpretación
Vals Index
59.35% ± 1.08
60.54% ± 0.99
Terra +1.19 puntos porcentuales
Terminal-Bench 4.0
39.39%
49.49%
Terra +10.10 puntos
Vibe Code Bench v1.1
81.01%
84.00%
Terra +2.99 puntos
Finance Agent v2.1
64.70%
55.96%
Modelo de Tencent +8.74 puntos
Legal Research Bench
41.35%
25.96%
Modelo de Tencent +15.39 puntos
Tax Agent Bench
34.40%
17.08%
Modelo de Tencent +17.32 puntos
Vals AI lista temperature 0.9, top_p 1.0 y un límite de salida de 65,536 tokens para Hy4; Terra usa esfuerzo de razonamiento máximo y un límite de salida de 128,000 tokens. Estas configuraciones difieren, así que lea los resultados como comparaciones de las configuraciones probadas en lugar de ejecuciones con presupuestos iguales.
La ventaja de Terra es mayor en tareas de terminal que en generación de código: 10.10 puntos porcentuales en Terminal-Bench 4.0 frente a 2.99 puntos en Vibe Code Bench. Eso hace que la depuración y el desarrollo en línea de comandos sean los lugares más claros para comenzar a evaluar Terra.
Hy4 lidera Finance Agent, Legal Research Bench y Tax Agent Bench por 8.74, 15.39 y 17.32 puntos porcentuales. Por lo tanto, los flujos de investigación que recopilan evidencia y aplican reglas de dominio son puntos de partida prometedores para Hy4.
La brecha general es de 1.19 puntos porcentuales, y los intervalos de incertidumbre publicados se superponen.
Tencent’s Hy4 Launch Benchmarks
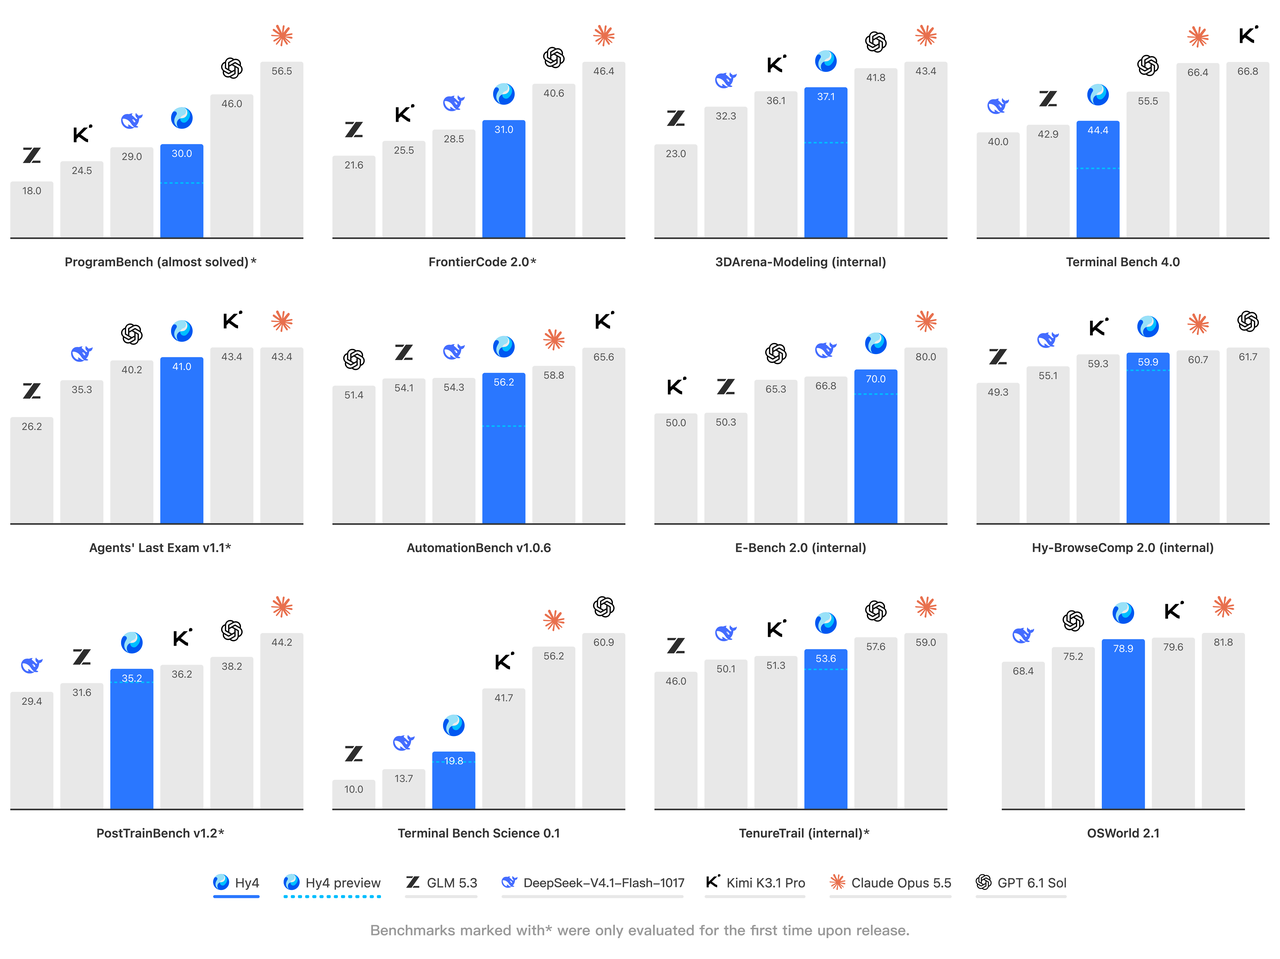
El gráfico de lanzamiento de Tencent agrega resultados para programación y uso de ordenador. Compara Hy4 con GPT-6.1 Sol; use la tabla de Vals AI anterior para la comparación directa con GPT-6.1 Terra.
Resultados de benchmarks de Hy4 reportados por Tencent, noviembre de 2026. El modelo de OpenAI mostrado es GPT-6.1 Sol.
En el gráfico de lanzamiento de Tencent, Hy4 obtiene 44.4 en Terminal Bench 4.0 y 78.9 en OSWorld 2.1. Estas cifras describen la configuración de evaluación de Tencent y son independientes de las puntuaciones de Vals AI anteriores.
Vision and Computer-Use Workflows
Tencent introduce la comprensión de imágenes en la versión oficial y describe entrenamiento para flujos de trabajo que abarcan herramientas de línea de comandos, interfaces gráficas, Blender y CAD. Esto hace que el análisis de gráficos y las tareas visuales de software sean centrales en su posicionamiento.
OpenAI posiciona su modelo para flujos basados en pantalla, escritura concisa y correcciones de código acotadas. Para una aplicación de catálogo, pruebe la coincidencia de fotos de producto; para trabajo técnico, use dibujos con etiquetas y medidas pequeñas; para automatización de escritorio, verifique los archivos guardados y el estado de la aplicación.
Un buen conjunto de pruebas visuales debe separar lectura de acción. Primero mida si el modelo extrae los valores correctos o identifica el elemento de interfaz adecuado. Luego mida si el flujo completo alcanza el resultado requerido sin clics incorrectos, archivos faltantes o intervención humana innecesaria.
Speed and End-to-End Latency
Para chat, las medidas de velocidad relevantes son cuán pronto comienza la respuesta y cuánto tarda en finalizar. Para agentes, mida la tarea completa, incluida la ejecución de herramientas y cualquier reparación.
Compare ambos modelos en tareas típicas y exigentes a la concurrencia que espera. Rastree la latencia mediana y de cola junto con la finalización exitosa: una respuesta rápida solo es útil si hace el trabajo.
Hy4 vs GPT-6.1 Terra: Cost
Compare primero las tarifas por token y luego tenga en cuenta el trabajo necesario para obtener un resultado utilizable. Los precios a continuación son tarifas base de CometAPI en dólares estadounidenses por millón de tokens; son independientes de las cifras de costo por prueba que informa Vals AI.
CometAPI Input and Output Pricing
Concepto de costo
API de Hy4 en CometAPI
API de GPT-6.1 Terra en CometAPI
Entrada por millón de tokens
$0.6672
$0.80
Salida por millón de tokens
$2.00
$4.00
La siguiente tabla usa las tarifas base listadas por CometAPI en dólares estadounidenses por millón de tokens. Compare entrada y salida por separado y luego calcule el costo de su solicitud típica.
Example Cost for 10,000 Requests
Considere 10,000 solicitudes, cada una usando 1,000 tokens de entrada sin caché y 200 tokens facturables de salida. En todas las solicitudes, eso son 10 millones de tokens de entrada y 2 millones de tokens de salida. Usando los precios base de CometAPI anteriores:
Hy4 cuesta aproximadamente un 33.3% menos en este ejemplo. Esta estimación cubre entrada sin caché y salida facturable; agregue cargos por caché, herramientas y reintentos al presupuestar un flujo completo.
Direct-Provider Billing and Long-Context Requests
Para documentos largos en la API directa de OpenAI, prompts por encima de 272K tokens de entrada activan tarifas de entrada y caché de 2× y tarifas de salida de 1.5× para la solicitud completa. Aplique las reglas de facturación del servicio que use; el ejemplo de CometAPI anterior usa tarifas base de CometAPI. Detalles de precios de OpenAI.
Cost per Accepted Task
Una tarea aceptada es aquella que cumple los controles de calidad y finalización de su aplicación. Cuente todos los intentos, uso de herramientas y trabajo de revisión necesarios para alcanzar ese resultado, incluido el gasto en intentos fallidos.
Costo por tarea aceptada = costos totales de modelo, reintentos, herramientas y revisión humana ÷ tareas que pasan los controles de aceptación.
Una llamada más costosa aún puede ser económica si evita varios intentos de reparación. Por el contrario, cuando un modelo de menor costo cumple el umbral de calidad, pagar una tarifa más alta por cada tarea puede aportar poco valor.
Which Model Should You Choose: Hy4 or GPT-6.1 Terra?
Comience con el modelo cuyos puntos fuertes coinciden con su carga de trabajo principal. Use las siguientes opciones para crear una lista corta y luego compare la calidad y el costo de las tareas completadas.
When to Choose Hy4
Elija primero Hy4 para investigación financiera, análisis de documentos legales o fiscales y aplicaciones que generan mucho texto. Sus ventajas en los tres benchmarks de dominio lo convierten en un candidato útil para investigación basada en evidencias. A las tarifas listadas de CometAPI, su precio de salida es la mitad del de Terra, lo que puede marcar una diferencia material en redacción e informes de alto volumen.
Para trabajo de investigación, evalúe la respuesta final por precisión de fuentes, cálculos y cobertura de la pregunta. Hy4 es la mejor opción cuando cumple esos requisitos a un costo total menor, incluidos revisión y reintentos.
When to Choose GPT-6.1 Terra
Elija primero GPT-6.1 Terra para programación en terminal, depuración y correcciones de código. Su ventaja de 10.10 puntos en Terminal-Bench es la señal de código más sólida en esta comparación. El mayor presupuesto de salida también lo hace digno de prueba para informes largos y respuestas de código sustanciales.
Evalúe a Terra por si sus parches pasan sus pruebas y sus entregables están completos. Para trabajo visual o de escritorio, compare ambos modelos en sus pantallas, gráficos y archivos reales, verificando el resultado final guardado.
Routing Research and Coding to Different Models
Una carga mixta puede beneficiarse de usar ambos modelos. Un asistente de análisis financiero podría usar Hy4 para investigación y redacción de informes, y luego llamar a Terra cuando un script de análisis necesite depuración:
Envíe la recopilación de evidencias y la redacción del informe a Hy4.
Verifique citas, valores de fuente y cálculos antes de aceptar el informe.
Envíe a Terra un script de análisis que falle, junto con el código, la salida de error y el comportamiento esperado.
Ejecute el script corregido y aplique las mismas verificaciones de evidencias antes de devolver el resultado final.
Use un segundo modelo cuando mejore el resultado final lo suficiente como para cubrir el costo adicional y el trabajo de integración.
Where Can You Access Hy4 and GPT-6.1 Terra?
Official Provider Access
Acceda a Hy4 a través de Tencent Cloud TokenHub y a GPT-6.1 Terra a través de la API de OpenAI. Use la documentación del proveedor para autenticación, IDs de modelo y facturación.
CometAPI Access and Tool Compatibility
CometAPI ofrece ambos modelos bajo los IDs hy4 y gpt-6.1-terra. Sus páginas de modelo listan ejemplos de solicitud y precios para cada ruta: Hy4 y GPT-6.1 Terra.
Para aplicaciones con herramientas habilitadas, verifique la compatibilidad de la ruta seleccionada con llamadas a funciones y salidas estructuradas. En la API directa de OpenAI, el llamado a herramientas de Terra requiere la Responses API.
How to Test and Roll Out Your Choice
Antes de cambiar el tráfico de producción, compare los modelos en tareas representativas usando las mismas entradas, herramientas y criterios de aprobación. Registre finalizaciones exitosas, costo total y tiempo transcurrido, y luego despliegue gradualmente la ruta más sólida.
Incluya solicitudes rutinarias y casos difíciles que importen a sus usuarios.
Verifique argumentos de herramientas, salidas estructuradas, errores y estado de finalización.
Establezca límites de reintentos y activadores de reversión antes de enviar tráfico real.
Conclusion
Elija Hy4 cuando la calidad de investigación y menores costos de generación de texto sean sus prioridades. Elija GPT-6.1 Terra cuando la programación en terminal, la depuración y un mayor presupuesto de salida importen más.
Para una aplicación mixta, comience con un modelo por carga principal y agregue una segunda ruta donde mejore los resultados. La mejor elección es la que completa sus tareas con precisión a un costo que pueda sostener.