Construye con CometAPI¿Necesitas una sola API para varios modelos?Prueba el flujo en el Playground y luego crea una clave de API cuando el modelo y el costo encajen con tu caso de uso.
Cómo desplegar Kimi K3.1 Pro de forma local: requisitos de hardware, configuración de vLLM - CometAPI
Cómo desplegar Kimi K3.1 Pro de forma local: requisitos de hardware, configuración de vLLM
Aprende a autoalojar Kimi K3.1 Pro con vLLM, a comprobar los requisitos de GPU, a descargar los pesos, a probar la inferencia y a comparar el despliegue local con el acceso a la API.
Deon GoodwinEquipo de investigación de modelos de IA y API
Implementa Kimi K3.1 Pro en un servidor Linux con GPU y conecta una aplicación local a su endpoint de inferencia. Este recorrido usa un nodo NVIDIA B300 con ocho GPU y vLLM. Necesitarás acceso por shell al servidor, controladores compatibles y almacenamiento para el checkpoint completo. Empieza completando una solicitud de texto corta antes de probar entradas más largas o flujos de agentes.
Sin GPUs adecuadas, puedes ejecutar tu aplicación localmente y conectarla a la API oficial de Kimi o a un proveedor de terceros como CometAPI.
Puntos clave
Los 104B parámetros activos del modelo no representan su requisito total de almacenamiento.
La compatibilidad de hardware incluye memoria de GPU, interconexiones, soporte de cuantización y kernels de inferencia.
Revisado para mayor claridad, atribución de fuentes y terminología API actual.
Buenos resultados en benchmarks justifican la prueba del modelo, pero no garantizan el rendimiento equivalente en tu aplicación.
Un endpoint de inferencia operativo no incluye automáticamente un navegador, sandbox de código o un runtime de agente completo.
Compara autohospedaje y acceso por API por costo por tarea exitosa, incluyendo reintentos y mantenimiento.
¿Qué es Kimi K3.1 Pro?
Kimi K3.1 Pro es el modelo multimodal de pesos abiertos de Moonshot AI para programación, análisis de documentos y uso de herramientas. Sus principales especificaciones se listan a continuación, según la ficha oficial del modelo .
Especificación
Configuración publicada
Arquitectura
MoE; 2.8T parámetros totales, 104B activos
Atención
93 capas: 69 KDA + 24 Gated DSA
Expertos
896 enrutados; 16 seleccionados por token; 2 compartidos
Contexto
1,048,576 tokens
Entradas
Texto e imágenes; codificador de visión MoonViT-V2
Cuantización
Pesos MXFP4 / activaciones MXFP8; checkpoint de precisión mixta
Motores recomendados
vLLM, SGLang, TokenSpeed
El modelo activa 104B parámetros por token, pero el despliegue sigue requiriendo el checkpoint completo de 2.8T parámetros. El motor de inferencia también debe soportar sus capas KDA y Gated DSA y la cuantización MXFP4.
¿Qué hardware necesitas para ejecutar Kimi K3.1 Pro localmente?
La tabla siguiente resume las configuraciones de vLLM relevantes para esta guía. El recorrido usa un nodo B300 con ocho GPU; despliegues en GB300 y AMD requieren sus configuraciones correspondientes.
Hardware
Ruta documentada
Notas de planificación
NVIDIA B300
Un nodo de ocho GPU, TP8
Línea base para el recorrido a continuación
NVIDIA GB300
Ocho GPU en dos bandejas, TP8
Requiere la configuración multinodo y la preparación del interconector
AMD MI355X
Nodo de ocho GPU con configuración específica de AMD
Usa la ruta ROCm/AITER; no reutilices la configuración del entorno de NVIDIA
Una sola GPU de consumo de 24–32 GB
Insuficiente para cargar directamente el checkpoint completo
No es un objetivo práctico para este tutorial
Solo como escala, 2.8T parámetros ocuparían aproximadamente 5.6 TB en BF16, 2.8 TB a ocho bits o 1.4 TB a cuatro bits idealizados. Estos son cálculos de almacenamiento bruto de parámetros, no tamaños reales de checkpoint ni mínimos de VRAM en tiempo de ejecución. La precisión mixta y los metadatos cambian el tamaño del archivo; la caché y las asignaciones en tiempo de ejecución aumentan el requisito de servicio.
Reserva capacidad NVMe para la descarga completa, archivos temporales y una copia de reversión. En sistemas multinodo, valida la comunicación antes de cargar el modelo.
Cómo implementar Kimi K3.1 Pro
Usa autohospedaje si tienes hardware adecuado; de lo contrario, comienza con una API alojada. Los pasos siguientes usan vLLM, con SGLang como alternativa al final de esta sección. Compara costos de hosting después de tener una solicitud funcionando.
Ejecuta los comandos de preparación, descarga, lanzamiento y verificación inicial en un shell Bash en el servidor con GPU. Si trabajas desde un portátil, conéctate a ese servidor con SSH primero. El cliente de Python puede ejecutarse luego en cualquiera de las máquinas usando las instrucciones de conexión a continuación.
Este recorrido sigue la receta oficial de despliegue; no ha sido probado de forma independiente para este artículo.
1. Verifica la visibilidad de la GPU, el almacenamiento y la conectividad
Comienza con comprobaciones básicas de infraestructura:
nvidia-smi
nvidia-smi topo -m
df -h
Confirma que todas las GPU objetivo son visibles y que el directorio del modelo tiene espacio suficiente. Presupuesta almacenamiento adicional para cachés de descarga, logs y futuras versiones del checkpoint.
Para despliegues multinodo, verifica la comunicación entre nodos antes de intentar el inicio del modelo.
Mantén estrecho el primer hito: carga el checkpoint y completa una solicitud de texto corta. Esto facilita el diagnóstico de fallas.
2. Prepara el entorno de servicio
Usa un host Linux con ocho GPU B300 para este ejemplo de nodo único. En un entorno CUDA compatible con la receta publicada, crea un entorno aislado e instala las herramientas de servicio:
El mínimo de versión no garantiza compatibilidad con todos los controladores o wheels. Si la receta de hardware requiere un contenedor o build dedicado, usa ese entorno en su lugar. Fija la versión que pase tus pruebas antes de producción.
3. Descarga el checkpoint completo
Instala la CLI de Hugging Face y descarga el repositorio del modelo:
Conserva la configuración, archivos de tokenizador y procesador, y el índice de pesos junto con los fragmentos de pesos. Copiar solo archivos de tensores seleccionados puede dejar el despliegue incompleto.
Para despliegues reproducibles en producción, registra y fija la revisión del repositorio que validaste. Revisa la licencia personalizada del repositorio antes del uso comercial.
Tras preparar el entorno, usa el siguiente comando base. Inicia paralelismo de tensores a ocho vías y limita la ventana de contexto inicial a 32,768 tokens:
El nombre kimi-local es un alias de cara a la aplicación. Usa el mismo nombre en solicitudes posteriores.
La configuración de 32,768 tokens es un punto de partida conservador para este recorrido, no el máximo de contexto soportado por el modelo.
La opción --trust-remote-code permite cargar código personalizado del repositorio. Empareja esto con una revisión de checkpoint auditada y fijada.
Aquí, 127.0.0.1 se refiere a la máquina que ejecuta el cliente. Las comprobaciones con curl a continuación se ejecutan en el servidor con GPU, donde alcanzan su proceso de inferencia. Para usar el cliente de Python desde tu portátil, abre un túnel SSH en una terminal separada del portátil y mantenlo activo:
ssh -N -L 8000:127.0.0.1:8000 user@gpu-server
Sustituye user@gpu-server por tu usuario de SSH y la dirección del servidor. Con este túnel abierto, el cliente del portátil puede usar http://127.0.0.1:8000/v1. Si el puerto 8000 ya está ocupado en el portátil, elige otro puerto local y actualiza la URL del cliente.
Un finish_reason que indique si la generación se completó o alcanzó su límite.
Errores de memoria de GPU u operaciones no soportadas.
El razonamiento puede consumir parte del presupuesto de generación. Si la solicitud alcanza su límite antes de producir una respuesta final, incrementa el presupuesto y reintenta antes de concluir que el servidor está roto.
6. Conecta una aplicación local de Python
python -m pip install openai
from openai import OpenAI

client = OpenAI(
    base_url="http://127.0.0.1:8000/v1",
    api_key="EMPTY",
    timeout=300.0,
    max_retries=1,
)
response = client.chat.completions.create(
    model="kimi-local",
    messages=[{"role": "user", "content": "Write a Python function that removes duplicate filenames while preserving order."}],
    reasoning_effort="low",
    max_tokens=2048,
)
print(response.choices[0].message.content)
print(response.choices[0].finish_reason)
EMPTY es un marcador de posición para este servidor de bucle local sin autenticación por API key. Usa tu credencial configurada para un endpoint autenticado. Valida la entrada de imagen y la ejecución de herramientas por separado antes de conectar un agente.
Alternativa con SGLang
Para SGLang, usa el cookbook oficial específico de hardware. Selecciona B300, Unified y Low-Latency (TP8) para el ajuste más cercano a este recorrido de nodo único. Revisa el estado de verificación mostrado; una configuración generada no es necesariamente una configuración probada.
En el servidor con GPU, instala Docker y configura NVIDIA Container Toolkit, luego crea un contenedor con el checkpoint descargado montado en /models/Kimi-K3.1-Pro. Detén vLLM primero para que ambos motores no compitan por las mismas GPU.
Dentro del contenedor, pega el comando de lanzamiento completo producido por el cookbook para tu configuración seleccionada. Reemplaza su ruta del modelo por /models/Kimi-K3.1-Pro, establece el host del servicio en 0.0.0.0 y el puerto en 30000, y conserva las flags específicas de hardware. El contenedor debe escuchar en su interfaz de red para que el reenvío de puertos de Docker funcione; el puerto del lado del host arriba permanece ligado a loopback. Espera el mensaje de servicio listo antes de probar.
En una segunda shell en el servidor con GPU, lista el modelo servido y luego envía una solicitud usando el ID de modelo exacto devuelto:
curl http://127.0.0.1:30000/v1/models

MODEL_ID="replace-with-id-from-models-response"
curl http://127.0.0.1:30000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d "{\"model\":\"$MODEL_ID\",\"messages\":[{\"role\":\"user\",\"content\":\"Explain database indexes in three sentences.\"}],\"reasoning_effort\":\"low\",\"max_tokens\":2048}"
Una respuesta correcta debe contener una respuesta final. Si el inicio falla, inspecciona los logs del contenedor y confirma que la receta de hardware e imagen seleccionadas coinciden. Para acceso desde el portátil, usa el mismo patrón de túnel SSH con el puerto 30000. Consulta la guía de instalación de Docker para SGLang para los prerrequisitos del contenedor.
¿Cómo rinde Kimi K3.1 Pro en benchmarks?
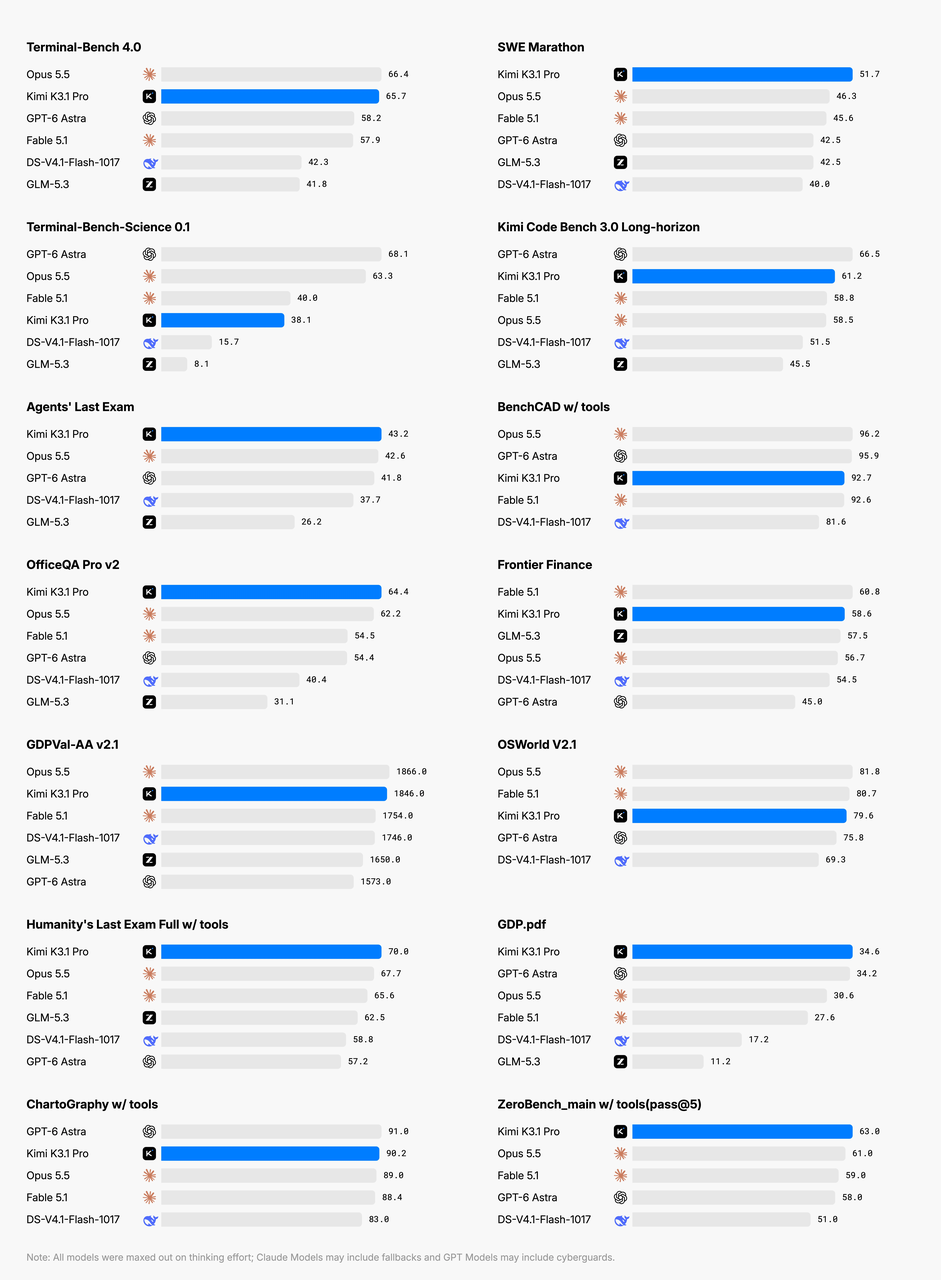
Usa los resultados de evaluación oficiales a continuación para elegir tareas para tu prueba de despliegue. Estas puntuaciones describen la configuración de evaluación publicada; no miden el servidor local configurado en esta guía.
La siguiente tabla muestra resultados seleccionados y sus posiciones dentro del conjunto de comparación publicado en la ficha del modelo.
Benchmark y resultados oficiales
Puntuación del modelo
Posición dentro de esa comparación
Terminal-Bench 4.0
65.7
Segundo
SWE Marathon v1.1
51.7
Primero
Program Bench
31.5
Cuarto
OfficeQA Pro v2
64.4
Primero entre los resultados reportados
Frontier Finance
58.6
Segundo
Los resultados respaldan probar el modelo para tareas de ingeniería extendidas y flujos de trabajo con documentos. Kimi K3.1 Pro lidera esta comparación en SWE Marathon pero ocupa el cuarto lugar en ProgramBench, lo que hace que ambos sean candidatos útiles para pruebas específicas de aplicación.
Estas posiciones se calculan dentro de la tabla de comparación oficial, no de un ranking global en vivo. Los arneses de evaluación, herramientas, presupuestos de razonamiento y selección de muestras difieren entre benchmarks.
Para una decisión de despliegue, construye un pequeño conjunto de evaluación basado en trabajo real: correcciones de repositorio, preguntas entre documentos y tareas de herramientas en múltiples pasos. Mide calidad de finalización, correcciones humanas y tiempo transcurrido. Las puntuaciones publicadas son útiles para preseleccionar; las pruebas de aplicación determinan si el despliegue vale la pena.
¿Cómo puedes optimizar la inferencia local de Kimi K3.1 Pro?
Controla el contexto y la concurrencia
Una vez que funcionen las solicitudes cortas, prueba documentos más largos, imágenes, conversaciones multi-turno y llamadas a herramientas por separado.
Registra la latencia del primer token, tokens de salida por segundo y pico de memoria de GPU a tu longitud de contexto y concurrencia previstas. También registra el éxito de la tarea y el costo por tarea exitosa, para que una salida más rápida no oculte más reintentos o correcciones humanas.
Cambia una variable importante a la vez. Aumentar simultáneamente la longitud de contexto, la concurrencia y los ajustes de optimización dificulta explicar regresiones de rendimiento.
Elige deliberadamente el esfuerzo de razonamiento y la configuración de caché
Usa esfuerzo de razonamiento bajo, alto o máximo según la tarea. Comienza con bajo para comprobaciones de interfaz, luego compara alto y máximo en tareas difíciles usando tanto la calidad de la completion como el tiempo transcurrido. Un trazo de razonamiento más largo no es en sí evidencia de un mejor resultado.
Para sesiones largas, evalúa la capacidad de caché y la reutilización de prefijos antes de añadir decodificación especulativa o más concurrencia. Mantén una base conocida y cambia un ajuste cada vez.
¿Por qué pueden fallar las llamadas a herramientas de Kimi K3.1 Pro tras la implementación?
Tu aplicación ejecuta llamadas a herramientas, devuelve sus resultados y continúa la conversación. Conserva el mensaje completo del asistente —incluidos reasoning_content y tool_calls— y devuelve cada resultado de herramienta con su tool_call_id correspondiente.
El manejo multi-turno también importa. La guía de uso del modelo requiere conservar el mensaje completo del asistente, incluyendo los campos de razonamiento y de llamada a herramientas, en lugar de retener solo el texto final.
Síntoma
Primeras comprobaciones
Arquitectura de modelo no reconocida
Versión de runtime, código personalizado y configuración
Falta de memoria al cargar
Capacidad de GPU, paralelismo y procesos en competencia
Las solicitudes cortas funcionan, pero las largas fallan
Límite de contexto, capacidad de caché y concurrencia
No se pueden parsear las llamadas a herramientas
Ajustes del parser y esquema de la herramienta
El agente se detiene tras solicitar una herramienta
Ejecución de la aplicación y manejo del resultado de la herramienta
Las respuestas multi-turno se vuelven inconsistentes
Falta de campos del mensaje del asistente
Usa una solicitud mínima reproducible para aislar cada falla. Una vez que funcione, reintroduce los ajustes adicionales de la aplicación uno a uno.
¿Deberías autoalojar o usar una API alojada?
Elige autohospedaje cuando necesites control sobre los pesos, la infraestructura o la ubicación de los datos y puedas mantener las GPU ocupadas de forma útil. Para evaluación inicial o demanda variable, compara la API oficial de Kimi y CometAPI usando los mismos prompts y criterios de aceptación. Confirma el acceso al modelo, parámetros soportados, cuotas y condiciones de manejo de datos de cada servicio.
Costo o factor operativo
Autohospedado
API oficial de Kimi / CometAPI
Costo de capacidad
Compra o alquiler de GPU, incluido el tiempo inactivo
Uso de API facturado; consulta las tarifas vigentes de cada proveedor
Almacenamiento y redes
Almacenamiento del checkpoint, caché y cargos de red
Cualquier almacenamiento y cargos de red del lado de la aplicación
Operaciones
Implementación, monitorización, actualizaciones y recuperación
Integración, gestión de cuotas y monitorización de solicitudes
Reintentos
Incluye su tiempo de GPU en los costos de cómputo
Incluye sus tokens o llamadas en los cargos de API
Revisión humana
Cuenta el tiempo de corrección usando la misma tarifa
Cuenta el tiempo de corrección usando la misma tarifa
Mejor ajuste
Demanda estable y control de la infraestructura
Evaluación y demanda variable
Una comparación útil es:
Costo por tarea exitosa = (cómputo en GPU o cargos de API + almacenamiento y redes + operaciones + corrección humana) / tareas completadas con éxito.
Usa costos y conteos de tareas exitosas del mismo período de medición. Incluye intentos fallidos y reintentos en el total de cómputo o API una sola vez; no añadas un segundo cargo por reintento. Para un flujo híbrido, incluye tanto cómputo como cargos de API. Cuenta tareas completadas únicas, no intentos de solicitud.
Un servidor infrautilizado puede seguir siendo caro incluso cuando su rendimiento teórico es excelente. Por el contrario, un equipo con infraestructura existente, demanda estable y requisitos estrictos de datos puede obtener un valor sustancial del autohospedaje.
Usa prompts y criterios de aceptación idénticos al comparar rutas de despliegue. Incluye la latencia de extremo a extremo y la calidad de la salida en la decisión.
Prueba el endpoint alojado sin cargar pesos
El inicio rápido de la API oficial de Kimi usa el endpoint siguiente. Define MOONSHOT_API_KEY en tu entorno y confirma el acceso al modelo en tu cuenta. Esta solicitud se ejecuta en la infraestructura del proveedor.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["MOONSHOT_API_KEY"],
    base_url="https://api.moonshot.ai/v1",
)
response = client.chat.completions.create(
    model="kimi-k3.1-pro",
    messages=[{"role": "user", "content": "Explain database indexes in three sentences."}],
    reasoning_effort="low",
    max_completion_tokens=2048,
)
print(response.choices[0].message.content)
Para la API de Kimi K3.1 Pro en CometAPI, define COMETAPI_API_KEY en tu entorno y confirma que tu cuenta tiene acceso al modelo solicitado. La solicitud se ejecuta de forma remota:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_API_KEY"],
    base_url="https://api.cometapi.com/v1",
)
response = client.chat.completions.create(
    model="kimi-k3.1-pro",
    messages=[{"role": "user", "content": "Explain database indexes in three sentences."}],
    max_tokens=2048,
)
print(response.choices[0].message.content)
Compara el resultado con tu endpoint local usando los mismos criterios de aceptación. Revisa el precio actual de la ruta y los parámetros soportados antes de estimar costos de producción.
Conclusión
Autohospedar Kimi K3.1 Pro es viable con una configuración de GPU soportada y el entorno de inferencia correspondiente. Usa los pasos de despliegue anteriores para establecer un endpoint operativo y luego mide calidad de tareas, latencia y costo en tu propia carga de trabajo. Elige una API alojada si aún estás validando la aplicación o no tienes hardware adecuado.
Preguntas frecuentes
¿Puede un portátil convencional ejecutar el modelo completo?
Un portátil convencional no es un objetivo práctico para los requisitos de capacidad del checkpoint original. Puede actuar como cliente conectado a tu propio servidor de inferencia o a una API alojada.
¿Instalar la aplicación de escritorio cuenta como implementación local?
La ubicación de instalación de la aplicación no establece dónde ocurre la inferencia. El autohospedaje requiere que los pesos del modelo y el proceso de inferencia se ejecuten en infraestructura que controles.
¿Por qué el modelo necesita tanta memoria si solo 104B parámetros están activos?
Distintos tokens pueden seleccionar distintos expertos. Los parámetros activos describen la participación en el cómputo; el despliegue aún necesita almacenar y acceder al conjunto completo de pesos.
¿Puedo habilitar de inmediato el contexto completo de un millón de tokens?
Incrementa la longitud de contexto gradualmente y mide el uso de memoria de GPU a tu concurrencia objetivo. El modelo soporta 1,048,576 tokens, pero la capacidad útil de servicio depende de tu caché y ajustes de paralelismo.
¿La implementación local reproducirá las puntuaciones de benchmark publicadas?
No automáticamente. La cuantización, presupuestos de razonamiento, herramientas, prompts y marcos de evaluación pueden afectar los resultados. Valida la configuración con tus propias tareas.
¿Debería probar a través de una API antes de comprar hardware?
Si no has establecido que el modelo cumple tus requisitos de calidad, probar vía API proporciona una línea base inicial con menos trabajo de infraestructura. Los equipos con hardware adecuado y requisitos claros de residencia de datos pueden proceder directamente a una evaluación controlada de autohospedaje.