
TL;DR
Kimi K3.1 Pro es la actualización del 24 de octubre de 2026 de Moonshot AI para Kimi K3. El posentrenamiento adicional mejora la programación autónoma, la investigación financiera y los flujos de trabajo extendidos con herramientas, manteniendo la misma capacidad de contexto de aproximadamente un millón de tokens.
Las evaluaciones independientes muestran un rendimiento general más sólido, y las tarifas oficiales estándar de tokens de entrada/salida bajan en un tercio. La actualización aún requiere pruebas de carga: un razonamiento más profundo puede aumentar la latencia de las tareas y el gasto total, mientras que K3 mantiene una ligera ventaja en AA-LCR y los pesos disponibles actualmente para self-hosting.
Conclusiones clave
- Las mejoras más claras están en la ejecución agentica. Artificial Analysis informa puntuaciones de Terminal-Bench 4.0 de aproximadamente 67% para K3.1 Pro frente a 13% para K3; los puntajes internos de Moonshot en Financial Research suben de 58.8 a 70.4.
- Los precios de tokens más bajos no garantizan menores costos por tarea. Las tarifas estándar oficiales de entrada/salida bajan de $3/$15 a $2/$10 por millón de tokens, pero el razonamiento adicional, las llamadas a herramientas y los reintentos pueden compensar el ahorro.
- La ventana de contexto se mantiene igual. Ambos modelos admiten hasta 1,048,576 tokens. K3 sigue ligeramente por delante en la evaluación AA-LCR v1.1 citada, así que prueba la precisión en contextos largos con tus propios documentos.
- La disponibilidad de pesos puede determinar la elección. A 24 de octubre de 2026, los pesos de K3 están disponibles; los de K3.1 Pro están programados para publicarse antes del 4 de noviembre. Los equipos que necesiten self-hosting inmediato deberían tener en cuenta esta diferencia.
Kimi K3.1 Pro vs Kimi K3: resumen y especificaciones
Kimi K3.1 Pro se basa en K3 mediante posentrenamiento adicional, con mejoras centradas en programación, investigación financiera y flujos de trabajo agenticos extendidos. Ambos conservan aproximadamente un millón de tokens de contexto. Las principales diferencias radican en el rendimiento por tarea, los precios de tokens, las opciones de servicio y la disponibilidad de pesos.
| Especificación | Kimi K3.1 Pro | Kimi K3 |
|---|---|---|
| Desarrollador | Moonshot AI | Moonshot AI |
| Fecha de lanzamiento | October 24, 2026 | July 16, 2026 |
| Arquitectura | MoE derivado de K3, posentrenado más | MoE con KDA, AttnRes |
| Tamaño del modelo | clase 3T y 104B parámetros activos | 2.8T total y 104B parámetros activos |
| Ventana de contexto | Hasta 1,048,576 tokens | Hasta 1,048,576 tokens |
| Precio estándar API entrada/salida | $2 / $10 por millón de tokens | $3 / $15 por millón de tokens |
| Versión Highspeed | Disponible | No hay variante K3 Highspeed separada |
| Disponibilidad de pesos | Publicación prevista para Nov 4, 2026 | Disponible bajo la Licencia Kimi K3 |
La disponibilidad de pesos refleja la información disponible al 24 de octubre de 2026. Los precios de la API están en USD para entrada y salida regulares, excluyendo cargos por escritura en caché, impuestos y otras tarifas aplicables.
Arquitectura y posentrenamiento
K3 introdujo una arquitectura de 2.8 billones de parámetros que combina Kimi Delta Attention, Attention Residuals y Stable LatentMoE. Activa aproximadamente 104 mil millones de parámetros por token.
Moonshot describe K3.1 Pro como una versión posentrenada de K3 desarrollada con un cómputo de posentrenamiento sustancialmente mayor. La actualización se centra en aplicar las capacidades del modelo en tareas de múltiples pasos, incluyendo uso de herramientas, depuración y verificación de resultados. El anuncio no introduce una arquitectura base con nombre separado.
Capacidades compartidas y requisitos de API
Ambos modelos admiten entradas multimodales, llamadas a herramientas, salidas estructuradas y caché de contexto. Los formatos de entrada de imagen y video dependen de la ruta de API seleccionada. Ambos siempre razonan y admiten niveles de esfuerzo de razonamiento low, high y max, con max como valor predeterminado.
Para conversaciones de múltiples turnos y llamadas a herramientas, las integraciones deben conservar los mensajes completos del asistente, incluido el contenido de razonamiento y las llamadas a herramientas, según lo requiera la API. Los límites de contexto reales y la disponibilidad de funciones también deben verificarse para el proveedor, producto y nivel de suscripción seleccionados.
Kimi K3.1 Pro vs Kimi K3: rendimiento
La evidencia proviene de pruebas internas de Moonshot y comparaciones reportadas, junto con evaluaciones independientes de terceros.
Estas deben interpretarse por separado porque los arneses de benchmark, los conjuntos de prueba, la configuración de razonamiento y los criterios de puntuación pueden diferir.
La evaluación de lanzamiento de Artificial Analysis reporta un aumento de 11 puntos en su Índice de Inteligencia compuesto, con mejoras especialmente grandes en programación basada en terminal y flujos de trabajo agenticos.
| Benchmark independiente (Artificial Analysis) | Kimi K3 | Kimi K3.1 Pro | Diferencia |
|---|---|---|---|
| Intelligence Index | 44 | 55 | +11 |
| Terminal-Bench 4.0 | ~13% | ~67% | +54 puntos porcentuales |
| AutomationBench-AA | 58% | 73% | +15 pp |
| GDPval-AA Elo | 1,534 | 1,846 | +312 |
| AA-Omniscience Index | 20 | 30 | +10 |
| Humanity's Last Exam | ~47% | ~52% | +5 pp |
| AA-Omniscience hallucination rate | 53% | 44% | −9 pp |
| AA-LCR v1.1 | 88.7% | 86.3% | −2.4 pp |
Estos son resultados de evaluaciones independientes. Se usan valores redondeados cuando el evaluador informa puntuaciones redondeadas. Una menor tasa de alucinación es mejor.
La mayor mejora se produce en programación basada en terminal. K3.1 Pro rinde sustancialmente mejor en tareas que requieren ejecución de comandos, interacción con el entorno, depuración y validación repetida.
AutomationBench-AA también muestra una ganancia significativa, lo que sugiere una ejecución más sólida en flujos de trabajo de software como servicio.
Los benchmarks de lanzamiento de Moonshot se centran en programación, ciencia, reconstrucción 3D, finanzas, trabajo de conocimiento y agentes autónomos.
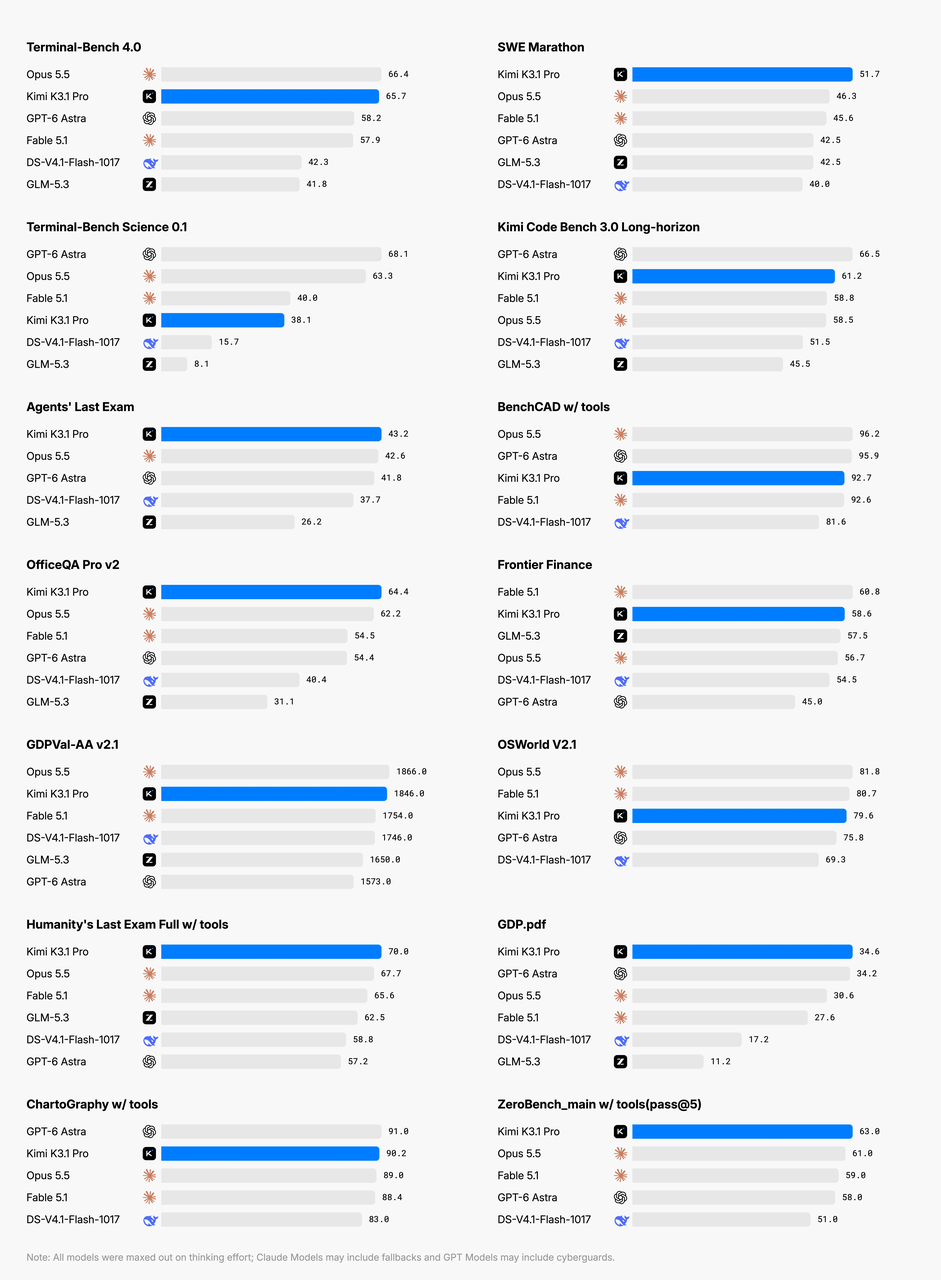
Las comparaciones seleccionadas incluyen a Claude Opus 5.5 y GPT-6 Astra. Compara cada resultado dentro de su benchmark nombrado y configuración indicada.
| Benchmark (Moonshot AI) | Kimi K3.1 Pro | Otro modelo | Puntuación del modelo de comparación |
|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | Claude Opus 5.5 | 66.4% |
| Terminal-Bench 4.0 | 65.7% | GPT-6 Astra | 58.2% |
| SWE-Marathon | 51.7% | Claude Opus 5.5 | 46.3% |
| Kimi Code Bench 3.0 | 61.2% | GPT-6 Astra | 66.5% |
| BenchCAD with tools | 92.7% | Claude Opus 5.5 | 96.2% |
| OfficeQA Pro v2 | 64.4 | Claude Opus 5.5 | 62.2 |
| Frontier Finance | 58.6 | Claude Opus 5.5 | 56.7 |
| OSWorld 2.1 | 79.6% | Claude Opus 5.5 | 81.8% |
K3.1 Pro se acerca o supera a varios modelos propietarios líderes en tareas seleccionadas. Pero no domina todas las categorías.
Por ejemplo, queda por detrás de Claude Opus 5.5 en las comparaciones de BenchCAD y OSWorld informadas por el proveedor, y el gráfico oficial muestra una debilidad mayor en Terminal-Bench Science.
Las configuraciones de evaluación difieren: Artificial Analysis usa el arnés mini-swe-agent para Terminal-Bench 4.0, mientras que Moonshot usa Claude Code. Compara puntuaciones dentro del mismo entorno de prueba; los arneses, el esfuerzo de razonamiento y los límites de ejecución pueden afectar los resultados.
Programación e ingeniería de software
Para programación autónoma compleja, K3.1 Pro suele ser la opción más fuerte.
Los resultados de Kimi Code Bench 3.0 Long-horizon internos de Moonshot aumentan de 55.95% para K3 a 61.2% para K3.1 Pro, una ganancia de aproximadamente 5.25 puntos porcentuales.
Los resultados independientes de Terminal-Bench también muestran una ganancia sustancial. Estas pruebas evalúan la ejecución de múltiples pasos: comprender un repositorio, cambiar archivos, ejecutar comandos, diagnosticar errores y verificar el resultado.
K3.1 Pro es el candidato más sólido para desarrollo multifichero, trabajo autónomo en terminal y depuración extendida. Para generación de código simple, compara ambos modelos en tus propias tareas; K3 sigue siendo la opción inmediata cuando se requiere self-hosting.
Una distinción importante es que las puntuaciones de benchmarks de programación dependen en gran medida del marco de agente. Las herramientas, los prompts, los límites de ejecución y los entornos de prueba influyen en el resultado.
Para desarrollo de software en producción, la mejor evaluación sigue siendo una comparación emparejada en tus propios repositorios.
Investigación financiera y operaciones empresariales
La modelización financiera ofrece algunas de las comparaciones directas más claras entre ambos modelos.
Moonshot probó K3 y K3.1 Pro en evaluaciones internas que cubren construcción de hojas de cálculo, calidad de la investigación y operaciones empresariales simuladas.
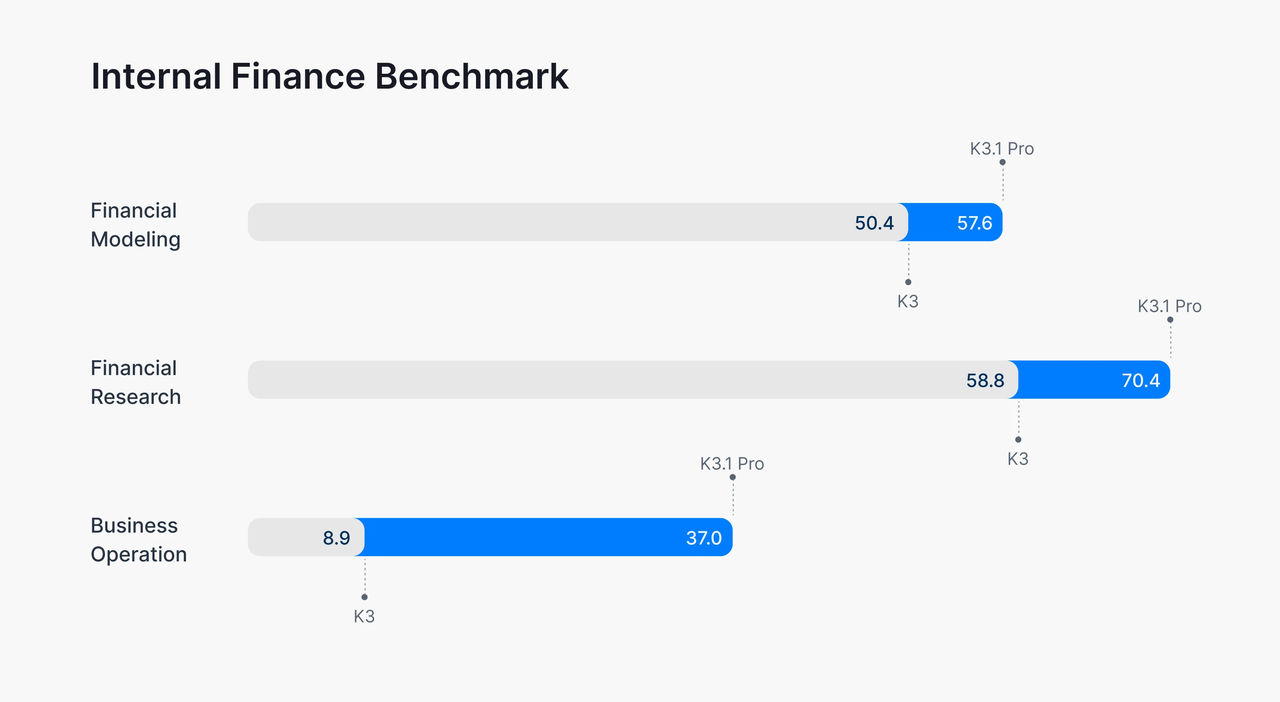
Los resultados financieros internos de Moonshot cubren modelización financiera, investigación y operaciones empresariales simuladas. Estos puntajes por tarea reportados por el proveedor no son medidas de rendimientos de inversión. No se debe suponer que la configuración por tarea sea idéntica a la de benchmarks no relacionados.
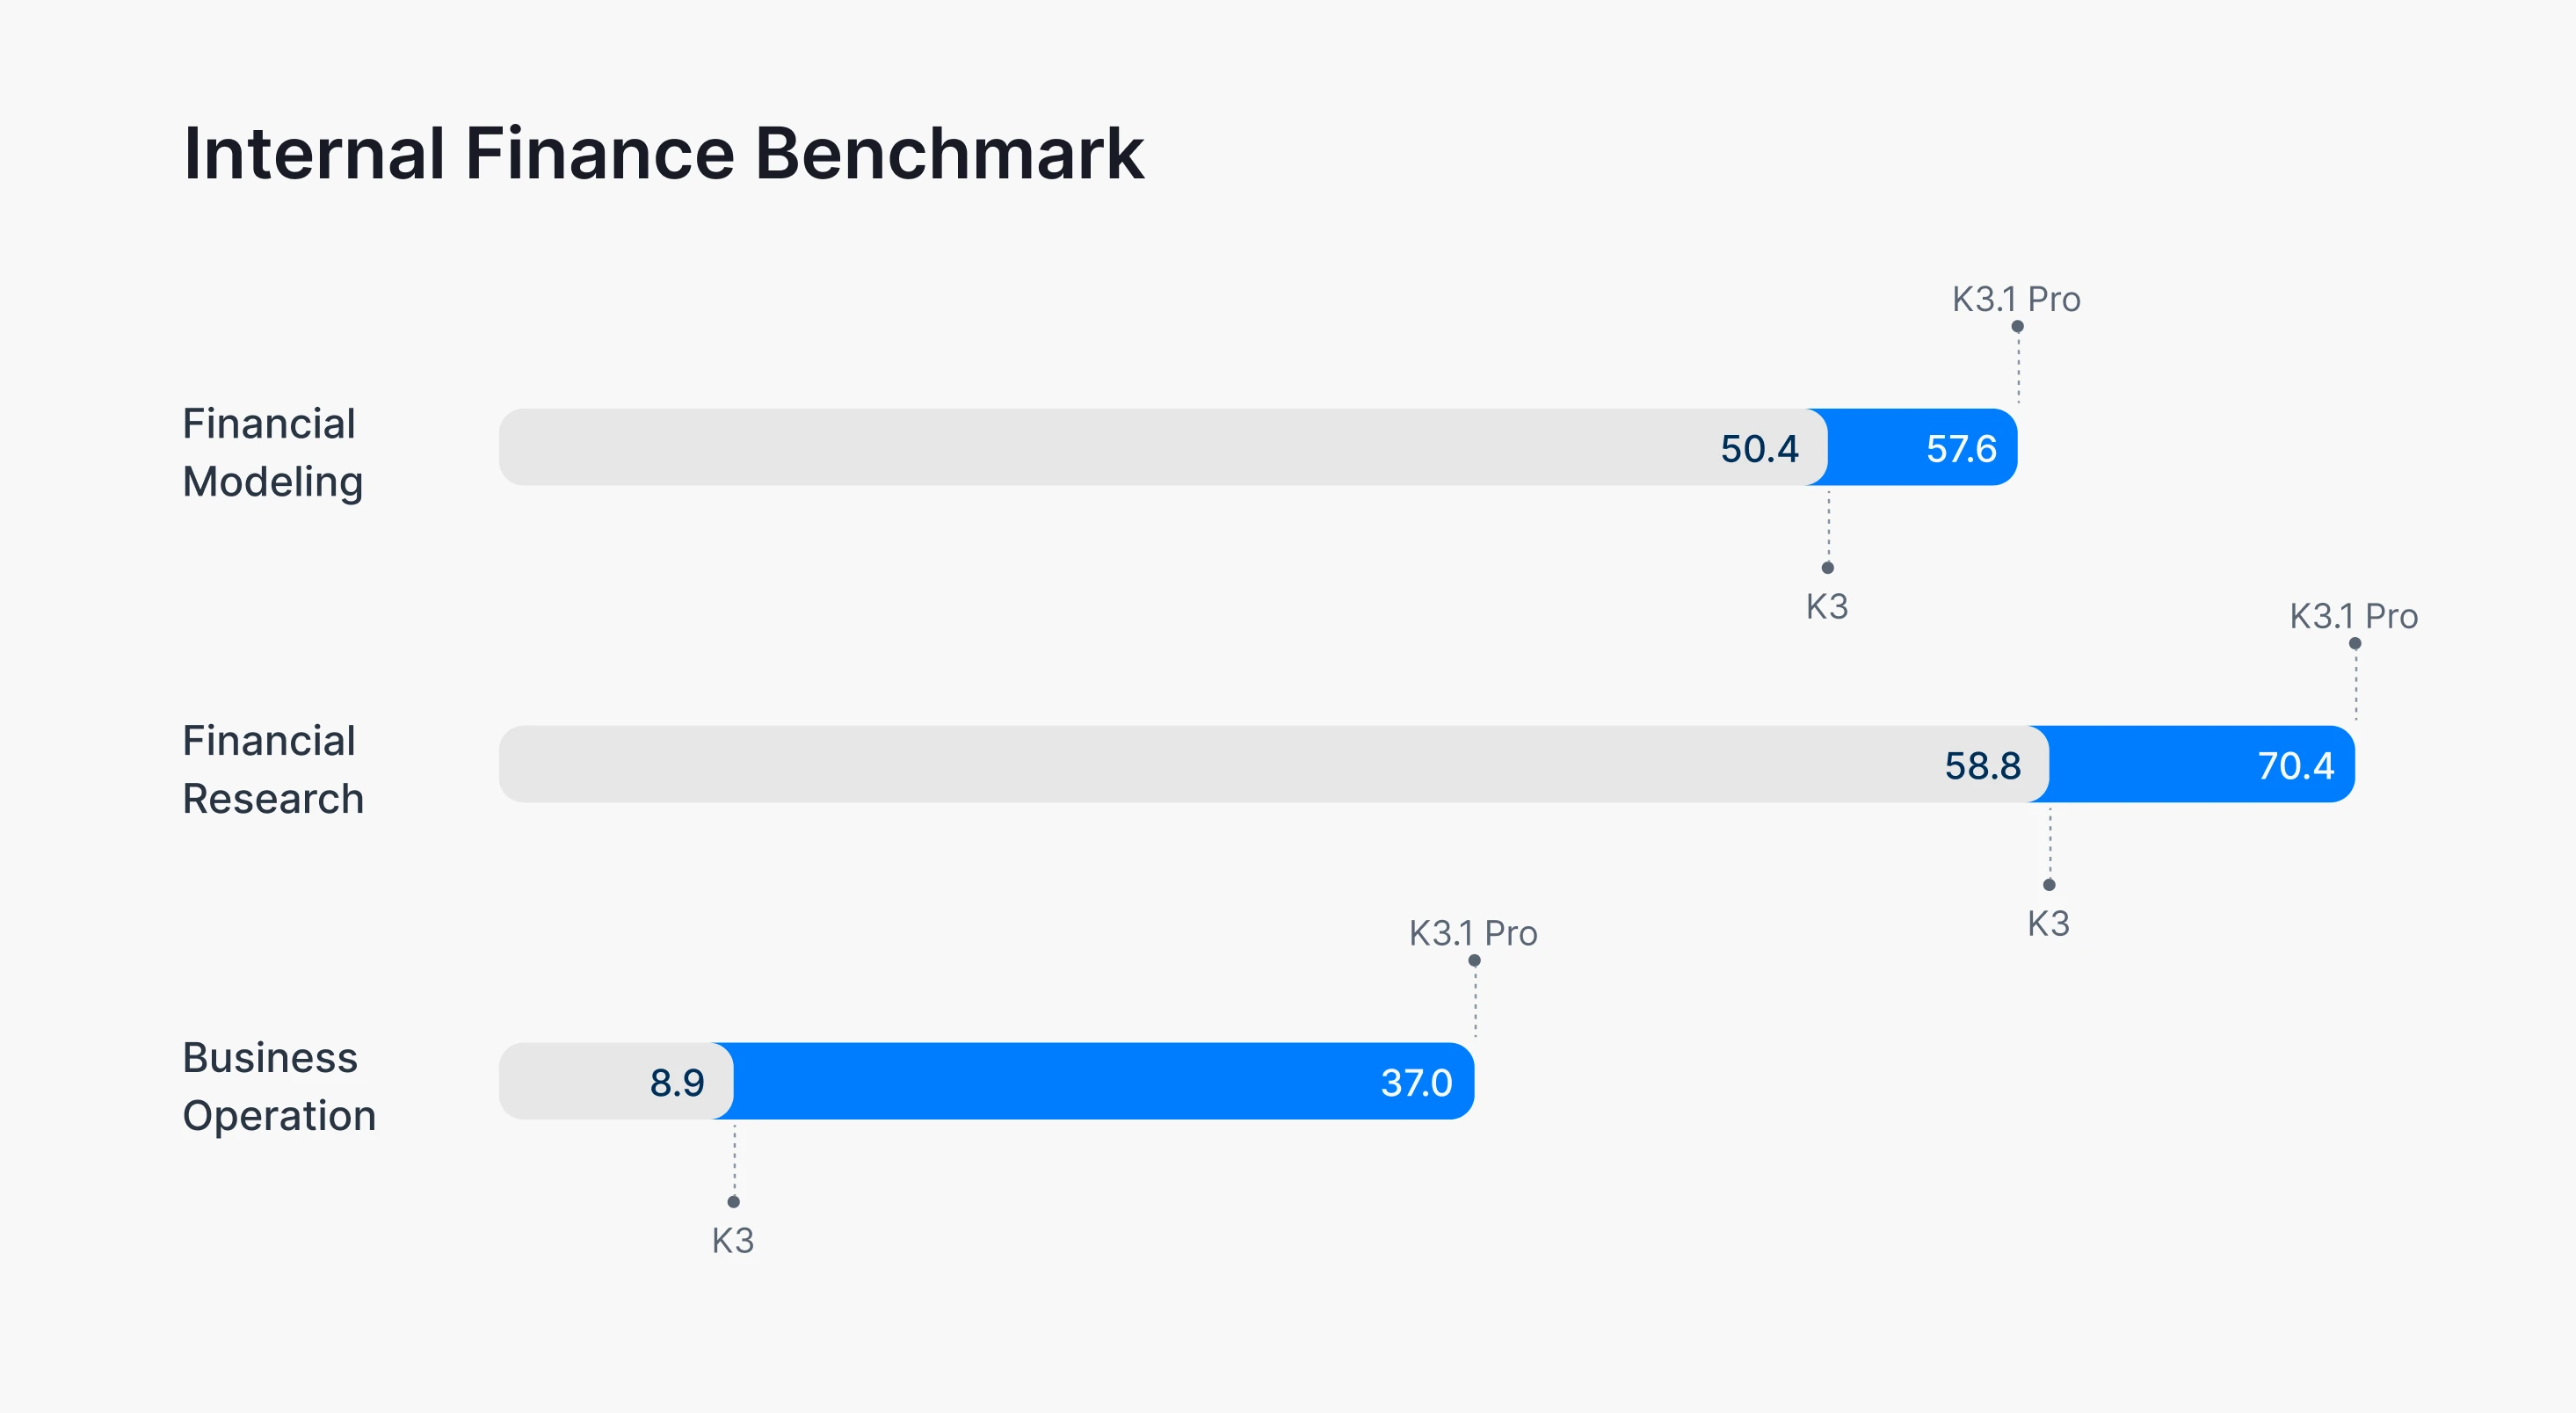
En las pruebas internas de Moonshot, Financial Modeling sube de 50.4 a 57.6, una ganancia de 7.2 puntos, y Financial Research sube de 58.8 a 70.4, una ganancia de 11.6 puntos. Business Operation aumenta de 8.9 a 37.0, alrededor de 4.2 veces la puntuación de K3.
Este benchmark evalúa la gestión y la toma de decisiones a largo plazo en un entorno empresarial simulado. Por lo tanto, está más estrechamente relacionado con la planificación agentica que con el simple QA financiero.
Financial Research mide la capacidad de producir investigación basada en evidencias respetando los requisitos de las fuentes y los cortes de información. Financial Modeling se centra en las relaciones matemáticas, la lógica de hojas de cálculo y la calidad del libro de trabajo.
El patrón sugiere que K3.1 Pro es particularmente valioso cuando las tareas financieras requieren razonamiento sostenido, verificación y entregables estructurados.
Para inversionistas, analistas y usuarios de negocio, el beneficio práctico es potencialmente un mejor manejo de flujos de trabajo multidocumento. Ningún modelo debe usarse como autoridad incuestionable para decisiones financieras.
Razonamiento de contexto largo y fiabilidad factual
Sin embargo, los resultados de AA-LCR de contexto largo muestran a K3 ligeramente por delante. Es un recordatorio útil de que un modelo más nuevo puede mejorar sustancialmente en general sin ganar todas las tareas especializadas.
Las evaluaciones reportadas muestran menos errores fácticos en sus respectivos conjuntos de prueba.
En Kimi Hallu Bench Hard with tools, Moonshot informa que la tasa de error a nivel de afirmación disminuyó de 23.4% para K3 a 8.3% para K3.1 Pro.
Eso es una reducción relativa de alrededor del 65% en la prueba de estrés deliberadamente difícil de Moonshot, más que una estimación de tasas de error cotidianas. Por separado, Artificial Analysis informa un descenso en la tasa de alucinación de AA-Omniscience del 53% al 44%. Las dos evaluaciones utilizan métodos diferentes, por lo que sus porcentajes no son directamente comparables.
La lección práctica es que K3.1 Pro parece más fiable en las tareas evaluadas, pero las mejoras factuales no eliminan la necesidad de recuperación, citas, verificación de cálculos y revisión humana en flujos de trabajo con consecuencias.
Análisis de datos: evidencia de la evaluación de Plotly
Plotly evaluó K3.1 Pro estándar a través de OpenRouter usando una prueba privada de 43 preguntas sobre un almacén de datos sintético de energía eólica. No probó Highspeed. Los resultados ilustran el trade-off entre calidad de respuesta, tiempo de finalización y costo en ese flujo analítico específico basado en SQL.
| Medida de analítica de datos de Plotly | Kimi K3 | Kimi K3.1 Pro |
|---|---|---|
| Respuestas correctas | 35/43 | 42/43 |
| Exactitud | 81.4% | 97.7% |
| Patrones ocultos descubiertos | 0/5 | 5/5 |
| Problemas de calidad de datos detectados | 1/3 | 3/3 |
| Costo de la evaluación completa | $5.01 | $13.47 |
| Tiempo mediano por pregunta | 43 segundos | 2.5 minutos |
En esta evaluación, K3.1 Pro respondió más preguntas correctamente e identificó más patrones ocultos y problemas de calidad de datos, pero incurrió en mayor costo y mayor tiempo mediano de finalización.
Los cargos reportados son costos de evaluación observados, no estimaciones calculadas a partir de los precios estándar de la API de Moonshot. La configuración publicada no establece que todos los ajustes del proveedor fueran idénticos entre ambas ejecuciones del modelo, por lo que las diferencias no pueden atribuirse únicamente al modelo.
Estos resultados respaldan evaluar K3.1 Pro para tareas analíticas donde hallazgos adicionales podrían justificar más tiempo y gasto. No establecen la misma exactitud ni la misma ventaj de costo.
¿Kimi K3.1 Pro es más rápido que Kimi K3?
Distingue el rendimiento de generación de tokens de salida de la latencia de la tarea de extremo a extremo.
Artificial Analysis informa 73.5 tokens de salida por segundo para K3.1 Pro, en comparación con 38.5 para K3 al máximo esfuerzo de razonamiento, usando la API de Kimi. Estas son mediciones de generación de tokens, verificadas el 24 de octubre de 2026; la latencia total de la tarea también depende de la duración del razonamiento y la ejecución de herramientas.
Sin embargo, una generación más rápida de tokens no garantiza una finalización más rápida de la tarea.
Moonshot también ofrece K3.1 Pro Highspeed, que se anuncia como aproximadamente dos a tres veces más rápido en salida que la variante estándar. Esta es una mejora en la velocidad de servicio, no una mejora de inteligencia verificada por separado.
K3.1 Pro tiene un mayor rendimiento informado de tokens de salida, pero no necesariamente completa las tareas más rápido. Distingue la velocidad de generación de tokens del tiempo necesario para razonar, llamar herramientas y terminar el trabajo.
Velocidad de salida vs. tiempo de finalización de tarea
Artificial Analysis informa velocidades de salida de 73.5 tokens por segundo para K3.1 Pro y 38.5 para K3 al máximo esfuerzo de razonamiento, usando la API de Kimi. Estas mediciones se verificaron el 24 de octubre de 2026 y describen el rendimiento de generación de tokens más que la latencia de la tarea de extremo a extremo.
Un modelo puede generar tokens más rápido y aun así tardar más en general si produce más tokens de razonamiento o realiza llamadas adicionales a herramientas. En la evaluación de Plotly mencionada, el tiempo mediano de K3.1 Pro fue de 2.5 minutos por pregunta, frente a 43 segundos para K3, junto con mayor exactitud.
Para aplicaciones interactivas, mide el tiempo hasta el primer token y el tiempo total de finalización de la tarea en la ruta del proveedor real. El rendimiento de salida por sí solo no basta para predecir la capacidad de respuesta.
Considera K3.1 Pro Highspeed
Moonshot anuncia K3.1 Pro Highspeed como aproximadamente dos a tres veces más rápido en salida que K3.1 Pro estándar. Esa afirmación se refiere a la velocidad de servicio; no debe interpretarse como una reducción de dos a tres veces del tiempo total de finalización de la tarea.
Considera Highspeed para programación interactiva o asistentes donde los usuarios esperan respuestas. Compara la latencia de extremo a extremo, el éxito de la tarea y el costo total facturado frente al endpoint estándar antes de elegirlo. Highspeed tiene precios más altos de tokens de entrada y salida regulares, mientras que su tarifa de entrada en caché es la misma.
Kimi K3.1 Pro vs Kimi K3: costo
Tarifas oficiales de API y de CometAPI
Las tarifas oficiales estándar de entrada, salida y aciertos de caché de K3.1 Pro son un tercio más bajas que las de K3. Las tarifas de entrada y salida en CometAPI listadas están un 20% por debajo de las correspondientes tarifas oficiales.
| Modelo | Entrada oficial / 1M | Salida oficial / 1M | Entrada oficial en caché / 1M | Entrada CometAPI / 1M | Salida CometAPI / 1M |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | $2.00 | $10.00 | $0.20 | $1.60 | $8.00 |
| Kimi K3 | $3.00 | $15.00 | $0.30 | $2.40 | $12.00 |
| Kimi K3.1 Pro Highspeed | $4.00 | $20.00 | $0.20 | Consultar cotización actual | Consultar cotización actual |
USD por millón de tokens; tarifas verificadas el 24 de octubre de 2026. Las columnas de entrada muestran tarifas de entrada regular sin caché. Se excluyen impuestos y cargos facturados por separado.
La tarificación oficial de Kimi también lista cargos por escritura en caché: $2/$4 por millón de tokens para Pro estándar con retención de 5 minutos/1 hora, y $4/$8 para Highspeed. Los aciertos de caché, las escrituras de caché y la entrada regular son categorías de facturación separadas y mutuamente excluyentes.
Kimi oficial y CometAPI son rutas de proveedor separadas. Confirma la tarificación actual y el soporte de caché para tu ruta seleccionada, incluida la disponibilidad de Highspeed. Compara el costo total facturado por tarea además de las tarifas de tokens.
Ejemplo de costo con tokens fijos
Considera una carga de trabajo que consume 100,000 tokens de entrada sin caché y 20,000 tokens de salida.
Para esta carga fija, el costo de la API oficial es $0.60 con K3 y $0.40 con K3.1 Pro. A las tarifas listadas de CometAPI, los mismos conteos de tokens cuestan $0.48 y $0.32, respectivamente. Estos totales incluyen únicamente los tokens de entrada y salida indicados.
Pero esta es una comparación de tokens fijos. Los flujos de trabajo de agentes complejos pueden consumir diferentes cantidades de tokens de razonamiento y llamadas a herramientas según el modelo.
Los ahorros en tokens desaparecen
Sea I el mismo conteo de tokens de entrada sin caché, O el conteo de tokens de salida facturados de Kimi K3 y P el conteo de tokens de salida facturados de Kimi K3.1 Pro, todos medidos en millones. A las tarifas oficiales estándar de la tabla de precios, los cargos son 3I + 15O y 2I + 10P dólares. Son iguales cuando P = 1.5O + 0.1I.
Para solicitudes con mucha salida, K3.1 Pro puede, por tanto, usar aproximadamente un 50% más de tokens de salida facturados antes de perder su ventaja de precio. Este cálculo asume tarifas sin cambios y excluye caché, tarifas de herramientas y otros usos facturados por separado. Usa las categorías de tokens facturados reales en lugar de la longitud visible de la respuesta.
Costo por tarea completada con éxito
Calcula el costo por tarea exitosa como el costo total facturado de todos los intentos de evaluación dividido por el número de tareas únicas que cumplen un criterio de aceptación predefinido. Incluye cargos de intentos no exitosos, reintentos y timeouts cuando el proveedor los factura; dividir solo el costo de las ejecuciones exitosas por su cantidad puede subestimar el costo por éxito.
Mantén el conjunto de tareas, los criterios de aceptación, el límite de reintentos y la política de timeouts fijos entre Kimi K3 y K3.1 Pro. Informa la tasa de éxito junto con el costo por éxito para que no eliminar tareas difíciles haga que un modelo parezca artificialmente económico. Si no hay ninguna tarea exitosa, el costo por éxito no está definido, no es cero.
Kimi K3.1 Pro vs Kimi K3: comparación y selección
Para la mayoría de las cargas de trabajo agenticas alojadas, K3.1 Pro es el punto de partida más sólido. No obstante, la decisión debe reflejar la complejidad de la tarea y los requisitos de despliegue.
| Caso de uso | Modelo recomendado | Motivo |
|---|---|---|
| Programación autónoma | Kimi K3.1 Pro | Evalúa cambios multifichero, trabajo en terminal, depuración y resultados de pruebas finales. |
| Investigación financiera multidocumento | Kimi K3.1 Pro | Mejores benchmarks de investigación y operaciones empresariales |
| Análisis de datos complejo | Kimi K3.1 Pro | Mejor detección de problemas y pruebas de calidad de datos |
| Creación 3D y flujos CAD | Kimi K3.1 Pro | Capacidades especializadas sólidas asistidas por herramientas |
| Tareas de texto sencillas | Evaluar ambos | Compara tareas rutinarias de texto y programación simple en ambos modelos; el razonamiento extra puede añadir latencia sin mejorar un resultado aceptable. |
| Precisión en recuperación de contexto largo | Evaluar ambos | K3 lidera ligeramente en AA-LCR |
| Self-hosting inmediato | Kimi K3 | Pesos descargables ya disponibles |
| Agentes interactivos de alta capacidad | K3.1 Pro Highspeed | Servicio más rápido, sujeto a validación de costos |
| Flujos de producción sensibles al costo | Evaluar ambos | Un precio de tokens más bajo puede no traducirse en menor costo por tarea |
Automatización alojada y flujos profesionales
Para agentes de programación alojados y flujos analíticos, evalúa K3.1 Pro en las partes difíciles del trabajo: cambios multifichero, recopilación de evidencias, verificación de cálculos y recuperación tras una llamada a herramienta fallida. Prefiere reducciones medidas en tareas fallidas o trabajo correctivo frente a una puntuación titular más alta por sí sola.
Para aplicaciones establecidas en K3, mantén la ruta actual como línea base de comparación. Las tareas rutinarias pueden ya cumplir el umbral de aceptación, mientras que las tareas especializadas de contexto largo pueden comportarse de manera diferente a los benchmarks agregados. Prioriza los segmentos de carga donde la actualización tenga un beneficio medible.
Self-hosting y restricciones de despliegue
A 24 de octubre de 2026, los pesos completos de K3 están disponibles para despliegue sujeto a la licencia del modelo y los requisitos de hardware. Los pesos completos de K3.1 Pro aún no se han publicado.
Moonshot planea publicar los pesos de K3.1 Pro para el 4 de noviembre de 2026. Este es un plan de publicación anunciado, no un checkpoint disponible; confirma los pesos publicados y las condiciones aplicables antes de programar el self-hosting.
Criterios de evaluación en producción
Compara K3 y K3.1 Pro en tareas representativas usando los mismos prompts, herramientas, criterios de aceptación, límites de reintentos y timeouts. Registra los ajustes del proveedor y del razonamiento, y conserva los mensajes completos del asistente como requiere la API.
Mide éxito de la tarea, latencia, uso de tokens y costo por tarea exitosa, incluyendo fallas y reintentos facturados. Revisa casos donde K3 tiene éxito y K3.1 Pro falla. Para evaluación humana, oculta las etiquetas de modelo y aleatoriza el orden de salida.
Si K3.1 Pro cumple tus umbrales de calidad, latencia y costo, impleméntalo gradualmente con un fallback probado en K3.
Migración controlada y fallbacks
Un enfoque práctico es empezar con un pequeño porcentaje del tráfico de producción en K3.1 Pro.
Mantén K3 disponible como fallback durante la validación. Compara calidad de la tarea, latencia, tasas de fallo y gasto antes de aumentar el uso de K3.1 Pro.
Presta especial atención a los esquemas de llamadas a herramientas, los campos de mensajes relacionados con razonamiento, las entradas multimodales y el parsing de salidas. La compatibilidad de API no garantiza automáticamente un comportamiento de aplicación idéntico.
Ganancias y regresiones en benchmarks
Si ambos modelos respondieron las mismas 43 preguntas y obtuvieron 35 y 42, K3.1 Pro podría haber corregido siete fallas de K3 sin regresiones, u ocho fallas mientras pierde una respuesta antes correcta. La puntuación total por sí sola no puede distinguir estos resultados.
Inspecciona respuestas emparejadas y clasifícalas como ambos correctos, solo K3 correcto, solo K3.1 Pro correcto o ambos incorrectos. Revisa los éxitos exclusivos de K3 frente a tus tareas de mayor impacto antes de migrar. El resultado 42/43 describe ese conjunto de prueba; no garantiza una tasa de éxito de 97.7% en una carga de trabajo diferente.
Evaluación ciega de salidas de modelos
Oculta las etiquetas de modelo y aleatoriza el orden en que los revisores ven las salidas. Define la rúbrica de aceptación antes de revisarlas: para código, usa pruebas ejecutables y checks de regresión; para investigación, verifica soporte de fuentes, cálculos y si el entregable solicitado está completo. Puntúa la corrección antes de considerar presentación o estilo de escritura.
Revela la identidad del modelo, latencia y costo facturado solo después de registrar la evaluación de calidad. Esto separa la calidad de salida de las expectativas sobre el modelo más nuevo. Resuelve desacuerdos de revisores con las mismas pruebas o fuentes, y conserva las decisiones para que un modelo o prompt posterior pueda evaluarse con consistencia.
¿Dónde puedes acceder a Kimi K3.1 Pro y Kimi K3?
Acceso del proveedor oficial
Usa la API de Kimi K3 o la API de Kimi K3.1 Pro documentadas por Moonshot para una integración directa con el proveedor. Verifica el identificador del modelo del endpoint seleccionado, los campos de solicitud admitidos y los límites de cuenta. El acceso público a la API y los pesos del modelo descargables son opciones de despliegue separadas.
Acceso a través de CometAPI
Los desarrolladores pueden acceder a la API de Kimi K3.1 Pro y a la API de Kimi K3 mediante la interfaz unificada de CometAPI y comparar ambas rutas con la misma carga de trabajo de la aplicación.
Esto hace que la migración de K3 a K3.1 Pro sea relativamente directa, especialmente para aplicaciones que ya usan una interfaz de chat compatible con OpenAI.
Para usar CometAPI, crea una cuenta y una clave de API, luego configura tu aplicación con el endpoint y el identificador de modelo en la documentación de integración. Selecciona kimi-k3 para K3, kimi-k3.1-pro para K3.1 Pro estándar, o kimi-k3.1-pro-highspeed para la ruta Highspeed donde esté soportada. Comienza con una solicitud pequeña y luego compara la misma carga de trabajo entre modelos mientras verificas resultados devueltos, latencia y uso facturado.
Conclusión
Kimi K3.1 Pro es el candidato más fuerte para programación autónoma exigente, investigación financiera y flujos de trabajo agenticos extendidos en las evaluaciones revisadas aquí. Kimi K3 sigue siendo relevante para self-hosting inmediato y cargas donde su perfil actual de precisión o latencia ya cumple los requisitos.
Elige usando tareas representativas y la ruta de proveedor real. Compara resultados exitosos, latencia y gasto total, luego migra gradualmente. Los precios de tokens más bajos y las puntuaciones más altas en benchmarks agregados son un buen punto de partida, pero no establecen la mejor configuración para cada aplicación.