
TL;DR
MiniMax M3.1 Flash es un modelo de IA de alta velocidad diseñado para agentes autónomos, ingeniería de software, uso de computadoras y automatización de flujos de trabajo complejos. Lanzado oficialmente el 19 de octubre de 2026, combina una ventana de contexto de 1 millón de tokens con profundidad de razonamiento configurable y menores costos de inferencia.
MiniMax informa hasta 200+ tokens de salida por segundo, una reducción del 70% en los costos de carga de trabajo de agentes en comparación con su predecesor y un rendimiento competitivo en Automation-Bench, DeepSWE y OSWorld. Con $0.15 por millón de tokens de entrada y $0.60 por millón de tokens de salida, el modelo hace más económicos los flujos de trabajo de agentes de IA multi‑paso.
Puntos clave
- Rendimiento de MiniMax M3.1 Flash: Los benchmarks informados por el proveedor incluyen Automation-Bench 62.8, DeepSWE v1.1 73.7 y OSWorld 2.0 61.7, destacando sus capacidades en automatización de agentes, codificación y uso de computadoras.
- Precios del API de MiniMax M3.1 Flash: Las tarifas oficiales son $0.15/M de entrada, $0.60/M de salida y $0.015/M de entrada en caché. Las tarifas de CometAPI son $0.80/M de entrada y $3.20/M de salida al 21 de octubre de 2026, sin tarifa de caché publicada en la página del modelo.
- Velocidad de inferencia de MiniMax M3.1 Flash: MiniMax informa 200+ tokens/s en condiciones favorables y un rendimiento P50 superior a 170 tokens/s, lo que respalda flujos de trabajo de agentes receptivos.
- Eficiencia del agente con MiniMax M3.1 Flash: Cinco niveles de esfuerzo de razonamiento permiten a los desarrolladores equilibrar finalización de tareas, latencia y costos generales de los agentes de IA.
- Acceso al API de MiniMax M3.1 Flash: Los desarrolladores pueden acceder al modelo lanzado a través de MiniMax o explorar la integración con CometAPI usando identificadores de modelo y precios específicos del proveedor.
¿Qué es MiniMax M3.1 Flash?
MiniMax M3.1 Flash es un modelo de lenguaje de nueva generación optimizado para razonamiento agente, codificación, uso de herramientas y ejecución autónoma de flujos de trabajo. MiniMax presentó oficialmente M3.1 Flash el 19 de octubre de 2026.
En lugar de centrarse exclusivamente en la inteligencia conversacional o puntuaciones aisladas, apunta al costo total de completar tareas mediante razonamiento repetido, llamadas a herramientas y ejecución multi‑paso. MiniMax también asoció su desarrollo temprano con Space Bunny, un modelo desplegado anónimamente que, según afirma, procesó más de 200 billones de tokens antes del anuncio; esta es una cifra de uso reportada, no un conteo publicado de tokens de entrenamiento.
Para desarrolladores que construyen asistentes de codificación autónomos, compañeros de trabajo de IA empresariales y agentes en el navegador, M3.1 Flash ofrece tres ventajas relevantes: amplia capacidad de contexto, generación rápida y uso de tokens económico.
¿Cuáles son las especificaciones de MiniMax M3.1 Flash?
| Especificaciones del API | MiniMax M3.1 Flash |
|---|---|
| Desarrollador | MiniMax |
| Lanzamiento oficial | 19 de octubre de 2026 |
| Familia de modelos | MiniMax M3 |
| Ventana de contexto | 1,000,000 tokens |
| Capacidades principales | Automatización de agentes, codificación, razonamiento, uso de computadoras |
| Modalidades de entrada | Texto, imagen y video vía el API compatible con OpenAI de MiniMax; confirme soporte en otros proveedores |
| Modalidad de salida | Texto |
| Controles de razonamiento | Low, medium, high, xhigh, max |
| Velocidad de salida informada | Hasta 200+ tokens/s |
| Velocidad P50 informada | 170+ tokens/s |
| Canales de acceso | MiniMax API, M Plan, MiniMax Code |
| Pesos abiertos | Anunciados para un lanzamiento futuro |
| Conteo de parámetros específico de M3.1 | No establecido en el anuncio |
Una gran ventana de contexto es valiosa para codificación a escala de repositorio y flujos de trabajo con muchos documentos, pero no garantiza un recuerdo perfecto. Los agentes en producción aún deben usar recuperación selectiva, respuestas de herramientas estructuradas y compresión de contexto.
Cinco configuraciones de esfuerzo de razonamiento permiten a los desarrolladores reservar cómputo intensivo para planificación y depuración complejas en lugar de gastar el esfuerzo máximo en cada paso de clasificación, extracción o simple selección de herramientas. Dado que una solicitud de agente puede activar docenas de invocaciones del modelo, pequeños ahorros en pasos rutinarios pueden reducir materialmente el costo total.
¿Cómo rinde MiniMax M3.1 Flash en las pruebas de referencia?
MiniMax informa resultados de benchmarks que abarcan automatización empresarial, ingeniería de software, uso de computadoras, ciberseguridad y razonamiento multimodal. Son evaluaciones reportadas por el proveedor, no un sustituto de pruebas independientes en un despliegue real.
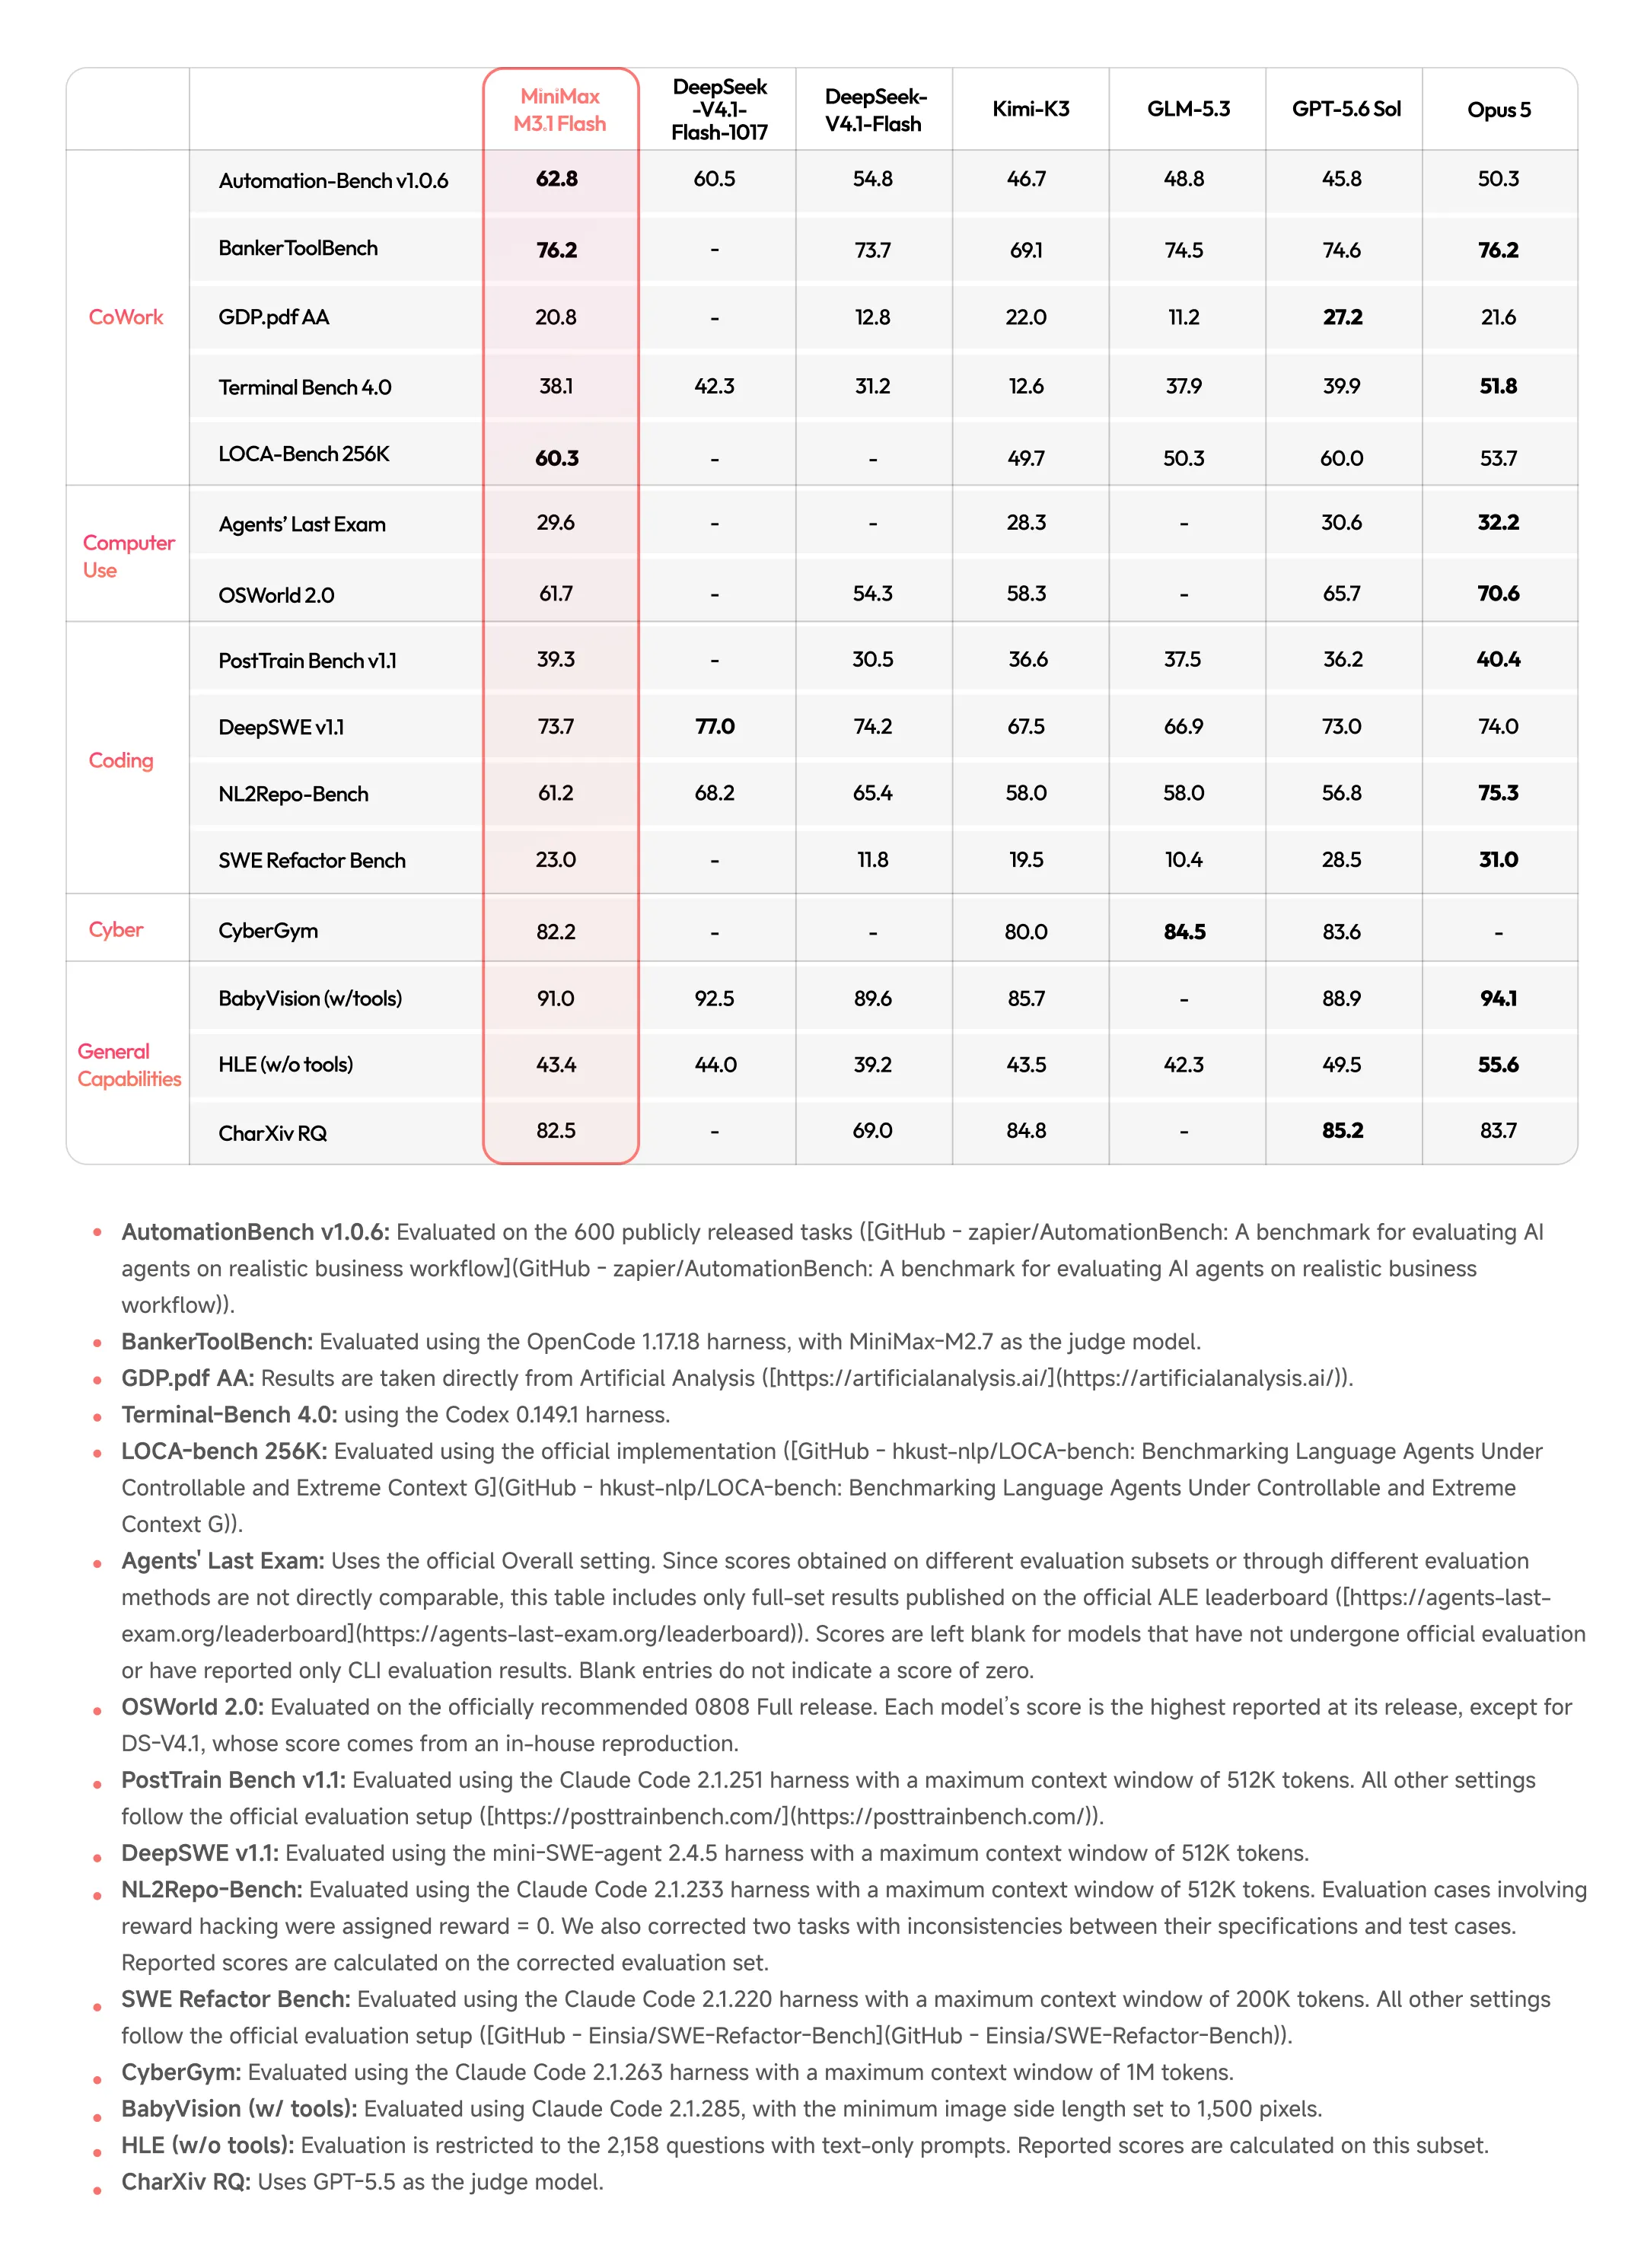
Comparación oficial de benchmarks de MiniMax, incluidas notas de evaluación. Las puntuaciones las reporta el proveedor y no representan una prueba independiente uniforme.
| Resultados oficiales de benchmarks | M3.1 Flash | Qué mide |
|---|---|---|
| Automation-Bench v1.0.6 | 62.8 | Automatización empresarial multi‑paso |
| BankerToolBench | 76.2 | Razonamiento financiero y herramientas |
| LOCA-Bench 256K | 60.3 | Ejecución de agentes con contexto largo |
| DeepSWE v1.1 | 73.7 | Ingeniería de software autónoma |
| Terminal Bench 4.0 | 38.1 | Resolución de problemas en terminal |
| OSWorld 2.0 | 61.7 | Interacción con escritorio/computadora |
| Agents’ Last Exam | 29.6 | Tareas económicas complejas |
| CyberGym | 82.2 | Resolución de problemas de ciberseguridad |
| BabyVision with tools | 91.0 | Razonamiento visual con herramientas |
| HLE without tools | 43.4 | Conocimientos y razonamiento desafiantes |
Automation-Bench v1.0.6 usa 600 tareas públicas. BankerToolBench usa OpenCode 1.17.18 con MiniMax-M2.7 como juez; Terminal Bench 4.0 usa Codex 0.149.1. DeepSWE v1.1 usa mini-SWE-agent 2.4.5 con un límite de contexto de 512K. OSWorld usa la versión 0808 Full: la tabla combina la puntuación más alta de cada modelo, excepto DeepSeek V4.1, que MiniMax reprodujo internamente. Estas configuraciones diferentes limitan las conclusiones directas entre modelos.
Para automatización empresarial, priorice Automation-Bench y BankerToolBench; para agentes de codificación, examine DeepSWE y los resultados basados en terminal. OSWorld evalúa interacciones con un entorno computacional en lugar de simplemente generar instrucciones. Una única puntuación agregada no reemplaza el análisis específico por tarea.
¿Qué tan rápido es MiniMax M3.1 Flash?
Los sistemas de agentes suelen realizar muchas llamadas secuenciales al modelo, por lo que el rendimiento por sí solo no describe la capacidad de respuesta.
| Métrica de velocidad | Rendimiento informado |
|---|---|
| Pico cotidiano de rendimiento de salida | 200+ tokens/s |
| Rendimiento mediano (P50) | 170+ tokens/s |
| Mejora de inferencia en línea | Casi 3× vs la generación anterior |
| Reducción del costo de carga de trabajo de agentes | 70% vs el predecesor |
Estas cifras de velocidad y costo de carga de trabajo reportadas por el proveedor describen la evaluación de lanzamiento de MiniMax, no un rendimiento ni ahorros garantizados para todas las aplicaciones. El hardware de servicio, la concurrencia, la longitud de los prompts y la variabilidad entre ejecuciones no se especifican completamente en el anuncio.
La latencia extremo a extremo también incluye el retraso del primer token, la sobrecarga de razonamiento, el tiempo de herramientas, reintentos y dependencias entre pasos. Un generador más rápido puede perder su ventaja si un agente necesita más llamadas para completar la misma tarea.
¿Cuánto cuesta la API de MiniMax M3.1 Flash?
MiniMax anunció tarifas estándar planas para M3.1 Flash sin un nivel separado de alto contexto en su descripción de precios inicial. Mientras tanto, la API Preview de MiniMax M3.1 Flash en CometAPI ofrece una estructura de precios separada con un descuento del 20% frente a sus tarifas de referencia mostradas.
| Categoría de precios | M3.1 Flash oficial | CometAPI Preview (≤512K) | CometAPI Preview (>512K) |
|---|---|---|---|
| Tokens de entrada / 1M | $0.15 | $0.24 | $0.48 |
| Tokens de salida / 1M | $0.60 | $0.96 | $1.92 |
| Entrada en caché / 1M | $0.02 | $0.05 | $0.10 |
| Estructura de precios | Tarifa plana | Nivel de contexto corto | Nivel de contexto largo |
Los precios oficiales del API de MiniMax hacen a M3.1 Flash particularmente atractivo para cargas de trabajo de agentes. Los tokens de salida cuestan cuatro veces la tarifa estándar de entrada, mientras que la entrada en caché cuesta una décima parte. Por lo tanto, las instrucciones repetidas y el historial de herramientas pueden convertirse en un objetivo de optimización mayor.
Los precios Preview de CometAPI comienzan en $0.24 por millón de tokens de entrada y $0.96 por millón de tokens de salida, representando un descuento del 20% respecto a sus precios de referencia Preview mostrados. Sin embargo, estas tarifas siguen siendo más altas que los nuevos precios oficiales anunciados de M3.1 Flash porque ambas ofertas usan bases de precios diferentes.
Para los desarrolladores, la distinción clave es que CometAPI proporciona una experiencia de integración unificada, mientras que la versión oficial actualmente ofrece tarifas de tokens publicadas más bajas. Antes del despliegue, verifique la versión activa del modelo, el nivel de longitud de contexto y las reglas de facturación para estimar con precisión el costo de los flujos de trabajo de agentes autónomos.
Costo de MiniMax M3.1 Flash por tarea de agente
Costo de inferencia estimado = (tokens de entrada no en caché × tarifa de entrada + tokens de entrada en caché × tarifa de caché + tokens de salida × tarifa de salida) / 1,000,000.
| Carga de trabajo ilustrativa | Entrada no en caché | Entrada en caché | Salida | Costo est. |
|---|---|---|---|---|
| Asistente de herramientas simple | 10K | 0 | 2K | $0.0027 |
| Revisión de pull request | 40K | 20K | 8K | $0.0111 |
| Agente de codificación multi‑paso | 100K | 200K | 30K | $0.0360 |
| Investigación empresarial | 300K | 700K | 80K | $0.1035 |
| Flujo de trabajo autónomo grande | 1M | 3M | 200K | $0.3150 |
Calculos ilustrativos, no facturación observada. Supone que las lecturas en caché califican para la tarifa de caché anunciada; excluye cargos de herramientas, búsqueda, navegador, infraestructura y revisión humana.
Esfuerzo de razonamiento y costo por tarea
El análisis de costos de Automation-Bench de MiniMax conecta el esfuerzo de razonamiento con el éxito en el benchmark y el gasto de inferencia por tarea.
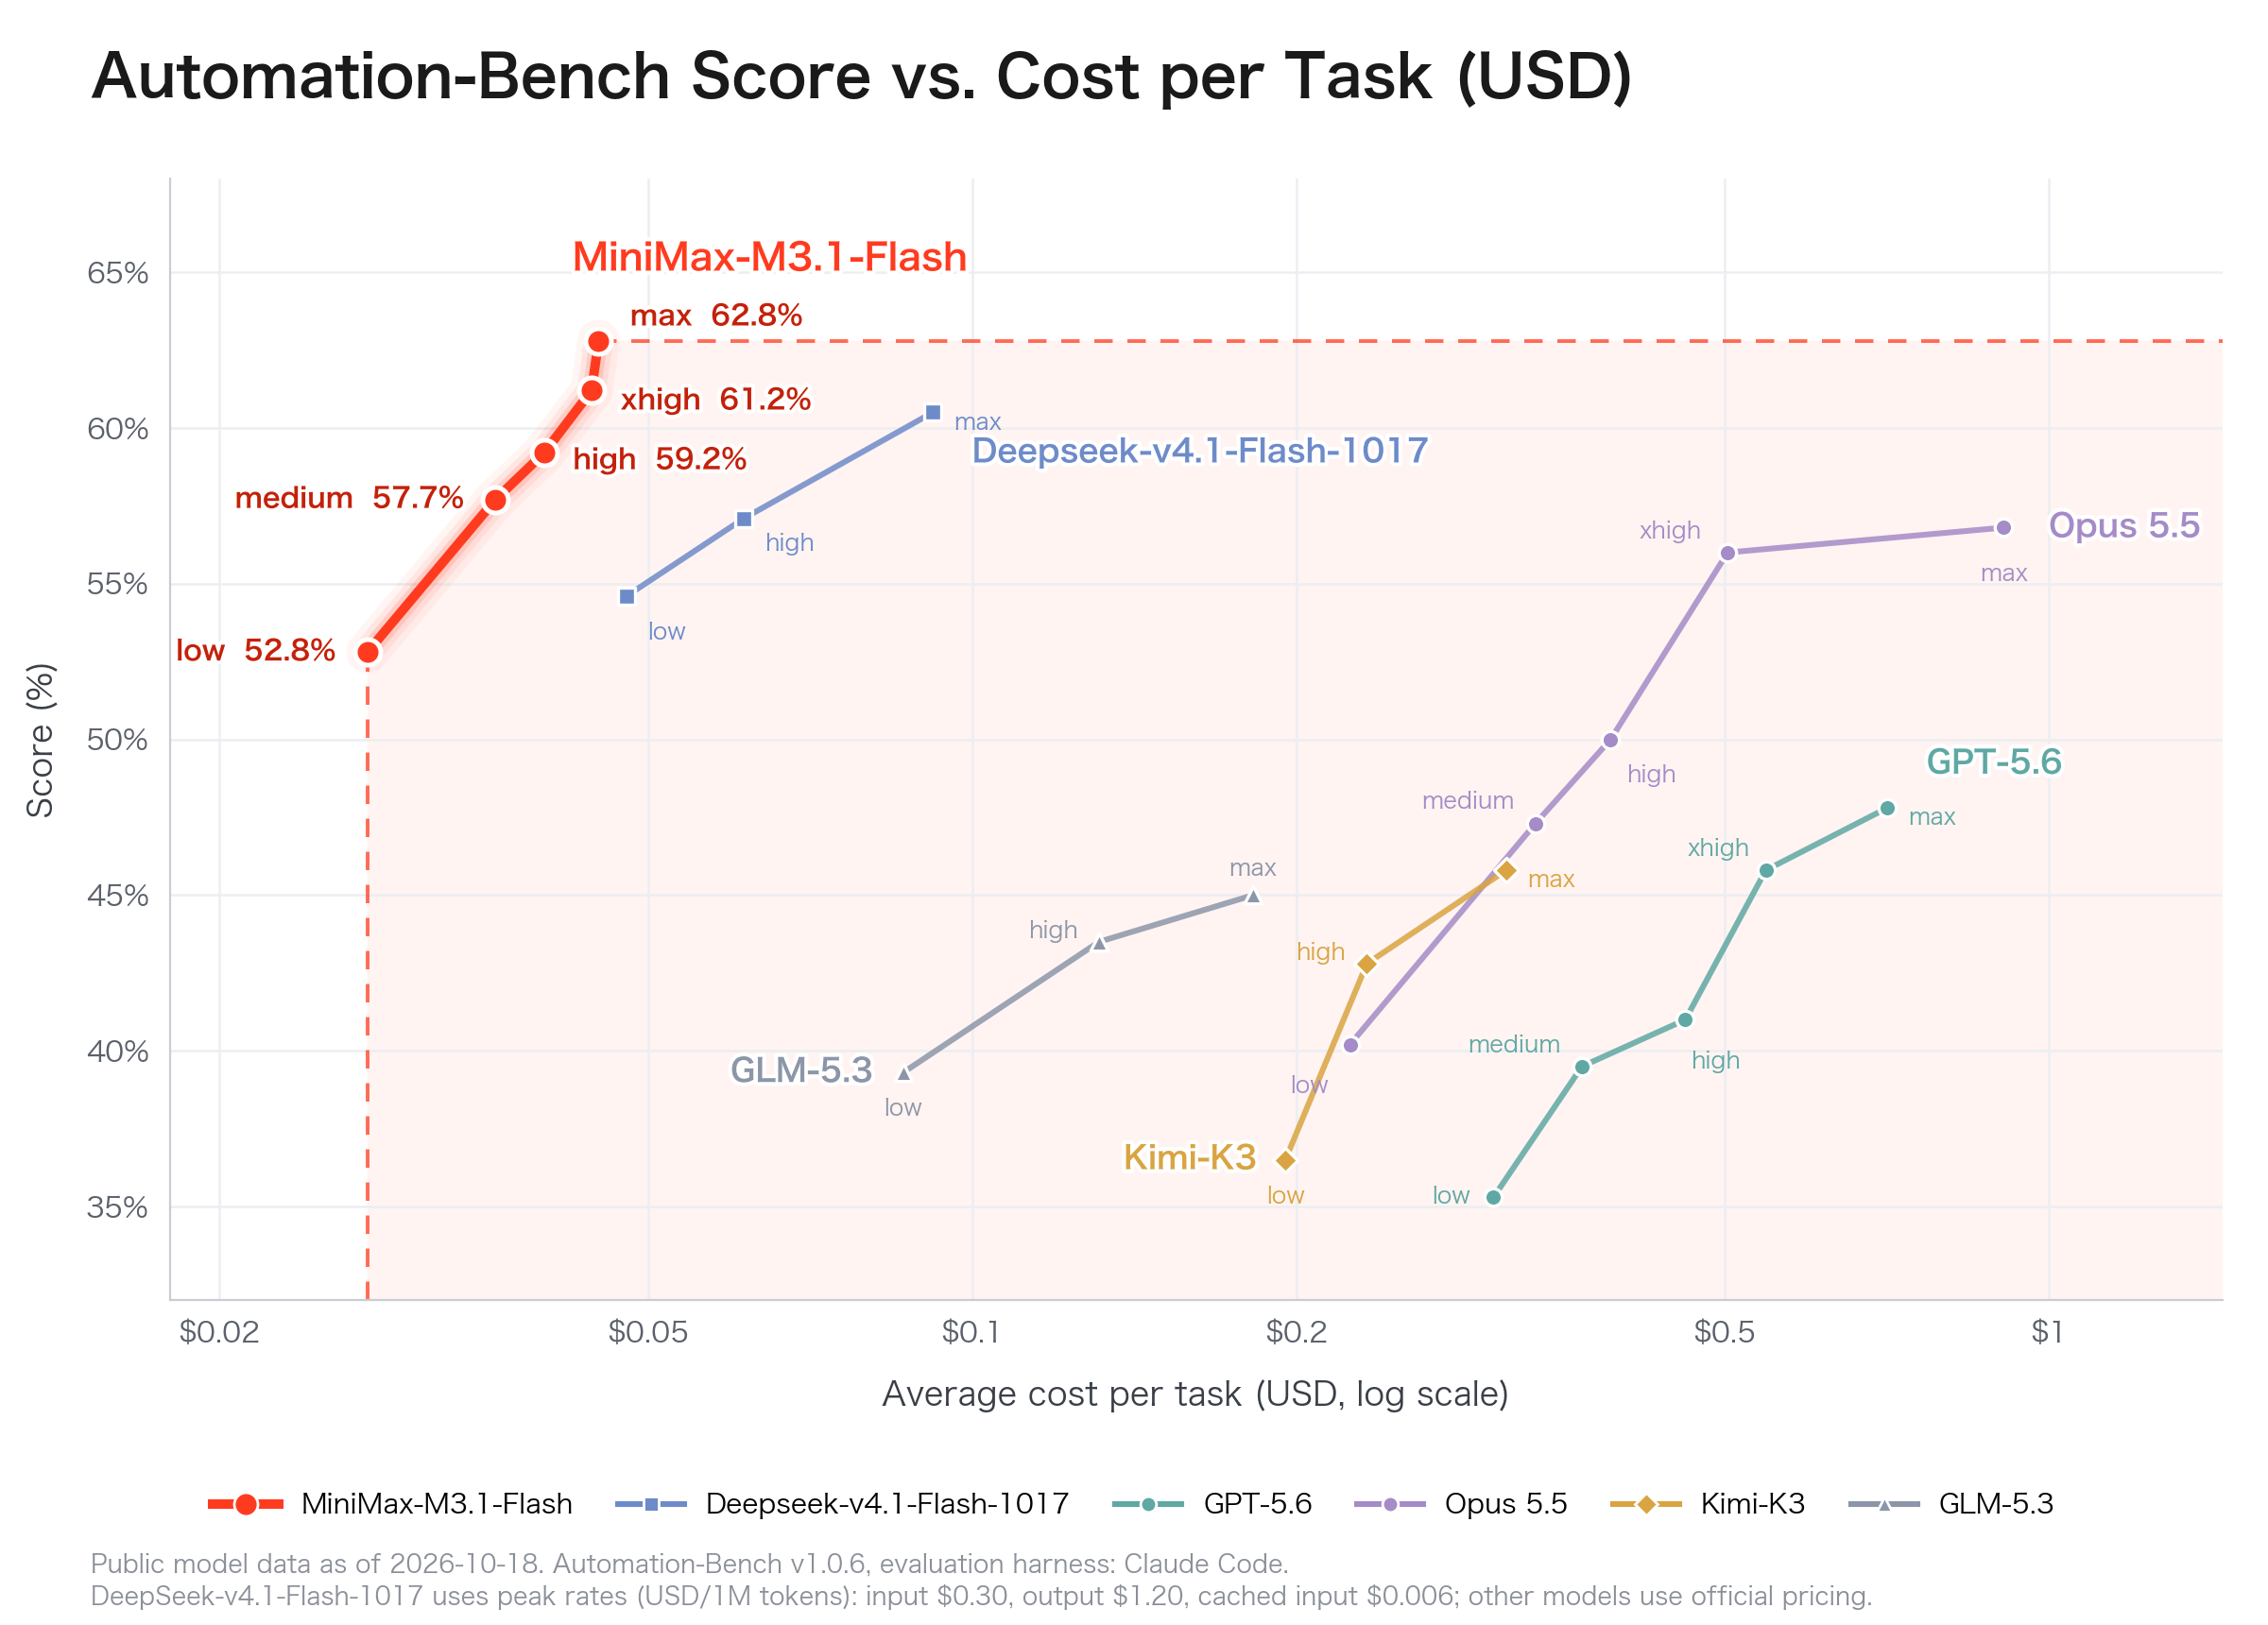
Gráfico oficial de MiniMax de puntuación versus costo en Automation-Bench. El eje horizontal es logarítmico; los costos en dólares exactos no están impresos para los puntos de MiniMax individuales.
Las notas de evaluación del gráfico oficial especifican Automation-Bench v1.0.6 con el arnés Claude Code y datos públicos del modelo al 18 de octubre de 2026. DeepSeek usa tarifas máximas de tokens; los otros modelos usan precios oficiales. Los detalles de hardware y los intervalos de confianza de ejecuciones repetidas no están especificados.
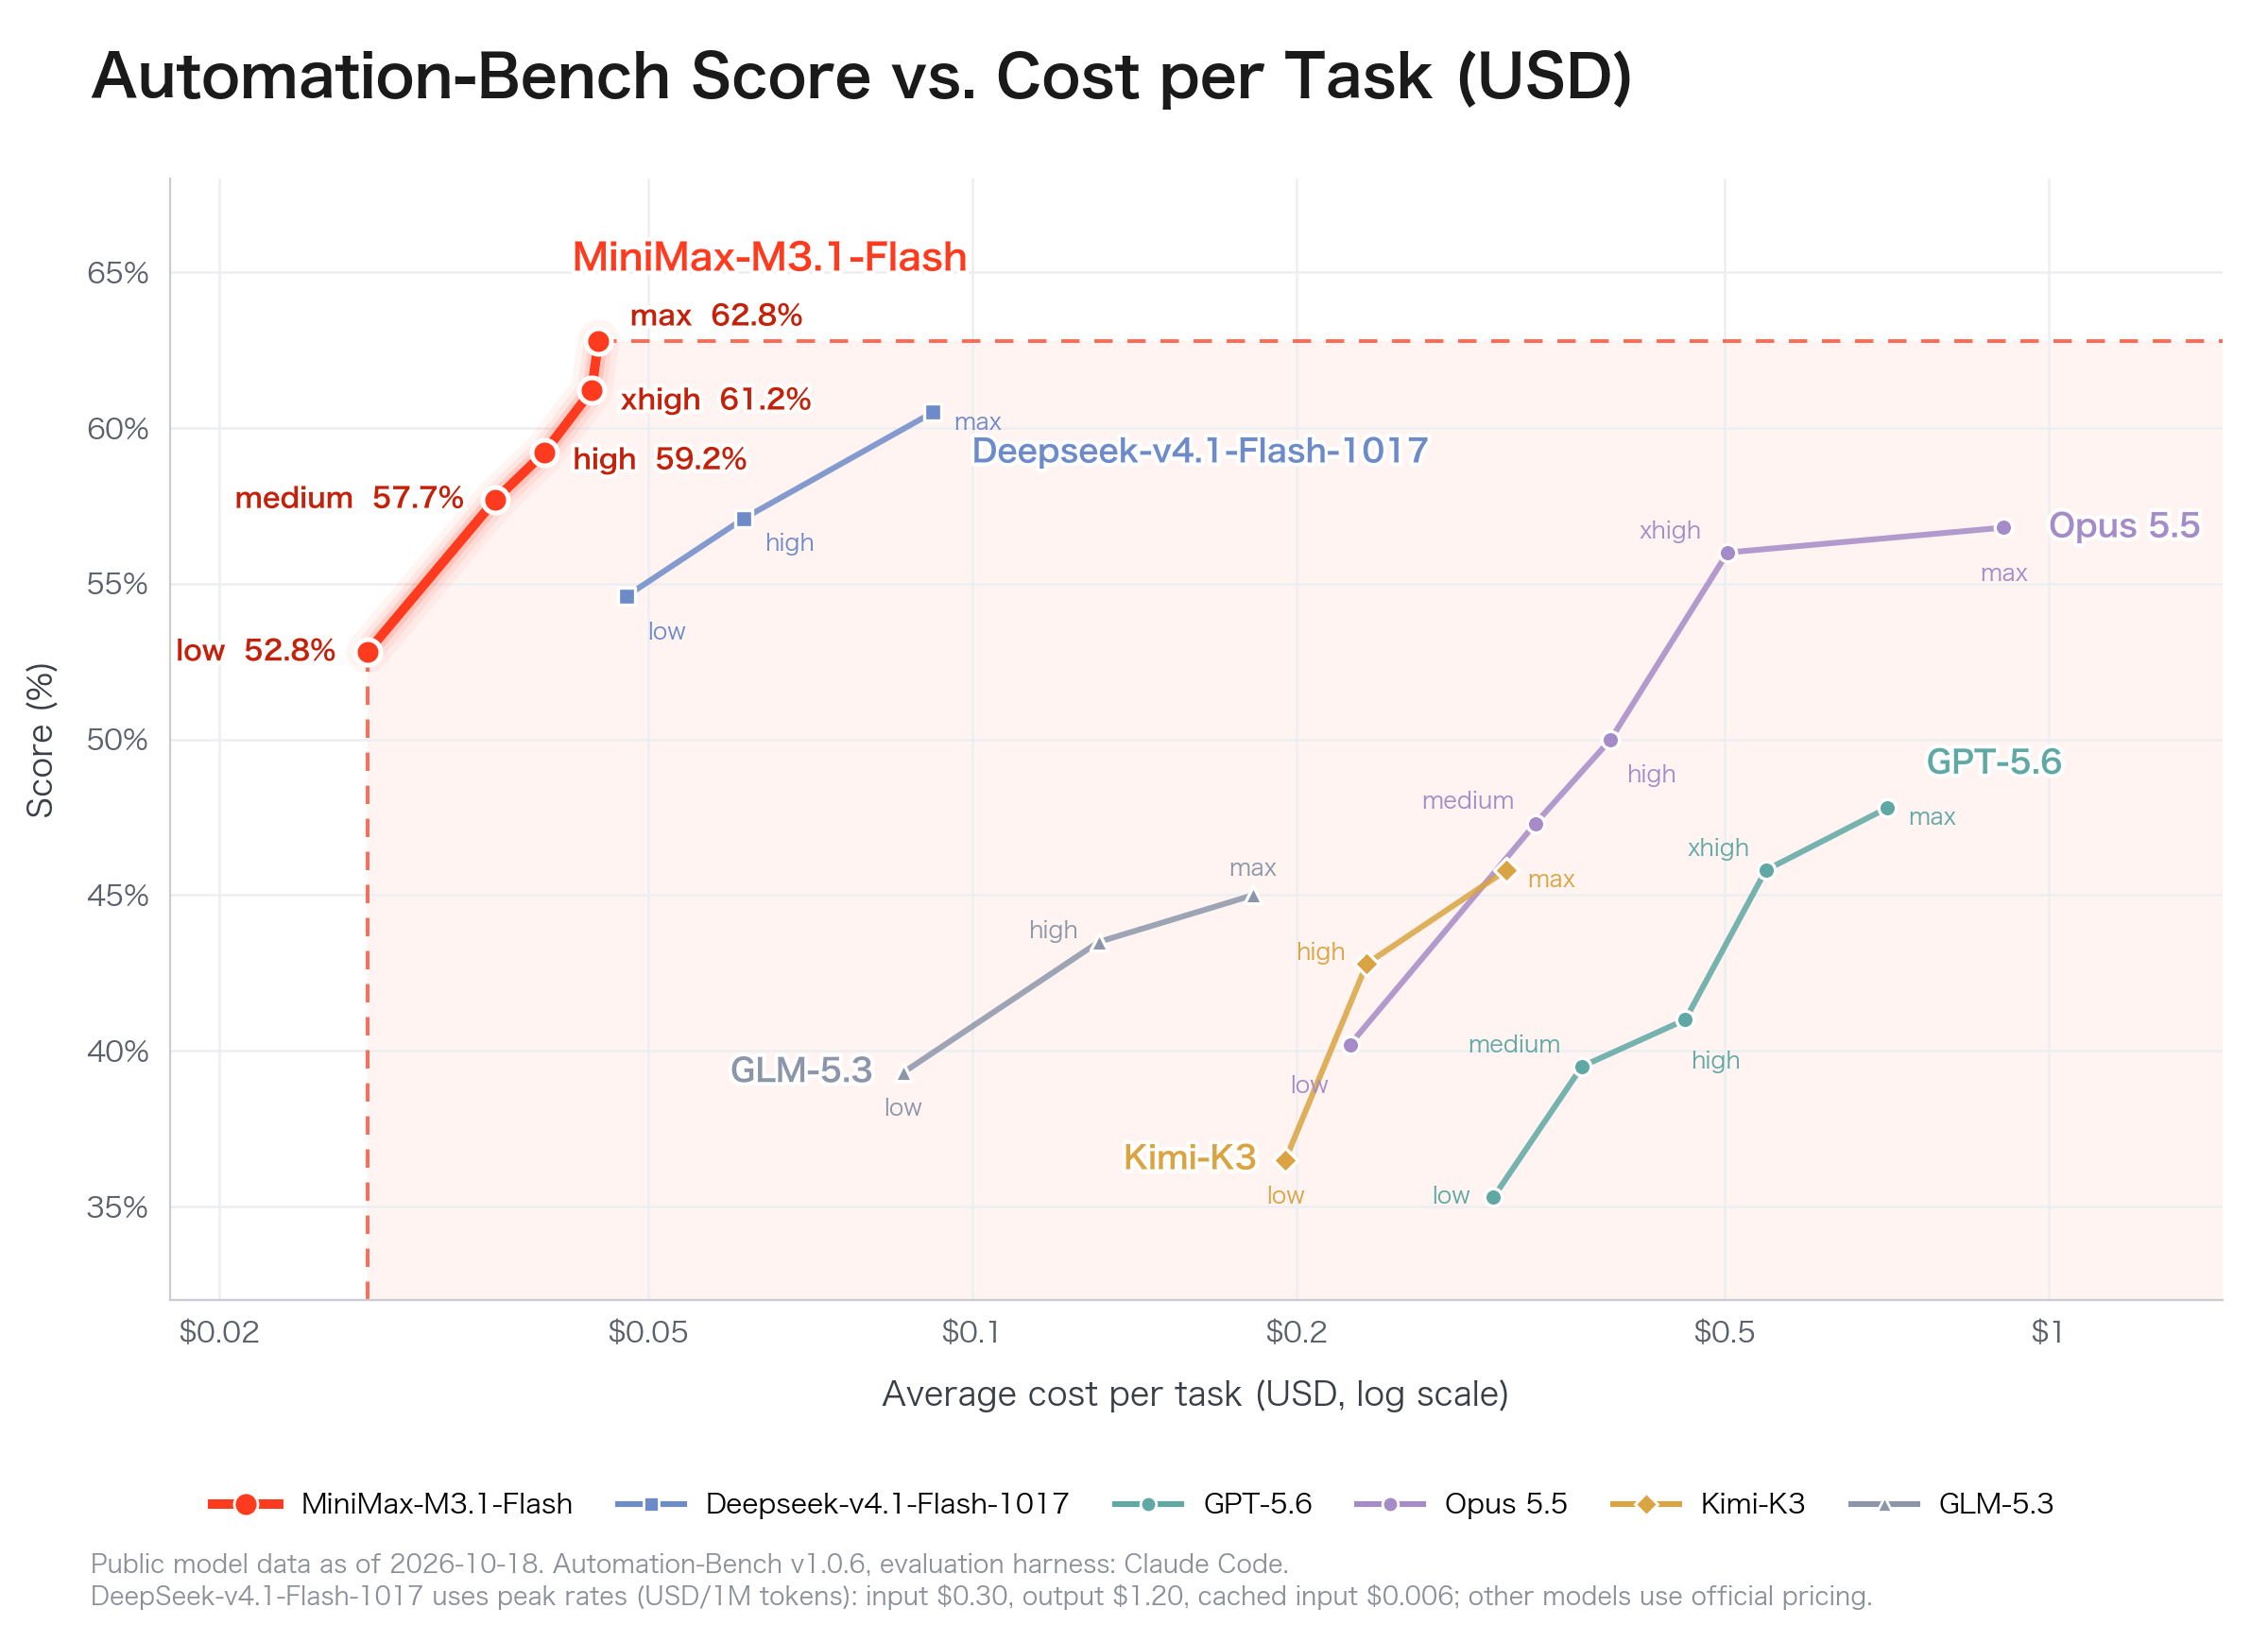
| Esfuerzo de razonamiento | Puntaje etiquetado en Automation-Bench |
|---|---|
| Low | 52.8% |
| Medium | 57.7% |
| High | 59.2% |
| Xhigh | 61.2% |
| Max | 62.8% |
La tabla de comparación oficial actual y el punto de esfuerzo máximo muestran ambos 62.8. La curva de costo compara configuraciones de esfuerzo dentro del entorno del proveedor; no establece un costo en dólares fijo para un agente en producción.
La puntuación etiquetada sube 10 puntos porcentuales de low a max. Para el despliegue, compare esfuerzo medio y superior en un conjunto de tareas fijo, contabilizando intentos fallidos y reintentos en el gasto total. Elija la configuración que cumpla el objetivo de calidad al menor costo medido por tarea aceptada.
¿Cómo pueden los desarrolladores acceder a MiniMax M3.1 Flash a través de CometAPI?
Los desarrolladores pueden acceder a la API de MiniMax M3.1 Flash en CometAPI. El catálogo público consultado el 20 de octubre de 2026 muestra el ID de modelo minimax-m3.1-flash aunque su URL mantiene un sufijo de preview. Use el ID de modelo disponible para su cuenta, en lugar de derivar un identificador de API de la URL de la página.
Envíe una solicitud POST a https://api.cometapi.com/v1/chat/completions con Authorization: Bearer YOUR_COMETAPI_KEY y Content-Type: application/json. En el cuerpo JSON, establezca model en minimax-m3.1-flash (si está habilitado para su cuenta) y proporcione un arreglo messages. Consulte la documentación de CometAPI para detalles de la solicitud.
¿Por qué usar CometAPI? Su clave de API unificada, formato de solicitud compatible y tablero de uso pueden simplificar el trabajo entre proveedores de modelos. Para MiniMax M3.1 Flash, sopese esa conveniencia de integración frente a los precios específicos del proveedor anteriores y verifique las funciones disponibles para su cuenta.
¿Qué agentes de IA se benefician más de MiniMax M3.1 Flash?
| Caso de uso | Por qué puede encajar | Consideración de despliegue |
|---|---|---|
| Automatización empresarial | Resultados sólidos en Automation-Bench | Validar herramientas y reintentos |
| Asistentes de codificación | Rendimiento competitivo en DeepSWE | Ejecutar pruebas y revisar parches |
| Soporte al cliente | Precios bajos de entrada y caché | Monitorear exactitud |
| Agentes de investigación | Ventana de contexto de 1M | Comprobar evidencias y fuentes |
| Agentes de uso de computadoras | Capacidad en OSWorld | Manejar cambios de UI y recuperación |
| Revisión de código de seguridad | Resultado en CyberGym | Verificación independiente |
Los beneficios son más fuertes cuando un agente completa suficientes tareas correctamente para compensar los costos de reintento, orquestación y revisión. El uso en producción debe medir tanto el rendimiento a nivel de modelo como a nivel de flujo de trabajo.
¿Es MiniMax M3.1 Flash la mejor relación costo-beneficio para agentes de IA?
MiniMax M3.1 Flash es una opción sólida para agentes sensibles al costo que implican contexto repetido y herramientas estructuradas, pero el precio de token más bajo no siempre produce el menor costo por tarea exitosa. Llamadas fallidas, reintentos adicionales y la intervención humana pueden borrar los ahorros. Evalúe la tasa de finalización aceptada, el tiempo de extremo a extremo, el costo total por tarea exitosa y la tasa de intervención humana.
Preguntas frecuentes
¿Por qué MiniMax M3.1 Flash puede devolver una respuesta vacía?
En el API nativo compatible con OpenAI de MiniMax, los tokens de pensamiento consumen el presupuesto de generación. Un límite demasiado pequeño puede terminar una solicitud con finish_reason establecido en length antes de que se produzca texto de respuesta visible. Inspeccione el motivo de finalización y el uso de tokens, aumente el presupuesto de finalización cuando corresponda y maneje reasoning_content por separado de la respuesta final. Confirme la misma semántica de respuesta en una ruta de terceros.
¿Cómo se debe almacenar el historial de llamadas a herramientas de MiniMax M3.1 Flash?
Conserve el mensaje completo del asistente, incluidas las llamadas a herramientas y el contenido de razonamiento, antes de anexar los resultados de las herramientas correspondientes. Guardar solo la respuesta visible puede eliminar información necesaria para el siguiente paso. Mantenga los IDs de llamadas a herramientas y el orden de los mensajes, y valide el comportamiento de reproducción usando el endpoint real del proveedor. La guía sobre historial de conversación de MiniMax describe los requisitos del API nativo.
¿Cómo pueden los equipos detectar cambios de enrutamiento de MiniMax M3.1 Flash?
Mantenga un pequeño conjunto de regresión con entradas fijas, estructura de salida esperada y aserciones de llamadas a herramientas. Registre el ID de modelo solicitado, el identificador de modelo devuelto cuando esté presente, el proveedor, la marca de tiempo y el uso facturado. Vuelva a ejecutarlo después de actualizaciones del proveedor; un alias estable por sí solo no demuestra que el checkpoint subyacente o el comportamiento no hayan cambiado.
¿Cómo se debe planificar una migración a MiniMax M3.1 Flash?
Comience con tareas de solo lectura o reproducidas y luego enrute una pequeña parte del tráfico en vivo mientras mantiene un fallback probado. Defina umbrales de reversión para llamadas a herramientas inválidas, timeouts y tareas no exitosas antes de aumentar el tráfico. Revise ejemplos de regresiones en lugar de confiar únicamente en puntuaciones promedio, porque un pequeño número de fallas costosas puede superar precios de tokens más bajos.
Conclusión
MiniMax M3.1 Flash mejora la economía de los agentes de IA autónomos mediante tokens económicos, razonamiento configurable, una gran ventana de contexto y sólidos resultados reportados en automatización y codificación. Su ventaja clave es el equilibrio entre rendimiento, latencia y costo por tarea, no la superioridad absoluta en cada benchmark.
Los desarrolladores deben validar las tasas reales de finalización de flujos de trabajo y los costos totales de los agentes, y luego elegir la ruta de MiniMax M3.1 Flash cuya configuración activa, funciones compatibles y facturación se ajusten a sus requisitos.