
TL;DR MiniMax M4 no ha sido lanzado. MiniMax se ha comprometido públicamente con una nueva generación de sus modelos de la serie M (y Hailuo de video) en la segunda mitad de 2026. El buque insignia actual sigue siendo MiniMax M3 (lanzado el 1 de junio de 2026: ~428B totales / ~23B parámetros activos, contexto de 1M tokens mediante MiniMax Sparse Attention, multimodal nativo, pesos abiertos, 59,0% en SWE-Bench Pro).
Una actualización de eficiencia a media generación, Minimax M3.1 Flash, se lanzó el 19 de octubre de 2026, ofreciendo aproximadamente 3× inferencia más rápida y ~70% menores costos para cargas orientadas a agentes. Los desarrolladores ya pueden acceder a la línea MiniMax en vivo (incluyendo M3 y M3.1 Flash) a través de gateways unificados como CometAPI para enrutamiento, monitoreo y control de costos simplificados.
Puntos clave
- MiniMax M4 no está lanzado a 20 de octubre de 2026. La compañía solo se ha comprometido con “una nueva generación de modelos de la serie M y Hailuo en la segunda mitad de 2026”.
- Modelos de producción actuales: MiniMax M3 (1 de junio de 2026) y el M3.1 Flash centrado en eficiencia (19 de octubre de 2026).
- M3 introdujo MSA (MiniMax Sparse Attention), habilitando un contexto práctico de 1M tokens, comprensión nativa de imagen/video, fuertes resultados en codificación/agentes y pesos abiertos.
- M3.1 Flash prioriza velocidad y costo (se afirma ~3× de aceleración de inferencia y 70% menos costos de agentes) manteniendo el contexto de 1M y entradas multimodales; se esperan pesos abiertos poco después del lanzamiento.
- Un informe de julio de 2026 describió un esfuerzo interno de ~2,7 billones de parámetros (llamado internamente M3 Pro) con posible liberación de pesos abiertos tan pronto como en el Q3 2026; esto no se ha materializado públicamente y es distinto del compromiso más amplio de “nueva generación”.
- Mejoras esperadas en M4 (especulativas, basadas en la trayectoria): más avances en codificación/agentes, eficiencia refinada en largo contexto, capacidades multimodales o de uso de ordenador más fuertes y precios agresivos continuados.
- Recomendación de acceso: Utilice un gateway multiproveedor como CometAPI para enrutar tráfico entre MiniMax M3/M3.1 Flash (y el futuro M4) junto con otros modelos de vanguardia con facturación unificada, observabilidad y lógica de fallback.
¿Realmente llegará pronto MiniMax M4?
Información confirmada
La cuestión principal no es si MiniMax está desarrollando futuros sistemas de IA, sino si hay evidencia concreta de que un modelo llamado MiniMax M4 está próximo a su lanzamiento.
MiniMax lanzó M3 en junio de 2026 y lanzó formalmente M3.1 Flash el 19 de octubre de 2026. Este es un lanzamiento intermedio confirmado, no una prueba de un calendario de M4. Anuncio oficial de lanzamiento.
El archivo oficial de investigación ahora incluye M3.1 Flash. No se encontró ningún anuncio de lanzamiento de M4 en las fuentes oficiales revisadas el 20 de octubre de 2026.
| Categoría de evidencia | Hallazgo | Evaluación |
|---|---|---|
| Anuncio oficial de M4 | No verificado | No confirmado |
| Identificador público de M4 | No verificado | No confirmado |
| Captura filtrada de benchmarks de M4 | No se encontró evidencia verificada independientemente | No confirmado |
| Endpoint de API de M4 | No verificado | No confirmado |
| Precio de M4 | No publicado | Desconocido |
| Pesos del modelo M4 | No verificado | Desconocido |
| Lanzamiento de MiniMax M3 | 1 de junio de 2026 | Confirmado |
| Lanzamiento de M3.1 Flash | Lanzado el 19 de octubre de 2026; disponible a través de MiniMax API, M Plan y MiniMax Code | Confirmado |
Informes de la comunidad / Filtraciones
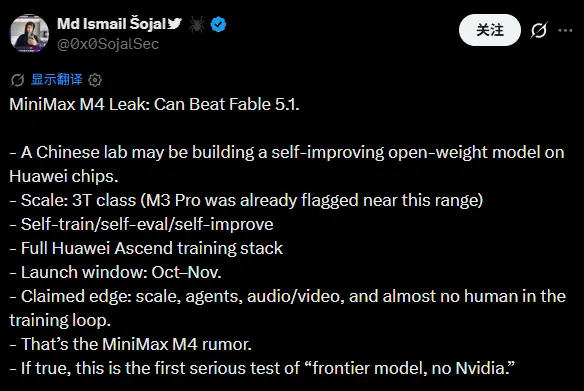
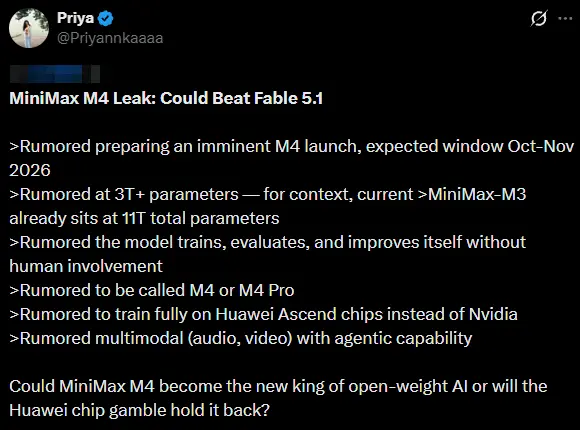
Dos publicaciones en X fechadas el 27 de septiembre de 2026 hablan de un posible lanzamiento de M4. Establecen que estos reclamos circulaban en la comunidad, no que MiniMax los haya confirmado. Ambos se tratan aquí como informes comunitarios no verificados; el distintivo de verificación de pago de los autores no establece la exactitud de las afirmaciones.
En una publicación de @0x0SojalSec, el autor sugiere un modelo de aproximadamente tres billones de parámetros, una liberación de pesos abiertos y entrenamiento en hardware Huawei Ascend. El fragmento legible también describe un bucle en el que el modelo participa en su propio entrenamiento y evaluación. Estas son afirmaciones del autor, no especificaciones verificadas de M4.
Una publicación de Priya (@Priyannkaaaa)sugiere un posible lanzamiento en octubre-noviembre de 2026 y un conteo de parámetros superior a tres billones. También hace una afirmación no verificada sobre el tamaño del modelo M3 anterior. Esa comparación no se adopta como línea base factual en este artículo.
¿Cuándo podría lanzarse MiniMax M4?
Modelos anteriores siguen siendo puntos de referencia útiles, incluyendo MiniMax M2.5 API en CometAPI. Sus fechas establecen el historial, no un pronóstico del próximo lanzamiento.
MiniMax no ha confirmado una fecha de lanzamiento para M4. La ventana de octubre-noviembre de 2026 mencionada en la publicación comunitaria de Priya es un rumor, no un calendario oficial; el fragmento subyacente y sus limitaciones se discuten en Informes de la comunidad / Filtraciones. El historial de lanzamientos de la familia de modelos muestra tanto generaciones principales como versiones intermedias, pero los intervalos de lanzamientos pasados no pueden predecir de forma fiable el próximo lanzamiento.
| Hito | Calendario de lanzamiento oficial | Significado |
|---|---|---|
| MiniMax M2.5 | 12 de febrero de 2026 | Codificación y productividad |
| MiniMax M2.7 | 18 de marzo de 2026 | Mejoras en flujos de trabajo de agentes |
| MiniMax M3 | 1 de junio de 2026 | Contexto de 1M y multimodalidad |
| M3.1 Flash | 19 de octubre de 2026 — lanzamiento oficial | Se lanzó un modelo de codificación y agentes enfocado en eficiencia |
| MiniMax M4 | No anunciado | Sin cronograma verificado |
Un anuncio formal de producto de MiniMax sería la señal más fuerte. La documentación de API o un identificador de modelo autenticado proporcionarían soporte adicional. Resultados de benchmarks y fichas públicas del modelo permitirían evaluar mejoras técnicas, mientras que precios oficiales y límites de tasa determinarían la viabilidad en producción.
Precio de MiniMax M4 — Lo que sugieren las filtraciones y generaciones previas
No existe un precio oficial para M4. Todas las cifras a continuación son extrapolaciones de las tarifas vigentes de M3 y M3.1 Flash (USD, por millón de tokens, aproximadas a mediados de octubre de 2026):
| Modelo | Entrada / 1M | Salida / 1M | Entrada en caché | Contexto | Notas |
|---|---|---|---|---|---|
| MiniMax M3 | $0.30 | $1.20 | ~$0.06 | 1M | Precio de lista con “50% permanente de descuento”; nivel superior para >512k de contexto |
| MiniMax M3.1 Flash | $0.15 | $0.60 | $0.015 | 1M | ~50% más barato que M3; optimizado para rendimiento de agentes |
| Rango esperado para M4 (especulativo) | $0.20–$0.40 | $0.80–$1.50 | Estructura de descuento similar | 1M+ | Probablemente se mantenga entre las ofertas abiertas de frontera más baratas |
Fuentes para precios actuales: documentación de la plataforma MiniMax, agregadores independientes y anuncios de lanzamiento.
MiniMax ha posicionado repetidamente sus modelos a una fracción del costo de los principales modelos cerrados occidentales, igualándolos o superándolos en benchmarks seleccionados de codificación y agentes. Se esperaría que un M4 completo continúe esta estrategia, con posibles niveles premium para contexto extendido, latencia prioritaria o mayor esfuerzo de razonamiento.
Recomendación de CometAPI: En lugar de gestionar múltiples claves de API y tablas de tarifas de MiniMax directamente, enrute mediante un gateway unificado como CometAPI. Esto permite conmutación fluida entre M3, M3.1 Flash y (cuando esté disponible) M4, fallbacks automáticos, analíticas de uso y a menudo mejor precio efectivo vía agregación de volumen—especialmente valioso para cargas orientadas a agentes que consumen grandes cantidades de tokens.
Lo que MiniMax M3.1 Flash revela sobre la próxima generación
MiniMax M3.1 Flash proporciona un punto de referencia más actual para evaluar lo que podría ofrecer un futuro modelo MiniMax M4. Presentado oficialmente el 19 de octubre de 2026, M3.1 Flash se centra en flujos de trabajo de agentes, desarrollo de software, uso de ordenador y ciberseguridad, enfatizando inferencia más rápida y menores costos de uso. Estas mejoras ofrecen pistas útiles sobre las prioridades de ingeniería actuales de MiniMax, aunque no establecen una fecha de lanzamiento de M4 ni confirman sus futuras especificaciones.
1. La fiabilidad del agente está volviéndose tan importante como la inteligencia bruta
Uno de los temas más claros en el anuncio de M3.1 Flash es el énfasis en completar tareas complejas y de múltiples pasos. MiniMax reporta mejoras en flujos de trabajo orientados a agentes, codificación, uso de ordenador y automatización empresarial.
Esta dirección sugiere que la próxima generación de modelos puede ser juzgada menos por el rendimiento en preguntas y respuestas aisladas y más por su capacidad para completar flujos de trabajo enteros de forma fiable.
Por ejemplo, un agente de ingeniería de software puede necesitar inspeccionar un repositorio, identificar un defecto, modificar varios archivos, ejecutar pruebas, diagnosticar fallos y verificar el parche final. El éxito depende no solo de la calidad del razonamiento, sino también de la selección de herramientas, el seguimiento de estado, la recuperación de errores y la consistencia a lo largo de múltiples pasos.
Un futuro modelo M4 podría construir sobre esta dirección mejorando la planificación de horizonte largo, reduciendo llamadas a herramientas innecesarias y recuperándose con más eficacia de acciones fallidas. Estos son objetivos de evaluación razonables, no características confirmadas de M4.
2. La eficiencia de inferencia podría convertirse en una ventaja competitiva clave
MiniMax reporta que M3.1 Flash ofrece casi tres veces la velocidad de inferencia en línea de su predecesor y reduce los costos de uso en un 70% para tareas orientadas a agentes. La compañía también atribuye sus mejoras de eficiencia a una esparsidad más agresiva.
Estas afirmaciones resaltan una distinción importante entre la inteligencia del modelo y la eficiencia operativa práctica. Un modelo que completa una tarea con menos reintentos, menor latencia y menor consumo de tokens puede ser más valioso que un modelo que logra un puntaje de benchmark ligeramente superior pero requiere muchos más recursos.
Para un posible lanzamiento de M4, las preguntas relevantes incluirán si puede sostener alto rendimiento en tareas de larga duración, preservar la calidad de salida bajo presupuestos de inferencia más ajustados y reducir el costo total de completar una tarea con éxito.
Las mejoras reportadas de M3.1 Flash son afirmaciones de la compañía y deben evaluarse independientemente bajo cargas comparables antes de tratarlas como garantías generales de rendimiento.
3. La codificación y el uso de ordenador son áreas a vigilar
El anuncio de M3.1 Flash reporta una puntuación de 73,7% en DeepSWE v1.1, 61,7 en OSWorld V2 y 82% en CyberGym. Estos resultados cubren diferentes aspectos de ingeniería de software, interacción con ordenador y ciberseguridad, respectivamente.
En conjunto, proporcionan un punto de partida más útil para evaluar modelos futuros que un único benchmark de propósito general.
Si MiniMax introduce M4, los desarrolladores deberían buscar evidencia de que mejora la finalización práctica de tareas en lugar de producir simplemente un puntaje principal más alto. Pruebas útiles podrían incluir corrección de errores a nivel de repositorio, flujos de trabajo entre aplicaciones, automatización de navegador, análisis de vulnerabilidades y recuperación de llamadas de herramientas fallidas.
Las comparaciones de benchmarks deben preservar la versión del conjunto de datos, el entorno de ejecución, el andamiaje del agente, los límites de recursos y la metodología de puntuación. Sin condiciones comparables, las diferencias entre puntajes de modelos pueden no reflejar mejoras reales de capacidad.
4. El contexto largo y el razonamiento multimodal todavía necesitan evaluación práctica
MiniMax M3 ya admite una ventana de contexto de hasta un millón de tokens y entradas multimodales nativas, incluidas imágenes y video. El lanzamiento de M3.1 Flash mantiene una ventana de contexto de un millón de tokens y combina comprensión multimodal con capacidades más fuertes orientadas a agentes.
Esto significa que una ventana de contexto más grande por sí sola no sería necesariamente una razón convincente para actualizar a M4.
Avances más significativos podrían incluir mejor recuperación desde repositorios grandes, mayor consistencia en documentos extensos, interpretación más precisa de evidencia visual y coordinación más fiable entre percepción y ejecución de herramientas.
Por ejemplo, un agente de desarrollo podría necesitar inspeccionar una grabación de pantalla, identificar una falla de interfaz de usuario, rastrear el código de la aplicación relevante, implementar una corrección y verificar el resultado. La calidad del flujo de trabajo completo importa más que la capacidad del modelo para procesar una gran entrada de forma aislada.
Estos escenarios representan posibles prioridades de evaluación para M4, no capacidades que MiniMax haya anunciado.
5. Las futuras versiones de modelos pueden evaluarse por costo por tarea completada
El anuncio de M3.1 Flash refuerza la importancia de evaluar la economía del modelo a nivel de flujo de trabajo. Los precios por token no capturan el costo total de usar un agente.
Una comparación más útil considera la probabilidad de completar una tarea con éxito, el número de intentos requeridos, el consumo de tokens, los costos de herramientas, la latencia y la intervención humana.
Los desarrolladores que se preparan para un futuro M4 deberían establecer una línea base con los modelos disponibles actualmente y usar el mismo conjunto de tareas para comparar lanzamientos posteriores. Esto permite determinar si un nuevo modelo aporta mejoras significativas en productividad en lugar de simplemente cambiar los rankings de benchmarks.
¿Qué tan sólidos son los benchmarks de MiniMax M3 y qué necesitaría superar M4?
MiniMax publicó un conjunto sustancial de resultados de benchmarks para M3, proporcionando objetivos medibles para un modelo futuro. Los siguientes valores son resultados reportados de M3, no predicciones de M4.
| Referencia | Puntuación reportada de MiniMax M3 | Qué evalúa | Objetivo de verificación para M4 |
|---|---|---|---|
| SWE-Bench Pro | 59,0% | Ingeniería de software del mundo real | Mayor resolución verificada de tareas |
| Terminal-Bench 2.1 | 66,0% | Ejecución de agentes basada en terminal | Más operaciones de extremo a extremo exitosas |
| SWE-fficiency | 34,8% | Eficiencia en tareas de codificación | Mejor rendimiento bajo presupuestos comparables |
| KernelBench Hard | 28,8% | Optimización de kernels GPU | Kernels más correctos y rápidos |
| MCP Atlas | 74,2% | Tareas orientadas a herramientas y MCP | Mejor selección y ejecución de herramientas |
Estos son resultados reportados por el proveedor en el anuncio del 1 de junio de 2026, no replicaciones independientes. Las suites miden resultados distintos, por lo que sus porcentajes no deben promediarse en una única puntuación de precisión.
Rendimiento en codificación e ingeniería de software
Lo que tenemos confirmado (M3)
- SWE-Bench Pro: 59,0%
- Terminal-Bench 2.1: 66,0%
- Resultados sólidos en tareas reales de corrección de errores, desarrollo frontend/backend y optimización de kernels (evaluaciones internas de MiniMax mostraron iteración autónoma de varias horas).
Lo que aporta M3.1 Flash: Afirmaciones de nuevas ganancias en benchmarks de codificación, agentes y ciberseguridad, además de un aumento dramático en tokens por segundo y menor costo por trayectoria de agente completada.
Lo que sigue sin confirmarse / esperado para M4: Puntajes absolutos más altos en benchmarks estilo SWE-Bench y de codificación interactiva multi-turno, mejor gestión de proyectos de horizonte largo y mayor capacidad para mantener consistencia en sesiones de múltiples archivos y varios días. Cualquier modelo de escala 2,7T (si se lanza) se esperaría que eleve aún más el techo de capacidad, aunque el conteo de parámetros activos y la esparsidad determinarán el costo en el mundo real.
Eficiencia de contexto largo y arquitectura
Confirmado: M3 introdujo MSA (MiniMax Sparse Attention), ofreciendo un contexto práctico de 1M tokens con un coste por token de 1/20 respecto a la generación previa de atención densa, >9× en pre-llenado y >15× en decodificación a longitudes extremas, igualando la atención completa en la mayoría de capacidades.
Mejoras esperadas: Refinamientos en patrones de esparsidad, mejor soporte para contextos aún más largos o recuperación más densa dentro de la ventana, menor huella de memoria para autoalojamiento y manejo mejorado de documentos multimodales largos intercalados.
Capacidades multimodales y de uso de ordenador
Confirmado: Comprensión nativa de imagen y video desde las primeras etapas de entrenamiento, además de uso de ordenador (operación de escritorio) demostrado en MiniMax Code y arneses de agentes.
Esperado para M4: Integración más estrecha del entendimiento de video con la planificación del agente, pipelines más sólidos de documento/captura de pantalla a código, y control de ordenador multiaplicación más fiable en horizontes más largos.
Flujos de trabajo orientados a agentes, uso de herramientas y automejora
Confirmado: M2.7 ya experimentó con bucles de automejora recursivos. M3 y M3.1 Flash enfatizan colaboración multiagente, búsqueda dinámica de herramientas, tareas autónomas de larga duración y bucles productor-verificador dentro de MiniMax Code.
Esperado: Equipos de agentes multidiarios más robustos, mejor recuperación ante fallas de herramientas, soporte nativo para ecosistemas de herramientas más grandes y posiblemente técnicas continuadas de automejora o búsqueda evolutiva a mayor escala.
Precio de MiniMax M4 — Lo que sugieren las filtraciones y generaciones previas
No existe un precio oficial para M4. Todas las cifras a continuación son extrapolaciones de las tarifas vigentes de M3 y M3.1 Flash (USD, por millón de tokens, aproximadas a mediados de octubre de 2026):
| Modelo | Entrada / 1M | Salida / 1M | Entrada en caché | Contexto | Notas |
|---|---|---|---|---|---|
| MiniMax M3 | $0.30 | $1.20 | ~$0.06 | 1M | Precio de lista con “50% permanente de descuento”; nivel superior para >512k de contexto |
| MiniMax M3.1 Flash | $0.15 | $0.60 | $0.015 | 1M | ~50% más barato que M3; optimizado para rendimiento de agentes |
| Rango esperado para M4 (especulativo) | $0.20–$0.40 | $0.80–$1.50 | Estructura de descuento similar | 1M+ | Probablemente se mantenga entre las ofertas abiertas de frontera más baratas |
MiniMax ha posicionado repetidamente sus modelos a una fracción del costo de los principales modelos cerrados occidentales, igualándolos o superándolos en benchmarks seleccionados de codificación y agentes. Se esperaría que un M4 completo continúe esta estrategia, con posibles niveles premium para contexto extendido, latencia prioritaria o mayor esfuerzo de razonamiento.
Recomendación de CometAPI: En lugar de gestionar múltiples claves de API y tablas de tarifas de MiniMax directamente, enrute mediante un gateway unificado como CometAPI. Esto permite conmutación fluida entre M3, M3.1 Flash y (cuando esté disponible) M4, fallbacks automáticos, analíticas de uso y a menudo mejor precio efectivo vía agregación de volumen—especialmente valioso para cargas orientadas a agentes que consumen grandes cantidades de tokens.
MiniMax M3 vs M3.1 Flash vs Dirección esperada de M4
| Dimensión | M3 API en CometAPI (jun 2026) | MiniMax M3.1 Flash (oct 2026) | Dirección esperada de M4 (H2 2026+) |
|---|---|---|---|
| Estado | En producción, pesos abiertos | En producción, pesos inminentes | No lanzado |
| Parámetros (aprox.) | 428B totales / ~23B activos | Escala similar | Desconocido (posible MoE más grande) |
| Contexto | 1M tokens (MSA) | 1M tokens | 1M+ con mayor eficiencia |
| Codificación (SWE-Bench Pro) | 59,0% | Mejoras adicionales afirmadas | Se esperan puntajes absolutos más altos |
| Velocidad de inferencia | Línea base sólida | ~3× más rápido (afirmado) | Optimización adicional |
| Costo de agentes | Competitivo | ~70% menor (afirmado) | Precios agresivos continuados |
| Multimodal | Imagen + video nativos | Igual + refinado | Integración más profunda |
| Pesos abiertos | Sí | Planeados pronto | Muy probable |
| Precio API (entrada/salida) | $0.30 / $1.20 | $0.15 / $0.60 | Se espera $0.20–0.40 / $0.80–1.50 |
Selección de modelo según el flujo de trabajo del desarrollador
Use el M3.1 Flash lanzado como candidato de evaluación actual y mantenga M3 y cualquier flujo de trabajo establecido en M2.7 para comparación. Mida la tasa de tareas aceptadas, reintentos, intervenciones humanas y costo total en la misma carga de trabajo. Ajuste el esfuerzo deliberadamente en lugar de asumir que la “máxima reflexión” es siempre el mejor punto operativo.
M4 aún no es una elección de producción accionable. La preparación más útil es construir un conjunto de benchmarks reproducible con los modelos existentes para que un futuro lanzamiento pueda evaluarse rápidamente.
Cómo acceder a los modelos actuales de MiniMax (y prepararse para M4)
Mientras espera M4, el camino práctico es usar los modelos en vivo:
- Obtenga una clave de API de MiniMax en la plataforma oficial.
- O, para fiabilidad en producción, enrute mediante un gateway multimodelo como CometAPI. CometAPI proporciona un único endpoint y clave que puede apuntar a MiniMax M3, M3.1 Flash y otros proveedores, con paneles de uso integrados, gestión de límites de tasa y la capacidad de cambiar de modelo sin cambios de código.
- Para agentes de codificación, combine el modelo con MiniMax Code (escritorio/CLI) o frameworks abiertos que ya soporten endpoints de MiniMax compatibles con Anthropic u OpenAI.
- Supervise los canales oficiales de MiniMax y catálogos de agregadores; en cuanto aparezca un nuevo ID de modelo de la serie M, gateways como CometAPI suelen incorporarlo rápidamente.
Este enfoque minimiza el bloqueo y permite a los equipos evaluar M3 vs M3.1 Flash (y eventualmente M4) en cargas reales con observabilidad consistente.
Conclusión
MiniMax M4 sigue siendo un modelo futuro definido por un compromiso claro pero de alto nivel de la compañía, más que por especificaciones concretas. La generación M3 ya estableció a MiniMax como un contendiente serio con pesos abiertos en codificación, agentes y trabajo multimodal de contexto largo; M3.1 Flash luego empujó la frontera de eficiencia. Sea cual sea la forma que tome la “nueva generación” de H2 2026—ya sea etiquetada M3.5, M4 u otra—heredará una base sólida de atención dispersa, pesos abiertos y precios agresivos.
Para desarrolladores y equipos que construyen agentes de producción hoy, la recomendación accionable es sencilla: integre los modelos MiniMax en vivo (M3 y M3.1 Flash) mediante una capa flexible multiproveedor como CometAPI. Esto ofrece ventajas inmediatas de capacidad y costo al tiempo que le posiciona para adoptar M4 en cuanto aparezca en endpoints públicos—con cambios mínimos de código y visibilidad total del rendimiento y el gasto.