Especificaciones técnicas de MiniMax M3.1-Flash-Preview
| Elemento | MiniMax M3.1-Flash-Preview |
|---|---|
| ID del modelo | MiniMax-M3.1-Flash-Preview |
| Familia de modelos | Serie MiniMax M3.1, modelo de codificación en Preview |
| Estado de lanzamiento | Preview; anunciado el 27 de septiembre de 2026 |
| Enfoque principal | Desarrollo de software cotidiano, desde correcciones de errores hasta trabajo de funcionalidades completas |
| Ventana de contexto | 1,000,000 tokens |
| Modalidades de entrada | Texto, imagen y video |
| Modalidad de salida | Texto |
| Control de razonamiento | reasoning_effort: low, medium, high, xhigh, max |
| Comportamiento de razonamiento | Se requiere pensamiento adaptativo; la documentación pública revisada no admite desactivar el pensamiento |
| Salida máxima | No publicado por separado en los materiales públicos revisados |
| Número de parámetros | No divulgado públicamente |
| Pesos abiertos | No se identificó ningún checkpoint/repositorio de modelos público |
MiniMax anunció M3.1-Flash-Preview para MiniMax Code el 27 de septiembre de 2026, posicionándolo en torno a tareas de desarrollo cotidianas como la corrección de errores y la entrega completa de funcionalidades. La cobertura pública actual identifica de forma consistente una ventana de contexto de 1M tokens y un esfuerzo de razonamiento ajustable, al tiempo que señala que no se han publicado una tabla de benchmark independiente ni el precio por token.
¿Qué es MiniMax M3.1-Flash?
MiniMax M3.1-Flash-Preview es un modelo de texto en Preview orientado a la codificación, diseñado para flujos de trabajo iterativos de desarrollo de software en lugar de solo generación de código. MiniMax describe el flujo de trabajo como abarcando la comprensión de requisitos, la localización del problema, la implementación, las pruebas de regresión y la verificación de cambios frente a la funcionalidad existente.
Sus controles diferenciadores documentados son su contexto extenso y una escalera de cinco niveles de esfuerzo de razonamiento. Los niveles disponibles son low, medium, high, xhigh y max, lo que permite a los desarrolladores intercambiar profundidad de razonamiento y latencia según la complejidad de la tarea.
Características principales de MiniMax M3.1-Flash-Preview
- Contexto de 1M tokens: La descripción publicada del modelo otorga al modelo Preview una ventana de contexto de un millón de tokens, lo que lo hace adecuado para grandes repositorios, especificaciones extensas y sesiones prolongadas de agentes de codificación.
- Entrada multimodal nativa: Las descripciones públicas del modelo enumeran texto, imagen y video como entradas, mientras que el modelo devuelve texto.
- Cinco niveles de esfuerzo de razonamiento:
low,medium,high,xhighymaxproporcionan un control más fino sobre la profundidad de razonamiento que un simple interruptor de pensamiento activado/desactivado. - Flujo de trabajo de codificación de extremo a extremo: MiniMax posiciona específicamente el modelo para la localización de errores, implementación, manejo de casos límite, finalización de pruebas de regresión y validación de cambios.
- Despliegue orientado a Preview: El lanzamiento público inicial es a través de MiniMax Code y Token Plan en lugar de una oferta independiente completamente documentada de pago por uso.
- Adecuación para agentes de codificación: El modelo está pensado para interacciones de desarrollo repetidas donde el contexto del repositorio, la salida de herramientas, las pruebas y las correcciones iterativas importan más que la generación de código de un solo intento.
MiniMax M3.1-Flash-Preview frente a otros modelos de codificación de MiniMax
| Modelo | Enfoque | Contexto | Datos de benchmark públicos | Acceso/estado |
|---|---|---|---|---|
| M3.1-Flash-Preview | Codificación cotidiana, desarrollo iterativo | 1M | Aún no publicados | Preview; MiniMax Code / Token Plan |
| M3 | Codificación de frontera + trabajo con agentes, multimodalidad nativa | Hasta 1M | Publicado por MiniMax | API, Token Plan, MiniMax Code |
| M2.7 | Ingeniería de software + trabajo amplio de agentes/productividad | No se usa aquí como una especificación copiada de M3.1 | Publicado por MiniMax | API, Token Plan, Agent |
M3 es el punto de referencia mejor documentado: MiniMax publica su arquitectura, la metodología de evaluación de codificación/agentes y la disponibilidad de la API. M2.7 también cuenta con un registro público de benchmarks e integración con API. M3.1-Flash-Preview es más reciente y actualmente tiene un alcance de documentación pública más estrecho, por lo que las comparaciones deben centrarse en el posicionamiento documentado en lugar de afirmar un ganador de benchmarks. 4
Casos de uso representativos
- Corrección de errores a escala de repositorio: Proporciona al modelo una gran base de código, descripción del issue, registros y pruebas y usa su largo contexto para preservar el contexto relevante del proyecto.
- Implementación de funcionalidades: Usa el modelo para pasar de un requerimiento en lenguaje natural a cambios de código y pruebas de regresión.
- Revisión y remediación de código: Pídele que identifique casos límite, proponga parches y verifique que los cambios no rompan el comportamiento existente.
- Depuración multimodal: Proporciona capturas de pantalla, diagramas o video junto con requerimientos textuales cuando el contexto visual forma parte del problema de ingeniería.
- Sesiones prolongadas con agentes de codificación: Usa la gran ventana de contexto para especificaciones, archivos del repositorio, salida de terminal y resultados de pruebas iterativas.
- Desarrollo sensible a la velocidad: Selecciona un nivel de esfuerzo de razonamiento inferior para ediciones rutinarias y aumenta el esfuerzo para cambios multietapa más complejos.
Cómo acceder a la API de MiniMax M3.1-Flash-Preview
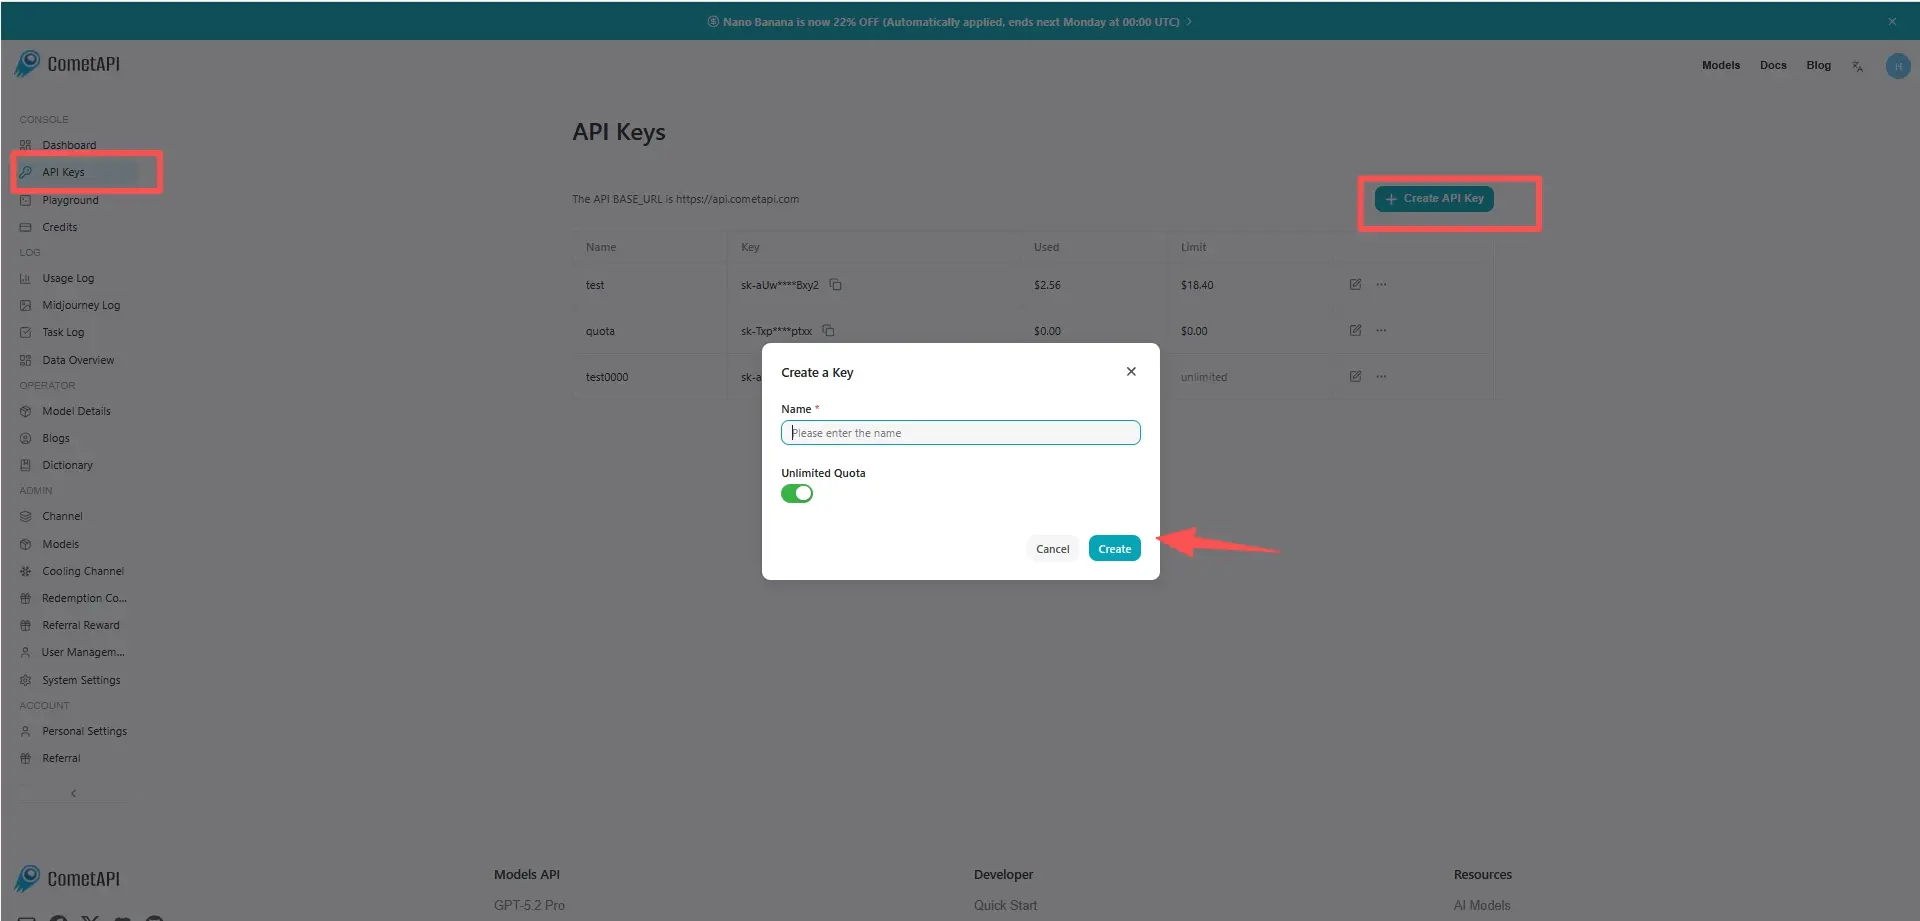
Paso 1: Regístrate para obtener una clave de API
Inicia sesión en cometapi.com. Si aún no eres usuario, regístrate primero. Inicia sesión en tu consola de CometAPI. Obtén la credencial de acceso (clave de API) de la interfaz. Haz clic en “Add Token” en el token de API en el centro personal, obtén la clave del token: sk-xxxxx y envíala.
Paso 2: Envía solicitudes a la API de MiniMax M3.1-Flash-Preview
Selecciona el endpoint “minimax-m3.1-flash-preview” para enviar la solicitud de API y configura el cuerpo de la solicitud. El método y el cuerpo de la solicitud se obtienen de la documentación de nuestra API en el sitio web. Nuestro sitio también proporciona Apifox para pruebas, para tu conveniencia. Reemplaza <YOUR_API_KEY> con tu clave real de CometAPI de tu cuenta. La URL base es Chat Completions.
Inserta tu pregunta o solicitud en el campo content—esto es a lo que responderá el modelo. Procesa la respuesta de la API para obtener la respuesta generada.
Paso 3: Recupera y verifica los resultados
Procesa la respuesta de la API para obtener la respuesta generada. Después del procesamiento, la API responde con el estado de la tarea y los datos de salida.