¿Qué es la API de GPT-5.2
GPT-5.2 API es lo mismo que GPT-5.2 Thinking en ChatGPT. GPT-5.2 Thinking es la variante de nivel intermedio de la familia GPT-5.2 de OpenAI, diseñada para trabajo más profundo: razonamiento de múltiples pasos, resumen de documentos largos, generación de código de calidad y trabajo profesional basado en conocimiento, donde la precisión y la estructura aprovechable importan más que el rendimiento bruto. En la API se expone como el modelo gpt-5.2 (Responses API / Chat Completions) y se sitúa entre la variante de baja latencia Instant y la variante Pro de mayor calidad pero más costosa.
Características principales
- Contexto muy largo y compactación: ventana efectiva de 400K y herramientas de compactación para gestionar la relevancia en conversaciones y documentos extensos.
- Esfuerzo de razonamiento configurable:
none | medium | high | xhigh(xhigh habilita el cómputo interno máximo para razonamientos difíciles).xhighestá disponible en las variantes Thinking/Pro. - Soporte más sólido de herramientas y funciones: invocación de herramientas de primera clase, gramáticas (CFG/Lark) para restringir salidas estructuradas y comportamientos de agente mejorados que simplifican la automatización compleja de múltiples pasos.
- Comprensión multimodal: comprensión más rica de imagen + texto e integración en tareas de múltiples pasos.
- Mejoras en seguridad / manejo de contenido sensible: intervenciones específicas para reducir respuestas indeseables en áreas como autolesiones y otros contextos sensibles.
Capacidades técnicas y especificaciones (vista para desarrolladores)
- Endpoints de API e IDs de modelo:
gpt-5.2para Thinking (Responses API),gpt-5.2-chat-latestpara flujos de chat/instant, ygpt-5.2-propara el nivel Pro; disponibles a través de Responses API y Chat Completions donde se indique. - Tokens de razonamiento y gestión del esfuerzo: la API admite parámetros explícitos para asignar cómputo (esfuerzo de razonamiento) por solicitud; un esfuerzo mayor incrementa la latencia y el costo, pero mejora la calidad de salida para tareas complejas.
- Herramientas de salida estructurada: soporte para gramáticas (Lark / CFG) para restringir la salida del modelo a un DSL o sintaxis exacta (útil para SQL, JSON, generación de DSL).
- Invocación paralela de herramientas y coordinación de agentes: un paralelismo mejorado y una orquestación de herramientas más limpia reducen la necesidad de indicaciones de sistema elaboradas y andamiaje multiagente.
Rendimiento en benchmarks y datos de respaldo
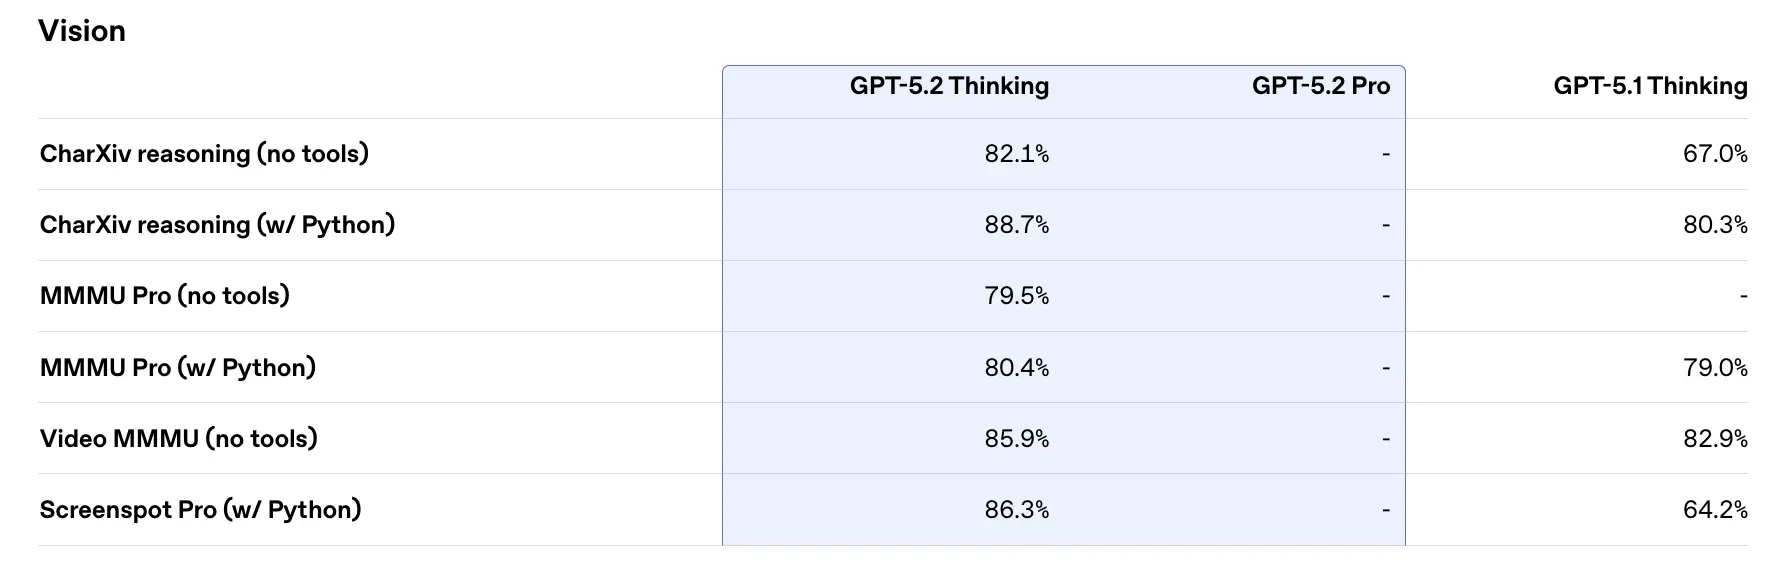
OpenAI publicó una variedad de resultados de benchmarks internos y externos para GPT-5.2. Aspectos destacados seleccionados (cifras reportadas por OpenAI):
- GDPval (44 ocupaciones, trabajo basado en conocimiento) — GPT-5.2 Thinking “supera o iguala a los mejores profesionales del sector en el 70.9% de las comparaciones”; OpenAI informa que las salidas se generaron a >11× la velocidad y a <1% del costo de profesionales expertos en sus tareas GDPval (las estimaciones de velocidad y costo se basan en datos históricos). Estas tareas incluyen modelos en hojas de cálculo, presentaciones y videos cortos.
- SWE-Bench Pro (coding) — GPT-5.2 Thinking alcanza ≈55.6% en SWE-Bench Pro y ~80% en SWE-Bench Verified (solo Python), según OpenAI, estableciendo un nuevo estado del arte para la evaluación de generación de código/ingeniería en sus pruebas. En la práctica, esto se traduce en depuración más confiable y correcciones de extremo a extremo, según los ejemplos de OpenAI.
- GPQA Diamond (preguntas y respuestas de ciencia a nivel de posgrado) — GPT-5.2 Pro: 93.2%, GPT-5.2 Thinking: 92.4% en GPQA Diamond (sin herramientas, razonamiento máximo).
- Serie ARC-AGI — En ARC-AGI-2 (un benchmark más difícil de razonamiento fluido), GPT-5.2 Thinking obtuvo 52.9% y GPT-5.2 Pro 54.2% (OpenAI dice que son nuevas marcas de estado del arte para modelos de estilo cadena de pensamiento).
- Contexto largo (OpenAI MRCRv2) — GPT-5.2 Thinking muestra una precisión cercana al 100% en la variante MRCR de 4 agujas hasta 256k tokens y puntuaciones sustancialmente mejoradas frente a GPT-5.1 en configuraciones de contexto largo. (OpenAI publicó gráficos y tablas de MRCRv2.)
Comparación con contemporáneos
- vs Google Gemini 3 (Gemini 3 Pro / Deep Think): Gemini 3 Pro se ha publicitado con una ventana de contexto de ~1,048,576 (≈1M) tokens y amplias entradas multimodales (texto, imagen, audio, video, PDFs), además de integraciones de agente sólidas mediante Vertex AI / AI Studio. Sobre el papel, la ventana de contexto más grande de Gemini 3 es un diferenciador para cargas de trabajo de sesión única extremadamente grandes; las compensaciones incluyen la oferta de herramientas y el encaje en el ecosistema.
- vs Anthropic Claude Opus 4.5: Opus 4.5 de Anthropic enfatiza flujos de trabajo de codificación/agents empresariales y reporta resultados sólidos en SWE-bench y robustez para sesiones agénticas largas; Anthropic posiciona Opus para automatización y generación de código con una ventana de contexto de 200k e integraciones especializadas de agente/Excel. Opus 4.5 es un competidor fuerte en automatización empresarial y tareas de código.
Conclusión práctica: GPT-5.2 apunta a un conjunto equilibrado de mejoras (contexto de 400k, salidas de tokens altas, razonamiento/codificación mejorados). Gemini 3 apunta a los contextos de sesión única absolutamente más grandes (≈1M), mientras que Claude Opus se centra en la ingeniería empresarial y la robustez agéntica. Elija según el tamaño de contexto, las necesidades de modalidad, el ajuste de características/herramientas y los compromisos entre costo y latencia.
Cómo acceder y usar la API de GPT-5.2
Paso 1: Regístrese para obtener la clave de API
Inicie sesión en cometapi.com. Si aún no es usuario, regístrese primero. Inicie sesión en su Consola de CometAPI. Obtenga la credencial de acceso (API key) de la interfaz. Haga clic en “Add Token” en el token de API del centro personal, obtenga la clave del token: sk-xxxxx y envíela.
Paso 2: Envíe solicitudes a la API de GPT-5.2
Seleccione el endpoint “gpt-5.2” para enviar la solicitud a la API y establecer el cuerpo de la solicitud. El método y el cuerpo de la solicitud se obtienen en la documentación de la API de nuestro sitio web. Nuestro sitio web también proporciona prueba en Apifox para su comodidad. Reemplace <YOUR_API_KEY> con su clave real de CometAPI de su cuenta. Los desarrolladores llaman a esto mediante los endpoints Responses API / Chat.
Inserte su pregunta o solicitud en el campo content—esto es a lo que responderá el modelo . Procese la respuesta de la API para obtener la respuesta generada.
Paso 3: Recupere y verifique los resultados
Procese la respuesta de la API para obtener la respuesta generada. Tras el procesamiento, la API responde con el estado de la tarea y los datos de salida.
Vea también Gemini 3 Pro Preview API