

TL;DR
Muse Wonder, Claude Opus 5.5 y GPT-6 Sol son modelos de alta capacidad orientados a la programación y flujos de trabajo con agentes. El nuevo Muse Wonder de Meta enfatiza la memoria persistente y la ejecución sostenida; Opus 5.5 lidera el índice agregado de inteligencia citado; GPT-6 Sol tiene las tarifas estándar más bajas para entrada y salida en contexto corto en esta comparación, mientras que su nivel de contexto largo se factura por separado. Elija según la calidad en tareas representativas, la fiabilidad y el coste total, no por una única puntuación de ranking.
Conclusiones clave
- Inteligencia general: Claude Opus 5.5 marca 58 frente a 52 de Muse Wonder en el Intelligence Index v4.3 reportado.
- Programación de largo recorrido: Muse Wonder registra 78.8 en DeepSWE 1.1 y 53.1 en SWE-Marathon; Opus 5.5 marca 74.2 y 46.3 en la tabla de Meta.
- Razonamiento de bajo coste: GPT-6 Sol parte de $2 de entrada / $10 de salida por millón de tokens mediante la API estándar de contexto corto de OpenAI.
- Agentes centrados en la memoria: Muse Wonder introduce Active Memory y Active Focus.
- La disponibilidad importa: Muse Wonder Full es un producto separado y más restringido que el Muse Wonder estándar accesible para desarrolladores.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol de un vistazo
Elija Muse Wonder para agentes persistentes e ingeniería de larga duración, Claude Opus 5.5 para programación amplia y trabajo intensivo en terminal, y GPT-6 Sol para costes más bajos de tokens en contexto corto estándar.
| Factor de decisión | Muse Wonder | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|
| Empezar a probar con | Agentes persistentes e ingeniería extendida | Programación intensiva en terminal y flujos pro | Programación y automatización sensibles al presupuesto |
| Ventana de contexto | 1,048,576 tokens | 1M tokens | 1,050,000 tokens |
| Fortalezas publicadas | DeepSWE 78.8; SWE-Marathon 53.1 | Intelligence Index 58; ProgramBench 70.5 | Entrada/salida estándar $2/$10 por 1M tokens |
| Entrada/salida estándar por 1M tokens | $4 / $20 | $4 / $20 | $2 / $10; nivel de contexto corto |
| Acceso del proveedor | Meta Model API; Full es un producto de suscripción independiente | Anthropic API | OpenAI API |
| Métrica de selección | Calidad de tareas aceptadas y coste total | Calidad de tareas aceptadas y coste total | Calidad de tareas aceptadas y coste total |
| Desarrollador | Meta | Anthropic | OpenAI |
| Lanzamiento | 12 de octubre de 2026 | 22 de septiembre de 2026 | 16 de septiembre de 2026 |
| Modalidades de entrada | Texto, imagen, audio, video; entradas PDF documentadas | Texto, imagen | Texto, imagen |
| Salida | Texto | Texto | Texto |
| Capacidad distintiva | Active Memory y Active Focus | Flujos con herramientas y subagentes | Esfuerzo de razonamiento configurable y herramientas de API |
Este panorama resume las especificaciones con fecha y los resultados publicados examinados más abajo. Las filas de benchmarks usan métodos de evaluación diferentes, y tarifas bajas por token no establecen un menor coste por tarea exitosa. Muse Wonder estándar y Muse Wonder Full son opciones de acceso distintas.
Las especificaciones se comprobaron el 13 de octubre de 2026. Las modalidades y funciones admitidas dependen del endpoint y la superficie de lanzamiento seleccionados, incluida la disponibilidad de audio. Las capacidades a nivel de modelo no garantizan soporte en todas las rutas del gateway.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Panorama general y especificaciones
Muse Wonder: flujos de trabajo con agentes persistentes
Meta presentó Muse Wonder y Muse Wonder Full el 12 de octubre de 2026. El Muse Wonder estándar enfatiza tareas profesionales de larga duración, memoria persistente del agente y recuperación ante obstáculos. Active Memory está pensado para recuperar contexto previo útil, mientras que Active Focus está diseñado para sostener el progreso a lo largo de trabajo de múltiples pasos. Meta describe la programación, la investigación, el análisis financiero y la asistencia personal como escenarios clave.
Claude Opus 5.5: programación profesional y uso de herramientas
Claude Opus 5.5 se orienta a la programación, el razonamiento y flujos profesionales con múltiples herramientas. Anthropic lo lanzó el 22 de septiembre de 2026. Su ventana de contexto es de un millón de tokens, mientras que los resultados de programación que se muestran a continuación evidencian fortalezas que varían según el benchmark.
GPT-6 Sol: razonamiento consciente del coste
GPT-6 Sol busca combinar fuerte razonamiento y uso de herramientas con inferencia comparativamente asequible. Admite flujos programáticos a través del ecosistema de API de OpenAI. Sus tarifas estándar de contexto corto son inferiores a las listadas para Claude Opus 5.5, aunque la economía extremo a extremo también depende de reintentos y del uso de tokens de razonamiento.
OpenAI describe GPT-6 Sol como un modelo para programación compleja y flujos agentivos; su anuncio de lanzamiento proporciona los resultados de evaluación utilizados más abajo. Este artículo compara las versiones de modelo especificadas, no todos los modelos más nuevos de la cartera de cada proveedor.
Arquitectura y controles de razonamiento
Las fuentes citadas aquí no proporcionan un desglose comparable de recuento de parámetros y arquitectura para los tres modelos. Por lo tanto, no se justifica un ranking denso versus mezcla de expertos. Active Memory y Active Focus describen capacidades de agente de Meta; no sustituyen a una arquitectura neuronal divulgada. GPT-6 Sol expone esfuerzo de razonamiento configurable, mientras que las puntuaciones reportadas de Meta y Claude también dependen del esfuerzo y la configuración de evaluación. Trate esos ajustes como parte de la configuración que se compara, no como medidas intercambiables de cómputo.
Resultado de la comparación: Los tres ofrecen amplias ventanas de contexto y APIs para desarrolladores. Muse Wonder documenta modalidades de entrada a nivel de modelo más amplias; Opus 5.5 y GPT-6 Sol enfatizan flujos de texto e imagen. La capacidad de contexto y la disponibilidad de funciones aún deben comprobarse en el endpoint seleccionado.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Rendimiento
Benchmarks publicados y límites de las fuentes
La tarjeta de modelo oficial de Meta ofrece comparaciones directas de Muse Wonder frente a Claude Opus 5.5. OpenAI publica los resultados de GPT-6 Sol por separado, por lo que los tres modelos no pueden situarse en una única clasificación totalmente controlada sin armonizar los arneses de evaluación, las versiones y la configuración.
| Benchmark | Muse Wonder | Claude Opus 5.5 | Puntuación más alta |
|---|---|---|---|
| Artificial Analysis Intelligence Index v4.3 | 52 | 58 | Opus |
| Personal Superintelligence Index | 54.3 | 55.2 | Opus |
| Harvey LAB-AA | 10.0 | 4.2 | Muse |
| Vals Finance Agent V2 | 56.6 | 58.6 | Opus |
| AutomationBench-AA | 39.1 | 41.2 | Opus |
| JobBench | 70.5 | 75.4 | Opus |
| MemoryBench | 85.6 | 81.5 | Muse |
| Terminal-Bench 4.0-AA | 52.0 | 59.6 | Opus |
| DeepSWE 1.1 | 78.8 | 74.2 | Muse |
| SWE-Marathon | 53.1 | 46.3 | Muse |
| ProgramBench | 50.0 | 70.5 | Opus |
| HealthBench Pro | 60.5 | 65.6 | Opus |
La metodología oficial de la tarjeta de modelo distingue pruebas internas, evaluaciones de terceros y puntuaciones de competidores reportadas por el proveedor. La tabla reproduce los valores reportados; no establece una prueba uniforme e independiente controlada en todas las filas.
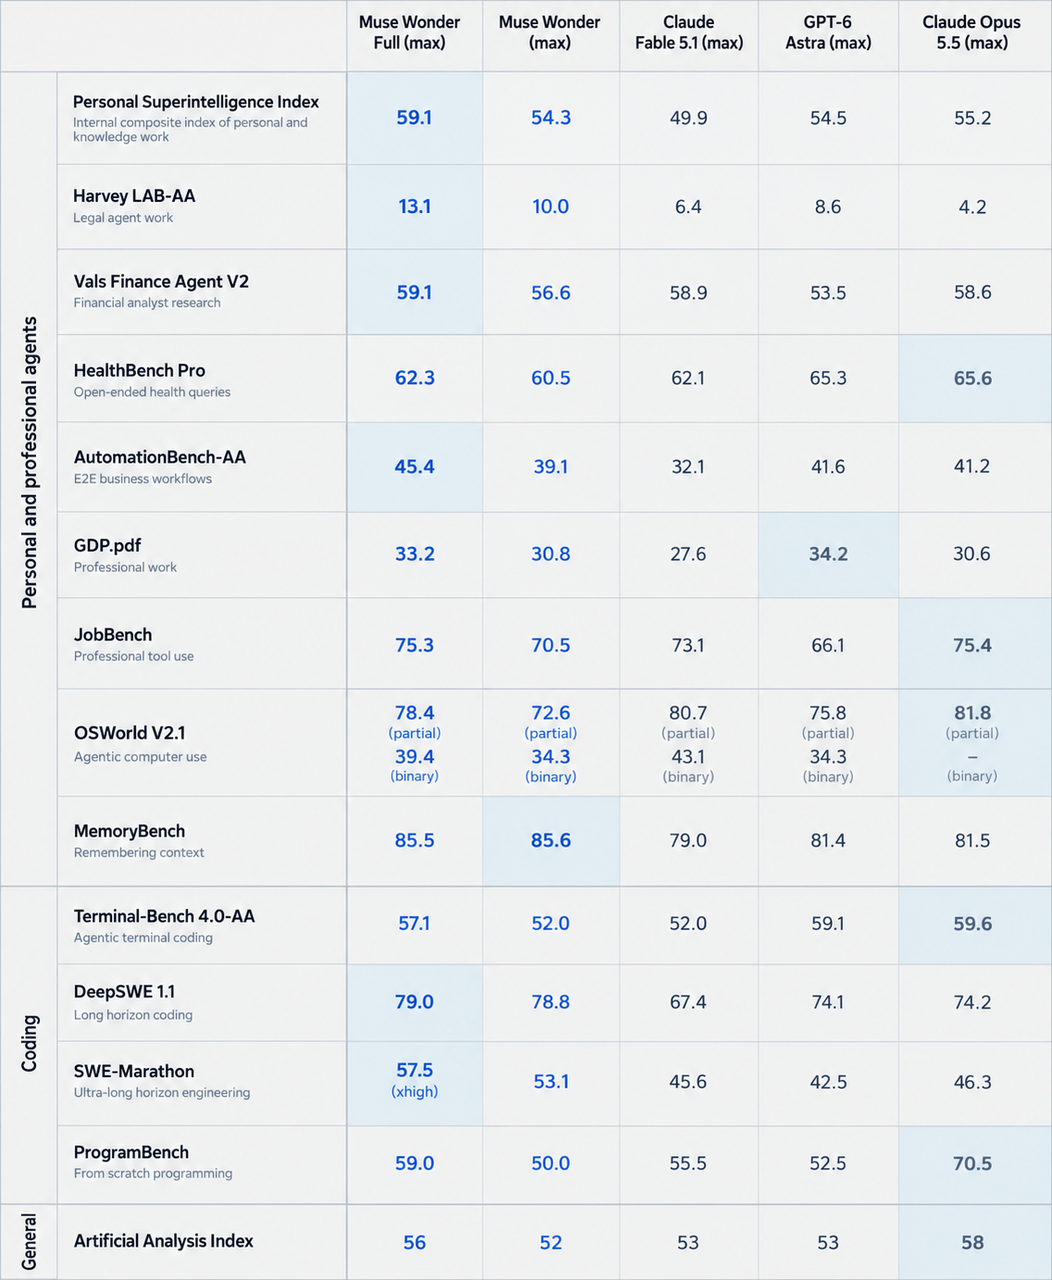
Tarjeta original de puntuaciones de benchmarks del modelo Muse Wonder de Meta, reproducida sin redibujar. El modelo adicional de OpenAI mostrado en esta imagen oficial es GPT-6 Astra, no GPT-6 Sol. Las tablas circundantes identifican los modelos relevantes para este artículo.
Condiciones de evaluación
DeepSWE v1.1 cubre 113 tareas en 91 repositorios y cinco lenguajes, calificado por pruebas funcionales y de regresión usando pass@1; la tarjeta de puntuaciones de Meta usa resultados de Datacurve para Muse Wonder y Opus 5.5. SWE-Marathon usa pruebas de proyecto e informa pass@1 de Abundant AI; los arneses de agente varían, y la puntuación de Wonder Full está marcada como xhigh. ProgramBench usa mini-swe-agent y mide ejecuciones que pasan al menos el 95% de las pruebas ocultas, con internet deshabilitado tras la configuración. MemoryBench es la prueba interna de Meta de conversación de 64K–100K tokens puntuada por un juez LLM. Estos entornos y métricas no deben colapsarse en una única puntuación de precisión general.
Programación y desarrollo de software
Muse Wonder lidera en los resultados reportados de DeepSWE 1.1 y SWE-Marathon. Claude Opus 5.5 lidera en Terminal-Bench 4.0-AA y ProgramBench. Esta división sugiere que la ingeniería de largo recorrido, el uso de herramientas de línea de comandos y la reconstrucción de programas exigen habilidades diferentes.
Resultados de GPT-6 Sol y comparabilidad entre fuentes
| Evaluación publicada por OpenAI | GPT-6 Sol | Configuración reportada |
|---|---|---|
| DeepSWE 1.1 | 68.8% | Razonamiento máximo |
| AutomationBench 1.0.6 | 33.2% | Razonamiento xhigh |
| Agents' Last Exam V1 | 56.4% | Razonamiento máximo |
| OSWorld 2.0 offline | 60.5% | Razonamiento xhigh |
Los resultados de evaluación publicados por OpenAI informan las puntuaciones anteriores. Su resultado en OSWorld es recompensa parcial en el conjunto offline v2026.08.08, en lugar de una tasa estricta de finalización de tareas. OpenAI señala que las evaluaciones usaron su entorno de investigación o la API; las configuraciones de producción pueden diferir.
Las puntuaciones reportadas de DeepSWE implican una brecha de 10.0 puntos porcentuales entre Muse Wonder y GPT-6 Sol, y una brecha de 5.4 puntos entre Opus 5.5 y GPT-6 Sol. Son diferencias aritméticas entre publicaciones, no estimaciones controladas de una ventaja atribuible solo al modelo. Diferentes configuraciones de agente, prompts, niveles de esfuerzo y presupuestos de herramientas pueden afectar el resultado.
Memoria y agentes de larga duración
Muse Wonder se orienta a agentes que deben recordar decisiones previas, recuperar contexto y continuar trabajo interrumpido. Active Memory puede ayudar a un asistente de investigación a recordar hechos específicos del proyecto, mientras que Active Focus respalda la acción iterativa cuando un plan anterior no tiene éxito. Estas capacidades de producto no sustituyen la verificación de estado, permisos, trazabilidad ni confirmación humana obligatoria para acciones sensibles.
Rendimiento de Muse Wonder Full
Muse Wonder Full es una opción de producto separada. Meta ofrece Muse Wonder estándar a través de su API, mientras que Full está restringido a las suscripciones Power Usage y Maximum Usage en Muse Code. Una puntuación más alta no convierte a Full en un reemplazo de la API para el modelo estándar.
Los resultados reportados de Wonder Full por Meta son 56 en el Intelligence Index, 59.1 en Personal Superintelligence, 13.1 en Harvey LAB-AA y 45.4 en AutomationBench-AA. También marca 79.0 en DeepSWE 1.1, 57.5 en SWE-Marathon, 85.5 en MemoryBench y 75.3 en JobBench. Estos resultados publicados describen el producto Full con acceso separado; no son nuevas mediciones de una comparación con arnés común.
En comparación con las puntuaciones anteriores de Muse Wonder estándar, Full mejora en siete de estas ocho medidas reportadas; MemoryBench es ligeramente menor con 85.5 frente a 85.6. Opus 5.5 aún lidera el Intelligence Index reportado con 58.
Latencia y fiabilidad
La evidencia citada no proporciona una comparación de latencia entre los tres modelos con igualdad de condiciones. Mida el tiempo hasta la primera salida útil, el tiempo mediano y al percentil 95 de tarea extremo a extremo, la frecuencia de timeouts y la finalización sin intervención. Mantenga fijas las entradas de la tarea, los permisos de herramientas, la concurrencia y los criterios de aceptación; registre los ajustes de esfuerzo y los presupuestos de reintentos. Una generación de tokens más rápida por sí sola no establece una finalización más rápida de una tarea de múltiples pasos.
Resultado de la comparación: Muse Wonder lidera las pruebas citadas de ingeniería sostenida, mientras que Opus 5.5 lidera las pruebas citadas de terminal y reconstrucción de programas. GPT-6 Sol se mantiene como candidato con precio de tokens más bajo, pero las publicaciones disponibles no prueban un ranking de calidad o velocidad en entornos iguales para los tres.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Coste
Precios oficiales por token en la API
| Precio por 1M tokens | Muse Wonder | Claude Opus 5.5 | GPT-6 Sol |
|---|---|---|---|
| Entrada estándar | $4 | $4 | $2 |
| Salida estándar | $20 | $20 | $10 |
| Entrada en caché | $0.20 | $0.20 | $0.20 |
| Entrada de contexto largo | $4 | $4 | $4 |
| Salida de contexto largo | $20 | $20 | $15 |
| Entrada en caché de contexto largo | $0.20 | $0.20 | $0.40 |
Meta publica $4 de entrada, $20 de salida y $0.20 por entrada en caché por millón de tokens. Anthropic lista Opus 5.5 a $4 de entrada, $20 de salida y $0.20 en aciertos de caché por millón de tokens. La tabla de precios de OpenAI lista GPT-6 Sol en $2/$10 para entrada/salida de contexto corto y $4/$15 para contexto largo; las tarifas de entrada en caché también varían por nivel. Aplique el nivel de contexto por solicitud pertinente, el modo de procesamiento y las condiciones del endpoint antes de estimar una carga de trabajo.
Para GPT-6 Sol, las solicitudes que contengan más de 272,000 tokens de entrada se facturan a tarifas más altas:
- Tokens de entrada: 2× la tarifa estándar, pasando de $2 a $4 por millón de tokens.
- Tokens de entrada en caché: 2× la tarifa estándar, pasando de $0.20 a $0.40 por millón de tokens.
- Tokens de salida: 1.5× la tarifa estándar, pasando de $10 a $15 por millón de tokens.
Estas tarifas más altas se aplican a toda la solicitud, no solo a los tokens que superan 272,000. Por lo tanto, una solicitud con 272,001 tokens de entrada entra en el nivel de precios de contexto largo para todos sus tokens de entrada, entrada en caché y salida.
En comparación, Muse Wonder y Claude Opus 5.5 no imponen una prima de precios equivalente por contexto largo en sus tarifas estándar de API.
Esta distinción es especialmente importante para análisis de documentos grandes, programación a nivel de repositorio y agentes de IA de larga duración, donde la ventaja de precios de contexto corto de GPT-6 Sol puede reducirse a medida que las solicitudes crecen.
Precios y condiciones de facturación de CometAPI
En el momento de la revisión, CometAPI listaba Opus 5.5 a $3.20 de entrada / $16 de salida y GPT-6 Sol a $1.60 de entrada / $8 de salida por millón de tokens. Estas son tarifas independientes de CometAPI y no deben confundirse con los precios oficiales del proveedor anteriores. Confirme la ruta aplicable, el nivel de contexto y las condiciones de facturación de la cuenta antes de estimar el coste; los precios y condiciones pueden cambiar.
Coste por tarea aceptada
Calcule el coste por tarea aceptada como el gasto total facturado de modelo y herramientas, incluidos reintentos y alternativas cobradas, dividido por el número de salidas que cumplen los criterios de aceptación predefinidos. Registre por separado el tiempo de revisión humana o conviértalo usando una tarifa laboral explícita. Rastree solicitudes fallidas y cargos reales de manera independiente: el fallo por sí solo no establece si se facturó una solicitud.
Resultado de la comparación: GPT-6 Sol tiene las tarifas estándar más bajas para entrada y salida en contexto corto, mientras que Muse Wonder y Opus 5.5 comparten las mismas tarifas base listadas. El coste real por tarea aceptada depende de la ruta de facturación seleccionada, uso de caché, niveles de contexto, tarifas de herramientas, reintentos y esfuerzo de revisión.
Muse Wonder vs Claude Opus 5.5 vs GPT-6 Sol: Comparación y selección
Selección basada en capacidad y carga de trabajo
- Para programación amplia y flujos de terminal, empiece con Claude Opus 5.5 porque lidera el Intelligence Index, Terminal-Bench y ProgramBench citados. Valídelo en refactorización, ejecución de herramientas y consistencia a nivel de programa.
- Para proyectos de ingeniería extensos, empiece con Muse Wonder porque sus resultados reportados en DeepSWE y SWE-Marathon son más fuertes que los de Opus 5.5. Mida la finalización de tareas, la recuperación ante obstáculos y el coste total de la tarea.
- Para agentes personales persistentes, empiece con Muse Wonder porque ofrece Active Memory y Active Focus y tiene una puntuación de MemoryBench reportada más alta que Opus 5.5. Pruebe recuerdo, correcciones, continuidad y aislamiento de proyectos.
- Para flujos de trabajo con múltiples herramientas, evalúe los tres modelos. Muse ofrece Active Focus, Opus enfatiza la orquestación de herramientas y GPT-6 Sol admite herramientas de la Responses API. Compare toda la pila de agente, incluidos permisos de herramientas, reintentos y gestión de estado.
- Para documentos profesionales y análisis, evalúe Muse Wonder o Claude Opus 5.5. Muse tiene fortalezas especializadas, mientras que Opus tiene el índice agregado citado más fuerte. Use documentos representativos y criterios de aceptación específicos de la tarea.
- Para automatización de alto volumen y sensible al coste, empiece con GPT-6 Sol porque tiene las tarifas estándar de contexto corto de entrada y salida más bajas. Compruebe el coste por tarea aceptada, niveles de contexto, latencia y reintentos.
- Para la opción de mayor nivel de Meta, evalúe Muse Wonder Full si es accesible. Tiene puntuaciones reportadas más altas en varias tareas especializadas, pero es separado del modelo de API estándar. Confirme acceso por suscripción e idoneidad antes de probar.
Programación profesional
Claude Opus 5.5 es una buena opción predeterminada para equipos que requieren un asistente de ingeniería amplio, especialmente donde importan la ejecución de herramientas, la refactorización y la consistencia a nivel de programa. Sus ventajas reportadas en Terminal-Bench y ProgramBench refuerzan ese caso, aunque los equipos deben validar la pila de agente completa y no solo el modelo.
Automatización de alto volumen
GPT-6 Sol es atractivo cuando las solicitudes son numerosas y la sensibilidad al coste es alta. Incluso un modesto déficit de calidad puede ser aceptable para tareas de bajo riesgo y fácil verificación, como redactar documentación, extraer campos estructurados o explicar código. Para ejecuciones autónomas largas, rastree calidad, tokens, latencia y reintentos en conjunto.
Lista de verificación para evaluación en producción
La evaluación en producción debe rastrear seis métricas: corrección, medida por respuestas aceptadas o pruebas aprobadas; fiabilidad, medida por tareas completadas sin rescate humano; latencia, medida por la duración extremo a extremo de la tarea; uso de tokens, medido por la entrada y salida totales facturadas; eficiencia del agente, medida por invocaciones de herramientas y reintentos correctivos; y coste efectivo, calculado como gasto total dividido por tareas aceptadas.
Resultado de la comparación: Incluya en la lista corta a Muse Wonder para comportamiento de agente persistente e ingeniería extendida, a Opus 5.5 para flujos de programación amplios con fuertes exigencias de terminal y a GPT-6 Sol cuando el coste por token sea una restricción importante. Promueva un candidato solo después de que cumpla umbrales de calidad y fiabilidad específicos de la tarea.
¿Dónde puede acceder a Muse Wonder, Claude Opus 5.5 y GPT-6 Sol?
Acceso del proveedor oficial
Use Meta Model API para Muse Wonder estándar, Anthropic API para Opus 5.5 u OpenAI API para GPT-6 Sol. Muse Wonder Full está disponible a través de los planes de suscripción especificados de Muse Code en lugar de ser un reemplazo directo del modelo de API estándar. Compruebe el acceso a la cuenta, los límites de uso y las funciones de solicitud admitidas para la ruta que seleccione.
Acceso vía CometAPI
Una pasarela unificada puede simplificar la autenticación, la facturación y el enrutamiento. Use un modelo de mayor rendimiento para revisión de arquitectura compleja y un modelo más barato para redacción repetitiva y de bajo riesgo. El identificador del modelo y el formato de solicitud admitido siempre deben verificarse con el endpoint de API de destino.
Los desarrolladores pueden acceder a la API de Claude Opus 5.5 en CometAPI y a la API de GPT-6 Sol en CometAPI para evaluar cargas de trabajo representativas. Confirme la superficie de API admitida para cada modelo en lugar de asumir que una pasarela compartida hace que todos los formatos de solicitud sean intercambiables.
Las rutas de CometAPI citadas en este artículo cubren Opus 5.5 y GPT-6 Sol. Este artículo no establece una ruta de CometAPI para Muse Wonder o Wonder Full; use la ruta del proveedor confirmada al evaluar esos productos.
Conclusión
Ningún modelo gana en todas las cargas de trabajo. Muse Wonder es el candidato más sólido para probar comportamiento de agente persistente y tareas de ingeniería de larga duración. Claude Opus 5.5 es un candidato fuerte para programación amplia, flujos de trabajo intensivos en terminal y trabajo de conocimiento, y lidera el valor de Artificial Analysis Intelligence Index reportado por Meta. GPT-6 Sol ofrece los precios de tokens estándar de contexto corto más bajos y es atractivo para automatización sensible al coste. Los equipos de producción deben tomar la decisión final usando calidad por tarea aceptada, fiabilidad, latencia, reintentos, uso de herramientas y coste total en cargas de trabajo representativas.
Preguntas frecuentes
¿Cómo pueden los equipos probar de forma justa Muse Wonder, Opus 5.5 y GPT-6 Sol?
Use un conjunto reservado de tareas reales con criterios de aceptación fijos, artefactos de entrada idénticos y permisos de herramientas documentados. Registre cada versión de modelo, ajuste de esfuerzo, arnés de agente, timeout y presupuesto de tokens. Ejecute ensayos repetidos donde las salidas varíen, informe fallos además de éxitos y separe una comparación con arnés común de una comparación del sistema mejor configurado. Esto produce evidencia aplicable a su flujo de trabajo en lugar del montaje de pruebas de otro equipo.
¿Puede un gateway de API preservar el estado del agente al cambiar de modelo?
Una dirección compartida de gateway por sí sola no garantiza estado de conversación portable, identificadores de llamadas de herramienta ni referencias a respuestas almacenadas. Mantenga un registro canónico en la aplicación de mensajes, salidas de herramientas y estado de tarea validado. Pruebe el estado y la semántica de herramientas de cada ruta antes de enrutar un trabajo en curso a otro modelo; de lo contrario, una alternativa más barata puede perder información necesaria para terminar correctamente.
¿Cómo deben los equipos presupuestar reintentos y revisión humana?
Defina un resultado aceptado antes de probar y luego divida el gasto total facturado de modelo y herramientas por los resultados aceptados. Informe la labor de revisión por separado o inclúyala usando una tarifa por hora declarada. Cuente los intentos fallidos, las llamadas correctivas y los modelos de respaldo, y compare tanto las tareas típicas como las de mayor coste. Esto evita tratar un precio por token más bajo como una reducción garantizada en el coste del trabajo útil.
¿Qué debe incluir una evaluación de agentes sensibles a la memoria?
Pruebe si el agente recuerda hechos relevantes, incorpora correcciones, ignora instrucciones obsoletas y mantiene proyectos separados aislados. Incluya seguimientos diferidos y actualizaciones contradictorias en lugar de solo un único prompt largo. Verifique el comportamiento de memoria en el nivel de aplicación además del nivel de modelo, porque la persistencia, la recuperación y la eliminación dependen del sistema desplegado.