
TLDR OpenAI Bel es una ejecución interna de preentrenamiento no confirmada (nombre en clave) reportada por primera vez en X el 25 de agosto de 2026 por @synthwavedd. La afirmación describe un modelo base terminado con más de 10 billones de parámetros totales—sucesor de una ejecución anterior llamada Doug—destinado a servir de base para sistemas posteriores a GPT-6 y potencialmente un modelo de “umbral de AGI” tras un mayor aprendizaje por refuerzo.
A fecha del 13 de octubre de 2026, OpenAI nunca ha utilizado el nombre Bel (ni Doug en materiales públicos de producto), no ha publicado recuento de parámetros, fecha de lanzamiento, benchmarks ni system card, y Bel no está disponible vía API ni en ChatGPT.
Puntos clave
- Bel se origina en una única publicación en X de @synthwavedd el 25 de agosto de 2026; OpenAI nunca lo ha confirmado.
- Escala afirmada: >10T parámetros totales, similar en clase de tamaño a GPT-4.5 según la publicación original.
- Posicionado en el rumor como sucesor de “Doug” y base para sistemas posteriores a GPT-6 / Astra tras RL.
- GPT-6 Astra está disponible públicamente desde principios de septiembre de 2026 y es el buque insignia actual de OpenAI.
- No existen benchmarks independientes, fecha de lanzamiento, API, precios ni pesos para Bel.
- Claude Fable 5.5 sigue sin anunciarse; el Claude de gama alta actual es Fable 5.1.
- Para uso en producción hoy, encamine GPT-6 Astra / Sol / Luna y modelos Claude mediante una sola clave en CometAPI para menor coste y cero dependencia de proveedor.
¿Qué es OpenAI Bel?
OpenAI Bel (a veces estilizado “BEL”) es el nombre en clave que circula en debates de la comunidad de IA para un supuesto preentrenamiento de gran escala que OpenAI habría completado en la segunda mitad de agosto de 2026. Según el informe original, Bel es un modelo de base en bruto—no un producto terminado—con más de 10 billones de parámetros totales. Se enmarca como el sucesor de un proyecto interno anterior llamado Doug y como la base prevista que, tras aprendizaje por refuerzo y posentrenamiento adicionales, podría impulsar sistemas más allá de GPT-6 Astra, potencialmente alcanzando lo que algunos insiders supuestamente denominan un nivel de capacidad de “umbral de AGI”.
Importante: Bel no es GPT-7, no es un modelo de ChatGPT con el que los usuarios puedan conversar y no es algo disponible mediante la API de OpenAI. Se describe estrictamente como un artefacto de preentrenamiento: la enorme red neuronal entrenada en texto (y posiblemente otros datos) que aún requiere un amplio ajuste fino, alineación y trabajo de seguridad antes de ser un producto comercializable.
Bel es el nombre en clave informado de un esfuerzo de modelo fundacional de OpenAI. La afirmación se atribuye a la publicación del 25 de agosto de 2026 sobre un preentrenamiento completado de @synthwavedd. La publicación reproducida alega más de 10 billones de parámetros totales y una relación de sucesión con Doug. Esos detalles siguen siendo afirmaciones de una única fuente: la captura de pantalla registra una alegación, no un resultado de entrenamiento autenticado de OpenAI.
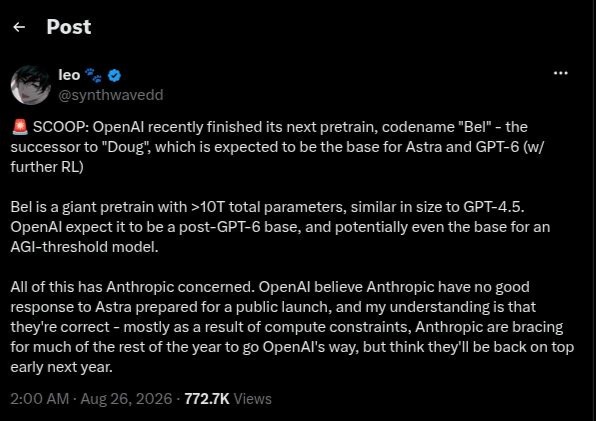
La captura de pantalla se reproduce de la captura de Mukhtada de la publicación atribuida en X. Muestra el 26 de agosto a las 2:00 a. m. en el contexto horario de Yakarta de la fuente, lo que corresponde al 25 de agosto a las 19:00 UTC. Es una captura de terceros, no una confirmación independiente del recuento de parámetros, el estado del entrenamiento o afirmaciones competitivas privadas.
Cronología de evidencias Doug–Bel
El trasfondo de Doug es independiente: La publicación del 7 de agosto de SemiAnalysis reproduce una nota del 9 de julio que menciona un modelo de OpenAI más grande llamado Doug. Esto es anterior a la publicación sobre Bel, pero no autentica Doug → Bel ni conecta ningún nombre en clave con un producto lanzado.
- 9 de julio de 2026: Una nota de investigación que menciona un modelo de OpenAI más grande llamado Doug fue reproducida posteriormente en el artículo de SemiAnalysis publicado el 7 de agosto. La fecha de la nota y la fecha de publicación son hitos distintos; esto es contexto sobre Doug, no confirmación de Bel.
- 7 de agosto de 2026: SemiAnalysis publicó el artículo que reproduce la referencia a Doug. Es anterior a la alegación sobre Bel pero no establece una línea Doug→Bel ni un nombre de producto público.
- 25 de agosto de 2026: La publicación atribuida de @synthwavedd alegó el preentrenamiento completado de Bel y más de 10 billones de parámetros totales. Una captura de terceros reproduce la afirmación; no es verificación independiente.
- 1 de septiembre de 2026: El informe Path to Astra citado en este artículo aporta contexto sobre un programa de desarrollo de modelos separado. No establece la identidad de Bel, su recuento de parámetros ni una conexión con GPT-7 o un posible nombre GPT-6 Bel.
- 23 de septiembre de 2026: Una versión en circulación atribuye una espera de meses a una publicación de seguimiento de la misma cuenta. Como el texto original no fue directamente accesible en la revisión de la fuente, esto sigue siendo una guía de tiempos no verificada y no aporta un compromiso de lanzamiento.
- 12 de octubre de 2026 — punto de control de revisión del artículo: La publicación atribuida sobre Bel, los reportes sobre Doug y el informe oficial separado citados aquí no establecen una identidad comercial para Bel. Ni GPT-7 ni GPT-6 Bel están confirmados por esta cadena de evidencias; esta fecha registra la revisión del artículo, no un anuncio de modelo.
En el mismo periodo, OpenAI habló públicamente de un modelo interno sin nombre “significativamente más capaz que GPT-6 Astra” en relación con trabajo matemático (incluidos resultados relacionados con las ecuaciones de Navier-Stokes).
Dos hipótesis de nomenclatura: ¿GPT-7 o GPT-6 Bel?
El preentrenamiento y el lanzamiento de producto son hitos diferentes. Un checkpoint fundacional aún puede requerir ajuste instruccional, aprendizaje por refuerzo, evaluación de seguridad, entrenamiento para uso de herramientas y optimización del serving. De una base pueden derivarse múltiples productos, y una versión pública no identifica una ejecución de entrenamiento. El informe Path to Astra de OpenAI aporta antecedentes oficiales sobre aprendizaje por refuerzo, sin establecer la identidad de Bel.
Hipótesis 1 — GPT-7: Si Bel representa una base materialmente nueva más allá de la generación GPT-6, OpenAI podría comercializar un modelo derivado como GPT-7. Esta interpretación depende de una nueva generación de capacidades y de una decisión de denominación pública; ni el recuento de parámetros alegado ni el supuesto fin del preentrenamiento establecen ese resultado.
Hipótesis 2 — GPT-6 Bel: OpenAI podría, en cambio, mantener un producto derivado de Bel dentro de la familia GPT-6, potencialmente usando una etiqueta como GPT-6 Bel para una oferta mejorada o especializada. Este es un escenario de denominación editorial para comparación, no un producto anunciado ni una filtración con fuentes independientes. Un nombre en clave interno no aparece necesariamente en el nombre comercial.
Qué sigue sin resolverse: El mismo esfuerzo de entrenamiento podría sustentar múltiples productos, otro nombre o ningún lanzamiento público. La cronología aporta contexto para ambas interpretaciones pero no puede elegir entre ellas. La confirmación requeriría documentación que vincule el esfuerzo de entrenamiento de Bel con un modelo público real y su nombre.
Comparación de OpenAI Bel con la generación anterior: ¿qué mejora?
Dado que no hay detalles técnicos concretos sobre Bel, cualquier discusión de mejoras debe basarse en (1) las afirmaciones de alto nivel de la filtración, (2) la trayectoria conocida de GPT-4o → GPT-5.x → GPT-6 Astra y (3) las capacidades demostradas por el modelo interno sin nombre usado para trabajo científico a escala Navier-Stokes. Cada área potencial de mejora se trata por separado a continuación.
Escala y cómputo de preentrenamiento
La afirmación central es un salto más allá de ejecuciones internas previas hacia el régimen de >10T parámetros. Si es exacto, representaría continuidad con las leyes de escalado en datos, parámetros y cómputo. Confirmado: OpenAI ha continuado ejecuciones de entrenamiento grandes y ha referido públicamente modelos más capaces que Astra. No confirmado: ningún recuento específico de parámetros, FLOPs de entrenamiento, mezcla de datos o cambios de arquitectura (densa vs. mezcla de expertos, atención novedosa, etc.). Expectativa realista basada en la historia: mejor eficiencia de muestreo y cobertura de conocimiento más amplia, pero rendimientos decrecientes sin avances correspondientes en posentrenamiento y calidad de datos.
Posentrenamiento y alineación para agencia en horizontes largos
GPT-6 Astra ya mejoró sustancialmente en flujos de trabajo multietapa, uso del ordenador y mantenerse dentro de los límites de la tarea. Una base más fuerte más RL adicional podría llevar la operación agente fiable de horas hacia horizontes de varios días o semanas con menos dirección humana. El experimento multiagente de Navier-Stokes (miles de agentes coordinándose) demuestra que OpenAI ya opera a escala de enjambre de agentes en problemas difíciles. Dirección de capacidad confirmada: sí. Contribución específica de Bel: no confirmada.
Razonamiento científico y matemático
El propio Astra contribuyó a avances matemáticos; el modelo interno más fuerte produjo un resultado formalizado sobre un problema del Premio del Milenio. Una base más grande y mejor entrenada podría comprimir aún más el tiempo y coste de explorar espacios de búsqueda STEM difíciles. Confirmado: OpenAI está invirtiendo fuertemente aquí. Específico de Bel: no confirmado.
Uso del ordenador, uso de herramientas y fiabilidad multimodal
Astra estableció nuevas marcas en benchmarks de uso del ordenador y del navegador. Se esperaría que bases futuras reduzcan las tasas de error en trayectorias largas, mejoren el anclaje visual y manejen entornos de software más complejos. Especulativo pero coherente con la hoja de ruta del producto.
Eficiencia, velocidad de inferencia y coste
Incluso si la base es mayor, la destilación, mejores arquitecturas y silicio personalizado (OpenAI ha hablado de sus propios ASIC) podrían aún ofrecer coste/rendimiento utilizable. No existen afirmaciones específicas de eficiencia para Bel.
¿Cuándo podrían lanzarse OpenAI Bel o GPT-7?
No hay fecha oficial de lanzamiento para Bel o un GPT-7 derivado de Bel establecida por las fuentes revisadas. Una versión en circulación de la publicación de seguimiento del 23 de septiembre de @synthwavedd que describe una espera de meses se atribuye a la misma fuente no oficial que la filtración original. Su texto completo no fue directamente accesible durante esta revisión, por lo que no debe usarse para pronosticar una ventana de lanzamiento. El preentrenamiento completado, si es cierto, aún podría ir seguido de posentrenamiento, evaluaciones, trabajo de serving y despliegue por etapas.
| Escenario | Qué ocurriría | Qué implica |
|---|---|---|
| Finalización más rápida | Las evaluaciones restantes y el despliegue tienen éxito relativamente rápido | Un sucesor podría llegar antes |
| Desarrollo extendido | Se requiere más entrenamiento, mitigación y trabajo de serving | El calendario se desplaza más allá |
| Despliegue alternativo | La base alimenta sistemas especializados o con otra marca | No tiene por qué existir un producto llamado Bel |
El hipotético Fable 5.5 no tiene calendario verificado en las fuentes revisadas, por lo que una predicción del orden de lanzamientos no está respaldada.
¿Podría Bel cambiar el equilibrio entre OpenAI y Anthropic?
Permanecen abiertas tres salidas creíbles. Primero, Bel podría introducir un salto amplio en preentrenamiento y mejorar posteriores sistemas de programación y razonamiento. Segundo, la ventaja podría ser estrecha, con otros proveedores conservando victorias en fiabilidad de agentes, latencia o coste. Tercero, la escala enorme reportada podría no traducirse en ganancias prácticas proporcionales. Hasta que exista evidencia reproducible, el encuadre correcto es una posible respuesta competitiva más que un ganador declarado.
Recomendaciones prácticas para desarrolladores y equipos (CometAPI)
Mientras la industria espera confirmación oficial de Bel o del próximo gran modelo base de OpenAI, los sistemas de producción necesitan acceso fiable a los modelos que sí existen hoy. CometAPI proporciona un endpoint único compatible con OpenAI (https://api.cometapi.com/v1) y una sola clave de API que llega a más de 500 modelos, incluida la familia GPT-6 actual completa (Astra, Sol, Luna y actualizaciones) y la línea Claude de Anthropic (Fable 5.1, Opus 5.5, Sonnet 5.5, etc.).
Conclusión
La frontera de la IA sigue moviéndose rápido. Bel puede resultar ser un hito interno importante, un nombre en clave mal reportado o algo intermedio. Hasta que OpenAI publique información concreta, la postura responsable es tratar las afirmaciones como no verificadas mientras se extrae el máximo valor de los modelos ya disponibles—y mantener la infraestructura lo bastante flexible como para incorporar la próxima generación en cuanto sea real. Para muchos equipos, esa flexibilidad se logra hoy más fácilmente mediante una plataforma unificada como CometAPI.