
TL;DR
OpenAI Decisions API y TypeSafe Jev devuelven decisiones acotadas con respaldo probabilístico, no prosa generada. OpenAI usa GPT-6 Luna mediante un endpoint dedicado; TypeSafe Jev es un modelo especializado System One. Jev es más barato según las tarifas publicadas por token de entrada ($0.042 frente a $0.10 por millón), mientras que OpenAI tiene soporte nativo de imágenes. Las cifras de los proveedores aquí revisadas no establecen un ganador en precisión o velocidad en comparativa directa.
Puntos clave
- Precios: Jev es un 58% más barato por token de entrada a las tarifas base publicadas.
- Arquitectura: OpenAI Decisions API usa GPT-6 Luna; Jev está diseñado específicamente para procesamiento de decisiones.
- Modalidad: OpenAI admite texto e imágenes; Jev se centra en texto y entradas estructuradas.
- Benchmarks: Las afirmaciones de velocidad usan líneas base distintas; compare en el mismo conjunto etiquetado.
- Selección: Priorice soporte multimodal e integración con OpenAI, o rendimiento en texto y costo, según su aplicación.
De un vistazo: OpenAI Decisions API vs Jev
La siguiente vista general compara los endpoints de decisión documentados y las tarifas base publicadas, verificadas el 12 de octubre de 2026. El acceso al modelo, los límites y las condiciones del servicio deben verificarse para la cuenta de despliegue.
| Característica | OpenAI Decisions API | TypeSafe Jev |
|---|---|---|
| Proveedor | OpenAI | TypeSafe AI |
| Motor | GPT-6 Luna | Jev System One |
| Endpoint | POST /v1/decisions | POST /v1/systemone |
| Identificador de modelo | gpt-6-luna | jev-1.13.0 / jev-latest |
| Entradas | Texto + imágenes | Texto / texto estructurado |
| Tipos de pregunta | Predicate (probabilidad de condición), choice (categoría), score (rúbrica) | Noul (probabilidad de condición), choice (categoría), score (niveles) |
| Preguntas en la solicitud | Array con nombres | Objeto indexado por ID |
| Límite de contexto | No especificado en la guía enlazada de Decisions | 64K total; state + pregunta más larga ≤32K |
| Costo base de entrada / 1M | USD 0.10 | USD 0.042 |
| Costo de tokens de salida | Sin cargo | Sin cargo |
| Declaración de velocidad | Aproximadamente 10× más rápido que Responses API | 70–500 ms de extremo a extremo |
| Disponibilidad | Beta pública | Acceso temprano en el anuncio de lanzamiento; verificar acceso actual |
| Ventaja distintiva | Decisiones basadas en imágenes | Menor costo publicado por token de entrada |
| Razonamiento/código generativo | No es el contrato de salida de este endpoint | No es el contrato de salida de este endpoint |
Muchas canalizaciones de IA necesitan una categoría, probabilidad o puntaje, no un párrafo. Un ticket de soporte necesita enrutamiento; un agente debe seleccionar una acción aprobada; una cola de revisión debe identificar entradas inciertas. Ambos productos convierten estas decisiones en salidas de API de primera clase.
OpenAI lanzó la Decisions API en beta el 6 de octubre de 2026. Su endpoint GPT-6 Luna acepta texto e imágenes. Jev es el modelo System One especializado de TypeSafe AI para evaluación no generativa, con un enfoque de entrenamiento descrito como Reinforcement Learning for Calibrated Decisions (RLCD).
Los tipos de pregunta de la tabla cubren tres tareas compartidas. El predicate de OpenAI y el noul de Jev estiman si una condición es verdadera, como intención de reembolso o elegibilidad. Choice selecciona entre categorías predefinidas, como Billing, Technical y Shipping, para enrutamiento. Score evalúa una entrada frente a una rúbrica o niveles, como urgencia o prioridad. Estas descripciones consolidan las dos reseñas de producto; los esquemas de solicitud y la semántica de probabilidades siguen requiriendo manejo específico por proveedor.
¿Qué son OpenAI Decisions API y Jev?
OpenAI Decisions API y TypeSafe Jev son servicios de IA centrados en decisiones, diseñados para transformar datos de entrada en salidas estructuradas y acotadas en lugar de texto abierto. A diferencia de los modelos de lenguaje tradicionales que generan explicaciones o respuestas conversacionales, estas APIs evalúan preguntas predefinidas y devuelven decisiones, probabilidades o puntajes. Esto las hace especialmente útiles para flujos automatizados como enrutamiento de solicitudes de clientes, clasificación de contenido, evaluación de riesgos y selección de herramientas por agentes de IA, donde se requieren salidas predecibles y procesamiento eficiente.
OpenAI Decisions API está impulsada por GPT-6 Luna y opera mediante el endpoint /v1/decisions. Admite entradas de texto e imagen, con tres tipos de decisión: predicate, choice y score. Su principal ventaja es combinar la comprensión contextual de un modelo de propósito general con una interfaz de decisión dedicada, lo que la hace adecuada para clasificación multimodal y aplicaciones ya integradas en el ecosistema de OpenAI.
TypeSafe Jev, en contraste, es un modelo de decisiones especializado al que se accede a través del endpoint /v1/systemone. Se centra en evaluación basada en texto con tres tipos de pregunta: noul, choice y score. Jev enfatiza la inferencia eficiente, las predicciones estructuradas y la calibración de probabilidades, lo que lo convierte en una opción atractiva para clasificación de alto volumen y canalizaciones de decisión automatizadas. Aunque ambos servicios abordan problemas similares, sus diferencias en arquitectura, capacidades de entrada, precios y diseño de API pueden influir significativamente en cuál se adapta mejor a una aplicación concreta.
Enfoque del modelo, límites de entrada y alcance
La comparación se refiere al comportamiento de API documentado y al posicionamiento del producto. OpenAI expone GPT-6 Luna a través de un endpoint de decisión, mientras que TypeSafe presenta Jev como un modelo System One especializado. Estas descripciones por sí solas no establecen una ventaja de precisión ni revelan todos los detalles de implementación.
Jev permite 64K tokens en toda la solicitud, con un límite separado de 32K para state más la pregunta más larga. Cuente las instrucciones y criterios de las preguntas, así como la entrada compartida. La guía enlazada de OpenAI Decisions no indica un límite numérico de contexto separado para este endpoint; verifique los límites aplicables en lugar de asumir que la ventana de contexto general del modelo se aplica sin cambios.
Los benchmarks de razonamiento generativo y codificación quedan fuera del alcance de estos endpoints de decisiones acotadas. Para generar explicaciones o código, evalúe un endpoint generativo adecuado por separado. Los resultados del modelo de propósito general subyacente no establecen el rendimiento del endpoint de Decisions.
Precisión y latencia
Los materiales citados de los proveedores no ofrecen una prueba directa y emparejada que establezca un ganador en precisión o latencia. La afirmación de aproximadamente 10× de velocidad de OpenAI compara Decisions con su Responses API. TypeSafe informa 70–500 ms de latencia de extremo a extremo y dice que sus evaluaciones publicadas generalmente se ejecutaron desde un portátil en el oeste de Estados Unidos.
| Métrica | OpenAI Decisions API | Jev | Evaluación |
|---|---|---|---|
| Precisión cara a cara | No hay prueba emparejada en las fuentes citadas | No hay prueba emparejada en las fuentes citadas | Sin ganador |
| Velocidad | Afirmación relativa del proveedor | Rango absoluto del proveedor | No directamente comparable |
| Calibración | Probabilidades; confianza separada para choice/score | Probabilidades; confianza derivada para choice/score | Medir calibración observada |
| Clasificación de texto | Compatible | Compatible | Ambos viables |
| Clasificación visual | Imágenes nativas | Sin imágenes nativas | Ventaja de OpenAI |
Calibración de probabilidades y umbrales de revisión
Un modelo puede ser preciso pero estar mal calibrado. Entre las predicciones con probabilidad 0.90 para la clase seleccionada, aproximadamente el 90% debería ser correcto si esa probabilidad está calibrada en la distribución de evaluación. No sustituya un campo de API denominado confidence por esta probabilidad sin revisar su definición. Jev deriva su confidence para Choice de la distribución de probabilidad: confidence = (p_max − 1/n) / (1 − 1/n), donde n es el número de opciones. Su resultado Noul no tiene un campo confidence separado. Mida ECE y Brier score a partir de las probabilidades apropiadas, junto con precision, recall y macro F1; elija los umbrales de revisión con ejemplos etiquetados.
Precios y costo por decisión aceptada
OpenAI publica $0.10 por millón de tokens de entrada para /v1/decisions; Jev publica $0.042 por millón de tokens de entrada. Ambos indican sin cargo por tokens de salida para estos servicios de decisión. Con esas tarifas base, Jev es un 58% más barato por token de entrada. Pueden aplicar recargos regionales de procesamiento y multiplicadores por contexto largo en OpenAI; los reintentos, el preprocesamiento y la revisión pueden añadir costos a la canalización.
Suponga que cada solicitud usa 500 tokens facturables de entrada en ambos servicios. Estos cálculos son ilustrativos, no facturas del proveedor.
| Decisiones mensuales | Tokens de entrada | Costo OpenAI | Costo Jev | Diferencia |
|---|---|---|---|---|
| 10,000 | 5M | $0.50 | $0.21 | $0.29 |
| 100,000 | 50M | $5.00 | $2.10 | $2.90 |
| 1,000,000 | 500M | $50 | $21 | $29 |
| 10,000,000 | 5B | $500 | $210 | $290 |
| 100,000,000 | 50B | $5,000 | $2,100 | $2,900 |
Costo por decisión aceptada correcta = (gasto en API + gasto en reintentos + gasto en revisión humana) / número de decisiones aceptadas correctas. Una tarifa baja por token puede verse compensada por una mayor tasa de enroutamientos erróneos o escalaciones.
Para un flujo convencional con GPT-6 Luna, la tabla de precios de modelos de CometAPI lista las siguientes tarifas en USD por millón de tokens, verificadas el 12 de octubre de 2026. Son tarifas por modelo-endpoint; la página enlazada muestra un ejemplo de Responses API y no establece soporte nativo de /v1/decisions ni su precio.
| Nivel publicado | Entrada / 1M tokens | Salida / 1M tokens |
|---|---|---|
| Contexto corto (condición de página: ≤272,000 tokens) | $0.08 | $0.40 |
| Contexto largo (según se indica en la página) | $0.16 | $0.60 |
Los tokens de salida en un uso ordinario de GPT-6 Luna en CometAPI se facturan. Mantenga esta estimación separada de los dos servicios de decisión anteriores, cuyos cargos por tokens de salida publicados son cero. Por ejemplo, 500 tokens de entrada más 20 tokens de salida cuestan $0.000048 por solicitud de contexto corto, o $48 por millón de solicitudes, antes de otros cargos. Confirme el nivel aplicable y la tarifa de cuenta en el catálogo de modelos en vivo antes de presupuestar.
Flujos de agentes y compensaciones de modalidad
Ambos pueden enrutar una llamada de herramienta, evaluar si se cumple una condición de guardia o puntuar una acción. Ninguno reemplaza la autorización, la validación de entradas ni los permisos explícitos de herramientas. Para automatización visual, el soporte nativo de imágenes de OpenAI simplifica la canalización; para enrutamiento puramente textual, el menor costo base de Jev puede ser atractivo.
El manejo de salidas difiere en el límite de respuesta. OpenAI devuelve un answers array, con names que identifican preguntas; Jev devuelve un answers object indexado por ID de pregunta. Normalice estas estructuras antes de aplicar reglas de negocio compartidas. Jev deriva confidence de su distribución de probabilidad; no asuma que campos con el mismo nombre tienen significados equivalentes entre proveedores. Valide etiquetas y calibre los umbrales de revisión con datos de la aplicación.
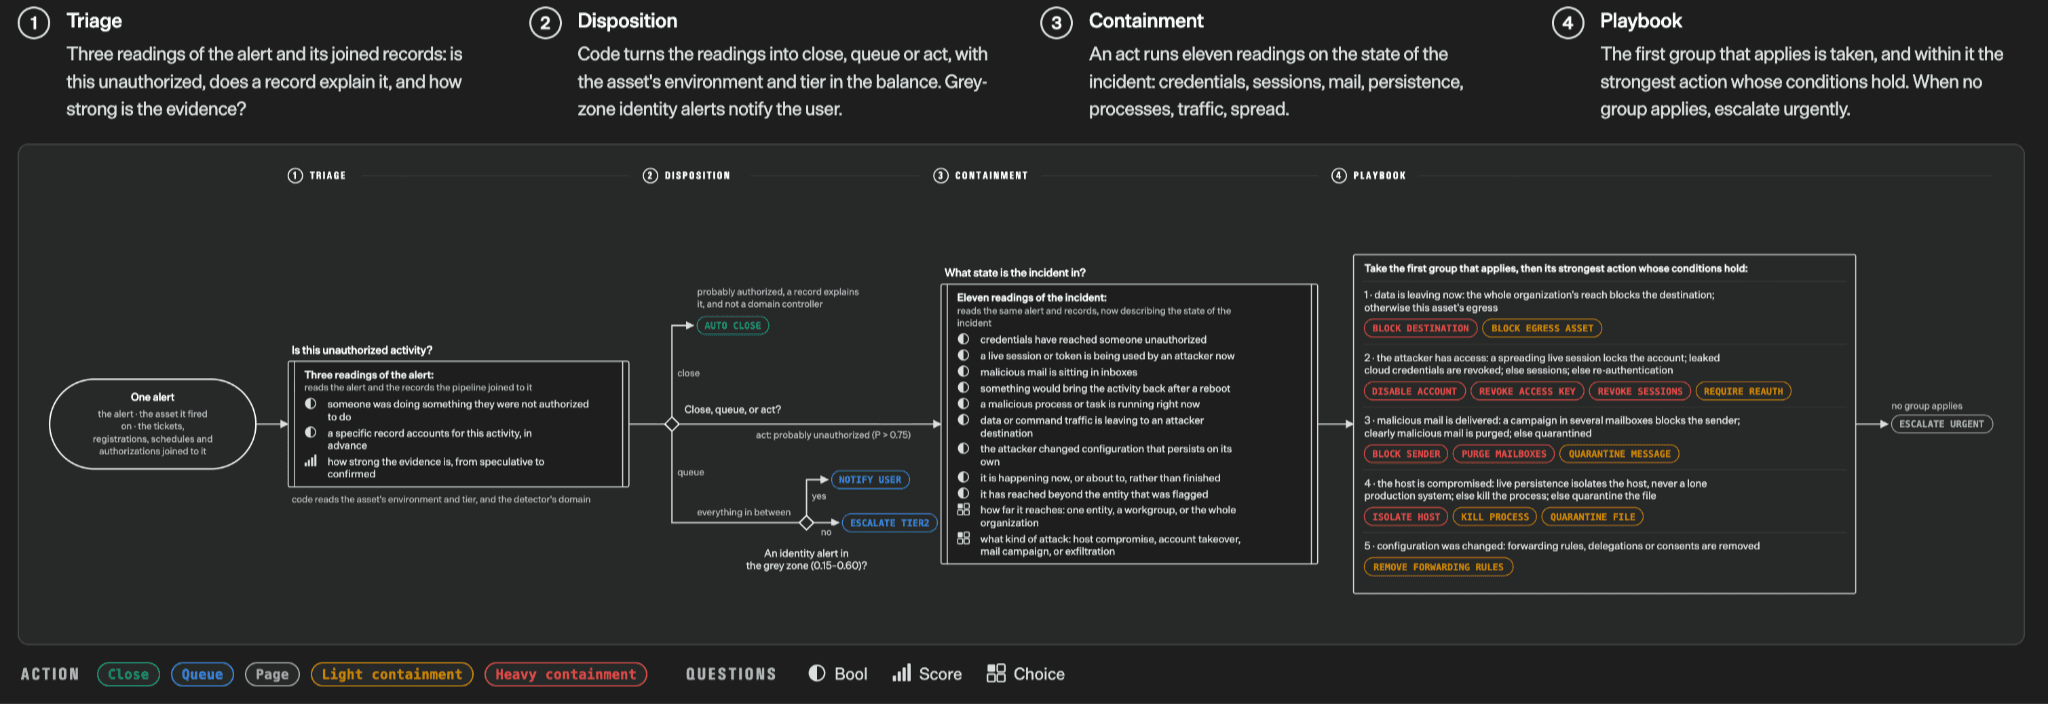
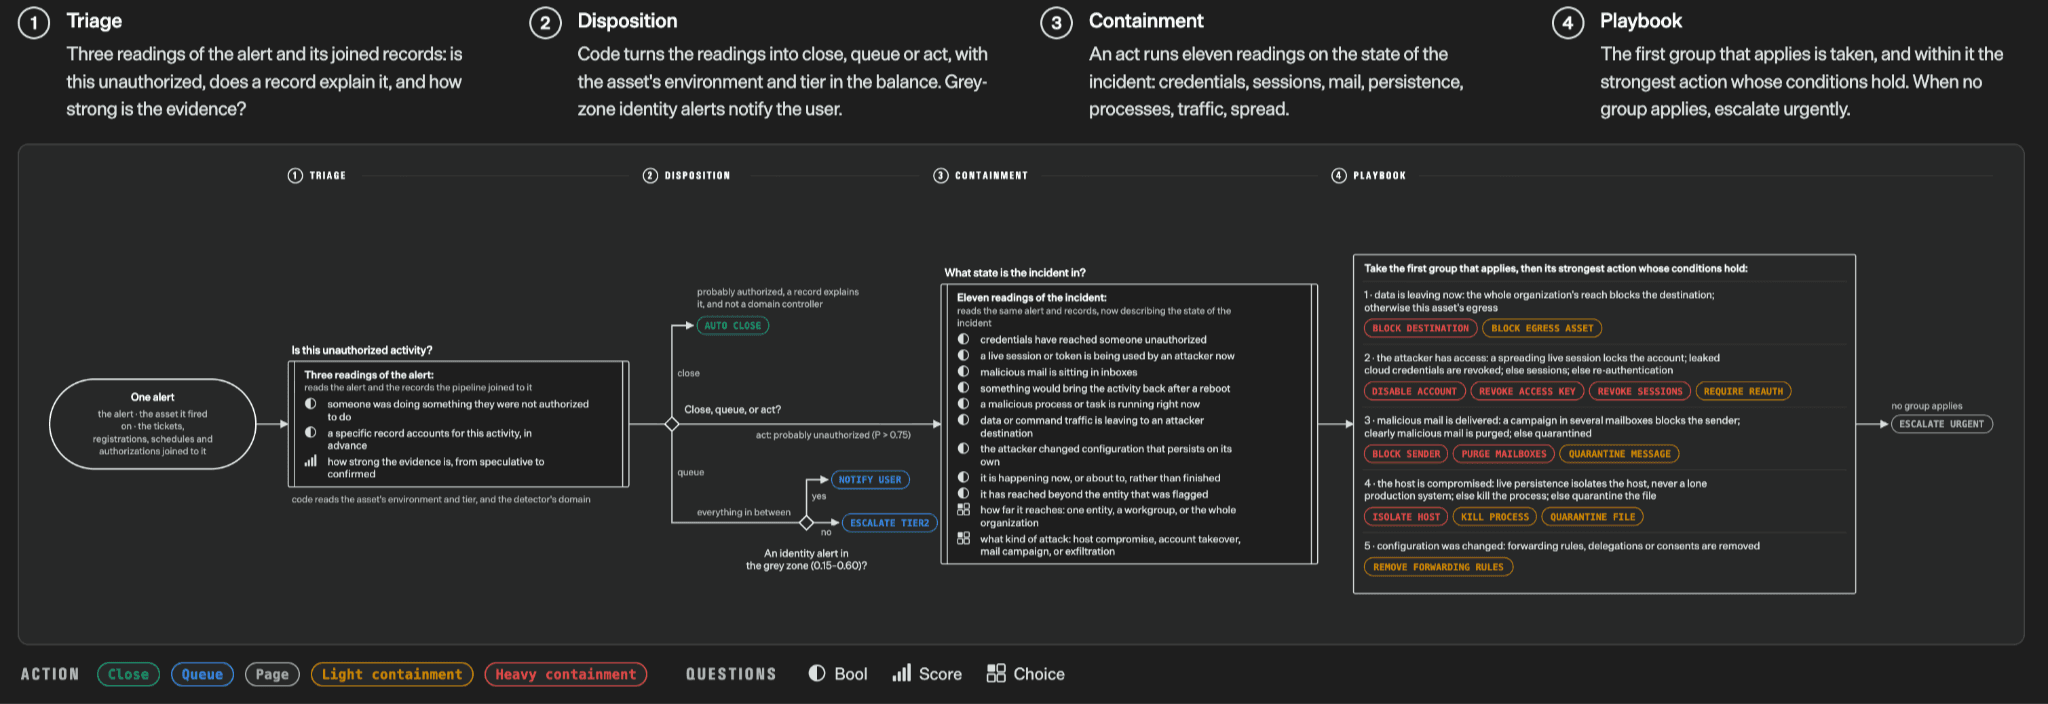
Fuente: Introducing System One Models & Jev; imagen original. Esto ilustra la composición del flujo de trabajo, no un benchmark emparejado contra OpenAI Decisions API.
Cómo difiere el uso de la API: OpenAI Decisions API vs Jev
El acceso debe configurarse por separado para cada proveedor: cada ejemplo a continuación usa su propio host y clave de API. OpenAI documenta Decisions como un endpoint en beta pública. Para Jev, confirme el acceso y las credenciales actuales con TypeSafe antes del despliegue. En cualquiera de los servicios, verifique permisos de cuenta, disponibilidad regional, cuotas y condiciones del servicio; un ejemplo de solicitud no garantiza acceso en producción. El acceso de terceros a un modelo generativo no confirma por sí mismo el soporte para su endpoint de decisiones nativo.
Cómo usar OpenAI Decisions API
Los conceptos se superponen, pero los esquemas de solicitud difieren. OpenAI envía input y un array de preguntas con nombre; Jev usa state y un objeto questions indexado por ID. Implemente un adaptador específico por proveedor antes de aplicar una política de decisión compartida.
Enrute un ticket de soporte con OpenAI Decisions API.
curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "I was charged twice for my order.",
    "questions": [{
      "type": "choice", "name": "department",
      "instructions": "Which team should handle this?",
      "choices": [
        {"value":"billing","description":"Charges and refunds"},
        {"value":"technical","description":"Product errors"},
        {"value":"other","description":"Other requests"}
      ]
    }]
  }'
Cómo usar Jev API
La siguiente solicitud cURL usa el endpoint System One de Jev para clasificar un ticket de soporte. Defina TYPESAFE_API_KEY en su entorno, coloque el ticket en state y defina department dentro del objeto questions. Su mapa criteria lista las etiquetas de enrutamiento permitidas y sus descripciones. Tras el éxito de la solicitud, lea la entrada department en answers y valide la etiqueta seleccionada antes de enrutar el ticket. Confirme que el identificador del modelo está disponible para su cuenta.
Enrute un ticket de soporte con TypeSafe Jev.
curl https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-1.13.0",
    "state": "I was charged twice for my order.",
    "questions": {
      "department": {
        "type": "choice",
        "instructions": "Which team should handle this?",
        "criteria": {
          "billing":"Charges and refunds",
          "technical":"Product errors",
          "other":"Other requests"
        }
      }
    }
  }'
| Elemento de integración | OpenAI | Jev |
|---|---|---|
| Entrada | input | state |
| Preguntas | Array | Keyed object |
| ID de pregunta | name | Object key |
| Pregunta binaria | predicate | noul |
| Opciones | choices | criteria |
| Forma de respuesta | answers array | answers object |
Política de revisión compartida para probabilidades de la clase seleccionada
Aplique un umbral explícitamente calibrado a la probabilidad de la clase seleccionada.
from dataclasses import dataclass
from math import isfinite

@dataclass
class NormalizedDecision:
    label: str | None
    selected_probability: float | None
    provider: str
    needs_review: bool

def apply_review_policy(label, selected_probability, provider, threshold):
    if not isfinite(threshold) or not 0.0 <= threshold <= 1.0:
        raise ValueError("threshold must be between 0 and 1")
    valid_probability = (
        selected_probability is not None
        and isfinite(selected_probability)
        and 0.0 <= selected_probability <= 1.0
    )
    return NormalizedDecision(
        label=label,
        selected_probability=selected_probability,
        provider=provider,
        needs_review=(
            not label
            or not valid_probability
            or selected_probability < threshold
        ),
    )
Este ejemplo para Python 3.10+ es una capa de política de aplicación, no un parser de la respuesta de API. Cada adaptador de proveedor debe validar la respuesta y extraer la probabilidad de la clase seleccionada. No pase el campo confidence sin procesar de Jev como selected_probability. Suministre un umbral calibrado para ese proveedor, pregunta y conjunto de evaluación; maneje rechazos y errores de transporte antes de llamar a la política.
OpenAI Decisions API vs Jev: cómo elegir
Elija en dos etapas. Primero, filtre por requisitos de despliegue: entrada de imágenes, acceso de cuenta, límites de entrada y esfuerzo de integración. Luego haga benchmarks de los servicios elegibles en la misma carga etiquetada. Para enrutamiento solo de texto, pruebe si el menor precio publicado por token de Jev se traduce en menor costo total; para decisiones dependientes de imágenes, evalúe la ruta nativa de imagen de OpenAI. Compare enroutamientos erróneos, calibración, latencia en cola, reintentos y revisión humana con un objetivo de calidad acordado. La tabla a continuación es una lista corta inicial, no evidencia de un ganador de rendimiento general.
| Caso de uso | OpenAI Decisions API | Jev | Recomendación práctica |
|---|---|---|---|
| Enrutamiento de soporte | Compatible | Compatible | Evaluar primero Jev por costo |
| Clasificación de texto | Compatible | Compatible | Comparar calibración |
| Inspección de capturas | Nativo | Requiere preprocesamiento de visión | OpenAI |
| Selección de herramienta por agente | Compatible | Compatible | Medir resultados de extremo a extremo |
| Moderación multimodal | Texto e imágenes | Solo texto | OpenAI |
| Stack existente de OpenAI | Nativo | Nueva integración | OpenAI |
Para automatización empresarial de alto volumen, como enrutamiento de soporte y clasificación de texto, Jev merece prioridad cuando el costo por entrada y el rendimiento son preocupaciones clave. Para aplicaciones multimodales, incluidas inspección de capturas, moderación visual y decisiones basadas en imágenes, OpenAI Decisions API es la opción más práctica por su soporte nativo de imágenes. Para agentes de IA y flujos empresariales, la elección depende de la infraestructura existente, la complejidad de integración y las consecuencias de decisiones incorrectas. OpenAI puede ofrecer un camino más fluido para equipos que ya usan su ecosistema, mientras que Jev merece consideración para cargas de trabajo a gran escala y centradas en texto. En todos los escenarios, la decisión final debe basarse en precisión medida, calibración de probabilidades, latencia y costo operativo total, no solo en precios de portada.
¿Cómo debe evaluar OpenAI Decisions API frente a Jev?
Ejecute ambos servicios sobre las mismas entradas reales etiquetadas, con definiciones de pregunta coincidentes y regiones de cliente emparejadas. Rastree precisión, macro F1, ECE, Brier score, latencia p50/p95/p99, timeouts, rechazos, tasa de revisión y costo en dólares por decisión correcta aceptada.
| Dimensión | Métricas recomendadas | Por qué importa |
|---|---|---|
| Clasificación | Accuracy, precision, recall, macro F1 | Calidad de las etiquetas |
| Calibración | ECE, Brier score | Fiabilidad de las probabilidades |
| Latencia | p50 / p95 / p99 | Capacidad de respuesta |
| Fiabilidad | Tasa 429 / timeouts / rechazos | Comportamiento en producción |
| Economía | Costo por decisión correcta aceptada | Gasto operativo real |
Procedimiento sugerido: construya un conjunto etiquetado representativo; incluya casos ambiguos y fuera de distribución; envíe tareas semánticamente idénticas; repita lo suficiente para medir varianza; calibre los umbrales de cada sistema de forma independiente; y compare el costo de extremo a extremo, incluyendo escalaciones y reintentos.
Conclusión
Elija OpenAI Decisions API cuando la decisión dependa de evidencia de imagen o cuando una integración existente con OpenAI reduzca el trabajo de despliegue. Evalúe Jev para cargas de trabajo de decisiones solo de texto, donde su tarifa publicada más baja por token de entrada puede reducir el gasto de inferencia. Mida calidad de etiquetas, calibración, latencia en cola y carga de revisión en los mismos datos de la aplicación antes de elegir.
Jev tiene el precio base publicado más bajo por token de entrada; OpenAI Decisions API tiene entrada nativa de imágenes. Las cifras citadas de los proveedores no establecen un ganador general en precisión o velocidad. La mejor opción depende del costo y la calidad de las decisiones aceptadas en la canalización completa.
Los desarrolladores pueden usar la GPT-6 Luna API en CometAPI para prototipar clasificación ligera en un flujo de trabajo multimodelo más amplio. La página del modelo enlazada proporciona un ejemplo de Responses API. El acceso a ese endpoint generativo no establece soporte para el endpoint dedicado /v1/decisions. Este es un prototipo convencional de generación de texto. No devuelve el esquema de respuestas nativo de Decisions ni una distribución de probabilidad de clase calibrada. Valide la etiqueta devuelta frente a las categorías permitidas y maneje errores de API antes de conectarlo a acciones posteriores. Confirme por separado el soporte nativo de /v1/decisions si se requiere ese endpoint.