



TL;DR
La caché de prompts permite que los modelos de lenguaje reutilicen prefijos de prompt previamente procesados en lugar de repetir el mismo cómputo de entrada. Puede reducir el costo de tokens de entrada y mejorar la latencia, especialmente para flujos de trabajo de agentes, soporte al cliente, RAG y análisis de documentos extensos. En 2026, OpenAI ofrece caché automática y nuevos controles explícitos de caché, Claude admite puntos de ruptura automáticos y a nivel de bloque, y Gemini enfatiza la caché implícita en sus modelos más recientes. Los proveedores cobran de forma distinta por escrituras, lecturas y, cuando aplica, almacenamiento de la caché. La expiración puede provocar otra escritura o un cargo completo por la entrada, por lo que el ahorro real depende de la frecuencia de reutilización y de los aciertos de caché medidos.
Esta guía compara la caché de prompts en GPT-6.1 Sol, Claude Opus 5.5 y Gemini 4 Argon para desarrolladores que crean aplicaciones con entrada repetida. Se centra en los controles de caché, precios y cómo verificar la reutilización.
Key Takeaways
- La caché de prompts reutiliza la entrada procesada, no la respuesta anterior del modelo.
- La caché de prompts de OpenAI depende de un prefijo estable, de funciones compatibles del modelo y de mínimos y retenciones específicos del modelo.
- La caché de prompts de Claude ofrece TTL de 5 minutos y opcional de 1 hora, con control de caché automático y explícito.
- La caché de contexto en Gemini es implícita en los modelos modernos; los recursos de caché explícitos siguen siendo dependientes del modelo.
- Los ahorros con caché dependen de escrituras, lecturas, almacenamiento y aciertos reales; verifica la compatibilidad del endpoint y la facturación de tokens en caché cuando uses CometAPI.
What Is Prompt Caching in LLMs?
La caché de prompts es una optimización de inferencia que permite reutilizar el estado computacional derivado de un prefijo previamente procesado. Un prompt suele contener instrucciones estables, definiciones de herramientas o documentos, seguidos de una pregunta cambiante del usuario. Si una solicitud posterior repite el prefijo elegible, el proveedor puede reutilizar estados de clave-valor (KV) en caché y procesar solo la parte restante no cacheada. A diferencia de la caché de respuestas, esto no reproduce una respuesta anterior: el modelo genera una nueva respuesta para la solicitud actual.
Flujo de trabajo de la caché de prompts:
- Primera solicitud: envía un prefijo grande y repetible y una pregunta específica.
- Creación de la caché: el proveedor almacena el estado computacional intermedio elegible.
- Siguiente solicitud: reutiliza el prefijo idéntico y reemplaza la pregunta.
- Lectura de caché: los tokens procesados anteriormente se reutilizan mientras que los tokens nuevos se procesan de forma normal.
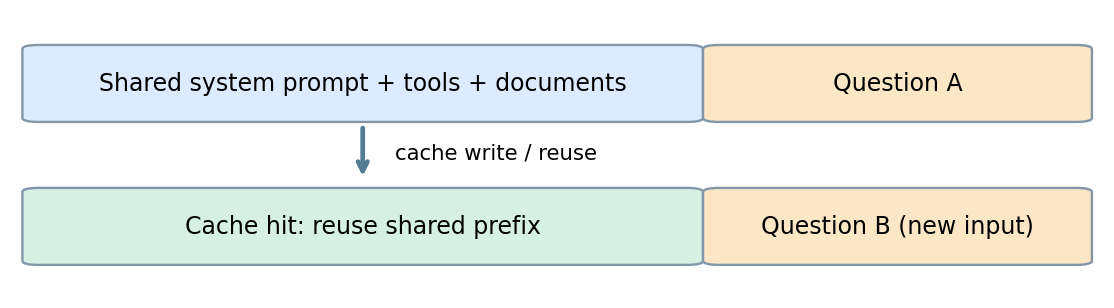
Ilustración conceptual suministrada con el borrador original: material de prompt repetido precede a una pregunta cambiante. No es un diagrama oficial de arquitectura de ningún proveedor.
El principio de diseño común es la estabilidad del prefijo. Los contratos de API, familias de modelos elegibles, vida útil de la caché y tarifas no son intercambiables.
OpenAI, Claude, and Gemini Caching at a Glance
El mismo principio de prefijo estable se aplica en todos los proveedores, pero los controles a continuación son específicos de los modelos usados en esta guía. Verifica el modelo y el endpoint en conjunto antes de copiar una configuración.
Prompt Caching Controls and Python Examples
Cada ejemplo envía el mismo material de referencia con dos preguntas diferentes. Mantén el contenido compartido sin cambios, ejecuta las solicitudes secuencialmente e inspecciona el uso para ver si la segunda solicitud realmente reutilizó la entrada en caché.
OpenAI: Cache Controls and Python Example
OpenAI hace coincidir automáticamente los prefijos de prompt elegibles para caché y, en modelos recientes compatibles, permite configurar explícitamente puntos de ruptura y retención. La reutilización de caché es especialmente útil cuando instrucciones de sistema extensas, esquemas de herramientas o contexto de repositorio se repiten entre solicitudes. La longitud de prefijo requerida y los multiplicadores de precio por token dependen de la generación del modelo y del nivel de retención seleccionado.
El ejemplo usa la Responses API con prompt_cache_options en modo implícito y una vida útil de 30 minutos. Generaciones anteriores de modelos usan parámetros de retención diferentes; sigue la configuración de tu modelo exacto.
Instala el SDK de openai y define OPENAI_API_KEY. Usa al menos 1,024 tokens visibles en el prefijo estable. Ejecuta ambas solicitudes secuencialmente e inspecciona input_tokens_details.cached_tokens y cache_write_tokens en usage. Un conteo positivo de tokens en caché confirma una lectura de caché facturada; no garantiza menor latencia en cada solicitud.
Para ejecutar los ejemplos, instala el SDK de Python correspondiente, define la clave de API del proveedor y crea un archivo UTF-8 reference.txt con suficiente contenido estable para cumplir el mínimo de caché de ese modelo.
from pathlib import Path
from openai import OpenAI

client = OpenAI()  # Reads OPENAI_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
questions = ["Summarize the architecture.", "Identify the main technical risks."]
for question in questions:
    response = client.responses.create(
        model="gpt-6.1-sol",
        instructions="Use the following reference material.\n" + shared,
        input=question,
        prompt_cache_key="docs-assistant-v1",
        prompt_cache_options={"mode": "implicit", "ttl": "30m"},
    )
    print(response.output_text)
    print(response.usage)
Claude: Cache Controls and Python Example
En la Messages API de Claude, la caché de prompts es opt-in. Agrega cache_control a nivel de solicitud para colocar automáticamente el punto de ruptura, o adjúntalo a un bloque de contenido para marcar un punto de ruptura explícito. Los desarrolladores pueden marcar instrucciones estables, documentos y bloques de prompt seleccionados, mientras cambian la entrada posterior del usuario. La caché estándar de corta duración es de cinco minutos, con una opción de una hora para cargas de trabajo adecuadas.
Las formas y mínimos admitidos están documentados en la guía oficial de caché de prompts de Claude
Instala el SDK de anthropic y define ANTHROPIC_API_KEY. Para Claude Opus 5.5, proporciona al menos 512 tokens antes del límite de caché. Mantén el bloque de sistema idéntico entre solicitudes. Una entrada de caché pasa a estar disponible cuando comienza la primera respuesta; este ejemplo espera a la respuesta completa para simplificar la demostración. Inspecciona los conteos de creación y lectura de caché; un prefijo corto puede devolver cero en ambos sin generar error.
from pathlib import Path
import anthropic

client = anthropic.Anthropic()  # Reads ANTHROPIC_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Summarize the architecture.", "Identify the main technical risks."]:
    response = client.messages.create(
        model="claude-opus-5-5",
        max_tokens=1024,
        system=[{
            "type": "text",
            "text": shared,
            "cache_control": {"type": "ephemeral"},
        }],
        messages=[{"role": "user", "content": question}],
    )
    print(response.content)
    print(response.usage.cache_creation_input_tokens)
    print(response.usage.cache_read_input_tokens)
Gemini: Implicit Caching and Python Example
Google llama a su implementación caché de contexto. Gemini 4 Argon usa caché implícita y no admite recursos de caché explícitos. Algunas familias de modelos anteriores admiten cachés explícitas con TTL configurable. Elige la interfaz de caché según el contrato del modelo individual en lugar de asumir que todos los modelos Gemini exponen los mismos controles.
Consulta la guía oficial de caché de contexto de Gemini
Instala google-genai y define GEMINI_API_KEY. Usa al menos 4,096 tokens de contenido inicial compartido para Gemini 4 Argon y envía la segunda solicitud poco después de la primera. Inspecciona cached_content_token_count en usage_metadata cuando esté presente. La caché implícita puede fallar incluso cuando el prefijo es elegible.
from pathlib import Path
from google import genai

client = genai.Client()  # Reads GEMINI_API_KEY
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Summarize the architecture.", "Identify the main technical risks."]:
    response = client.models.generate_content(
        model="gemini-4-argon",
        contents=shared + "\nQuestion: " + question,
    )
    print(response.text)
    print(response.usage_metadata)
How Much Does Prompt Caching Cost Across OpenAI, Claude, and Gemini?
Los costos de caché deben evaluarse como la combinación de escrituras, lecturas y—en algunos sistemas con caché explícita—retención o almacenamiento. Los multiplicadores siguientes ilustran diseños comunes y no son promesas de precio universales en todas las versiones de modelos.
Ejemplo ilustrativo: se reutiliza un prefijo de 10,000 tokens a lo largo de N solicitudes; su escritura inicial en caché cuesta 1.25 veces la entrada ordinaria, y las lecturas de caché posteriores cuestan 0.1 veces la entrada ordinaria. Supón un precio base de entrada de $2 por millón de tokens y aciertos perfectos de caché después de la primera solicitud.
| Número de solicitudes | Sin caché | Con caché | Ahorro en el prefijo reutilizado |
|---|---|---|---|
| 10 | $0.200 | $0.043 |
Fórmula: Costo del prefijo en caché = 1.25P + (N − 1) × 0.1P, donde P es el costo ordinario de procesar el prefijo compartido una vez. Este ejemplo excluye entrada dinámica, salida, expiraciones, fallos de caché, almacenamiento y otros servicios.
El ejemplo anterior usa una tasa de lectura ilustrativa del 10%, no la tasa actual de GPT-6.1 Sol. La tarificación estándar de Sol para contexto corto es de $2 por millón de tokens de entrada no cacheados, $0.10 por millón de tokens de entrada cacheados y $2.50 por millón de tokens escritos con la vida útil predeterminada. Recalcula el ejemplo usando tu modelo, nivel y facturación de endpoint reales.
Una vida útil más larga solo compensa cuando evita suficientes escrituras repetidas o solicitudes sin caché como para compensar su precio. Las escrituras de 5 minutos y 1 hora de Claude se cobran a 1.25× y 2× la entrada base, respectivamente. Las cachés explícitas de Gemini en modelos anteriores compatibles también pueden incurrir en cargos de almacenamiento. Mide la reutilización a lo largo de intervalos reales de inactividad, no solo en una ráfaga de llamadas consecutivas.
Considera fallos, expiración y generación de salida como parte de la factura. Si un prefijo expira antes de que se reutilice, la siguiente solicitud puede requerir otra escritura o un procesamiento completo de la entrada. Los prompts cortos pueden no calificar en absoluto, mientras que las respuestas largas pueden convertir los tokens de salida en el mayor gasto incluso con una fuerte reutilización de caché. Compara el costo total por tarea completada antes de añadir más complejidad de caché.
Which Prompt Caching API Is Best for Different Workloads?
Para agentes de programación y soporte al cliente, coloca definiciones de herramientas estables, contexto de repositorios, políticas y conocimiento antes de la tarea cambiante. OpenAI y Claude ofrecen controles de puntos de ruptura que ayudan a definir límites reutilizables; evalúa las lecturas reales de caché del endpoint en lugar de asumir que el texto repetido se cacheó.
Para análisis de documentos y trabajo multimodal, mantén el documento fuente o el medio compatible antes de la pregunta. El enfoque implícito de Gemini reduce el trabajo de gestión de caché, mientras que Claude te permite marcar directamente el bloque estable. Verifica la compatibilidad con el tipo de medio y modelo particular antes de confiar en la reutilización.
Para conversaciones largas, agrega nuevos turnos en lugar de reescribir repetidamente el comienzo, y elige una vida útil disponible que se ajuste a los intervalos entre turnos. Si tu aplicación necesita un recurso de caché nombrado que pueda crear y referenciar explícitamente, evalúa un modelo de Gemini que admita esa interfaz; Argon no lo hace.
No hay un ganador universal: compara la tasa de aciertos de caché, el costo por tarea completada y la latencia según tu patrón de tráfico real.
How Does Prompt Caching Affect Latency and Performance?
Un acierto de caché reduce el procesamiento de entrada repetido y puede acortar el tiempo hasta el primer token. No mejora intrínsecamente la calidad de la respuesta ni acelera la generación de salida, y la entrada cacheada sigue ocupando la ventana de contexto. Mide tanto la latencia hasta el primer token como el tiempo total de respuesta en solicitudes comparables; un acierto de caché por sí solo no es evidencia de que el usuario recibió antes la respuesta final.
How to Optimize Prompt Caching and Troubleshoot Misses
Start with a Stable, Useful Prefix
Coloca primero instrucciones reutilizables, definiciones de herramientas, políticas y documentos; pon después las marcas de tiempo, IDs de solicitud, contexto cambiante y la pregunta del usuario. Mantén el orden de las herramientas y los esquemas estables. Al usar caché explícita, termina el punto de ruptura en el último bloque sin cambios. Agrega material de referencia útil cuando ayude a la tarea; no infles cada solicitud solo para perseguir una métrica de caché.
If Cached Tokens Stay at Zero
Comprueba la elegibilidad antes de cambiar el prompt: confirma el modelo exacto, el endpoint, la longitud mínima de tokens y la configuración requerida de control de caché. Luego envía dos solicitudes secuenciales con el contenido compartido idéntico. Inspecciona por separado la creación de caché y las lecturas; la primera solicitud puede crear la entrada que una solicitud posterior puede reutilizar. Una caché implícita es elegible para acertar, no está garantizada.
Para Claude, una solicitud por debajo del mínimo puede devolver cero tokens de creación y de lectura de caché sin error. Su entrada de caché pasa a estar disponible cuando comienza la primera respuesta. La guía de caché de Claude también explica cómo la colocación del punto de ruptura y el cambio de configuración de la solicitud afectan la reutilización.
If Hits Disappear Between Requests
Compara las cargas útiles reales, no solo la plantilla del prompt. Busca texto de documento cambiado, herramientas reordenadas, esquemas alterados, turnos tempranos de conversación reescritos o campos dinámicos insertados antes del límite reutilizable. Verifica el tiempo transcurrido desde la solicitud anterior y si la vida útil elegida lo cubre. Cambia una variable a la vez y registra el uso resultante.
If Hits Do Not Produce Savings
Separa la entrada en caché, las escrituras, la entrada no cacheada, la salida y cualquier cargo de almacenamiento. Las escrituras repetidas después de períodos de inactividad, la baja reutilización o respuestas generadas largas pueden superar los descuentos de entrada. Usa el cálculo de costos anterior con uso medido y las tarifas reales de facturación del endpoint. Mantén una optimización solo si mejora el costo total de la tarea o la latencia visible para el usuario.
Check Endpoint Support and Data Boundaries
Un endpoint de compatibilidad puede aceptar una solicitud sin exponer los mismos controles de caché o campos de uso que la API nativa. Confirma la compatibilidad de parámetros y compara el uso devuelto con la facturación de la cuenta antes de considerar la reutilización como un ahorro. Mantén el aislamiento de inquilinos y los controles de acceso, y sigue las políticas de retención y procesamiento de datos del proveedor. La caché no reemplaza esos controles.
How Can You Use Prompt Caching with CometAPI?
CometAPI ofrece un único punto de integración para probar solicitudes entre familias de modelos. Para la caché, verifica qué controles específicos del proveedor acepta el endpoint seleccionado y cómo aparece la entrada en caché en el uso y la facturación. Los desarrolladores pueden centralizar pruebas de modelos manteniendo validaciones separadas para el comportamiento de caché y la contabilidad, dado que las opciones nativas del proveedor no están garantizadas como idénticas en endpoints proxy o de compatibilidad.
Para la configuración específica por modelo, consulta las páginas de CometAPI para GPT-6.1 Sol, Claude Opus 5.5 y Gemini 4 Argon. Confirma que el endpoint elegido admite el comportamiento de caché que necesitas.
Instala el SDK de openai y define COMETAPI_KEY. Este ejemplo envía solicitudes con prefijo repetido a través de la interfaz Chat Completions compatible con OpenAI de CometAPI. Confirma la disponibilidad del modelo y luego inspecciona el uso devuelto y la facturación de la cuenta para evidencias de reutilización de caché. No copies parámetros de caché de la Responses API en este endpoint sin verificar su compatibilidad.
import os
from pathlib import Path
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
)
shared = Path("reference.txt").read_text(encoding="utf-8")
for question in ["Summarize the architecture.", "Identify the main technical risks."]:
    response = client.chat.completions.create(
        model="gpt-6.1-sol",
        messages=[
            {"role": "system", "content": shared},
            {"role": "user", "content": question},
        ],
    )
    print(response.choices[0].message.content)
    print(response.usage)
Conclusion
Para aplicaciones de IA con mucha repetición, la caché de prompts puede marcar una diferencia material en la economía de la inferencia. OpenAI ofrece controles cada vez más detallados de prompt y retención; Claude proporciona controles prácticos automáticos y a nivel de bloque; Gemini facilita la reutilización implícita en modelos modernos. La implementación adecuada depende del volumen de prompt estable, la tasa de aciertos, la expiración y el costo total. Comienza con un prefijo compartido claro, verifica la telemetría de uso y luego optimiza la retención y la selección de proveedor usando mediciones similares a producción.
FAQ
¿Cómo puedo comparar de forma justa los proveedores de caché?
Reproduce los mismos documentos fuente útiles y preguntas equivalentes, pero usa los conteos de tokens y las tarifas reales de facturación de cada proveedor. Mantén comparables los requisitos de salida e informa solicitudes fallidas además de las exitosas. Un número fijo de caracteres no implica el mismo número de tokens, así que compara el costo por tarea completada junto con las mediciones de aciertos de caché.
¿Debería cachear cada documento en una base de conocimiento cambiante?
Agrupa los documentos según la frecuencia con la que cambian y con la que se reutilizan. Un documento que se actualiza con frecuencia puede invalidar repetidamente un prefijo compartido grande; colocar primero el material de política estable y después el material cambiante puede reducir esa exposición. Versiona deliberadamente el material fuente y actualízalo cuando la corrección lo requiera, incluso si hacerlo reduce la reutilización de la caché.