Construye con CometAPI¿Necesitas una sola API para varios modelos?Prueba el flujo en el Playground y luego crea una clave de API cuando el modelo y el costo encajen con tu caso de uso.
Predicciones de Qwen 4: fecha de lanzamiento y prueba de referencia
Explora la predicción de la fecha de lanzamiento de Qwen 4, su ventaja inicial en los benchmarks y los modelos, y qué deberían tener en cuenta los desarrolladores en el lanzamiento; verifica si deberías esperar.
lesileEquipo de investigación de modelos de IA y API
Qwen 4 está atrayendo atención tanto por su lanzamiento inminente como por su potencial valor para desarrolladores. Pronosticamos un anuncio en noviembre de 2026, con mediados de noviembre como la primera ventana a observar. Esto ofrece a los usuarios una ventana de lanzamiento más específica, aunque el momento aún espera confirmación oficial. Mientras tanto, el rendimiento de la vista previa Flash en el benchmark de desarrollo de juegos GameFeel está destacando el potencial equilibrio entre capacidad y costo de la próxima generación.
Puntos clave
El reciente teaser oficial de Qwen y las primeras pruebas externas respaldan las expectativas de un anuncio cercano, aunque Alibaba no ha confirmado una fecha.
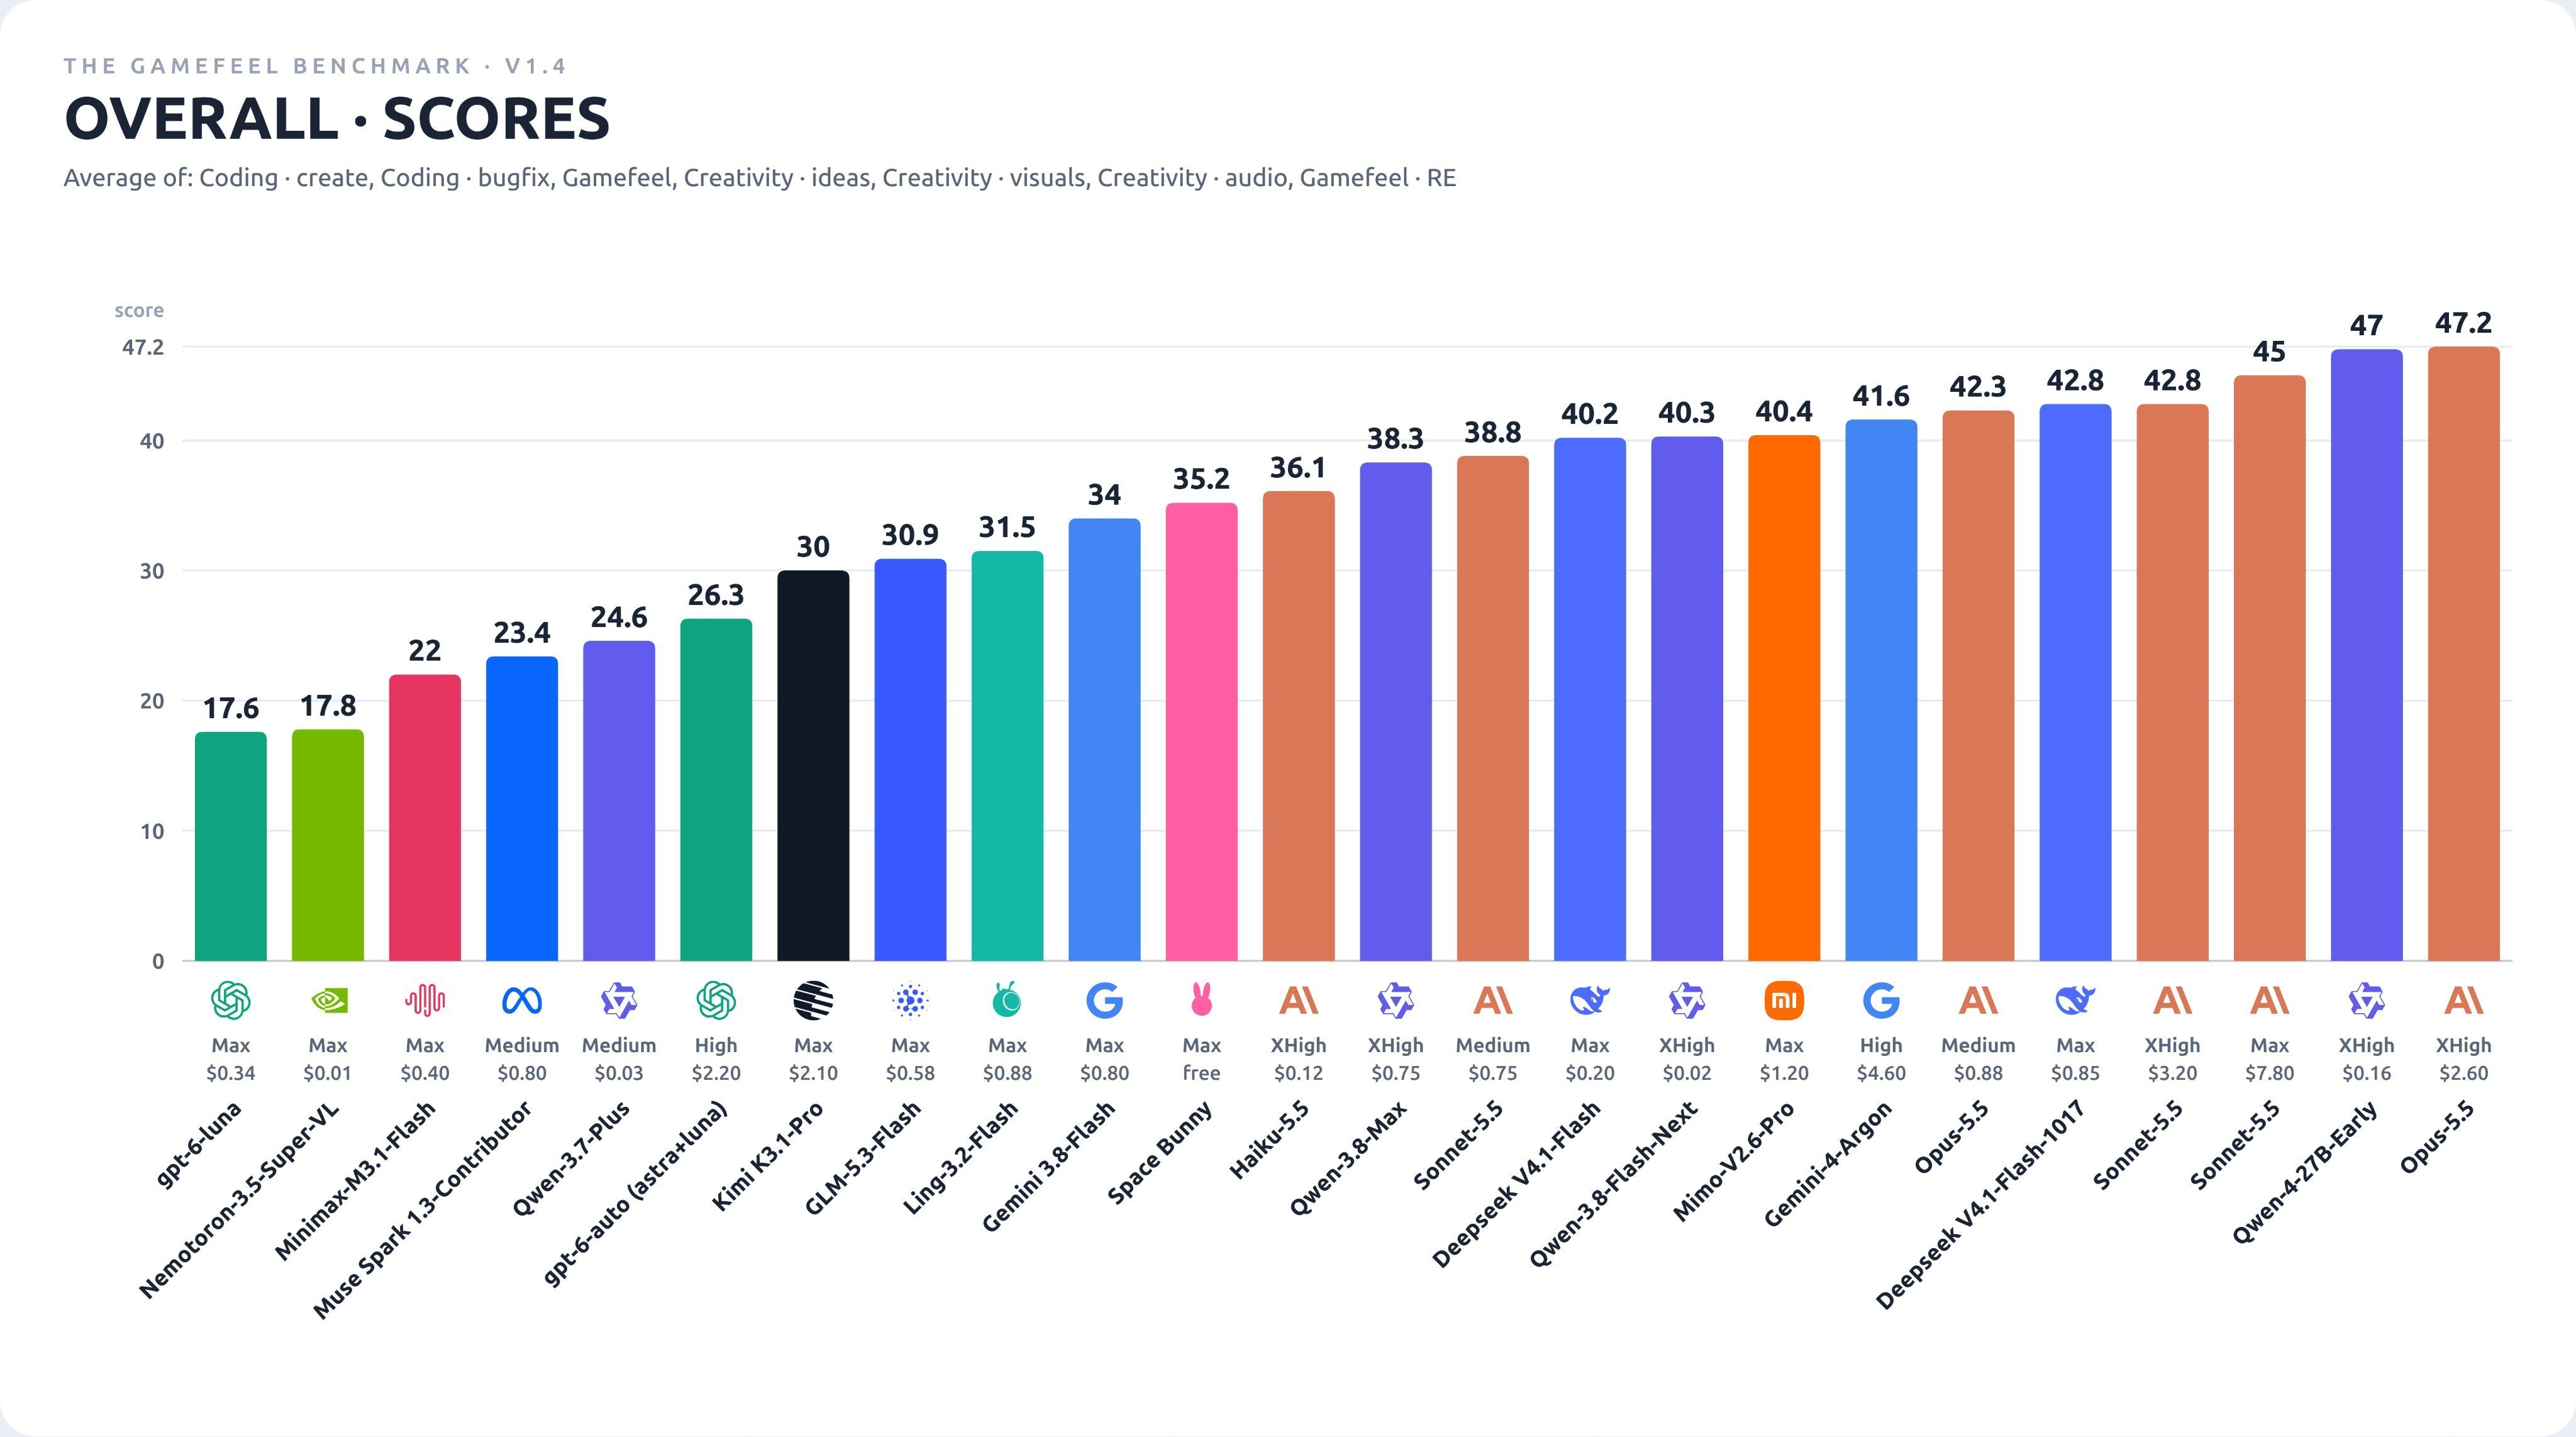
Qwen-4-Flash-Early Max obtuvo 49.9 en GameFeel v1.4, por delante del 47.2 de Claude Opus 5.5 XHigh en la evaluación de desarrollo de juegos.
El benchmark reporta un costo por tarea de $0.40 para Qwen Flash y $2.60 para Opus, lo que sitúa el costo reportado de Flash en aproximadamente una sexta parte del de Opus.
Revisado para mayor claridad, atribución de fuentes y terminología API actual.
El valor práctico de Qwen 4 27B para implementación local dependerá de la disponibilidad de sus pesos, los términos de la licencia y los requisitos de hardware medidos.
¿Cuándo se lanzará Qwen 4?
Quien busque “fecha de lanzamiento de Qwen 4” quiere una estimación útil respaldada por evidencia. Tres desarrollos moldean nuestro pronóstico: un nuevo teaser oficial, pruebas externas de modelos tempranos y una vista previa pública anterior de la arquitectura.
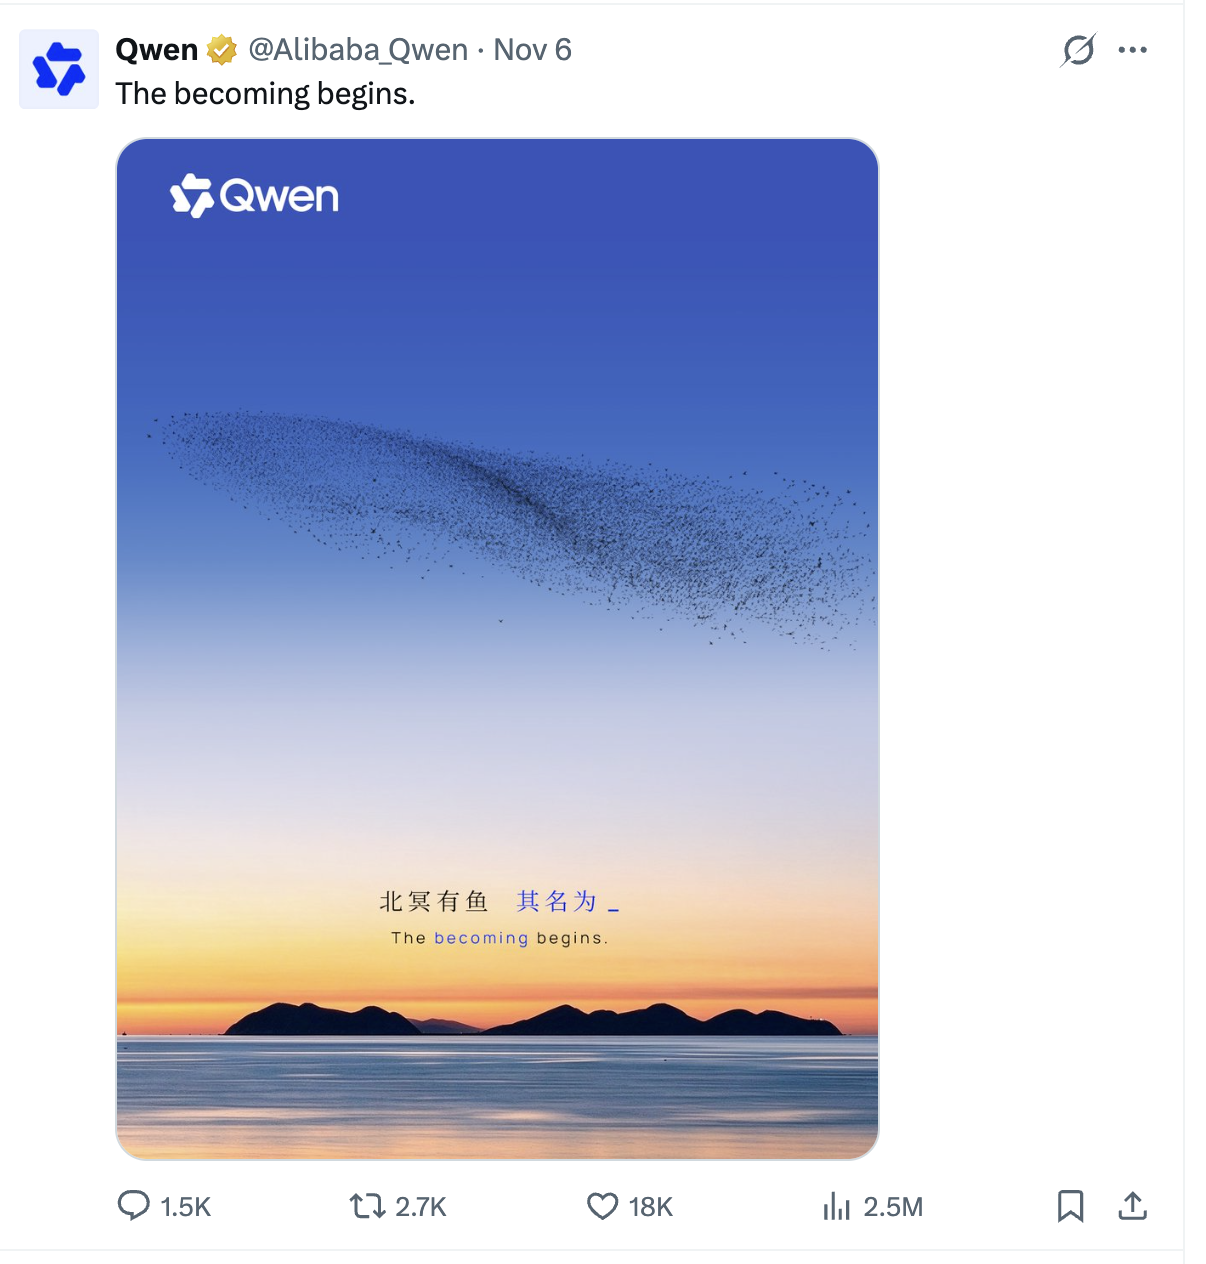
La imagen adjunta mostraba aves formando la silueta de un pez, construida alrededor de la frase en chino “北冥有鱼,其名为_,”, que no nombraba un modelo ni proporcionaba una fecha, pero aporta una señal oficial reciente a la predicción de lanzamiento.
Los modelos tempranos han llegado a evaluadores externos
El 8 de noviembre, el evaluador follistatin anunció que Qwen-4-Flash-Early, con nombre en clave “hawk”, había sido agregado a GameFeel Bench. La publicación también señaló una corrección a un cálculo anterior de la puntuación de audio para Qwen-4-27B.
Las pruebas externas refuerzan la hipótesis de un anuncio cercano. Indican que versiones tempranas funcionales están siendo evaluadas más allá del equipo de desarrollo.
Qwen también estableció un preámbulo técnico mediante su anuncio del 26 de agosto, que describía Qwen3.8-Flash y Flash-Next como vistas previas tempranas de la arquitectura que se está explorando para Qwen 4.
¿Cuál es la ventana de lanzamiento más probable?
En conjunto, estos desarrollos sitúan a noviembre de 2026 como nuestro pronóstico principal, con la primera ventana a observar en la mitad de noviembre.
Este pronóstico se refiere al anuncio inicial. El acceso público a la API, los lanzamientos individuales de modelos y los pesos descargables pueden llegar por etapas. Cuando se anuncie, la pregunta práctica será qué versiones están disponibles de inmediato para los usuarios.
¿Cómo rindió Qwen 4 Flash Early?
Los resultados tempranos publicados dan a Qwen-4-Flash-Early una puntuación de 49.9 con esfuerzo Max, frente a 47.2 para Claude Opus 5.5 con esfuerzo XHigh.
Model and effort setting
Overall score
Reported cost per task
Qwen-4-Flash-Early — Max
49.9
$0.40
Claude Opus 5.5 — XHigh
47.2
$2.60
Claude Sonnet 5.5 — Max
45.0
$7.80
Qwen-4-27B-Early — XHigh
44.6
$0.16
Qwen Flash Early aventaja por 2.7 puntos en esta comparación. Este es el resultado específico detrás de la afirmación de que la puntuación temprana de Qwen 4 en el benchmark supera a la de Opus 5.5.
¿Por qué importa la diferencia de costos?
Las cifras listadas sitúan el costo por tarea de Flash en aproximadamente el 15.4% del de Opus, o cerca de una sexta parte. Se trata de resultados de un benchmark de terceros sobre compilaciones tempranas, y los costos representan el gasto reportado por tarea en lugar de precios oficiales de la API de Qwen.
Para desarrolladores que revisan repetidamente prototipos de juegos, esa diferencia podría ser útil. El movimiento de personajes, el manejo de colisiones, el comportamiento de enemigos y la retroalimentación audiovisual suelen requerir varias rondas de cambios. Un gasto menor por iteración permite que el mismo presupuesto cubra más intentos.
Si la versión pública puede mantener esa combinación de rendimiento y costo será una cuestión importante tras el lanzamiento.
¿Qué modelos de Qwen 4 se esperan?
Las expectativas actuales se centran en Qwen 4 Max, Plus, Flash y 27B. Se espera que la versión 27B llegue primero el 9 de noviembre, mientras que el momento y las especificaciones finales de las otras versiones siguen sin estar claros.
Max y Plus: calidad y costo en tareas complejas
Los desarrolladores que gestionan razonamiento complejo, documentos largos y flujos de trabajo de varios pasos querrán comparar Max y Plus en calidad de salida, latencia y precio.
Esas diferencias influirán en qué modelo usa una aplicación por defecto y cuándo debería encaminar una tarea a una versión más capaz.
Flash: ¿puede la versión pública sostener sus resultados tempranos?
Flash ya cuenta con un punto de interés claro: sus resultados tempranos en desarrollo de juegos sugieren un equilibrio atractivo entre rendimiento y costo por tarea.
Si la versión pública puede completar trabajos similares de forma fiable, podría ser apta para aplicaciones que requieren generación, edición y reintentos frecuentes.
27B: ¿qué requerirá la implementación local?
Con un lanzamiento esperado pronto, la versión 27B es especialmente relevante para usuarios que quieren ejecutar un modelo en su propio hardware.
El número de parámetros es solo una parte del panorama de implementación. La disponibilidad de los pesos, la compatibilidad de cuantización, la licencia y la eficiencia de inferencia también determinarán si el modelo es práctico para una configuración concreta.
¿Qué deberían observar los desarrolladores en el lanzamiento?
Disponibilidad de API: Verifique qué versiones son accesibles de inmediato, si el acceso es público o limitado, y qué IDs de modelo están soportados. Estos detalles determinan la rapidez con la que los desarrolladores pueden empezar a probar.
Precios oficiales: Compare los precios de tokens de entrada y salida junto con los cargos de caché y el uso de tokens de razonamiento. Para aplicaciones en producción, la medida útil es el costo total de completar una tarea con éxito, incluidos los reintentos.
Rendimiento en código y agentes: Edición de código, llamadas a herramientas, salida estructurada y recuperación ante errores merecen atención. Las aplicaciones que dependen de varios pasos consecutivos necesitan ejecución consistente a lo largo del flujo de trabajo.
Requisitos de implementación local: Para Qwen 4 27B, lo primero que hay que verificar son los pesos descargables y los términos de la licencia. Los formatos de cuantización, los frameworks de inferencia soportados, los requisitos de VRAM y la velocidad de generación determinarán después si el modelo encaja con el hardware existente. El número de parámetros por sí solo es insuficiente para elegir una GPU, por lo que las decisiones de hardware deberían seguir los detalles publicados de implementación y mediciones prácticas.
¿Debería esperar Qwen 4 o usar modelos existentes?
¿Dónde podrán los desarrolladores usar Qwen 4?
Si ya está construyendo una aplicación de IA, continúe con un modelo que cumpla sus requisitos actuales. El lanzamiento inminente de Qwen 4 es una razón para preparar una comparación, más que para posponer trabajo útil.
Para desarrolladores que evalúan varios proveedores, una plataforma de API multimodelo como CometAPI ofrece un punto de partida práctico para comparar modelos disponibles en su catálogo. Use los mismos prompts, documentos o tareas de código entre candidatos y registre la calidad de salida, el tiempo de respuesta y el gasto total.
Una vez que Qwen 4 esté disponible a través de su canal de acceso elegido, agréguelo a esa misma evaluación. Esto facilita la decisión: ya tendrá una línea base para juzgar si mejora su aplicación.
Un conjunto de evaluación compacto puede incluir:
Una tarea de codificación extraída de su proyecto real.
Una pregunta sobre un documento con respuesta verificable.
Un flujo de trabajo de uso de herramientas con una condición de finalización clara.
Una tarea de redacción puntuada según sus requisitos editoriales.
Para usuarios de implementación local, el paso más útil es esperar los detalles del lanzamiento de 27B antes de tomar decisiones de hardware.
Conclusión
Qwen 4 merece un lugar en los planes de evaluación de los desarrolladores. Su caso de adopción dependerá de si los modelos lanzados entregan resultados útiles de forma consistente a un costo total competitivo.
Mantenga en marcha los proyectos actuales y establezca una línea base con su proveedor existente o con los modelos soportados a través de CometAPI. Cuando Qwen 4 sea accesible, pruébelo frente a esa línea base. La razón más sólida para cambiar será una mejora medible en su propio flujo de trabajo.
¿Por qué importa la diferencia de costos?
Las cifras listadas sitúan el costo por tarea de Flash en aproximadamente el 15.4% del de Opus, o cerca de una sexta parte. Se trata de resultados de un benchmark de terceros sobre compilaciones tempranas, y los costos representan el gasto reportado por tarea en lugar de precios oficiales de la API de Qwen.
Para desarrolladores que revisan repetidamente prototipos de juegos, esa diferencia podría ser útil. El movimiento de personajes, el manejo de colisiones, el comportamiento de enemigos y la retroalimentación audiovisual suelen requerir varias rondas de cambios. Un gasto menor por iteración permite que el mismo presupuesto cubra más intentos.
Si la versión pública puede mantener esa combinación de rendimiento y costo será una cuestión importante tras el lanzamiento.
¿Qué modelos de Qwen 4 se esperan?
Las expectativas actuales se centran en Qwen 4 Max, Plus, Flash y 27B. Sus especificaciones finales y disponibilidad determinarán cómo encaja cada uno en la gama.
Max y Plus: calidad y costo en tareas complejas
Los desarrolladores que gestionan razonamiento complejo, documentos largos y flujos de trabajo de varios pasos querrán comparar Max y Plus en calidad de salida, latencia y precio.
Esas diferencias influirán en qué modelo usa una aplicación por defecto y cuándo debería encaminar una tarea a una versión más capaz.
Flash: ¿puede la versión pública sostener sus resultados tempranos?
Flash ya cuenta con un punto de interés claro: sus resultados tempranos en desarrollo de juegos sugieren un equilibrio atractivo entre rendimiento y costo por tarea.
Si la versión pública puede completar trabajos similares de forma fiable, podría ser apta para aplicaciones que requieren generación, edición y reintentos frecuentes.
27B: ¿qué requerirá la implementación local?
La versión 27B esperada es especialmente relevante para usuarios que quieren ejecutar un modelo en su propio hardware.
El número de parámetros es solo una parte del panorama de implementación. La disponibilidad de los pesos, la compatibilidad de cuantización, la licencia y la eficiencia de inferencia también determinarán si el modelo es práctico para una configuración concreta.
¿Qué deberían observar los desarrolladores en el lanzamiento?
Disponibilidad de API: Verifique qué versiones son accesibles de inmediato, si el acceso es público o limitado, y qué IDs de modelo están soportados. Estos detalles determinan la rapidez con la que los desarrolladores pueden empezar a probar.
Precios oficiales: Compare los precios de tokens de entrada y salida junto con los cargos de caché y el uso de tokens de razonamiento. Para aplicaciones en producción, la medida útil es el costo total de completar una tarea con éxito, incluidos los reintentos.
Rendimiento en código y agentes: Edición de código, llamadas a herramientas, salida estructurada y recuperación ante errores merecen atención. Las aplicaciones que dependen de varios pasos consecutivos necesitan ejecución consistente a lo largo del flujo de trabajo.
Requisitos de implementación local: Para Qwen 4 27B, lo primero que hay que verificar son los pesos descargables y los términos de la licencia. Los formatos de cuantización, los frameworks de inferencia soportados, los requisitos de VRAM y la velocidad de generación determinarán después si el modelo encaja con el hardware existente. El número de parámetros por sí solo es insuficiente para elegir una GPU, por lo que las decisiones de hardware deberían seguir los detalles publicados de implementación y mediciones prácticas.
¿Debería esperar Qwen 4 o usar modelos existentes?
¿Dónde podrán los desarrolladores usar Qwen 4?
Si ya está construyendo una aplicación de IA, continúe con un modelo que cumpla sus requisitos actuales. El lanzamiento inminente de Qwen 4 es una razón para preparar una comparación, más que para posponer trabajo útil.
Para desarrolladores que evalúan varios proveedores, una plataforma de API multimodelo como CometAPI ofrece un punto de partida práctico para comparar modelos disponibles en su catálogo. Use los mismos prompts, documentos o tareas de código entre candidatos y registre la calidad de salida, el tiempo de respuesta y el gasto total.
Una vez que Qwen 4 esté disponible a través de su canal de acceso elegido, agréguelo a esa misma evaluación. Esto facilita la decisión: ya tendrá una línea base para juzgar si mejora su aplicación.
Un conjunto de evaluación compacto puede incluir:
Una tarea de codificación extraída de su proyecto real.
Una pregunta sobre un documento con respuesta verificable.
Un flujo de trabajo de uso de herramientas con una condición de finalización clara.
Una tarea de redacción puntuada según sus requisitos editoriales.
Para implementación local, espere detalles sobre los pesos, la licencia y los requisitos de VRAM de Qwen 4 27B antes de elegir una configuración.
Conclusión
Qwen 4 merece un lugar en los planes de evaluación de los desarrolladores. Su caso de adopción dependerá de si los modelos lanzados entregan resultados útiles de forma consistente a un costo total competitivo.
Mantenga en marcha los proyectos actuales y establezca una línea base con su proveedor existente o con los modelos soportados a través de CometAPI. Cuando Qwen 4 sea accesible, pruébelo frente a esa línea base. La razón más sólida para cambiar será una mejora medible en su propio flujo de trabajo.
Preguntas frecuentes
¿Cuándo se espera el lanzamiento de Qwen 4?
Pronosticamos un anuncio en noviembre de 2026, con mediados de noviembre como la primera ventana a observar. Alibaba no ha confirmado una fecha específica.
¿Ya se lanzó Qwen 4?
El material revisado para este artículo muestra pruebas externas de modelos tempranos. Consulte los anuncios oficiales de Qwen para conocer la disponibilidad pública del producto.
¿Qwen 4 realmente obtuvo una puntuación superior a Claude Opus 5.5?
En los resultados publicados de GameFeel v1.4, Qwen-4-Flash-Early Max obtuvo 49.9, mientras que Claude Opus 5.5 XHigh obtuvo 47.2.
¿Qwen 4 27B tendrá pesos abiertos?
El arreglo final requiere un anuncio oficial. Los usuarios deben verificar qué checkpoint está disponible para su descarga y la licencia que rige su uso.
¿Dónde podrá usarse Qwen 4?
Esté atento a la disponibilidad a través de productos de Qwen, APIs oficiales y canales de descarga de modelos. Los usuarios de plataformas de terceros deben consultar sus catálogos para conocer la versión exacta soportada y el momento de su lanzamiento.