TL;DR: Alibaba lanzó Qwen4-Max el 16 de noviembre de 2026 como el modelo insignia de su generación Qwen4. Las evaluaciones oficiales reportan mejor desempeño en tareas industriales y menores costes de ejecución que Qwen3.8-Max, reflejando mejoras en eficiencia de tokens y una reducción del precio de la API.
Conclusiones clave
- Tamaño del modelo: Qwen4-Max tiene 2.4 billones de parámetros de backbone, con 71 mil millones activados por token.
- Ventana de contexto: Qwen4-Max admite una ventana de contexto de un millón de tokens.
- Soporte multimodal: Qwen4-Max acepta texto, imágenes y video, y genera texto.
- Funciones para desarrolladores: Qwen4-Max admite llamadas a funciones, salidas estructuradas, caché de contexto y búsqueda web.
- Opciones de acceso: Los usuarios pueden acceder a Qwen4-Max mediante aplicaciones compatibles de Qwen, la API QwenCloud de cobro por uso y suscripciones Token Plan.
¿Qué es Qwen4-Max?
En el anuncio oficial de Alibaba, Qwen describe Qwen4-Max como un compañero de equipo de IA para trabajo, creación y exploración. Sus capacidades se centran en comprender objetivos, operar herramientas, responder a retroalimentación de ejecución y entregar resultados a través de múltiples etapas.
Para estos flujos de trabajo, el modelo aporta razonamiento y coordinación. Las aplicaciones, herramientas y entornos de ejecución conectados realizan las operaciones.
Especificaciones de Qwen4-Max
La página oficial del modelo en QwenCloud lista las siguientes especificaciones:
| Especificación | Qwen4-Max |
|---|---|
| ID del modelo | qwen4-max |
| Parámetros de backbone | 2.4 billones |
| Parámetros activados por token | 71 mil millones |
| Ventana de contexto | 1 millón de tokens |
| Entrada / salida | Texto, imágenes y video / Texto |
| Límites del modo estándar | Entrada máxima: 991K; salida máxima: 131K tokens |
| Límites del modo de pensamiento | Entrada máxima: 983K; salida máxima: 262K tokens |
| Longitud máxima de razonamiento | 262K tokens |
| Capacidades para desarrolladores | Llamadas a funciones, salidas estructuradas, caché de contexto y búsqueda web |
| Compatibilidad de API | Protocolos de API de OpenAI y Anthropic |
El tamaño de contexto, los límites de entrada y los límites de salida representan restricciones diferentes. Las aplicaciones deben satisfacerlas conjuntamente y reservar suficiente capacidad para las respuestas generadas y el razonamiento.
¿Cuáles son las funciones principales de Qwen4-Max?
Las capacidades de Qwen4-Max son especialmente relevantes cuando una tarea abarca múltiples documentos, herramientas y pasos de ejecución. El contexto largo preserva el trasfondo de trabajo, la comprensión visual amplía la evidencia disponible, y las capacidades de agente ayudan a avanzar la tarea hacia la entrega.
Ventana de contexto de un millón de tokens y comprensión visual nativa
La gran ventana de contexto permite procesar materiales relacionados dentro de un contexto de trabajo compartido. Aplicaciones prácticas incluyen comparar contratos, analizar dependencias en archivos de código y revisar informes junto con documentos de soporte.
La comprensión visual nativa extiende esto a capturas de pantalla, diagramas, páginas escaneadas y video. Un usuario puede proporcionar un plano de ingeniería o una captura de interfaz y pedir al modelo que lo interprete junto a requisitos escritos.
Para tareas con muchos documentos, conservar nombres de archivo, fechas y etiquetas de sección ayuda a organizar las evidencias y facilita la verificación del análisis resultante.
Programación y uso profesional de herramientas
Qwen4-Max admite llamadas a funciones, permitiendo a los desarrolladores conectarlo con bases de datos, servicios de búsqueda, operaciones de archivos y sistemas de negocio. Las salidas estructuradas ayudan a pasar los resultados del modelo a procesos de software posteriores.
Las demostraciones oficiales muestran flujos de trabajo de software más amplios. En desarrollo de juegos, el modelo utiliza motores como Unity, Unreal Engine y Godot para construir escenas, implementar jugabilidad y refinar resultados mediante pruebas. En Blender, coordina geometría, materiales, iluminación y renderizado.
Reproducir estos flujos de trabajo requiere el software correspondiente, activos y permisos de ejecución. Las demostraciones muestran lo que el modelo puede lograr dentro de esos entornos.
Agentes de largo horizonte y Live Delivery
Las tareas largas se vuelven difíciles de gestionar cuando los usuarios no pueden inspeccionar el progreso hasta su finalización. El enfoque Live Delivery de Qwen4-Max introduce un resultado inicial utilizable seguido de actualizaciones sucesivas.
Para una tarea de investigación, un agente podría entregar primero hallazgos preliminares y una lista de fuentes, luego ampliar el análisis y agregar gráficos. Los usuarios pueden revisar cada versión y redirigir el trabajo posterior.
Qwen también lanzó el Qwen-Live-Delivery-Plugin. Para flujos de trabajo que duran horas o más, la entrega escalonada crea puntos de control prácticos para revisar la calidad y corregir la dirección.
Arquitectura y eficiencia de tokens
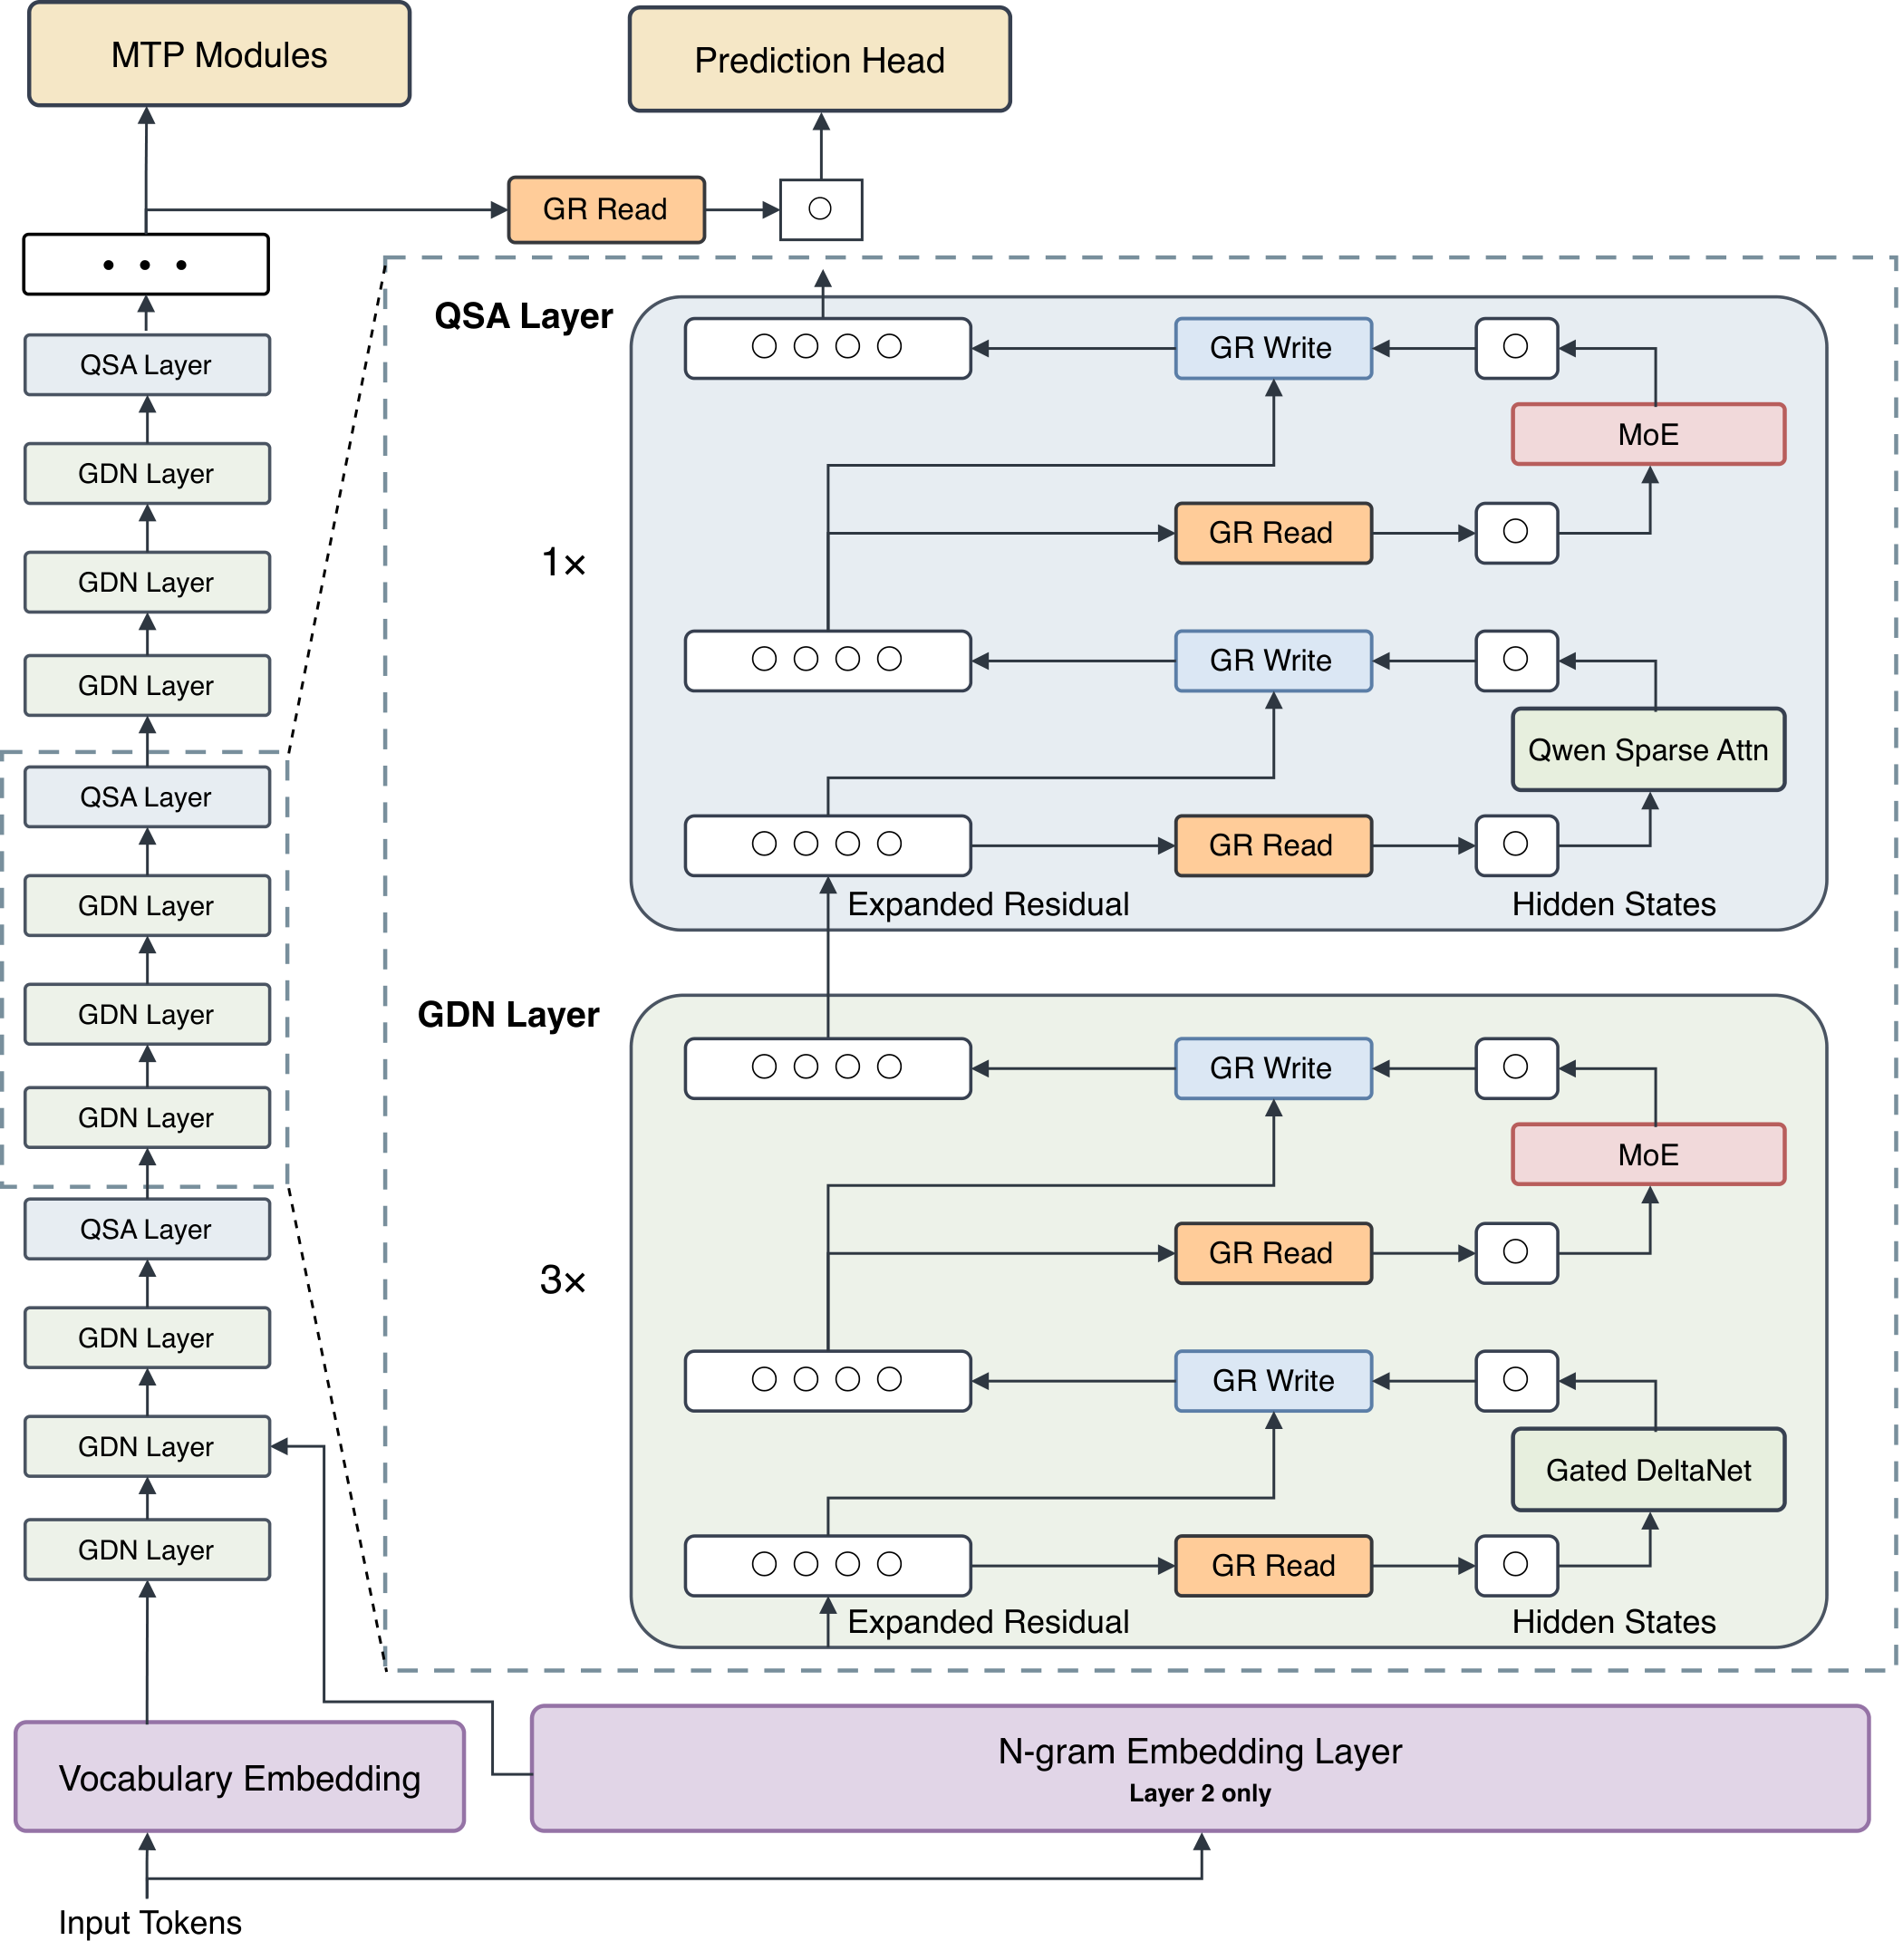
Qwen4-Max introduce varios cambios en su arquitectura dispersa de mezcla de expertos:
- Gated DeltaNet y Qwen Sparse Attention: combinan compresión de información histórica con atención selectiva al contexto relevante, reduciendo el cómputo en secuencias largas.
- Gated Residual: utiliza cuatro ramas residuales en paralelo y puertas dinámicas para mejorar la transferencia de información y la estabilidad del entrenamiento.
- N-gram Embedding: añade 328 mil millones de parámetros de embedding para representar patrones locales de tokens mediante operaciones de búsqueda, ampliando la capacidad con un cómputo adicional relativamente bajo.
Para los usuarios, la prueba práctica es si estos cambios reducen los recursos necesarios para entregar un resultado aceptable. Las mediciones publicadas por Qwen sobre consumo de tokens aportan evidencia de mejoras en las tareas evaluadas.
¿Cómo rinde Qwen4-Max? Benchmarks y ejemplos oficiales
Los benchmarks publicados por Qwen miden desempeño de tareas, consumo de tokens y costes de ejecución, mientras que sus demostraciones ilustran flujos de trabajo prácticos.
Resultados de los benchmarks de Qwen4-Max
Los siguientes resultados comparan Qwen4-Max con Qwen3.8-Max:
| Métrica | Qwen4-Max vs. Qwen3.8-Max |
|---|---|
| Puntuación Work360 | Aumentó de 47.74 a 52.69 |
| Consumo de tokens en Work360 | Se redujo aproximadamente un 24% en Xhigh y un 35% en High |
| Consumo de tokens en Terminal-Bench 4.0 | Se redujo aproximadamente un 48% en Xhigh y un 49% en High |
| Coste medio por tarea Work360 | Cayó de RMB 26.58 a RMB 11.16, aproximadamente un 58% menos |
La reducción de costes refleja tanto el menor consumo de tokens como la revisión del precio de la API.
Para aplicaciones que realizan llamadas repetidas a herramientas, el coste por tarea completada con éxito es una comparación más útil que los precios por token por sí solos. Una solicitud de menor precio ofrece un ahorro limitado si el flujo de trabajo requiere muchos reintentos o correcciones manuales.
Ejemplos en investigación financiera y manufactura
Varios ejemplos oficiales proporcionan entregables concretos y resultados medibles.
En investigación financiera, el modelo combina herramientas de datos de mercado y búsqueda para producir hojas de trabajo en Excel y informes en PowerPoint editables. Enlaces a fuentes y gráficos alineados permiten a los revisores rastrear los hallazgos del informe hasta los datos de soporte.
En un ejemplo de manufactura, el modelo combina modelado parametrizado, generación de trayectorias de herramienta y retroalimentación de simulación. El esfuerzo humano de programación para una pieza se redujo de aproximadamente 475 minutos a 24 minutos. Este resultado describe la pieza demostrada y el entorno de herramientas, y proporciona un punto de partida útil para evaluar procesos similares.
Cómo interpretar los resultados
La puntuación Work360 de Qwen4-Max aumentó de 47.74 a 52.69, una ganancia de 4.95 puntos. Esto indica un rendimiento más sólido en las tareas industriales evaluadas, aunque los resultados de tareas individuales pueden variar. Las reducciones en consumo de tokens ofrecen una medida separada de eficiencia, con ahorros diferentes en los ajustes de razonamiento High y Xhigh.
La reducción reportada del 58% en el coste medio por tarea Work360 combina menor consumo de tokens con la revisión del precio de la API. Para los desarrolladores, la pregunta relevante es si esos ahorros se mantienen hasta una tarea completada con éxito tras reintentos y correcciones manuales.
Las demostraciones de aplicaciones añaden evidencia sobre flujos de trabajo y entregables específicos. Úsalas para identificar tareas que valga la pena probar, luego compara calidad de finalización, esfuerzo de revisión y coste total bajo condiciones de herramientas consistentes.
Precios de Qwen4-Max: costes de API y opciones de Token Plan
Qwen4-Max está disponible mediante facturación de API por uso y suscripciones Token Plan. La opción adecuada depende de si estás construyendo una aplicación o utilizando una herramienta de IA interactiva.
Precios oficiales de API por uso
QwenCloud enumera los siguientes precios para la región de Singapur:
| Ítem de facturación | Precio por 1 millón de tokens |
|---|---|
| Entrada estándar | $1.50 |
| Salida | $4.50 |
| Entrada de caché implícita | $0.075 |
| Lectura de caché explícita | $0.075 |
La creación de caché explícita cuesta $1.875 por millón de tokens para una caché de cinco minutos y $3.00 para una caché de una hora.
Una tarea que use 100,000 tokens de entrada sin caché y 10,000 tokens de salida facturables cuesta $0.195 en tasas de tokens del modelo, excluyendo herramientas o servicios adicionales facturables.
La entrada en caché se cobra un 95% por debajo de la entrada estándar. Las aplicaciones que envían repetidamente las mismas instrucciones, definiciones de herramientas o prefijos de documentos pueden reducir costes de entrada mejorando el uso de caché.
Cómo funciona Token Plan
Token Plan usa facturación por suscripción y deducciones de Créditos. Actualmente lista qwen4-max entre sus modelos compatibles.
A 17 de noviembre de 2026, la página de la región de Singapur muestra los siguientes planes mensuales individuales:
| Plan | Precio mensual | Créditos mensuales |
|---|---|---|
| Lite | $6 | 20,000 |
| Essential | $10 | 45,000 |
| Standard | $18 | 80,000 |
| Pro | $43 | 200,000 |
La página también anuncia una promoción para nuevos usuarios que empieza en $3. La elegibilidad y el importe final se muestran durante el pago.
Los Créditos son unidades de facturación por suscripción, no una asignación directa de tokens. El consumo depende de las reglas del modelo y herramientas aplicables.
Según la documentación de Token Plan, el servicio está destinado a uso interactivo en herramientas de IA compatibles y actualmente está disponible en la región de Singapur.
Cómo acceder a Qwen4-Max
Hay tres rutas prácticas: usar un producto de Qwen, conectarse directamente a través de QwenCloud o configurar una herramienta de IA compatible. Cada una tiene requisitos de configuración diferentes, especialmente en credenciales y endpoints.
Usar aplicaciones de Qwen
El anuncio oficial lista Qwen Studio, la app Qwen, QwenWork y Qoder como canales de acceso.
Estos productos proporcionan un punto de partida conveniente para probar análisis de documentos, asistencia de programación y flujos de trabajo de oficina. Los desarrolladores que necesitan controlar solicitudes, herramientas y manejo de resultados pueden pasar a la integración directa de la API.
Acceder a la API de QwenCloud
Para acceder a Qwen4-Max, inicia sesión en QwenCloud, obtén una clave de API para tu región seleccionada y configura el endpoint correspondiente con el ID de modelo qwen4-max. QwenCloud proporciona acceso compatible con OpenAI. Los usuarios que migren desde la vista previa también deben revisar sus parámetros de solicitud y configuración de facturación.
Configurar herramientas de programación y agentes
La documentación de Token Plan proporciona guías de integración para herramientas como Qwen Code, Cline, Cursor y OpenCode.
La configuración generalmente requiere una clave de API dedicada, la Base URL apropiada y el nombre del modelo. Token Plan utiliza el dominio de endpoint separado token-plan.maas.qwencloudapi.com, y sus claves no se pueden intercambiar con claves de API de cobro por uso.
Sigue la guía de tu herramienta elegida y valida la configuración con una tarea que incluya leer material, realizar una operación y comprobar el resultado.
¿Quién debería usar Qwen4-Max?
Vale la pena evaluar Qwen4-Max cuando un flujo de trabajo recurrente requiere un contexto extenso, múltiples herramientas y un entregable verificable.
- Desarrolladores pueden evaluar Qwen4-Max para cambios de código en múltiples archivos, desarrollo frontend y agentes que usan herramientas externas.
- Equipos de oficina e investigación pueden usarlo para analizar documentos, organizar datos y preparar informes con fuentes rastreables.
- Equipos de diseño y contenido pueden probarlo para modelado 3D, prototipos de juegos y flujos de video conectados a software profesional.
- Equipos empresariales pueden evaluar procesos recurrentes con acceso a datos definido, interfaces de herramientas y criterios de aceptación.
Para flujos de trabajo financieros, legales y médicos, úsalo para procesamiento de evidencias y apoyo analítico, con profesionales calificados revisando conclusiones de impacto.
Preguntas frecuentes
¿El límite de salida de Qwen4-Max es de un millón de tokens?
No. La ventana de contexto y la longitud máxima de salida son límites separados. QwenCloud lista salidas máximas de 131K tokens en modo estándar y 262K tokens en modo de pensamiento. Las solicitudes también deben satisfacer los límites de entrada y contexto aplicables.
¿Debo elegir la API de Qwen4-Max o Token Plan?
Elige la API de cobro por uso al integrar Qwen4-Max en una aplicación o servicio backend. Token Plan está destinado a uso interactivo en herramientas de IA compatibles y utiliza Créditos de suscripción. Las dos opciones requieren credenciales y endpoints separados.
¿Puedo usar Qwen4-Max gratis?
El acceso oficial a la API y Token Plan son servicios de pago. El acceso gratuito a través de aplicaciones de Qwen, cuando se ofrece, sigue las reglas de cuenta y uso de cada producto; no establece una asignación de API gratuita.
¿Puedo descargar Qwen4-Max para una implementación local?
Hasta el 17 de noviembre de 2026, Qwen no ha proporcionado pesos abiertos para Qwen4-Max, por lo que el lanzamiento oficial no ofrece un modelo descargable para implementación local. Qwen ha anunciado planes para publicar progresivamente modelos más pequeños de la serie Qwen4 como código abierto.
Conclusión
Qwen4-Max es un candidato sólido para análisis de documentos largos, programación compleja y flujos de trabajo que involucran múltiples herramientas. Las evaluaciones oficiales muestran puntuaciones más altas y menores costes por tarea que Qwen3.8-Max en las cargas de trabajo reportadas.
Empieza con una tarea representativa que ya tenga criterios de aceptación claros. Compara la calidad de la salida, el tiempo de corrección manual, el tiempo de ejecución y el coste total. Las mejoras en esas métricas proporcionan una base práctica para expandir Qwen4-Max a flujos de trabajo similares.