Construye con CometAPI¿Necesitas una sola API para varios modelos?Prueba el flujo en el Playground y luego crea una clave de API cuando el modelo y el costo encajen con tu caso de uso.
Hasta mi última actualización (octubre de 2024), no hay información pública oficial sobre modelos llamados “GPT‑6 Sol” y “GPT‑6 Luna”. Si se trata de nombres internos o de variantes comerciales de un proveedor, sus diferencias no están documentadas públicamente. Dicho esto, las familias de modelos con nombres duales suelen representar compromisos de rendimiento típicos:
- Latencia vs. calidad: una variante “rápida” prioriza respuesta inmediata con menor profundidad de razonamiento; la “precisa” mejora exactitud y coherencia a costa de más tiempo.
- Tamaño del modelo y costo: modelos más pequeños son más baratos por token pero rinden peor en tareas complejas; modelos grandes aumentan costo y consumo.
- Longitud de contexto vs. throughput: ventanas de contexto largas permiten documentos extensos pero reducen tokens/segundo y elevan memoria.
- Razonamiento y codificación vs. velocidad: mejores en planificación, matemáticas y código suelen ser más lentos.
- Multimodalidad: soporte de imágenes/audio/video puede añadir latencia y costo frente a un modelo solo texto.
- Estabilidad/determinismo vs. creatividad: salidas más estables restringen variabilidad; modos creativos aceptan más dispersión.
- Herramientas/funciones: variantes con mejor “function calling”, recuperación (RAG) o herramientas de agente pueden ser más pesadas.
- Guardrails: filtros más estrictos reducen riesgos pero pueden bloquear más contenido válido.
Si tuviera que anticipar el tipo de trade-off entre dos variantes hipotéticas:
- “Sol” (orientada a velocidad): menor latencia, menor costo, contexto más corto, rendimiento aceptable en tareas comunes, peor en tareas de razonamiento profundo.
- “Luna” (orientada a calidad): mejor razonamiento y seguimiento de instrucciones, contexto más largo, más costosa y lenta.
Cómo elegir en la práctica:
- Defina métricas: calidad (tasa de aciertos/hallucinaciones), latencia p95/p99, costo/token, recall en contexto largo, exactitud en function calling.
- Evalúe por caso de uso: chat general vs. análisis complejo, RAG, codificación, multimodal.
- Haga pruebas A/B con su propio conjunto de evaluación y SLAs de producción.
GPT-6 Sol, Luna utilizando capacidades publicadas, rendimiento, precios y detalles de acceso a la API. Conozca qué modelo se ajusta a su carga de trabajo
Deon GoodwinEquipo de investigación de modelos de IA y API
OpenAI lanzó GPT-6 Sol y GPT-6 Luna el 22 de septiembre de 2026, ampliando la familia GPT-6 más allá de Astra. Sol está diseñado para programación compleja y flujos de trabajo basados en agentes, mientras que Luna se orienta a trabajo enfocado y repetible a gran volumen. Ambos aceptan entradas de texto e imagen, generan texto, ofrecen una ventana de contexto de 1,050,000 tokens y son compatibles con las API Responses y Chat Completions. Su diferencia principal es la economía del trabajo: Sol gasta más por token para abordar trabajo exigente, mientras que Luna minimiza el costo unitario para tareas bien acotadas.
Para la mayoría de los equipos, el punto de partida práctico es simple: usa Astra para el trabajo integral más difícil, Sol cuando deba equilibrarse capacidad y costo, y Luna cuando la tarea sea lo suficientemente acotada como para validarla automáticamente. El acceso directo de OpenAI está activo para Sol y Luna. CometAPI debe comprobarse por separado porque la disponibilidad de rutas, promociones y el enrutamiento de cuentas pueden diferir del lanzamiento directo de OpenAI.
Key Takeaways
GPT-6 Sol es el mejor punto de partida para código exigente, agentes de múltiples pasos, depuración difícil y flujos donde un fallo genera un alto costo de revisión.
Revisado para mayor claridad, atribución de fuentes y terminología API actual.
GPT-6 Luna está diseñada para tareas enfocadas y de alto volumen como extracción, clasificación, enrutamiento, resúmenes estructurados y transformaciones de primera pasada.
Ambos modelos tienen los mismos límites publicados de contexto y salida, por lo que la longitud del contexto por sí sola no es motivo para elegir entre ellos.
Las tarifas estándar de OpenAI para contexto corto son $2 por millón de tokens de entrada y $10 por millón de tokens de salida para Sol, frente a $0.10 de entrada y $0.50 de salida para Luna.
Usa la API Responses para razonamiento con herramientas. En Chat Completions, la llamada a funciones para Sol y Luna requiere establecer reasoning_effort en none.
What Did OpenAI Release With GPT-6 Sol and Luna?
El lanzamiento del 22 de septiembre añade dos niveles operativos de menor costo a la familia GPT-6. GPT-6 Astra sigue siendo la opción más capaz para el trabajo integral más difícil; Sol aporta razonamiento sólido a tareas exigentes de programación y agentes con una tarifa por token más baja; Luna está optimizada para trabajo enfocado que debe ejecutarse de forma repetida y económica.
Esto es más que una actualización de nombres. El registro de cambios de la API de OpenAI enumera los ID de modelo exactos gpt-6-sol y gpt-6-luna, con entrada de texto e imagen, salida de texto y disponibilidad tanto en Responses como en Chat Completions. Los desarrolladores pueden, por tanto, probar los modelos con los mismos prompts representativos y seleccionar un nivel según la tasa de salida aceptada, latencia, tokens totales, reintentos y tiempo de revisión humana, no solo el precio por token. Consulta el OpenAI API changelog y la comparación oficial de modelos.
What Is GPT-6 Sol?
GPT-6 Sol es el modelo GPT-6 de OpenAI para programación compleja y flujos de trabajo basados en agentes. Está pensado para tareas que requieren razonamiento sostenido, decisiones de herramientas y múltiples pasos, incluidas el análisis de repositorios, la depuración y cambios de software impulsados por agentes. La especificación oficial indica entrada de texto e imagen, salida de texto, una ventana de contexto de 1,050,000 tokens, hasta 128,000 tokens de salida y esfuerzo de razonamiento desde none hasta max.
Sol no es simplemente “el modelo intermedio”. Su valor económico depende de si un mejor rendimiento multietapa reduce reintentos, escalaciones y revisión. Es una buena opción por defecto cuando el menor costo unitario de Luna quedaría superado por más validaciones fallidas o mayor intervención humana.
What Is GPT-6 Luna?
GPT-6 Luna es la opción de GPT-6 centrada en la eficiencia para trabajo bien delimitado que se repite a alto volumen. Los ejemplos incluyen extracción, clasificación, respuestas guiadas por plantillas, triaje de soporte y resúmenes de primera pasada, siempre que las salidas se comprueben contra los requisitos de la aplicación. Luna tiene los mismos límites publicados de contexto de 1,050,000 tokens y salida de 128,000 tokens que Sol, con entrada de texto e imagen y salida de texto.
Luna resulta más convincente cuando el éxito puede definirse claramente y verificarse a bajo costo. Una tarifa baja por token no produce automáticamente el menor costo del flujo: los equipos deberían incluir reintentos, salidas rechazadas, fallos posteriores y tiempo de revisión en su evaluación.
How Did GPT-6 Sol and Luna Improve Performance?
Professional and coding evaluations
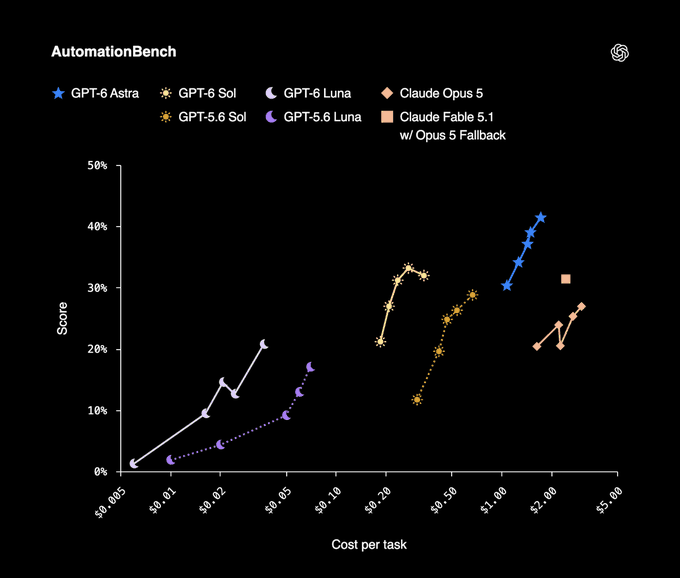
En las evaluaciones de lanzamiento publicadas por OpenAI, Sol obtuvo 33.2% en AutomationBench con xhigh effort y un costo estimado de $0.27 por tarea; Astra con low effort obtuvo 30.3% en esa comparación. Sol alcanzó 68.8% en DeepSWE v1.1 con max effort, mientras que Luna logró 66.6% con max effort. AutomationBench evalúa flujos de trabajo en múltiples aplicaciones; DeepSWE evalúa tareas de ingeniería de software de largo horizonte. Estas cifras provienen de configuraciones de prueba específicas y no establecen un ranking universal para cada prompt.
La lección útil no es que un benchmark declare un ganador universal. Es que el mejor modelo puede cambiar según el esfuerzo de razonamiento, el uso de herramientas y el diseño de la tarea. Las configuraciones de benchmark deben tratarse como evidencia para formar un plan de pruebas, no como sustituto de evaluar los prompts de producción.
Computer use, factuality, and limits
En la evaluación offline OSWorld 2.0 de OpenAI, Sol alcanzó 60.5% con xhigh effort. OpenAI también informó aproximadamente la mitad de errores para Sol frente a su predecesor GPT-5.6 en un conjunto interno de conversaciones seleccionadas porque los usuarios habían señalado errores fácticos. Ese conjunto no es representativo del tráfico típico.
Para el despliegue, evalúa los modos de fallo que importan a tu aplicación: elección incorrecta de herramientas, ejecución multietapa incompleta, fallos de esquema, errores fácticos, latencia y costo por resultado aceptado. Un conjunto de evaluación pequeño y representativo es más accionable que una puntuación amplia de un ranking.
How Much Do GPT-6 Sol and Luna Cost?
La tabla oficial de precios de OpenAI separa las tarifas estándar de contexto corto y de contexto largo. Los precios a continuación están en USD por un millón de tokens. Un prompt con más de 272,000 tokens de entrada usa tarifas de contexto largo para toda la solicitud, no solo para la parte por encima del umbral.
Tarifa estándar de OpenAI / 1M tokens
GPT-6 Sol: corto / largo
GPT-6 Luna: corto / largo
Entrada
$2.00 / $4.00
$0.10 / $0.20
Entrada en caché
$0.20 / $0.40
$0.01 / $0.02
Escrituras en caché
$2.50 / $5.00
$0.125 / $0.25
Salida
$10.00 / $15.00
$0.50 / $0.75
Batch, Flex, Fast mode y el procesamiento regional elegible tienen tarifas separadas. Estima el costo usando el nivel de servicio, la longitud total de la entrada, la longitud de la salida, el comportamiento de caché, las tarifas de herramientas y la tasa de reintentos.
CometAPI pricing and availability snapshot
Actualmente, CometAPI enumera tanto GPT-6 Luna como GPT-6 Sol con un 20% por debajo de las tarifas estándar de contexto corto correspondientes de la API de OpenAI. Para GPT-6 Luna, CometAPI cobra $0.08 por millón de tokens de entrada y $0.40 por millón de tokens de salida, en comparación con las tarifas de OpenAI de $0.10/$0.50. El catálogo también lista precios con descuento para lecturas y escrituras de caché, con la misma reducción del 20%.
GPT-6 Sol recibe el mismo descuento del 20% en CometAPI. Su tarifa de contexto corto es de $1.60 por millón de tokens de entrada y $8.00 por millón de tokens de salida, frente a los precios estándar de OpenAI de $2/$10. Esto hace que Sol sea sustancialmente más caro que Luna por token, pero los dos modelos apuntan a cargas de trabajo distintas: Sol está diseñado para programación exigente y flujos basados en agentes, mientras que Luna enfatiza una inferencia eficiente y de alto volumen.
Modelo de CometAPI
Estado público
Entrada/salida de contexto corto
Interpretación
GPT-6 Luna
Listado con 20% de descuento
$0.08 / $0.40*
La entrada se muestra públicamente; la salida es el cálculo correspondiente con 20% de descuento. Vuelve a comprobar el panel.
GPT-6 Sol
Listado con 20% de descuento
$1.60 / $8.00*
La entrada se muestra públicamente; la salida es el cálculo correspondiente con 20% de descuento. Vuelve a comprobar el panel.
GPT-6 Astra vs GPT-6 Sol vs GPT-6 Luna: How Should Developers Choose?
Los tres modelos deben compararse por el costo de un flujo de trabajo exitoso, no solo por las especificaciones. Astra ofrece el mayor techo de capacidad, Sol equilibra un razonamiento sólido con una tarifa por token mucho más baja y Luna minimiza el costo unitario para tareas con límites claros y validación.
Modelo
Elígelo cuando
Compensación operativa
GPT-6 Astra
La tarea es el trabajo integral más difícil: ambiguo, de alta consecuencia, con uso intensivo de herramientas o costoso de revisar.
Mayor precio por token, pero puede reducir fallos posteriores e intervención humana en los casos más difíciles.
GPT-6 Sol
Necesitas un rendimiento sólido en programación y agentes sin pagar tarifas de Astra en cada solicitud.
Una opción fuerte por defecto para trabajo de producción exigente; valida si su capacidad adicional reduce los reintentos lo suficiente como para justificar su costo frente a Luna.
GPT-6 Luna
El trabajo es acotado, medible, de alto volumen y protegido por esquemas, reglas o muestreo.
Menor costo unitario, pero definiciones de tarea débiles o una validación deficiente pueden convertir el ahorro en costos de revisión y reintentos.
Patrón de enrutamiento recomendado: envía el trabajo rutinario y bien acotado a Luna; enruta los casos exigentes a Sol; reserva Astra para tareas donde la complejidad, la ambigüedad o la consecuencia hagan valioso el mayor techo de capacidad. Las señales de escalación pueden incluir validación fallida, requisitos de herramientas, baja confianza, prompts inusualmente largos o un alto costo de error.
Why Has GPT-6 Terra Not Been Released?
OpenAI no ha anunciado un modelo GPT-6 Terra ni ha dado un motivo por su ausencia al 23 de septiembre de 2026. Su catálogo público de modelos GPT-6 lista Astra, Sol y Luna, y el registro de cambios del API anuncia Sol y Luna sin un ID de modelo Terra. La generación anterior GPT-5.6 incluía Terra, lo que explica la pregunta, pero no establece un plan de lanzamiento de GPT-6.
Cualquier explicación basada en precios, estrategia de portafolio o calendario de lanzamiento es análisis y no una declaración de OpenAI. Hasta que OpenAI publique una página de modelo o un anuncio, la fecha de lanzamiento, especificaciones, benchmarks y precio de GPT-6 Terra siguen siendo desconocidos.
How Can Developers Access and Use GPT-6 Sol and Luna?
Use OpenAI directly
Ambos ID de modelo están activos en las API Responses y Chat Completions de OpenAI. Usa Responses para razonamiento con herramientas integradas y llamadas a funciones. Chat Completions admite solicitudes normales, pero la llamada a funciones para Sol y Luna requiere reasoning_effort="none".
Use CometAPI after checking the live route
CometAPI documenta una URL base compatible con OpenAI, por lo que los equipos pueden usar el OpenAI SDK con una clave de CometAPI. El catálogo público actualmente admite usar Luna como el ejemplo más seguro. Solo sustituye gpt-6-sol después de que tu cuenta confirme que la ruta de Sol está habilitada.
Si tu panel de CometAPI documenta compatibilidad con Responses y chat para la ruta seleccionada, pruébalo por separado antes del despliegue. Registra el proveedor, la ruta, el ID del modelo, el ajuste de razonamiento, la latencia, los tokens, el resultado de validación y el costo facturado para que las pruebas por gateway sigan siendo distinguibles de las pruebas directas con OpenAI.
Conclusion
GPT-6 Sol y GPT-6 Luna amplían la familia GPT-6 con dos economías de trabajo diferentes. Sol está construido para programación compleja y flujos basados en agentes; Luna está diseñada para trabajo eficiente y enfocado a escala. Astra sigue siendo la opción para las tareas integrales más difíciles. Dado que las tres opciones pueden parecer económicas en condiciones diferentes, la comparación correcta es el costo por resultado aceptado, no la longitud del contexto ni el precio por token en aislamiento.
Empieza con un conjunto de evaluación representativo. Mide calidad, latencia, tokens totales, reintentos, fallos de validación y tiempo de revisión humana. Usa los ID de modelo publicados por OpenAI para el acceso directo y verifica la ruta activa y los precios de tu cuenta en CometAPI antes de hacer afirmaciones de disponibilidad específicas del gateway.
Hasta mi última actualización (octubre de 2024), no hay información pública oficial sobre modelos llamados “GPT‑6 Sol” y “GPT‑6 Luna”. Si se trata de nombres internos o de variantes comerciales de un proveedor, sus diferencias no están documentadas públicamente. Dicho esto, las familias de modelos con nombres duales suelen representar compromisos de rendimiento típicos:
- Latencia vs. calidad: una variante “rápida” prioriza respuesta inmediata con menor profundidad de razonamiento; la “precisa” mejora exactitud y coherencia a costa de más tiempo.
- Tamaño del modelo y costo: modelos más pequeños son más baratos por token pero rinden peor en tareas complejas; modelos grandes aumentan costo y consumo.
- Longitud de contexto vs. throughput: ventanas de contexto largas permiten documentos extensos pero reducen tokens/segundo y elevan memoria.
- Razonamiento y codificación vs. velocidad: mejores en planificación, matemáticas y código suelen ser más lentos.
- Multimodalidad: soporte de imágenes/audio/video puede añadir latencia y costo frente a un modelo solo texto.
- Estabilidad/determinismo vs. creatividad: salidas más estables restringen variabilidad; modos creativos aceptan más dispersión.
- Herramientas/funciones: variantes con mejor “function calling”, recuperación (RAG) o herramientas de agente pueden ser más pesadas.
- Guardrails: filtros más estrictos reducen riesgos pero pueden bloquear más contenido válido.
Si tuviera que anticipar el tipo de trade-off entre dos variantes hipotéticas:
- “Sol” (orientada a velocidad): menor latencia, menor costo, contexto más corto, rendimiento aceptable en tareas comunes, peor en tareas de razonamiento profundo.
- “Luna” (orientada a calidad): mejor razonamiento y seguimiento de instrucciones, contexto más largo, más costosa y lenta.
Cómo elegir en la práctica:
- Defina métricas: calidad (tasa de aciertos/hallucinaciones), latencia p95/p99, costo/token, recall en contexto largo, exactitud en function calling.
- Evalúe por caso de uso: chat general vs. análisis complejo, RAG, codificación, multimodal.
- Haga pruebas A/B con su propio conjunto de evaluación y SLAs de producción. - CometAPI