
TL;DR
Claude Haiku 5.5 es el modelo pequeño más rápido de Anthropic a velocidad estándar para tareas de alto volumen y sensibles a la latencia. Combina una ventana de contexto de 1 millón de tokens, un límite de salida estándar de 128K, razonamiento adaptativo y precios base que comienzan en $0.10 por millón de tokens de entrada y $0.50 por millón de tokens de salida. Las tarifas aumentan cuando un prompt supera 100,000 tokens. Para codificación compleja y trabajo de agentes extendido, Sonnet 5.5 y Opus 5.5 siguen siendo opciones más sólidas. La tarifa Standard de CometAPI es 20% inferior a las oficiales, comenzando en $0.08 por millón de tokens de entrada y $0.40 por millón de tokens de salida. La página del modelo en CometAPI está activa e informa acceso de API en producción.
Puntos clave
- Lanzamiento oficial: 7 de octubre de 2026; ID del modelo en la API de Claude: claude-haiku-5-5.
- Tarifas iniciales de API: $0.10 entrada y $0.50 salida por millón de tokens para prompts de hasta 100K tokens. CometAPI: $0.08 entrada y $0.40 salida por millón de tokens al 80% de la tarifa Standard oficial.
- Contexto y salida: 1M tokens de contexto y 128K tokens de salida estándar.
- Enfoque: clasificación, extracción de documentos, ruteo, soporte y tareas delegadas a agentes.
- El tokenizador más reciente puede contar aproximadamente 30% más tokens para el mismo texto; evalúe el costo por tarea aceptada en lugar del precio por token únicamente.
¿Qué es Claude Haiku 5.5?
Claude Haiku 5.5 es el miembro ligero de la familia actual Claude de Anthropic, desarrollado para grandes volúmenes de solicitudes donde la capacidad de respuesta y la economía operativa son centrales. Sus aplicaciones principales incluyen procesamiento de documentos, soporte conversacional, extracción de información y trabajos compactos de subagentes. La visión general del modelo de Anthropic confirma la fecha de lanzamiento, capacidades e identificadores de plataforma.
Claude Haiku 5.5 es el primer modelo Haiku que admite niveles de esfuerzo configurables, lo que permite a los desarrolladores intercambiar profundidad de razonamiento, latencia y uso de tokens dentro del mismo modelo.
¿Cuáles son las características clave de Claude Haiku 5.5?
Pensamiento adaptativo y esfuerzo ajustable
Haiku 5.5 puede decidir cuándo y cuánto razonar, mientras que el parámetro de esfuerzo ofrece a los desarrolladores una forma de equilibrar la calidad de respuesta, la latencia y el uso de tokens. El esfuerzo predeterminado es medio. Para clasificación simple, puede preferirse un esfuerzo bajo; para extracción ambigua o pasos de planificación de herramientas, puede justificarse una configuración más alta.
Procesamiento de contexto amplio
Una ventana de contexto de 1M tokens permite que documentos largos e historiales sustanciales de conversación quepan en una sola solicitud. Aun así, los desarrolladores deben usar recuperación, truncado y caché cuando corresponda: los contextos largos pueden introducir costos innecesarios y compromisos de precisión, especialmente más allá del umbral de precios de 100K.
Procesamiento de alto rendimiento y bajo costo
Las nuevas tarifas iniciales de $0.10/$0.50 hacen que solicitudes cortas repetidas sean sustancialmente más económicas que la generación Haiku anterior en términos de costo por token. Sin embargo, Anthropic documenta un tokenizador cambiado: texto idéntico produce aproximadamente 30% más tokens que en Haiku 4.5. Por lo tanto, los ahorros reales a nivel de tarea pueden ser menores que las reducciones de tarifas de titular.
Interacción con computadoras y tareas delegadas a agentes
Las evaluaciones publicadas indican un desempeño más sólido en tareas de interacción con computadoras y asistidas por herramientas que el modelo Haiku precedente. Esto hace que Haiku 5.5 sea útil para pasos de agentes acotados, pero la automatización exitosa aún depende de permisos sólidos para herramientas, recuperación de errores y aprobación humana para acciones riesgosas.
¿Cómo rinde Claude Haiku 5.5 en benchmarks?
Anthropic reporta ganancias notables en tareas de conocimiento profesional, uso de computadoras, codificación y razonamiento. Los resultados a continuación utilizan la configuración de evaluación reportada; las puntuaciones de diferentes benchmarks no deben combinarse en una única “puntuación de inteligencia”.
| Benchmark | Haiku 4.5 | Haiku 5.5 | Sonnet 5.5 |
|---|---|---|---|
| GDPval-AA v2.1 (Elo) | 735 | 1,620 | 1,840 |
| AA-Briefcase v1.1 (Elo) | 614 | 1,578 | 1,824 |
| OSWorld 2.1, offline subset, partial credit | 15.7% | 72.4% | 83.9% |
| Humanity's Last Exam, no tools | 10.2% | 45.9% | 56.9% |
| Humanity's Last Exam, with tools | 18.7% | 57.4% | 64.5% |
| Terminal-Bench 4.0 | 0.0% | 39.2% | 70.6% |
| Chartography, no tools | 6.4% | 46.4% | 61.6% |
La configuración estándar de evaluación de Haiku 5.5 en la system card usa pensamiento adaptativo al esfuerzo máximo, muestreo predeterminado y cinco ensayos salvo que se indique lo contrario; el valor predeterminado del producto es medio, por lo que las puntuaciones principales no son garantías en configuraciones predeterminadas. OSWorld usa 82 tareas offline, sin acceso a internet, 1080p y un límite de 500 acciones. Su 72.4% es una puntuación con crédito parcial; la tasa de aprobación estricta es 37.1%. GDPval-AA y AA-Briefcase son reportados por Anthropic a partir de evaluaciones de Artificial Analysis ejecutadas de forma independiente.
Terminal-Bench 4.0 usa Claude Code en modo --bare con salvaguardas habilitadas. Haiku 5.5 usa esfuerzo máximo, sin modelo de respaldo y sin egreso a internet, con 10 ensayos por tarea; Sonnet 5.5 usa cinco ensayos y un fallback para algunas solicitudes señaladas. Haiku 4.5 usa un presupuesto fijo de pensamiento de 63,999 tokens. Estas diferencias de configuración importan al interpretar 39.2% frente a 70.6%.
Los resultados de benchmarks publicados por Anthropic proporcionan las puntuaciones anteriores. OSWorld usa su subconjunto offline; Humanity's Last Exam separa ejecuciones con y sin herramientas, y Chartography es sin herramientas. Son resultados reportados por el proveedor, no mediciones independientes bajo una configuración universal. Anthropic proporciona detalles de evaluación en su system card de Haiku 5.5; reproduzca los ajustes relevantes de esfuerzo, herramientas, andamiaje y presupuesto antes de comparar sus propios resultados. El resumen de lanzamiento no especifica un entorno de prueba común completo para cada fila.
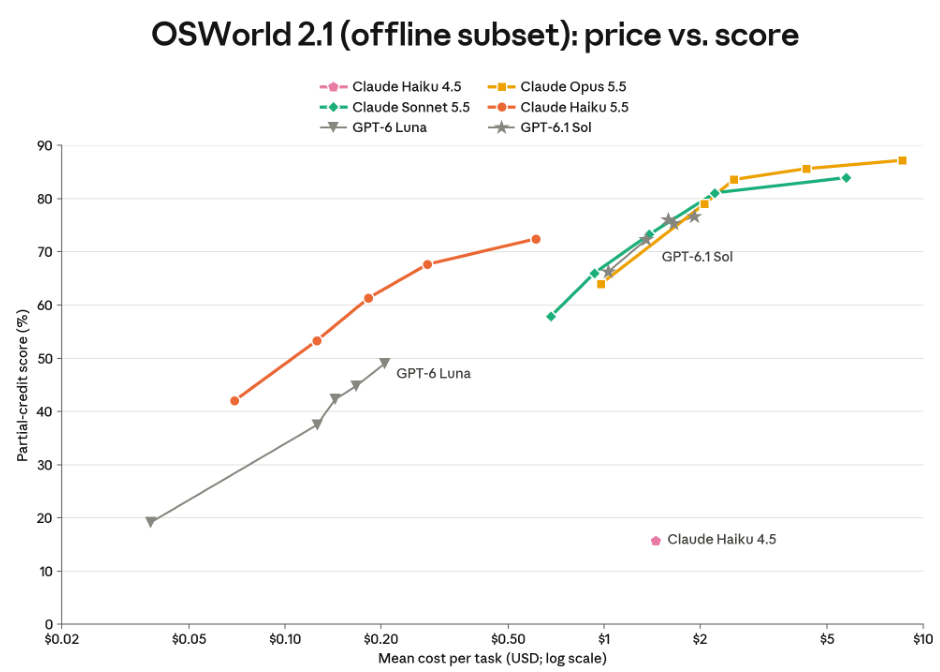
El gráfico oficial de evaluación de Anthropic anterior se reproduce de su system card. Proporciona evidencia adicional sobre las configuraciones evaluadas; no es un nuevo benchmark producido para este artículo.
Interpretación de benchmarks
La mejora en OSWorld sugiere que Haiku 5.5 se ha vuelto significativamente más útil para tareas gráficas estructuradas. Sin embargo, el 70.6% de Sonnet 5.5 frente al 39.2% de Haiku 5.5 en Terminal-Bench indica una ventaja continua para la codificación agentica con modelos más grandes. Seleccione modelos de acuerdo con el costo del fallo y la dificultad del flujo de trabajo real.
Claude Haiku 5.5 vs Haiku 4.5 vs Sonnet 5.5
| Dimensión | Haiku 4.5 | Haiku 5.5 | Sonnet 5.5 |
|---|---|---|---|
| Contexto | 200K | 1M | 1M |
| Salida estándar máxima | 64K | 128K | 128K |
| Entrada estándar / MTok | $1 | $0.10 hasta 100K; $0.50 por encima | $2 |
| Salida estándar / MTok | $5 | $0.50 hasta 100K; $2.50 por encima | $10 |
| Razonamiento | Pensamiento extendido con un presupuesto de tokens fijo | Adaptativo; predeterminado medio | Adaptativo; predeterminado alto |
| Latencia relativa | Rápido | Más rápido a velocidad estándar | Rápido |
| Profundidad de codificación | Tareas acotadas | Subagentes más fuertes | Codificación más compleja |
| Uso típico | Despliegues heredados de modelos pequeños | Flujos de trabajo de alto volumen | Flujos de trabajo de producción complejos |
Especificaciones compartidas: los tres modelos aceptan entradas de texto e imagen y producen salidas de texto. Se puede acceder a ellos a través de la API de Claude y plataformas asociadas compatibles; los identificadores de modelo y el acceso a la cuenta dependen del proveedor. La documentación del producto citada no establece recuentos de parámetros ni arquitecturas detalladas.
Haiku 5.5 es una primera opción sensata para tareas verificables y repetitivas. Sonnet 5.5 se vuelve más atractivo donde un juicio más sólido ahorra llamadas fallidas repetidas, reintentos de herramientas o correcciones humanas. Opus 5.5 es una opción para encargos multietapa particularmente exigentes.
Las etiquetas de latencia comparativa se refieren a modos de velocidad estándar. La calificación de velocidad de Anthropic excluye Opus Fast Mode de la afirmación del modelo más rápido. Los detalles de arquitectura, como el recuento de parámetros, no se establecen por estos niveles de producto. La entrada de texto e imagen con salida de texto es distinta de la generación de imágenes.
La comparación de capacidades sigue las especificaciones del modelo de Anthropic. El acceso a la plataforma depende del proveedor seleccionado y de la cuenta; ningún nivel de modelo implica un recuento de parámetros publicado.
Selección de cargas de trabajo
| Carga de trabajo | Predeterminado práctico | Por qué |
|---|---|---|
| Clasificación de correos | Haiku 5.5 | Decisiones cortas, repetidas y verificables |
| Extracción de campos de documentos | Haiku 5.5 | Procesamiento estructurado rentable |
| Triaje de soporte | Haiku 5.5 | Respuestas rápidas y escalación |
| Subagentes de codificación | Haiku 5.5 | Búsqueda de archivos de bajo costo y ediciones contenidas |
| Depuración compleja | Sonnet 5.5 | Mejor desempeño en benchmarks de codificación |
| Razonamiento multietapa de alto riesgo | Opus 5.5 | Modelo de nivel superior más capaz |
| Carga de trabajo mixta | Haiku + Sonnet | Enrutar por complejidad y confianza |
¿Cuánto cuesta Claude Haiku 5.5?
¿Por qué se anuncia Haiku 5.5 como “alrededor de 75% más barato” si su precio por token es 90% menor?
La cifra de 90% describe la reducción en las tarifas Standard de entrada y salida para prompts de hasta 100,000 tokens; prompts más largos reciben una reducción del 50%. Anthropic informa que Haiku 5.5 cuesta en promedio alrededor de 75% menos de operar, teniendo en cuenta la mezcla de longitudes de solicitud del modelo anterior y los cambios en el uso de tokens por tarea. La tokenización es un factor: el mismo texto de entrada puede contabilizar aproximadamente 30% más tokens, por lo que las estimaciones de costo deben usar recuentos medidos con el nuevo modelo.
La tarificación oficial de Anthropic tiene dos bandas de longitud de prompt. Las tarifas en la primera tabla son precios oficiales en USD por millón de tokens; la comparación con CometAPI a continuación aplica un descuento del 20% a las tarifas Standard oficiales de entrada y salida.
| Categoría de tarifa | Prompt hasta 100K | Prompt superior a 100K |
|---|---|---|
| Entrada | $0.10 | $0.50 |
| Salida | $0.50 | $2.50 |
| Escritura de caché 5 minutos | $0.125 | $0.625 |
| Escritura de caché 1 hora | $0.20 | $1.00 |
| Lectura de caché | $0.01 | $0.05 |
| Entrada por lotes (50% de descuento) | $0.05 | $0.25 |
| Salida por lotes (50% de descuento) | $0.25 | $1.25 |
Las tarifas Standard oficiales, de caché y por lotes se muestran arriba, verificadas el 8 de octubre de 2026. La longitud del prompt selecciona la banda de precios; la banda superior se aplica a la solicitud en su conjunto y no solo a los tokens por encima de 100K. Las tarifas Standard de CometAPI a continuación equivalen a las correspondientes tarifas Standard oficiales multiplicadas por 0.8. Esta comparación no asume que el descuento del gateway se acumule con descuentos por lotes o de caché.
| Longitud del prompt | Categoría de tokens | Standard oficial / MTok | CometAPI / MTok |
|---|---|---|---|
| Hasta 100K tokens | Entrada | $0.10 | $0.08 |
| Hasta 100K tokens | Salida | $0.50 | $0.40 |
| Más de 100K tokens | Entrada | $0.50 | $0.40 |
| Más de 100K tokens | Salida | $2.50 | $2.00 |
Ejemplo: 100,000 solicitudes cortas por mes
Suponga que cada solicitud usa 2,000 tokens de entrada y 500 tokens de salida; cada solicitud permanece por debajo del umbral de 100K. Ignore caché de prompts, herramientas y reintentos, y suponga recuentos de tokens idénticos entre modelos a modo ilustrativo.
| Modelo / proveedor | Entrada/mes | Salida/mes | Total/mes |
|---|---|---|---|
| Haiku 4.5 — Standard oficial | $200 | $250 | $450 |
| Haiku 5.5 — Standard oficial | $20 | $25 | $45 |
| Sonnet 5.5 — Standard oficial | $400 | $500 | $900 |
| Haiku 5.5 — CometAPI | $16 | $20 | $36 |
En este ejemplo, 100,000 solicitudes usan 200 millones de tokens de entrada y 50 millones de tokens de salida. La entrada en CometAPI cuesta 200 × $0.08 = $16 y la salida cuesta 50 × $0.40 = $20, para $36 por mes frente a los $45 oficiales: un ahorro de $9, o 20%. El escenario excluye caché, herramientas y reintentos y usa recuentos de tokens fijos; mida el costo por tarea aceptada en entradas representativas porque el tokenizador más reciente cambia los recuentos de tokens.
La comparación de $450 a $45 es una ilustración de tarifa fija de una reducción del 90%, no una promesa de ahorros del 90% para cargas de trabajo reales equivalentes. En su anuncio de lanzamiento, Anthropic reporta alrededor de 75% menor costo promedio de operación después de tener en cuenta las longitudes de solicitud y los cambios en el uso de tokens. Recuente entradas representativas y mida el costo de tareas completadas antes de estimar sus propios ahorros.
¿Dónde se puede acceder a Claude Haiku 5.5?
Acceso oficial y plataformas en la nube
Haiku 5.5 está disponible a través de la API de Claude y plataformas compatibles en Amazon Web Services, Google Cloud y Microsoft Azure, según el anuncio de disponibilidad de Anthropic. El ID del modelo directo en la API de Claude es claude-haiku-5-5; Amazon Bedrock usa anthropic.claude-haiku-5-5. Use credenciales emitidas por su proveedor elegido y verifique los requisitos actuales de acceso a la cuenta.
Acceso de terceros a través de CometAPI
La página del modelo de CometAPI lista claude-haiku-5-5 como disponible, con tarifas Standard que comienzan en $0.08 por millón de tokens de entrada y $0.40 por millón de tokens de salida para prompts de hasta 100K, 20% por debajo de las tarifas oficiales correspondientes. Use una clave emitida por CometAPI con el endpoint y formato de solicitud de CometAPI; es una ruta de acceso separada del acceso directo a la API de Anthropic. Verifique la página en vivo para disponibilidad, bandas de precios y detalles de integración.
Al cambiar de proveedor o actualizar desde Haiku 4.5, verifique los IDs de modelo, recuente tokens y pruebe los límites de respuesta y el manejo de conversaciones. Para detalles de implementación y cambios incompatibles, consulte la guía de migración de Anthropic.
Validación de la migración
- Actualice el ID del modelo y valide los campos de solicitud específicos del endpoint.
- Recuente los tokens con el tokenizador actualizado, incluidos prefijos estables y definiciones de herramientas.
- Pruebe las configuraciones de pensamiento adaptativo, las distribuciones de latencia y el análisis de bloques de respuesta.
- Verifique las llamadas a herramientas, la recuperación ante fallos y cualquier restricción de cuenta para bloques de pensamiento almacenados.
- Compare latencia p50/p95, tasa de tareas aceptadas y total de tokens facturables.
- Use un despliegue escalonado y una ruta de rollback para flujos de trabajo críticos para el negocio.
- Se prohíbe el prefill del asistente
La guía de migración de Haiku 5.5 explica el comportamiento del tokenizador, los IDs y la compatibilidad de solicitudes. Omita temperature, top_p y top_k. Si se suministran explícitamente, temperature debe ser 1 y top_p debe ser 0.99; cualquier valor de top_k, o suministrar tanto temperature como top_p, devuelve un error 400.
¿Cuáles son las limitaciones de Claude Haiku 5.5?
Haiku 5.5 no es un sustituto universal de los modelos más grandes. La codificación compleja y el razonamiento de largo horizonte siguen siendo diferenciadores significativos para Sonnet y Opus. Los prompts más largos también cuestan más, por lo que la ventana de 1M tokens debe usarse selectivamente. El razonamiento adaptativo introduce variación en los tokens generados y la latencia; los benchmarks no establecen garantías para un flujo de trabajo empresarial individual.
La automatización sensible al riesgo debe validar salidas estructuradas, limitar permisos de herramientas externas, mantener registros de auditoría y requerir revisión antes de acciones con consecuencias. Rutee tareas inciertas a modelos más fuertes en lugar de confiar únicamente en el precio base más bajo por token de Haiku.
Conclusión
Para procesamiento de alto volumen con criterios de aceptación medibles, Claude Haiku 5.5 es una actualización atractiva: precios de entrada más bajos, contexto más amplio, razonamiento adaptativo y evaluaciones publicadas más sólidas. Para programación compleja y toma de decisiones ambigua, Sonnet 5.5 u Opus 5.5 pueden ofrecer mejores economías generales al reducir reintentos y correcciones. La estrategia ganadora es evaluar el flujo de trabajo completo y enrutar las solicitudes según la dificultad.
Preguntas frecuentes
¿Cómo afecta el límite de precios de 100K de Haiku 5.5 a un flujo de trabajo con caché?
La longitud del prompt determina qué banda de tarifas se aplica; no estime el cargo solo a partir de texto nuevo ni asuma que solo los tokens excedentes usan la banda superior. Cuente la solicitud para el modelo seleccionado, incluida la historia y las definiciones de herramientas, luego concilie el uso de entrada, escritura de caché, lectura de caché y salida con la banda relevante. Compare facturas en solicitudes con caché representativas antes de fijar un presupuesto de producción.
¿Se pueden reproducir los bloques de pensamiento de Haiku 5.5 entre cuentas?
Funcionan solo en la cuenta que los produjo o en una cuenta vinculada a ella. Si una cuenta no relacionada envía un bloque de pensamiento almacenado, la API lo descarta antes de que el modelo lo vea; la solicitud aún puede tener éxito sin ese razonamiento. Consulte la guía de migración oficial. Conserve los bloques de conversación y use la cuenta de origen o vinculada al continuar un flujo de trabajo con herramientas. Un cambio de gateway o de cuenta debe probarse explícitamente; hacer coincidir un nombre de modelo no garantiza que los bloques de pensamiento almacenados sigan siendo utilizables.
¿Por qué Haiku 5.5 puede truncar una respuesta que Haiku 4.5 completaba?
El tokenizador más reciente puede contar más tokens para el mismo texto, por lo que un límite max_tokens sin cambios puede permitir menos salida equivalente. El pensamiento adaptativo también puede consumir presupuesto de salida. Inspeccione stop_reason y usage, recuente prompts con el nuevo modelo y reajuste las asignaciones de salida en tareas reales en lugar de copiar límites heredados.
¿Cómo deben seleccionarse los umbrales de enrutamiento de Haiku 5.5?
Use una muestra etiquetada del flujo de trabajo real para medir la tasa de tareas aceptadas, el costo de corrección y la latencia. Enrute las solicitudes que fallen la validación explícita o excedan el alcance de la tarea probado a un modelo más fuerte. Ajuste el umbral frente al costo total del flujo de trabajo, incluidos reintentos y escalación, y supervise después de cambios en prompts, herramientas o esfuerzo.