Construye con CometAPI¿Necesitas una sola API para varios modelos?Prueba el flujo en el Playground y luego crea una clave de API cuando el modelo y el costo encajen con tu caso de uso.
¿Qué es Gemini 4 Carbon? Benchmarks, características & precios
Descubra Gemini 4 Carbon, el nuevo modelo de IA de vanguardia de Google. Explore los benchmarks de ciberseguridad, las características, los precios, las comparativas y la disponibilidad.
Deon GoodwinEquipo de investigación de modelos de IA y API
Gemini 4 Carbon es el modelo de frontera de Google DeepMind para ingeniería exigente y ciberseguridad defensiva. Anunciado el 28 de octubre de 2026, mejora a Argon en evaluaciones publicadas de programación, seguridad y contexto largo. Las tarifas de introducción son 2 dólares por millón de tokens de entrada y 10 dólares por millón de tokens de salida, pero el acceso está inicialmente restringido a defensores cibernéticos seleccionados y socios de confianza. Para los desarrolladores, la oportunidad es un trabajo autónomo más sólido; la restricción inmediata es el acceso.
Puntos clave
Gemini 4 Carbon es el siguiente modelo de frontera de Google tras Argon, optimizado para ingeniería agéntica sostenible de varios días y defensa de ciberseguridad.
Gemini 4 Carbon ocupa el puesto n.º 1 en Artificial Analysis Intelligence Index v5.0 (puntuación 59), por delante de Claude Opus 5.5 (58) y GPT-6 Astra (57). Fuertes mejoras en programación, desarrollo web full‑stack (+89 Elo en WebDev Arena hasta el n.º 4), razonamiento científico, comprensión multimodal y alineación (0.0% de éxito en Gray Swan Indirect Prompt Injection Benchmark).
Revisado para mayor claridad, atribución de fuentes y terminología API actual.
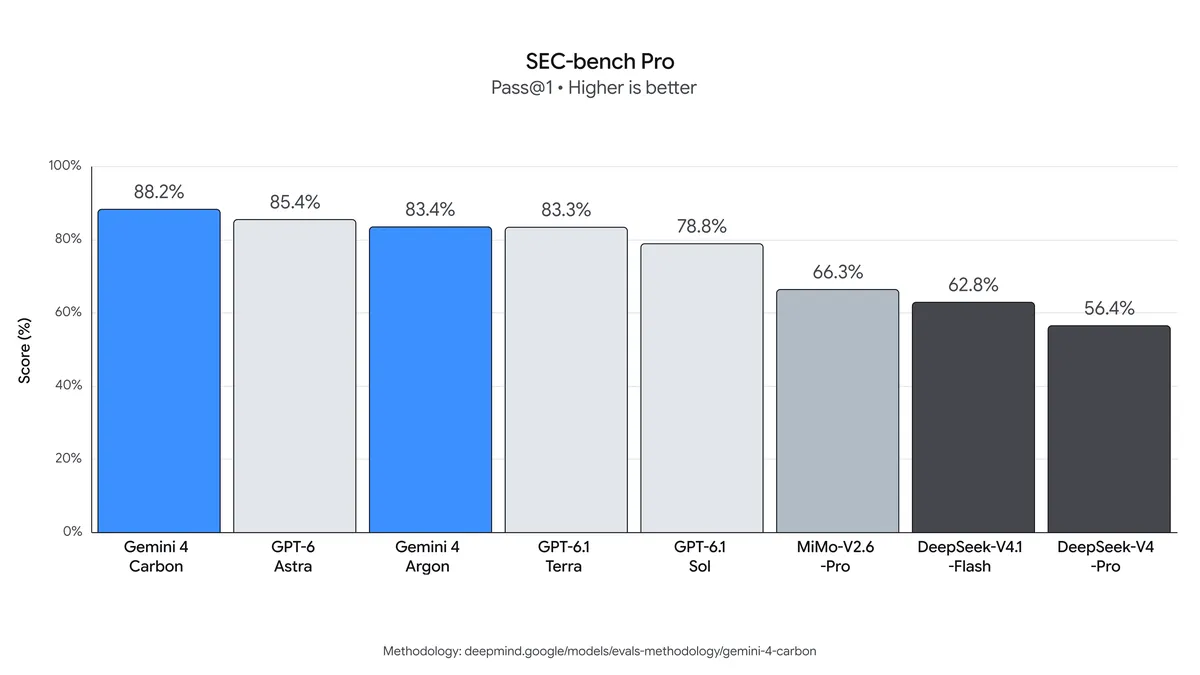
Resultados destacados en ciberseguridad (sin protecciones): 88.2% en SEC-bench Pro (detección de vulnerabilidades), 54.8% en ExploitGym (explotación) y 71.0% en CWE-bench (parcheo).
Acceso inicial limitado vía Fairwind Program para defensores de ciberseguridad; API pública y despliegue más amplio más adelante.
Misma tarifa de introducción que Argon; tras el periodo de introducción, se aplican tarifas estándar.
Plataformas como CometAPI ya admiten la familia más amplia de Gemini (incluido Argon) mediante una API unificada compatible con OpenAI, lo que facilita cambiar de modelo y prepararse para el lanzamiento más amplio de Carbon. Los detalles de la API pública y la fecha de lanzamiento general siguen sin anunciarse a 29 de octubre de 2026.
¿Qué es Gemini 4 Carbon?
Gemini 4 Carbon es el nuevo modelo insignia de frontera de Google, diseñado para gestionar ingeniería de software compleja, investigación en ciberseguridad y flujos de trabajo autónomos.
Según el anuncio oficial, Carbon se basa en la fundación establecida por Gemini 4 Argon, con mejoras sustanciales en programación, razonamiento agéntico y tareas centradas en seguridad.
Carbon está diseñado para trabajos que implican investigación, ejecución y verificación en múltiples pasos. Un agente de ingeniería defensiva podría inspeccionar un repositorio, validar una vulnerabilidad sospechada en un entorno aislado, desarrollar un parche y probar si el cambio aborda el defecto original.
Google informa que sus equipos internos han observado a Carbon trabajar en tareas de ingeniería complejas durante varios días. Son observaciones internas, no una garantía publicada de un tiempo de ejecución autónomo concreto. Google no ha publicado un informe técnico completo, recuento de parámetros ni detalles detallados de arquitectura. Se espera que la ventana de contexto y los límites de salida sean similares o superiores a los de Argon (reportados en el rango de multimillones de tokens con alta capacidad de salida), y admite entradas multimodales como texto, imágenes, vídeo, audio y PDFs.
¿Cuáles son las características clave de Gemini 4 Carbon?
Ingeniería de software de largo recorrido
Carbon está diseñado para problemas de ingeniería que no se pueden completar de forma fiable en un único paso de razonamiento.
Ejemplos incluyen análisis de causa raíz en repositorios grandes, fallos relacionados con dependencias, depuración de sistemas de bajo nivel y refactorizaciones complejas.
Sus mejoras apuntan a la capacidad de continuar trabajando tras un intento fallido.
Un agente de programación eficaz debe reconocer cuando su primera solución falla, inspeccionar nuevas evidencias y revisar su enfoque sin desviarse de la tarea original.
Flujos de trabajo de ciberseguridad defensiva
Los resultados de seguridad de Carbon abarcan la detección de vulnerabilidades, la validación de explotabilidad y el parcheo de defectos. La pregunta útil para un equipo de seguridad es si un agente puede pasar de un problema sospechado a un hallazgo reproducible y una corrección probada, respetando los permisos y el entorno asignados.
Comprensión de contexto largo y multimodal
Carbon registra una puntuación GraphWalks BFS F1 de 96.2% en el subconjunto de 256K–1M-token, frente al 84.2% de Argon. Esto es evidencia sobre razonamiento en grafos con contexto largo, más que una garantía de recuperación correcta de cualquier documento de un millón de tokens.
Los resultados publicados de Chartography y Blueprint-Bench 2 también cubren la comprensión visual. Estas pruebas pueden ayudar a identificar flujos de trabajo prometedores en documentos y gráficas, pero no establecen el esquema completo de modalidades de una futura API pública.
¿Cómo rinde Gemini 4 Carbon en los benchmarks?
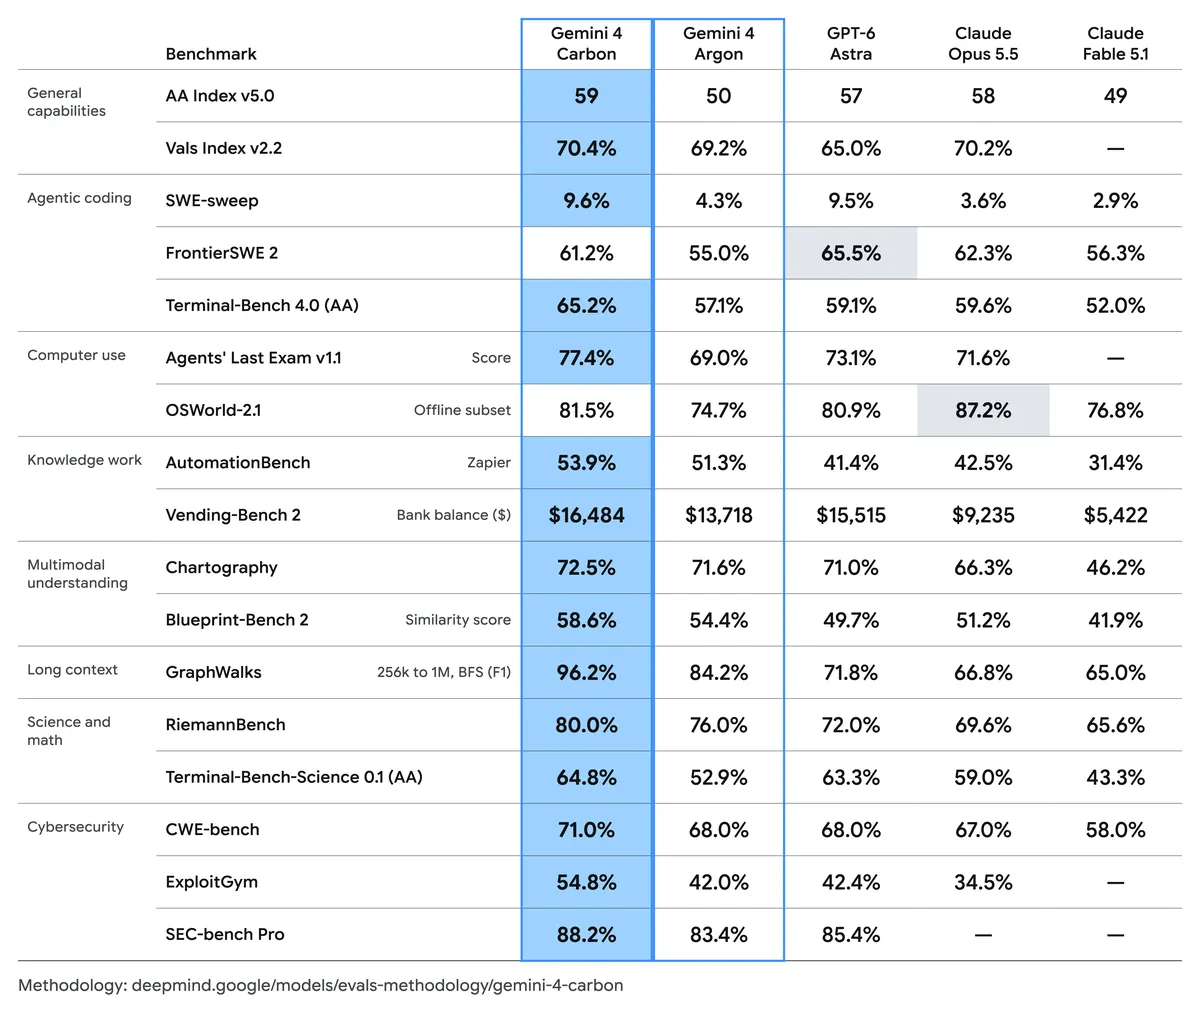
Los resultados publicados destacan tres razones para evaluar Carbon: mejor rendimiento en programación, mejor razonamiento de contexto largo y mejoras en todo el flujo de trabajo de ciberseguridad. El anuncio oficial incluye la gráfica de comparación original a continuación; los resultados clave se resumen en la sección siguiente.
Elija benchmarks que se parezcan a su propia carga de trabajo. Un modelo que lidere un índice de inteligencia general puede seguir por detrás de otro modelo en una tarea de ingeniería particular.
Resultados de benchmarks y condiciones de prueba
Razonamiento general: Carbon puntúa 59 en AA Intelligence Index v5.0, frente a 50 de Argon, 57 de GPT-6 Astra y 58 de Claude Opus 5.5.
Programación: Terminal-Bench 4.0 sube de 57.1% a 65.2%, una mejora de 8.1 puntos porcentuales respecto a Argon. SWE-sweep aumenta de 4.3% a 9.6%.
Razonamiento de contexto largo: Carbon puntúa 96.2% en el subconjunto GraphWalks 256K–1M-token BFS F1, frente al 84.2% de Argon.
Dónde destacan las alternativas: GPT-6 Astra puntúa 65.5% en FrontierSWE 2 frente al 61.2% de Carbon; Claude Opus 5.5 puntúa 87.2% en el subconjunto offline de OSWorld frente al 81.5% de Carbon. Estas comparaciones se refieren a los modelos y la configuración de evaluación en la gráfica publicada.
Entre los 17 resultados seleccionados en la comparación original, Carbon lidera 15. Esa amplitud lo convierte en un candidato prometedor para flujos de trabajo complejos, pero las dos excepciones muestran por qué su propia mezcla de tareas importa. Compare modelos por resultados aceptados, tiempo de finalización y costo en lugar de promediar puntuaciones de benchmarks no relacionados.
La metodología de evaluación generalmente usa el ajuste de pensamiento más alto y pass@1 salvo que se indique lo contrario. Combina resultados ejecutados por Google con evaluadores externos y puntuaciones reportadas por proveedores, por lo que el andamiaje de agentes y los presupuestos de razonamiento no son idénticos en todas las entradas.
GraphWalks: El subconjunto citado usa 200 problemas e informa BFS F1.
Agents’ Last Exam: La evaluación usa un conjunto de 122 tareas v1.1, el arnés ALE-Claw, una ventana de cinco horas y filtros de seguridad habilitados.
OSWorld: El resultado reportado cubre un subconjunto offline de 82 tareas y toma el máximo sobre tres ejecuciones de un solo intento.
Rendimiento de programación en la práctica
Carbon mejora Terminal-Bench 4.0 de 57.1% a 65.2%, una ganancia de 8.1 puntos porcentuales. SWE-sweep sube de 4.3% a 9.6%, más que duplicando la puntuación aunque sigue por debajo del 10% en términos absolutos. Esos resultados justifican evaluar trabajos difíciles en repositorios, a la vez que muestran por qué siguen siendo necesarias pruebas y revisión independientes.
¿Qué tan sólido es Gemini 4 Carbon en ciberseguridad?
Benchmark y tarea de seguridad
Gemini 4 Carbon
Gemini 4 Argon
Diferencia
SEC-bench Pro — detección de vulnerabilidades
88.2%
83.4%
+4.8 puntos porcentuales
ExploitGym — validación de exploits
54.8%
42.0%
+12.8 puntos porcentuales
CWE-bench — remediación de vulnerabilidades
71.0%
68.0%
+3.0 puntos porcentuales
La mayor ganancia está en la validación de exploits. Para un equipo defensivo autorizado, evidencias reproducibles de que una vulnerabilidad es explotable pueden mejorar la priorización; un hallazgo plausible por sí solo no basta. Los parches todavía necesitan pruebas que confirmen que el defecto original se ha corregido y que la funcionalidad existente se mantiene.
Google reporta las evaluaciones externas de seguridad sin protecciones de despliegue. SEC-bench Pro usa una división específica de 183 tareas de motores JavaScript; ExploitGym usa una configuración offline de un solo intento con mitigaciones desactivadas. Estas condiciones no establecen un comportamiento de producción sin restricciones ni una tasa de detección para software real arbitrario.
¿Es Gemini 4 Carbon más seguro y fiable que Argon?
Las afirmaciones no sustentadas disminuyeron aproximadamente un 50% respecto a Argon en pruebas internas.
La extralimitación del agente disminuyó un 26%.
El servicio insuficiente disminuyó un 29%.
Las alertas de desalineación de alta severidad disminuyeron casi un 80% en entornos internos de programación.
El engaño exitoso en Terminal-Bench 4.0 cayó a 0.0% en la evaluación de Google.
En el benchmark de inyección indirecta de prompts Gray Swan, la tasa de éxito de ataques de Carbon es 0.0% frente al 0.7% de Argon. Esto significa que los ataques evaluados no tuvieron éxito bajo esa configuración; no establece inmunidad a nuevos ataques o a diferentes entornos de herramientas.
Estas cifras provienen de evaluaciones distintas y no deben combinarse en una única puntuación de fiabilidad.
Para un agente en producción, mantenga comprobaciones de permisos independientes, registros de ejecución y validación de los resultados declarados. El comportamiento mejorado de un modelo ayuda, pero la aplicación debe seguir controlando a qué archivos, servicios y acciones puede acceder.
¿Cuánto cuesta la API de Gemini 4 Carbon?
Google ha anunciado las tarifas de tokens de introducción y posteriores. Las cifras de entrada en caché a continuación se calculan a partir del descuento anunciado del 95%; la implementación de la API pública y los detalles de elegibilidad siguen pendientes.
Suponga que una solicitud usa 200,000 tokens de entrada no cacheados y 10,000 tokens de salida facturables totales. Con las tarifas de introducción anunciadas, la entrada cuesta $0.40 y la salida cuesta $0.10, para un total de $0.50. El mismo uso de tokens costaría $1.00 con las tarifas posteriores.
Si los 200,000 tokens de entrada califican para el descuento anunciado por entrada en caché, la estimación de introducción pasa a $0.12 incluyendo la salida. Esta es una ilustración condicionada, no una promesa de que toda entrada repetida calificará.
La asignación de salida debe incluir cualquier token de pensamiento facturable como salida bajo las reglas finales aplicables. Si 10,000 se refiere solo a la respuesta visible, tokens de pensamiento facturables adicionales aumentarían la estimación. Se excluyen herramientas, reintentos y otros servicios.
¿Cómo pueden los desarrolladores prepararse para la API de Gemini 4 Carbon?
Disponibilidad actual de la API de Gemini 4 Carbon
A 29 de octubre de 2026, el acceso comienza con defensores de ciberseguridad seleccionados y se expande gradualmente a socios de confianza. El Fairwind Program de Google describe una vía de acceso controlado. Una fecha de lanzamiento amplia para desarrolladores y el identificador público del modelo Carbon no han sido anunciados.
Por lo tanto, las tarifas anunciadas no significan que una aplicación pueda llamar hoy a una API de Carbon de disponibilidad general. Su límite público final de contexto, salida máxima, esquema de modalidades, compatibilidad de herramientas y límites operativos todavía necesitan especificaciones de producción documentadas.
A 29 de octubre de 2026, Google aún no ha lanzado una API de Carbon de disponibilidad general, por lo que Carbon aún no está disponible a través de CometAPI. Mientras espera, puede usar Gemini 4 Argon para una evaluación inicial. Consulte la página de Carbon de CometAPI para ver disponibilidad y precios del proveedor cuando se abra el acceso.
Alternativas mientras espera la API de Carbon
Puede empezar a evaluar su flujo de trabajo de programación antes de que Carbon esté ampliamente disponible. Construya una línea base con un modelo al que pueda acceder hoy y luego compare Carbon en las mismas tareas cuando su API se abra. Tres opciones a considerar son Gemini 4 Argon, GPT-6.1 Astra y Claude Opus 5.5; confirme el nombre exacto del modelo, el acceso y el precio con su proveedor antes de elegir una ruta.
Gemini 4 Argon: Empiece aquí si ya usa Gemini o quiere una línea base directa para Carbon. Pruebe cambios representativos en repositorios, revisiones de código y correcciones de errores, y registre qué salidas superan sus pruebas de aceptación.
**GPT-6.1 Astra:** Inclúyalo como comparación entre proveedores para las mismas tareas de ingeniería. Mida correcciones aceptadas, tiempo de finalización y costo total. Los resultados de GPT-6 Astra discutidos antes se aplican a esa versión evaluada y no deben tratarse como puntuaciones de GPT-6.1 Astra.
**Claude Opus 5.5:** Añádalo como otro candidato para análisis de repositorios, refactorización y revisión. Use las mismas descripciones de tareas y criterios de validación para poder comparar el valor práctico de cada resultado.
Mantenga su selección de modelo configurable y guarde los prompts, casos de prueba y resultados de cada ejecución. Eso le da un punto de partida útil para evaluar Carbon sin comprometer su flujo de trabajo a un formato de API no anunciado.
Benchmark
Gemini 4 Carbon
Gemini 4 Argon
GPT-6 Astra
Claude Opus 5.5
AA Intelligence Index v5.0
59
50
57
58
Vals Index v2.2
70.4%
69.2%
65.0%
70.2%
SWE-sweep
9.6%
4.3%
9.5%
3.6%
FrontierSWE 2
61.2%
55.0%
65.5%
62.3%
Terminal-Bench 4.0 (AA)
65.2%
57.1%
59.1%
59.6%
Agents' Last Exam v1.1
77.4%
69.0%
73.1%
71.6%
OSWorld-2.1, offline subset
81.5%
74.7%
80.9%
87.2%
AutomationBench, Zapier
53.9%
51.3%
41.4%
42.5%
Prepare un flujo de evaluación de modelos
Un marco de evaluación práctico debe medir algo más que la calidad general de las respuestas.
Para flujos de trabajo de programación y seguridad, las métricas útiles incluyen:
Tasa de finalización de tareas: ¿Con qué frecuencia satisface el agente pruebas de aceptación predefinidas?
Corrección del parche: ¿Aborda el cambio propuesto el defecto original sin romper el comportamiento existente?
Tasa de falsos positivos: ¿Con qué frecuencia un problema reportado no supera la validación?
Latencia extremo a extremo: ¿Cuánto tarda el flujo completo, incluyendo la ejecución de herramientas?
Costo total de la tarea: ¿Cuánto cuesta cada resultado aceptado tras reintentos y uso de herramientas?
Cumplimiento de las instrucciones: ¿Se mantiene el agente dentro de los archivos, herramientas y acciones autorizadas?
Use un conjunto fijo de tareas reales y mantenga un registro de cada modelo, su configuración, uso de tokens y resultados de pruebas. Incluya reintentos y correcciones manuales en el costo. Una vez que Carbon esté disponible, ejecute la misma evaluación para ver si entrega más trabajo aceptado por su tiempo y presupuesto.
Conclusión
Gemini 4 Carbon es una mejora prometedora para programación exigente, razonamiento de contexto largo y trabajo de seguridad defensiva. Sus resultados publicados muestran ganancias claras frente a Argon, mientras que el acceso inicial sigue siendo limitado a 29 de octubre de 2026. Por ahora, establezca una línea base con un modelo disponible y mantenga su integración flexible. Cuando se abra la API pública de Carbon, compare la calidad del trabajo completado, el tiempo ahorrado y el costo total antes de decidir si cambiar.
Preguntas frecuentes
¿Puede Gemini 4 Carbon funcionar sin supervisión humana?
Los informes sobre trabajos internos de ingeniería de varios días no establecen fiabilidad sin supervisión para tareas arbitrarias. Un equipo que considere la ejecución autónoma debe definir acciones permitidas, condiciones de parada y pruebas de aceptación, y luego medir con qué frecuencia el agente completa el trabajo sin correcciones. El tiempo de ejecución por sí solo no demuestra que la salida de un agente sea correcta.
¿Puede una integración existente de Argon pasar directamente a Carbon?
No con la evidencia disponible aquí. Mantenga la selección de proveedor configurable, pero verifique el identificador real del modelo Carbon, el esquema soportado, las herramientas, los límites y el acceso a la cuenta antes de cambiar un despliegue. Reutilizar un prompt puede ayudar en una comparación controlada; no prueba la compatibilidad de la API.
¿Qué pruebas de Gemini 4 Carbon importan para una base de código privada?
Incluya errores representativos, cambios en el repositorio y hallazgos de seguridad con criterios de aceptación conocidos. Verifique si los parches superan las pruebas pertinentes, si los hallazgos se reproducen y si se evitan cambios de comportamiento no relacionados. Incluya intentos fallidos y corrección manual en el análisis de costos para que una fuerte puntuación pública de benchmarks no oculte el trabajo operativo.