Construye con CometAPI¿Necesitas una sola API para varios modelos?Prueba el flujo en el Playground y luego crea una clave de API cuando el modelo y el costo encajen con tu caso de uso.
¿Qué es Gemini 4 Hydrogen? Todo lo que necesitas saber
Explore las características, las pruebas comparativas, los precios de la API y la configuración de Gemini 4 Hydrogen. Aprenda dónde encaja en programación, análisis de documentos y flujos de trabajo de agentes.
Deon GoodwinEquipo de investigación de modelos de IA y API
Gemini 4 Hydrogen es el modelo de Google centrado en la ejecución para desarrolladores que crean asistentes de codificación, flujos de trabajo de documentos y agentes. Combina un presupuesto de contexto compartido de un millón de tokens con cuatro configuraciones de razonamiento, lo que permite ajustar la velocidad, la calidad de la tarea y el costo dentro de un mismo modelo. Su principal atractivo es completar trabajo práctico de forma eficiente; el ajuste adecuado depende de cuánto razonamiento necesite realmente tu aplicación.
Key Takeaways
Gemini 4 Hydrogen se dirige a la codificación iterativa, la depuración y la ejecución impulsada por herramientas, ya sea por sí solo o junto a un modelo de planificación.
Su presupuesto de contexto de 1,048,576 tokens se comparte entre la entrada, el razonamiento, las llamadas a herramientas y la respuesta final.
LOW, MEDIUM, HIGH y XHIGH ofrecen distintos perfiles de calidad, latencia y costo; HIGH es el valor predeterminado.
Se aceptan como entrada texto, imágenes, audio, video y documentos ofimáticos compatibles; la salida generada es texto.
Revisado para mayor claridad, atribución de fuentes y terminología API actual.
Global Standard PayGo cuesta $1.50 por millón de tokens de entrada y $7.50 por millón de tokens de salida, incluyendo el razonamiento.
What Is Gemini 4 Hydrogen?
Google DeepMind presentó Gemini 4 Hydrogen el 12 de noviembre de 2026 para tareas de codificación, trabajo con agentes y labores cotidianas de conocimiento. El modelo es propietario y está disponible a través de los productos para desarrolladores y empresas de Google.
La model card indica que Hydrogen está adaptado de Gemini 4 Carbon. Eso establece su linaje, pero no describe por sí mismo cada cambio de arquitectura o entrenamiento. Para los desarrolladores, la distinción útil es su énfasis en la ejecución rápida a través de ediciones repetidas, llamadas a herramientas y verificación.
What Are the Main Features of Gemini 4 Hydrogen?
Fast Coding, Debugging, and Repository Work
Hydrogen está diseñado para trabajo en repositorios: localizar un bug, cambiar los archivos relevantes, ejecutar tests y comprobar el resultado. Google informa que Gemini 4 Hydrogen completa tareas evaluadas 2.5 veces más rápido que Gemini 3.8 Flash en el nivel de razonamiento predeterminado HIGH. Esto se refiere al rendimiento de finalización de tareas en la evaluación de Google, no a una reducción universal de 2.5x en la latencia de respuesta del API. Los resultados reales dependen de la longitud del prompt, la ejecución de herramientas, la complejidad de la tarea y el flujo de trabajo de la aplicación, junto con un incremento en Terminal-Bench 4.1 del 18.2% al 57.0%. Estos son resultados de lanzamiento, no una garantía para todos los repositorios.
Lecturas y búsquedas paralelas de archivos pueden ayudar a que un agente inspeccione partes independientes de un repositorio antes de editar. En la práctica, el beneficio depende de las herramientas, las dependencias de la tarea y cuánto trabajo puede ejecutarse de forma segura en paralelo.
Four Adjustable Thinking Levels
Hydrogen admite cuatro niveles de razonamiento: LOW, MEDIUM, HIGH y XHIGH. HIGH es el predeterminado. Esta configuración controla cuánto razonamiento aplica el modelo antes de producir una respuesta, por lo que afecta la calidad de la tarea, el tiempo de respuesta y el uso de tokens de salida.
Thinking level
Artificial Analysis Index
Cost per index task
Time per index task
LOW
27
$0.29
1.3 min
MEDIUM
41
$0.80
3.7 min
HIGH (default)
51
$1.87
8.3 min
XHIGH
54
$3.16
aprox. 13 min
Estas mediciones del Artificial Analysis Intelligence Index son una instantánea del 13 de noviembre de 2026 de tareas de benchmark, no el costo o la latencia de una llamada ordinaria al API. Las puntuaciones del índice, la mezcla de cargas de trabajo y el rendimiento del proveedor pueden cambiar; usa la misma versión del benchmark y el mismo nivel de razonamiento al comparar resultados.
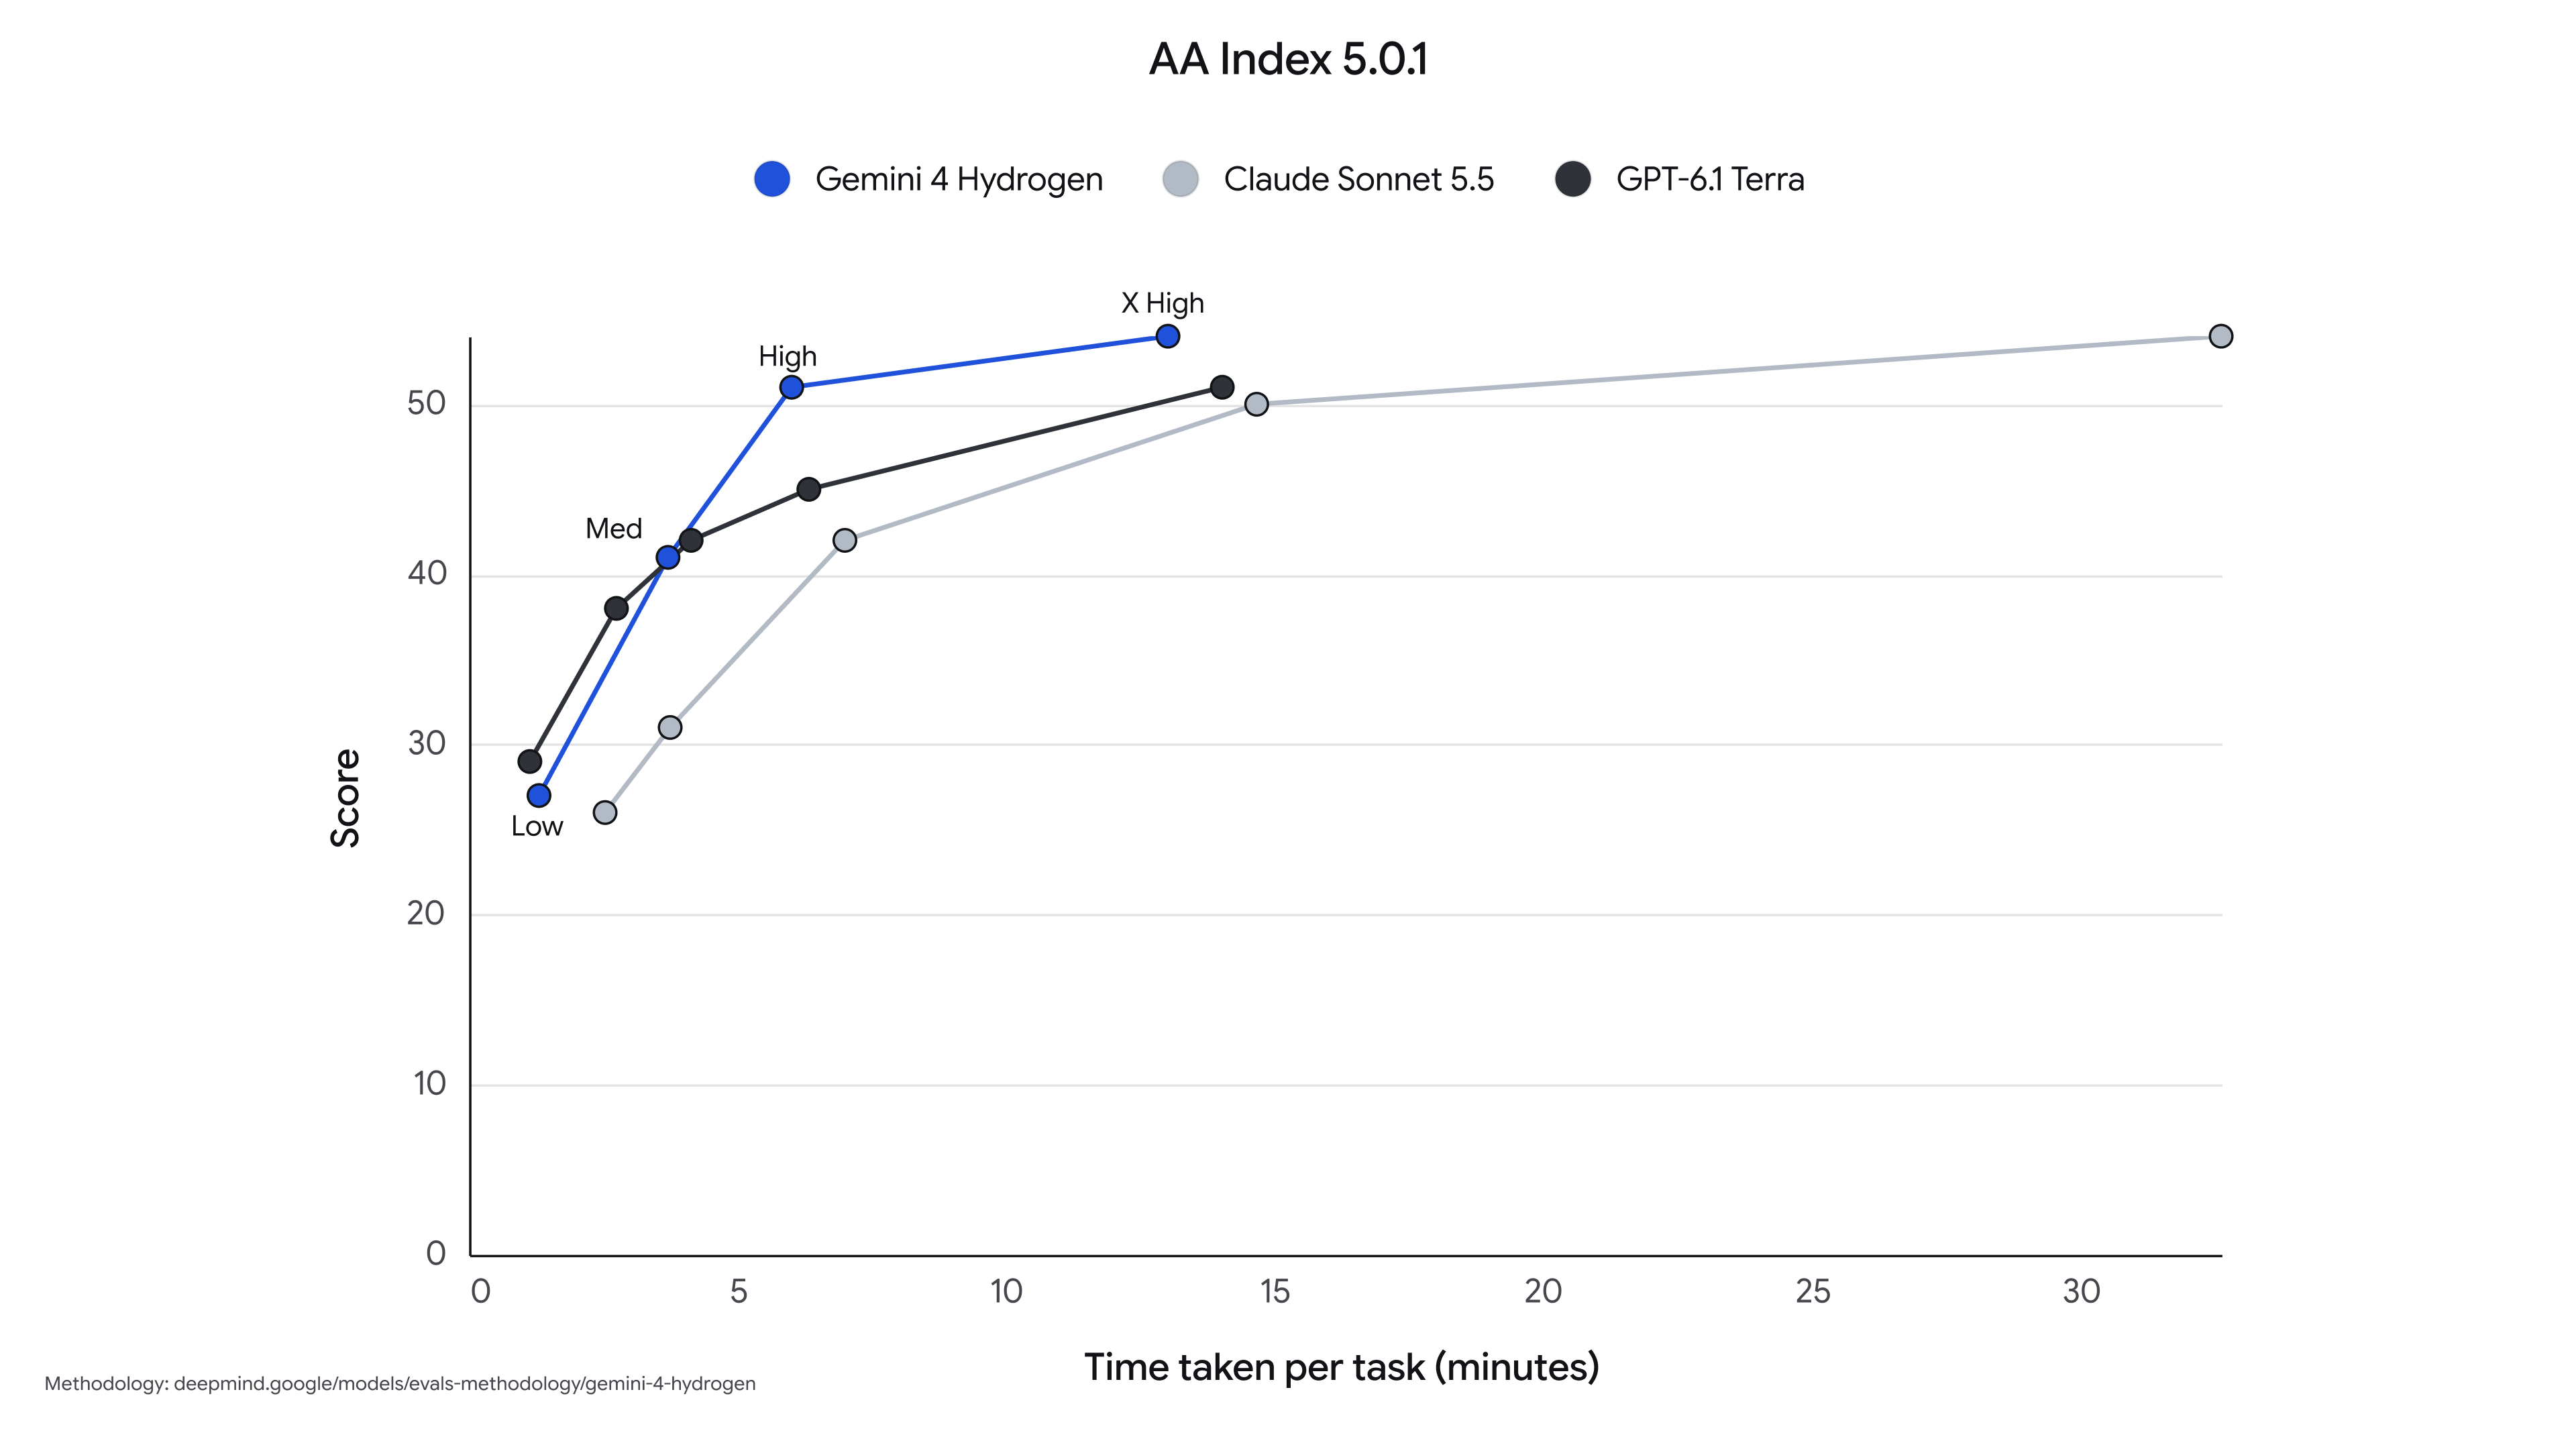
La decisión práctica más habitual suele estar entre MEDIUM y HIGH, no entre HIGH y XHIGH. Pasar de HIGH a XHIGH añade solo tres puntos en el Artificial Analysis Intelligence Index, mientras incrementa el costo medido por tarea de $1.87 a $3.16. Para cargas de agentes de alto volumen, el esfuerzo adicional de razonamiento debería justificarse por una mejora medible en la calidad de finalización.
El patrón práctico es claro: LOW es adecuado para tareas directas donde importa la velocidad; MEDIUM es una configuración interactiva útil; HIGH es un buen predeterminado para codificación y ejecución de agentes; XHIGH conviene reservarlo para tareas en las que el razonamiento extra mejora materialmente el resultado.
El gráfico de lanzamiento de Google traza la puntuación de AA Index 5.0.1 frente al tiempo por tarea. Es una instantánea fija del lanzamiento; sus valores temporales no deben tratarse como un compromiso de nivel de servicio en vivo.
Multimodal Knowledge Work and Office Documents
Google documenta entradas de PDF, Microsoft Office y OpenDocument junto con texto, imágenes, audio y video. Una aplicación puede combinar una hoja de cálculo, un informe, capturas de pantalla y una grabación de reunión, y luego devolver un análisis escrito o un resultado estructurado.
Hydrogen devuelve texto en lugar de imágenes, audio o video generados. La comprensión de video orientada a agentes está disponible pero desactivada por defecto; actívala deliberadamente cuando el flujo de trabajo necesite procesamiento activo de video.
Tool Calling, Grounding, and Computer Use
Function calling, ejecución de código, contexto de URL, uso de computadora y grounding conectan las respuestas del modelo con herramientas externas y evidencia. Selecciona las herramientas para la superficie de API que estés usando: la capacidad del modelo por sí sola no configura credenciales, permisos de herramientas ni funciones de la aplicación.
Consulta la matriz de funciones compatibles de Google antes de reutilizar una integración existente. Hydrogen no admite RAG Engine ni ajuste de modelos, y su flujo de trabajo de caché usa un enfoque implícito en lugar de recursos explícitos de contenido en caché.
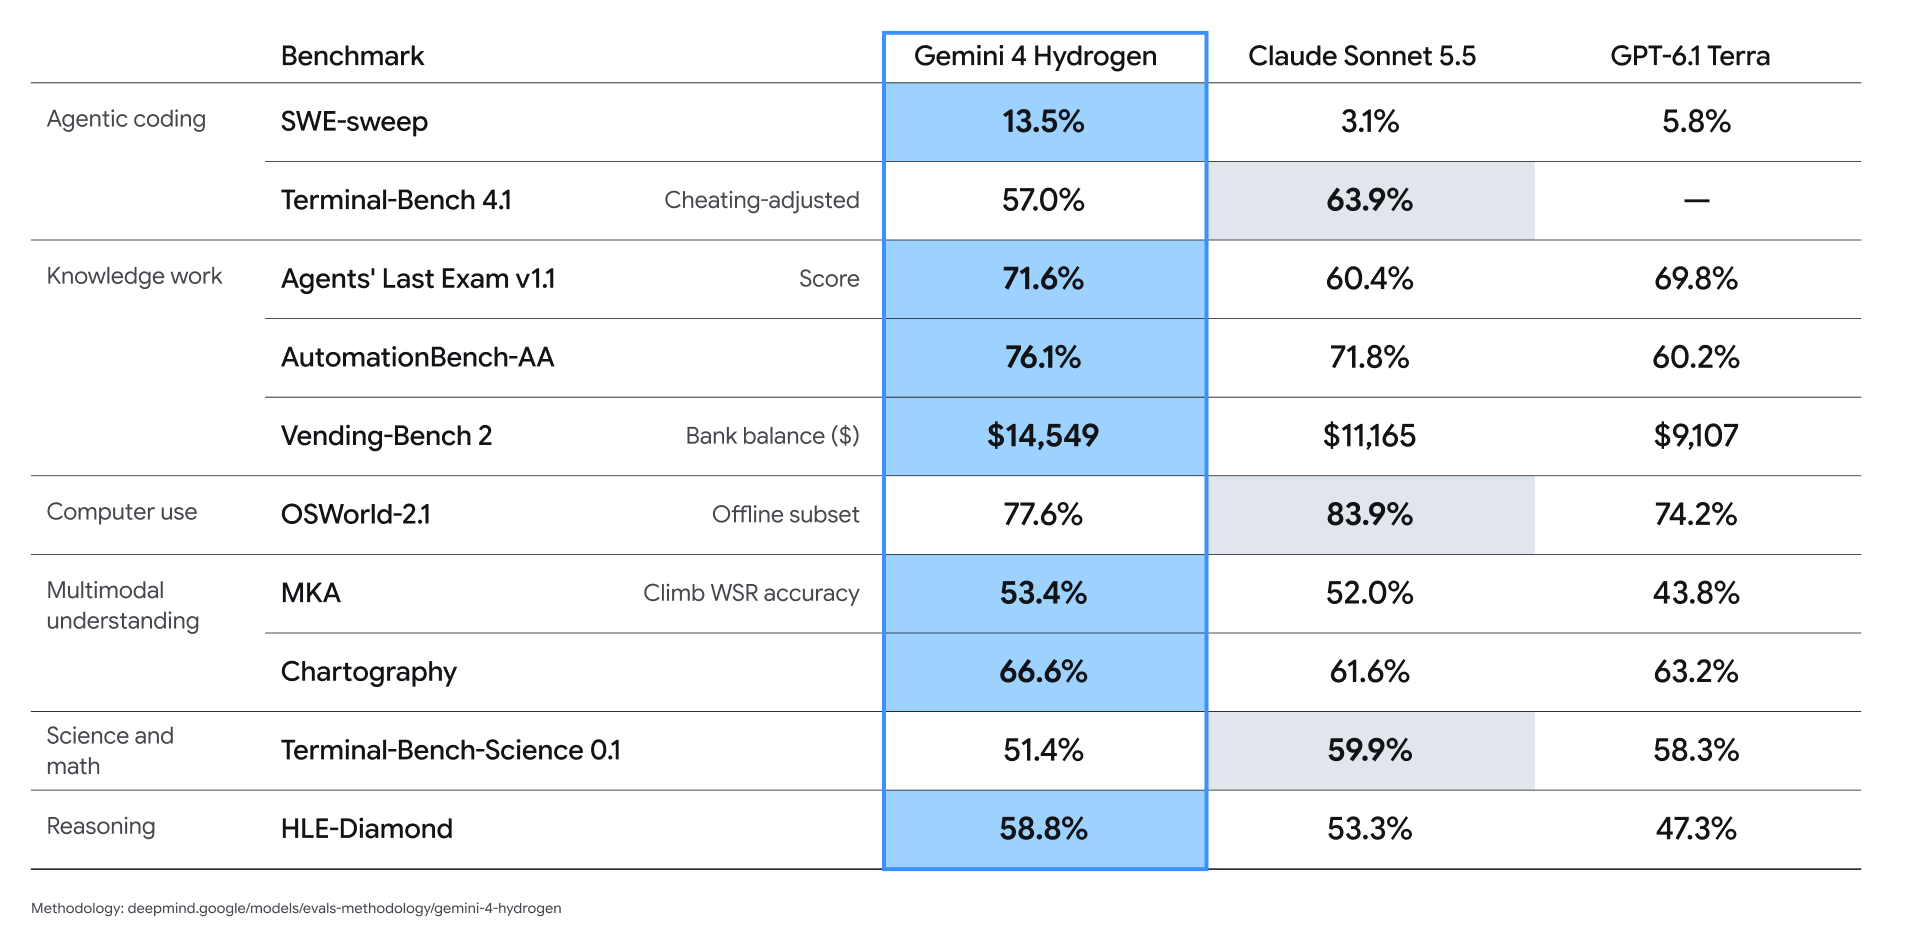
Lee cada fila bajo su configuración de evaluación indicada: Terminal-Bench 4.1 está ajustado por trampas; OSWorld-2.1 usa el subconjunto sin conexión; MKA reporta la precisión Climb WSR; y Vending-Bench 2 reporta saldo bancario simulado, no precisión porcentual. Un guion indica que no se proporciona resultado en esta comparación. El resumen de la model card no especifica un arnés completo por modelo, presupuesto de herramientas o configuración de hardware, por lo que estos resultados no establecen latencia o costo del API en condiciones iguales.
Hydrogen muestra la puntuación más alta en siete de las diez filas, incluida Chartography. Sonnet 5.5 lidera Terminal-Bench 4.1, OSWorld-2.1 y Terminal-Bench-Science 0.1. Estas diferencias favorecen elegir evaluaciones que se parezcan a tu carga de trabajo en lugar de tratar un modelo como el ganador universal.
La comparación original de lanzamiento de Google conserva las etiquetas de benchmark y las notas de evaluación. Las cifras son resultados reportados por el proveedor, no mediciones independientes realizadas para este artículo.
Gemini 4 Hydrogen vs Gemini 4 Carbon, Gemini 4 Argon, and Gemini 3.8 Flash
La comparación más útil no es simplemente qué modelo tiene la puntuación más alta. Los desarrolladores deben considerar la calidad de la tarea, la latencia, el costo por tarea completada, los requisitos de contexto y si el modelo puede usar las herramientas que su aplicación necesita.
La tabla compara funciones operativas más que detalles de arquitectura no documentados. Google identifica a Hydrogen como adaptado de Carbon; los nombres de familia de modelos por sí solos no establecen internos idénticos ni un comportamiento de API intercambiable.
Decision factor
Gemini 4 Hydrogen
Gemini 4 Carbon / Argon
Gemini 3.8 Flash
Primary use
Codificación rápida y ejecución de agentes
Razonamiento avanzado y planificación compleja
Modelo general rápido de generación anterior
Reasoning profile
Cuatro niveles seleccionables; HIGH predeterminado
Carbon y Argon: $2 / $10 tarifa promocional efectiva hasta el 30 de nov. de 2026; $4 / $20 desde el 1 de dic. de 2026
$0.75 / $3.75 tarifa promocional efectiva hasta el 31 de dic. de 2026; $1.50 / $7.50 desde el 1 de ene. de 2027
Best selection rule
Elige cuando importen el throughput y la ejecución disciplinada
Elige cuando la tarea necesite el razonamiento más sólido
Mantén para flujos de bajo costo existentes hasta que se justifique la migración
Los términos de precios promocionales de Google proporcionan los descuentos indicados mediante créditos del 50% sobre el gasto neto elegible. Las tarifas efectivas temporales anteriores no deben leerse como una reducción incondicional de todos los cargos facturados. Las tarifas son USD por millón de tokens de entrada/salida.
Para una migración desde Gemini 3.8 Flash, el principal cambio de integración es el presupuesto compartido de entrada/salida. Hydrogen también cambia los predeterminados de razonamiento y el comportamiento de caché, por lo que un simple intercambio de ID de modelo no es una migración completa. Compara resultados aceptados de tareas, reintentos y uso total de tokens antes de reemplazar un despliegue que funciona.
Carbon y Argon siguen siendo opciones de planificación útiles para trabajo difícil y ambiguo. Una división práctica del trabajo es asignar a Hydrogen una tarea de implementación acotada y escalar decisiones no resueltas. La evaluación de Orchestrator en Terminal-Bench 4.0 reportó éxito cercano a Carbon con 24% menos cuota y 19% de finalización más rápida; este es un resultado de sistema multimodelo y no debe atribuirse solo a Hydrogen.
Where Can You Access Gemini 4 Hydrogen?
Official Google Access
Puedes probar Gemini 4 Hydrogen en Google AI Studio y crear aplicaciones con la API de Gemini. Para despliegues empresariales basados en proyectos, usa Gemini Enterprise Agent Platform con la autenticación y configuración descritas en la guía para desarrolladores de Hydrogen. El ID del modelo es gemini-4-hydrogen.
Para el uso cotidiano, Hydrogen también está disponible a través de la app de Gemini y Google Search. Los desarrolladores con suscripciones de pago elegibles a Google AI pueden usarlo en Google Antigravity. Elige una ruta de API cuando necesites integrar el modelo en tu propia aplicación y una interfaz de Google cuando quieras trabajar con él directamente.
CometAPI Access
También puedes acceder a la API de Gemini 4 Hydrogen en CometAPI. Esto brinda a los desarrolladores una ruta de acceso CometAPI para añadir Hydrogen a sus aplicaciones junto a otros modelos compatibles. Usa tu cuenta y clave de API de CometAPI y sigue las instrucciones de integración para el formato de solicitud compatible.
How Much Does Gemini 4 Hydrogen Cost?
La tabla compara las tarifas del endpoint Global de Google Cloud con la API de Gemini 4 Hydrogen en CometAPI. Los precios están en USD por millón de tokens al 13 de noviembre de 2026. Las tarifas estándar de entrada y salida de CometAPI son 20% inferiores a las Global Standard de Google; los cargos de salida incluyen los tokens de razonamiento así como la respuesta final.
Provider / service tier
Input / 1M tokens
Output / 1M tokens
Cached input / 1M tokens
CometAPI savings vs Google Standard / 1M tokens
Google Standard PayGo
$1.50
$7.50
$0.075
Referencia
CometAPI
$1.20
$6.00
—
Entrada: $0.30; salida: $1.50 (20% cada uno)
Google Priority PayGo
$2.70
$13.50
$0.135
Nivel de servicio diferente
Google Batch
$0.75
$3.75
$0.0375
Nivel de servicio diferente
El 20% de descuento compara únicamente el uso estándar de entrada y salida. Las tarifas Priority, Batch y de entrada en caché de Google se muestran por separado y no son la base de ese descuento. El guion significa que aquí no se cotiza una tarifa de entrada en caché de CometAPI, en lugar de que las lecturas de caché sean gratuitas.
La tarifa Standard no global es $1.65 por millón de tokens de entrada y $8.25 por millón de tokens de salida. Las tarifas de entrada en caché se refieren a lecturas de caché. La tarificación de escrituras en caché está programada para entrar en vigor el 12 de enero de 2027 y se excluye del ejemplo siguiente.
Gemini 4 Hydrogen API Cost Example
Este ejemplo asume una solicitud con 100,000 tokens de entrada facturables y 20,000 tokens de salida facturables, incluyendo cualquier token de razonamiento, sin descuento de caché ni herramientas facturadas por separado.
La misma carga cuesta $0.24 a través de CometAPI: $0.12 por entrada más $0.12 por salida, ahorrando $0.06 (20%) frente a Google Global Standard. Google Batch costaría aproximadamente $0.15 y Priority $0.54 a sus respectivas tarifas, antes de cualquier herramienta facturada por separado. El gasto real depende de la longitud del prompt, el uso de tokens de razonamiento, las llamadas a herramientas y el nivel de servicio.
Las tarifas de grounding incluyen 5,000 consultas de grounding de Google Search por mes compartidas entre Gemini 3 y Gemini 4, luego $14 por 1,000 consultas. Google Maps tiene su propio cupo indicado de 5,000 consultas y la misma tarifa por consultas excedentes. Un prompt de usuario puede generar varias consultas facturables.
What Are the Limitations of Gemini 4 Hydrogen?
It Can Still Hallucinate or Refuse Benign Requests
La model card de Google identifica alucinaciones e informa de un aumento de 5.57 puntos porcentuales en rechazos injustificados respecto a Gemini 3.8 Flash en su evaluación automatizada de seguridad. Esa cifra se refiere a prompts benignos o limítrofes en una prueba particular; no es la tasa de rechazo para todo el tráfico en producción. Usa evidencia actual para tareas fácticas y evalúa tanto las respuestas incorrectas como los rechazos innecesarios en tus propias entradas.
Short-Term GA Lifecycle
Hydrogen es una versión de disponibilidad general (GA) de corto plazo con una política de aviso mínimo de retiro de 45 días. Mantén el modelo configurable y planifica cómo evaluar un reemplazo. La política de aviso no es una promesa de que un endpoint particular permanecerá disponible indefinidamente.
Conclusion
Comienza con un pequeño conjunto de evaluación extraído de tu carga real: un cambio de código que deba pasar tests, una tarea de documento con respuestas verificables y una secuencia de herramientas con criterios claros de éxito. Registra la calidad de finalización, el tiempo transcurrido, los reintentos y el total de tokens facturados. Adopta Hydrogen donde mejore esos resultados y mantén un fallback para los casos que no maneje con fiabilidad. Esto convierte una comparación prometedora de lanzamiento en una decisión de despliegue defendible.
FAQ
How Can I Recover an Interrupted Gemini 4 Hydrogen Long Decode?
Con un SDK de Python compatible, una continuación interrumpida puede exponer salida parcial y un token de continuación a través de ContinuationInterruptedError. Conserva ese estado y sigue el procedimiento de recuperación de decodificación larga para tu superficie de API. Reintentar la solicitud original desde cero puede repetir trabajo y cargos; es posible que los segmentos completados ya se hayan facturado.
How Should I Organize Gemini 4 Hydrogen Prompts for Caching?
Mantén las instrucciones estables y el material de referencia compartido al principio, con la entrada cambiante del usuario después. El umbral documentado de caché implícita es de 4,096 tokens. Reutilizar un prefijo puede mejorar la elegibilidad de caché, pero los ahorros reales dependen de los aciertos de caché y del uso facturado; no asumas que cada prompt repetido recibe el precio de entrada en caché.
How Can I Make Gemini 4 Hydrogen Agent Results Easier to Verify?
Da a cada herramienta un propósito acotado y define una condición de finalización observable antes de que el modelo comience. Para una edición de repositorio, exige los tests relevantes e inspecciona el diff; para extracción de documentos, valida la salida contra un esquema y conserva el pasaje de respaldo. Evalúa el artefacto final y la evidencia de herramientas en lugar de aceptar un mensaje de finalización confiado como prueba.