
TL;DR
Kimi K3.1 Pro aporta un rendimiento más sólido en programación, CAD e investigación financiera sobre la base K3 de Moonshot AI, con una ventana de contexto de un millón de tokens. Su puntuación publicada en Terminal-Bench 4.0 del 65.7% la sitúa cerca de Claude Opus 5.5 en la comparativa de Moonshot. El modelo estándar se adapta a cargas sensibles al costo; Highspeed ofrece aproximadamente 2–3× más velocidad de salida con las mismas capacidades anunciadas.
Ambos están disponibles a través de la API de Kimi K3.1 Pro de CometAPI. La tarifa estándar de CometAPI es de $1.60 por millón de tokens de entrada y $8.00 por millón de tokens de salida. Esta guía explica los benchmarks, compara costos y muestra cómo invocar cualquiera de las versiones. Las cifras y los precios se verificaron el 24 de octubre de 2026.
Puntos clave
- Kimi K3.1 Pro es una mejora de posentrenamiento: se basa en la fundación MoE de K3 y admite una ventana de contexto de 1,048,576 tokens.
- Kimi K3.1 Pro refuerza los flujos de trabajo de agentes: Moonshot informa 65.7% en Terminal-Bench 4.0 y 92.7% de Voxel IoU en BenchCAD con herramientas.
- Kimi K3.1 Pro Highspeed prioriza la velocidad de respuesta: su tasa de salida anunciada es aproximadamente 2–3× la de la versión estándar, con las mismas capacidades del modelo.
- El acceso a la API de Kimi K3.1 Pro está disponible a través de CometAPI: las tarifas estándar de entrada y salida son un 20% inferiores a las oficiales publicadas en USD; la tarificación de Highspeed requiere verificación de cuenta por separado.
- El acceso alojado a Kimi K3.1 Pro se adelanta a la publicación completa de pesos: Moonshot planea publicar los pesos completos para el 4 de noviembre de 2026.
¿Qué es exactamente Kimi K3.1 Pro?
Kimi K3.1 Pro es el modelo de lenguaje grande insignia de Moonshot AI (月之暗面), con sede en Pekín, lanzado el 23 de octubre de 2026. No es un modelo base completamente nuevo. En su lugar, es una versión fuertemente posentrenada del anterior Kimi K3 (lanzado en julio de 2026), utilizando un cómputo de posentrenamiento significativamente mayor centrado en aprendizaje por refuerzo conjunto en cientos de dominios downstream.
Moonshot lo describe como “nuestro modelo de pesos abiertos más capaz de la clase 3T hasta la fecha”. El modelo mantiene la misma arquitectura central que K3:
- 2.8 billones de parámetros totales
- 104 mil millones de parámetros activos por token (diseño escaso de Mezcla de Expertos, MoE)
- Ventana de contexto nativa de 1 millón de tokens
- Soporte multimodal (entrada de texto, imágenes y video)
- Razonamiento siempre activado (sin modo de no razonamiento)
Una variante complementaria, Kimi K3.1 Pro Highspeed, ofrece de 2 a 3× la velocidad de inferencia de la versión Pro estándar a doble precio, lo que la hace adecuada para aplicaciones más interactivas o sensibles a la latencia.
Se prevé la publicación de los pesos completos del modelo para el 4 de noviembre de 2026, lo que convertiría a K3.1 Pro en uno de los modelos de pesos abiertos más potentes disponibles.
Especificaciones técnicas de Kimi 3.1 Pro
| Especificación | Detalles |
|---|---|
| Familia de modelos | Serie Kimi K3.1 (primer modelo) |
| Base | Kimi K3 posentrenado |
| Parámetros totales | 2.8 billones |
| Parámetros activos | 104 mil millones (MoE) |
| Ventana de contexto | 1,048,576 tokens |
| Salida máxima | Hasta ~944K–1M tokens (configurable) |
| Modalidades de entrada | Texto, Imagen, Video |
| Salida | Texto |
| Razonamiento | Siempre activado (esfuerzo bajo/alto/máx.) |
| Llamadas a herramientas | Compatibles |
| Salida estructurada (JSON) | Compatible |
| IDs de modelo de API | kimi-k3.1-pro, kimi-k3.1-pro-highspeed |
| Pesos abiertos | Para el 4 de noviembre de 2026 |
imi K3.1 Pro Benchmarks: Coding, CAD, and Finance
La siguiente tabla utiliza las evaluaciones del lanzamiento de Moonshot. Son resultados de benchmarks reportados por el proveedor, no una prueba reproducida de forma independiente entre proveedores.
Las tasas de alucinación cayeron drásticamente: Moonshot informa que las afirmaciones falsas pasaron de 23.4% en K3 a alrededor de 8.3% (o menos en pruebas internas). El modelado y la investigación relacionados con finanzas también mejoraron significativamente.
| Benchmark | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | Nota |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | 66.4% | 58.2% | Agentes de programación en tareas reales de terminal |
| BenchCAD, con herramientas (Voxel IoU) | 92.7% | 96.2% | 95.9% | Reconstrucción 3D / CAD |
| OfficeQA Pro v2 | 64.4 | 62.2 | 54.4 | Documentos y tareas de oficina |
| Frontier Finance | 58.6 | 56.7 | 45.0 | Finanzas |
| SWE-Marathon | 51.7% | 46.3% | 42.5% | Ingeniería de software de largo horizonte |
| Humanity’s Last Exam (with tools) | 70.0% | 67.7% | 57.2% | Conocimiento amplio y razonamiento |
| Kimi Hallu Bench Hard, con herramientas (menor es mejor) | 8.3% | 15.0% | 5.5% |
Los benchmarks de programación muestran rendimiento de frontera a nivel de agente
En Terminal-Bench 4.0, la brecha con Claude Opus 5.5 es de 0.7 puntos porcentuales; la ventaja sobre GPT-6 Astra es de 7.5 puntos. Esto convierte a K3.1 Pro en un candidato relevante para agentes de ingeniería basados en terminal, pero el diseño de la evaluación importa tanto como la cifra principal.
Tenga en cuenta que algunas pruebas independientes de agentes de programación muestran resultados más dispares dependiendo del arnés exacto y la duración de la sesión, con K3.1 Pro produciendo a veces trazas de razonamiento más largas y verbosas.
Kimi K3.1 Pro mejora la creación 3D y la visión
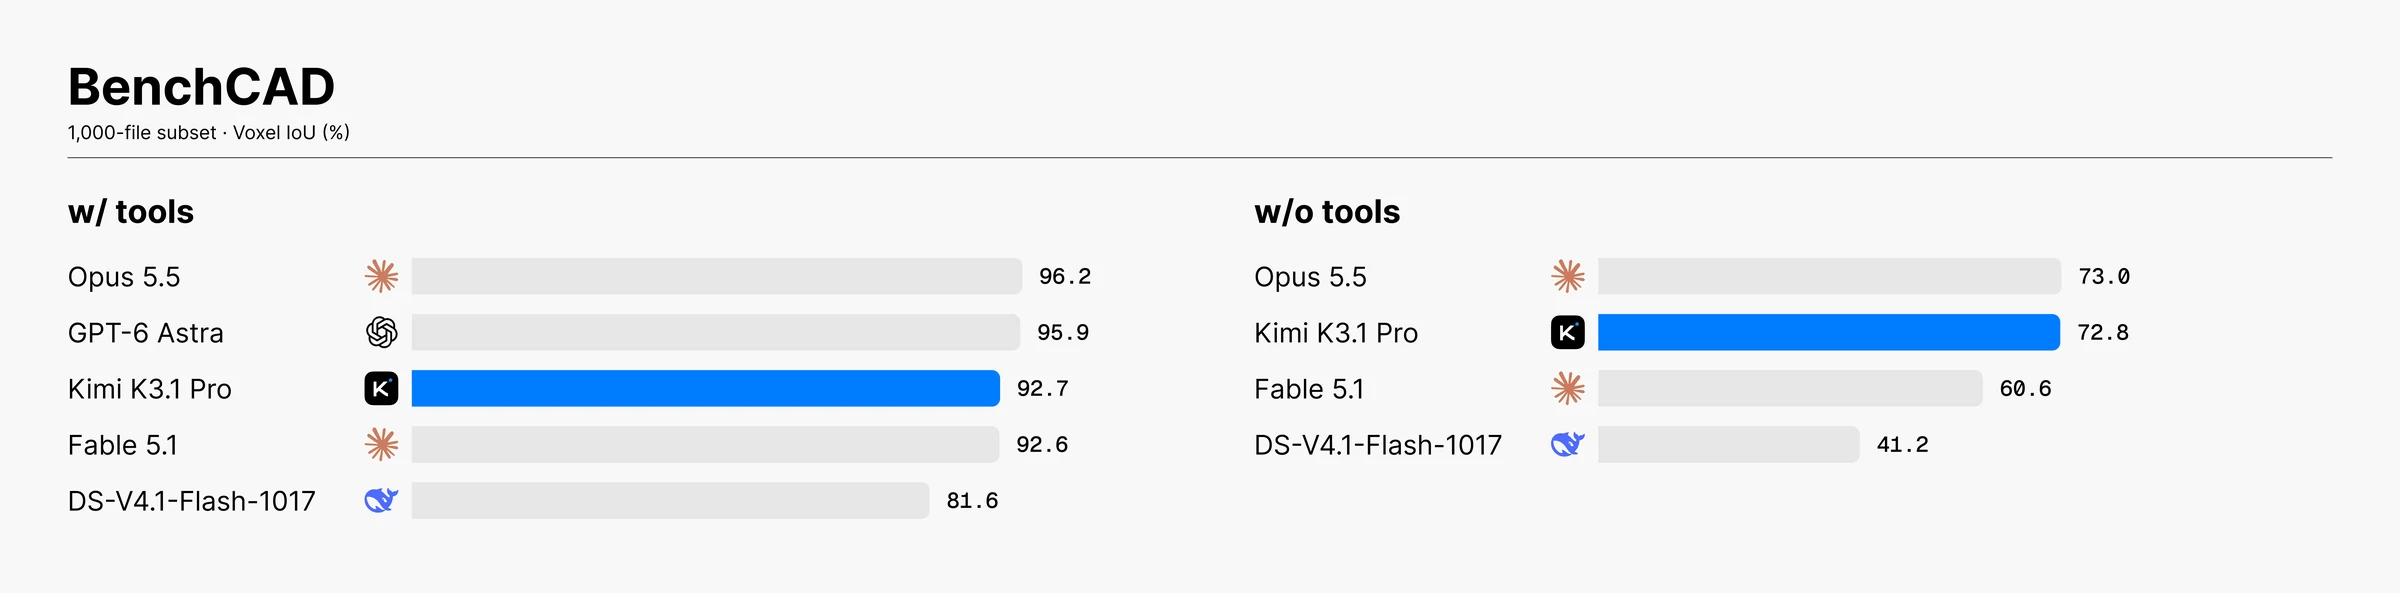
BenchCAD mide la calidad de reconstrucción a partir de renders multivista mediante código CAD generado. Su puntuación de Voxel IoU mide la superposición geométrica, por lo que 92.7% no debe leerse como una tasa de aciertos del 92.7%. La comparación con herramientas de Moonshot utiliza un subconjunto de 1,000 casos y sitúa a K3.1 Pro por debajo de Opus 5.5 y GPT-6 Astra en esta métrica.
También muestra grandes avances sobre Kimi K3 en tareas de visión-lenguaje (p. ej., +0.11 mAP50 en la clasificación de autoanotación de Ultralytics) y en exámenes de analítica de datos (42/43 preguntas aprobadas).
¿Qué hay de nuevo en Kimi K3.1 Pro frente a Kimi K3?
La razón más clara para considerar una actualización es la mejora en completar trabajos de múltiples pasos. La tabla siguiente compara K3 y K3.1 Pro dentro de las evaluaciones reportadas por Moonshot.
| Evaluación | Kimi K3 | Kimi K3.1 Pro | Mejora |
|---|---|---|---|
| Kimi Code Bench 3.0 Long-horizon | 55.95% | 61.2% | +5.25 puntos |
| Internal Financial Modeling | 50.4 | 57.6 | +7.2 puntos |
| Internal Financial Research | 58.8 | 70.4 | +11.6 puntos |
| Internal Business Operation | 8.9 | 37.0 | ~4.2× rendimiento |
| Kimi Hallu Bench Hard with tools, claim-level errors | 23.4% | 8.3% | ~64.5% menos |
Sin embargo, se trata de comparaciones de benchmarks individuales. No deben interpretarse como una mejora universal de 4.2× en el rendimiento de agentes.
Kimi K3.1 Pro reduce los errores fácticos
El gráfico separa los resultados sin herramientas de la evaluación más difícil con herramientas; la cifra de 8.3% pertenece a esta última.
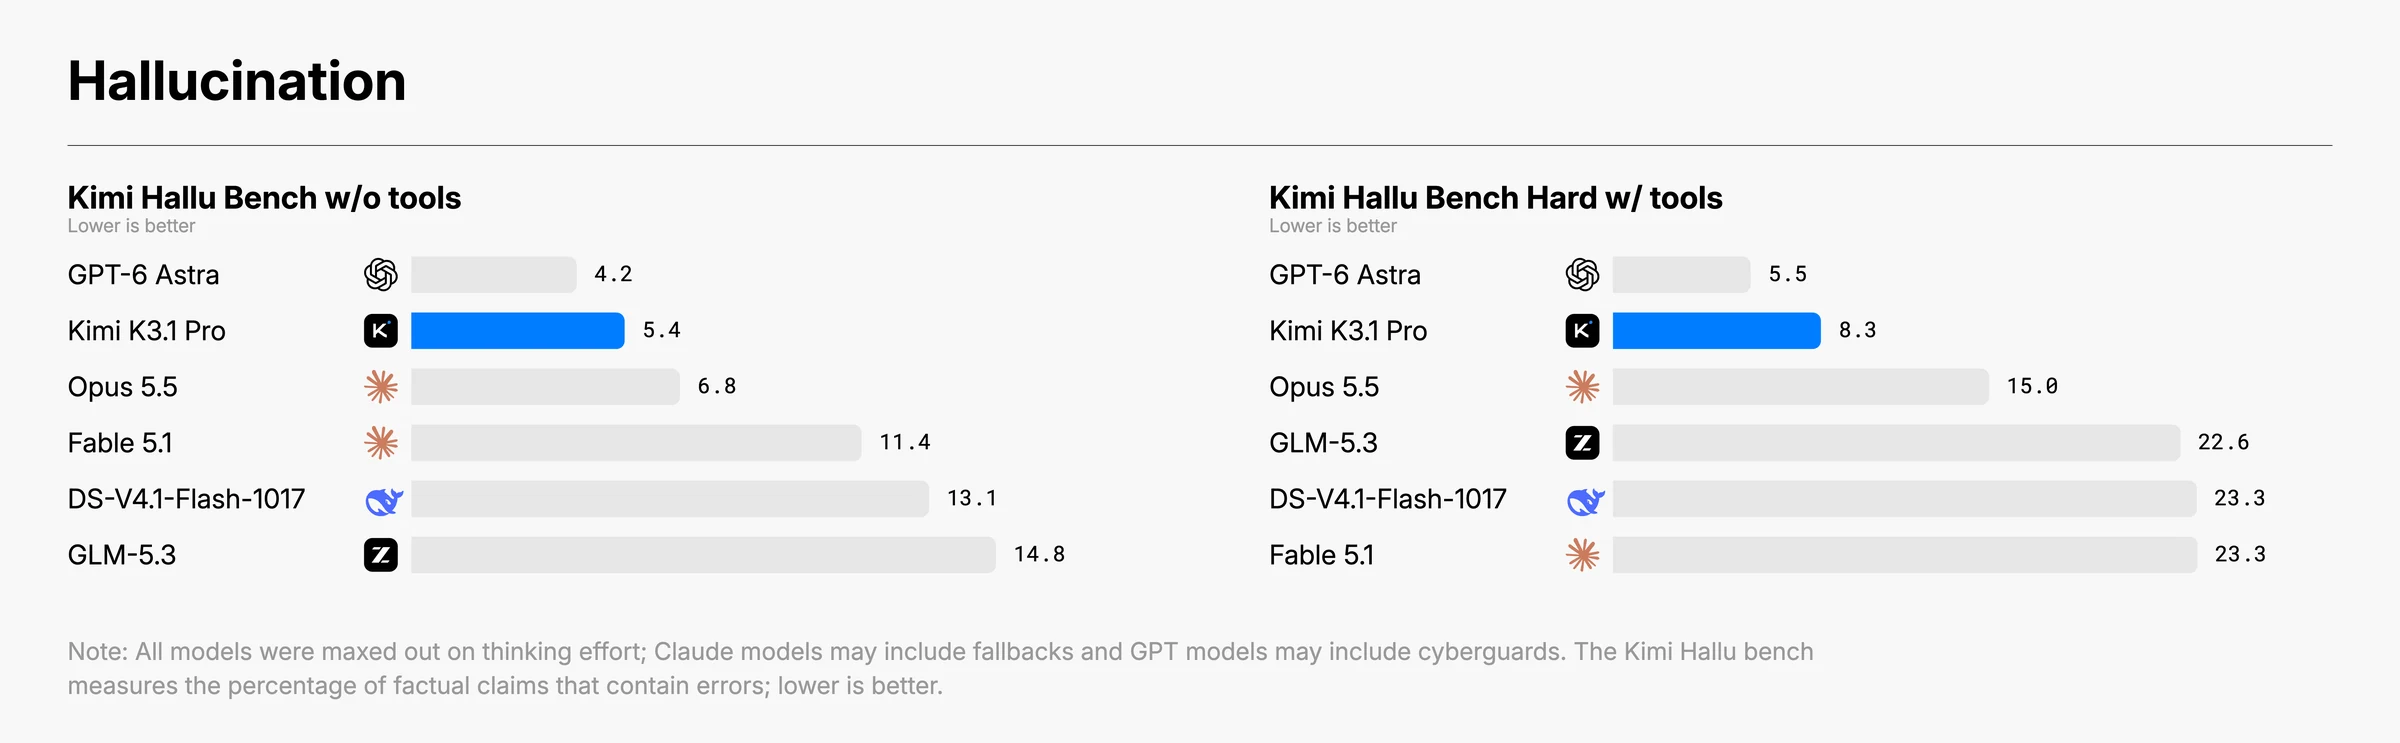
La distinción entre exactitud en benchmarks y fiabilidad en el mundo real es importante. Esta evaluación utiliza deliberadamente prompts difíciles que probablemente expongan errores fácticos. Sus resultados no representan la tasa media de alucinación del modelo en conversaciones cotidianas.
Kimi K3.1 Pro introduce una compensación deliberada en ciberseguridad
Moonshot AI eliminó datos de entrenamiento y tareas de aprendizaje por refuerzo selectas relacionadas con ciberseguridad ofensiva para reducir dichas capacidades, preservando el rendimiento general de programación.
En la evaluación interna xdev-bench-hard de Moonshot en pass@3, el checkpoint sin restricciones obtuvo 90.5% y el modelo de lanzamiento obtuvo 81.0%. Esa diferencia refleja una elección deliberada de entrenamiento, no una garantía de que el modelo publicado no pueda ser mal utilizado. Consulte la evaluación oficial de ciberseguridad para conocer sus condiciones y limitaciones.
Kimi K3.1 Pro vs Highspeed: ¿qué versión deberías elegir?
| Factor de decisión | Kimi K3.1 Pro | Kimi K3.1 Pro Highspeed |
|---|---|---|
| Capacidades del modelo | Capacidades insignia estándar | Mismas capacidades anunciadas |
| Velocidad de salida | Línea base | Aproximadamente 2–3× más rápida |
| Mejor carga inicial | Análisis por lotes, informes largos, tareas en segundo plano | Asistentes de programación e investigación interactivos |
| ID de modelo en CometAPI | kimi-k3.1-pro | kimi-k3.1-pro-highspeed |
Usa la versión estándar cuando el costo importe más que la salida inmediata. Elige Highspeed cuando los usuarios estén esperando la generación; luego mide el efecto en tareas completas en lugar de asumir que la velocidad de salida se traduce directamente en el mismo ahorro de tiempo total.
Por ejemplo, si un agente de programación pasa la mayor parte del tiempo ejecutando pruebas, instalando dependencias o esperando herramientas externas, acelerar la salida del modelo puede producir una mejora de extremo a extremo relativamente pequeña.
Accede a ambas versiones de Kimi K3.1 Pro a través de CometAPI
CometAPI proporciona acceso a Kimi K3.1 Pro y Kimi K3.1 Pro Highspeed mediante su endpoint de Chat Completions compatible con OpenAI. La integración se mantiene igual al cambiar de versión; cambia el ID del modelo para seleccionar la variante.
- Crea una clave de API en tu cuenta de CometAPI y ponla a disposición de tu aplicación como la variable de entorno COMETAPI_API_KEY.
- Instala el SDK de Python de OpenAI y establece la base URL del cliente en
https://api.cometapi.com/v1. - Usa kimi-k3.1-pro para el modelo estándar o kimi-k3.1-pro-highspeed para Highspeed.
python -m pip install --upgrade openaiimport osfrom openai import OpenAIclient = OpenAI( api_key=os.environ["COMETAPI_API_KEY"], base_url="https://api.cometapi.com/v1",)response = client.chat.completions.create( model="kimi-k3.1-pro", # O "kimi-k3.1-pro-highspeed" messages=[ { "role": "user", "content": "Sugiere tres pruebas para una función de importación de CSV.", } ],)print(response.choices[0].message.content)
El siguiente ejemplo de shell invoca Highspeed directamente. Usa la misma variable de entorno COMETAPI_API_KEY.
Precios de la API de Kimi K3.1 Pro: tarifas oficiales vs CometAPI
La tabla compara tarifas publicadas en USD por un millón de tokens para entrada sin caché y salida generada, verificadas el 24 de octubre de 2026. Las tarifas estándar de K3.1 Pro en CometAPI son un 20% inferiores a las oficiales. Verifica las tarifas actuales de Highspeed en tu cuenta antes de elegir esa versión.
| Modelo | Entrada oficial | Salida oficial | Entrada en CometAPI | Salida en CometAPI |
|---|---|---|---|---|
| Kimi K3.1 Pro | $2.00 | $10.00 | $1.60 | $8.00 |
| Kimi K3.1 Pro Highspeed | $4.00 | $20.00 | Verifica precio en cuenta | Verifica precio en cuenta |
No se debe asumir que el descuento de la versión estándar se aplique a Highspeed. Lecturas y escrituras de caché, cargos por herramientas, impuestos y reintentos quedan fuera de esta comparación.
A tarifas oficiales de API, K3.1 Pro es aproximadamente un 33.3% más barato que K3 para tokens de entrada y salida sin caché.
Para solicitudes sin caché ni servicios adicionales facturables, el costo es:
Costo = (Tokens de entrada × Tarifa de entrada + Tokens de salida × Tarifa de salida) / 1,000,000
Por ejemplo, procesar 100,000 tokens de entrada sin caché y generar 10,000 tokens de salida cuesta aproximadamente $0.24 a través de la API estándar de K3.1 Pro en CometAPI, frente a $0.30 a la tarifa del proveedor oficial.
Estima el gasto en producción a partir de tareas exitosas, incluyendo cualquier reintento o uso de tokens de razonamiento que aparezca en tus registros de facturación. Una tarifa de token más baja no garantiza un costo total menor si un flujo genera más tokens o necesita intentos adicionales.
Pon Kimi K3.1 Pro a trabajar: cuatro puntos de partida prácticos
Elige un flujo pequeño con una salida que puedas inspeccionar.
| Flujo de trabajo | Un primer proyecto práctico | Criterios de aceptación |
|---|---|---|
| Ingeniería de software | Corregir un bug reproducible en un repositorio y añadir una prueba de regresión. | Pasan las pruebas relevantes; el parche aborda el problema sin cambios no relacionados. |
| CAD y creación 3D | Generar una pieza paramétrica a partir de un briefing dimensionado. | Verifica dimensiones, geometría válida, editabilidad y compatibilidad de exportación. |
| Investigación financiera | Conciliar cifras seleccionadas entre informes anuales y un libro de trabajo. | Verifica cada cifra con su fuente y comprueba las fórmulas de forma independiente. |
| Investigación de largo contexto | Comparar requisitos en una colección de documentos técnicos. | Revisa ubicaciones de evidencia, versiones de documentos y cobertura de afirmaciones en conflicto. |
Para la evaluación, el éxito en tareas completadas es más informativo que el número de líneas de código generadas.
¿Cuáles son las limitaciones de Kimi K3.1 Pro?
- El razonamiento permanece activado. K3.1 Pro admite esfuerzo de razonamiento bajo, alto y máximo, con máximo como valor predeterminado documentado. No asumas que hay un modo sin razonamiento disponible.
- Las entradas largas tienen costos operativos. Una ventana de contexto grande puede aumentar el tiempo de procesamiento de entrada y el consumo de tokens. Selecciona material relevante y evalúa el caché en lugar de enviar un archivo completo por defecto.
- Una respuesta de API no completa un flujo de trabajo externo. Tu aplicación aporta la ejecución de herramientas, el estado guardado y la validación de salida; un resultado de benchmark con herramientas no significa que esas capacidades vengan con una llamada básica a la API.
- El acceso alojado y la publicación de pesos descargables son hitos distintos. A 24 de octubre, la publicación completa de pesos de K3.1 Pro sigue prevista para el 4 de noviembre de 2026; revisa la publicación y la licencia antes de planificar el autoalojamiento.
El comportamiento de la API se describe en la guía de la API de Kimi; la disponibilidad de pesos se cubre en el anuncio de lanzamiento.
Conclusión
Kimi K3.1 Pro merece una evaluación cuando tu aplicación depende de programación de múltiples pasos, investigación documental o trabajo asistido por herramientas. Sus ganancias reportadas sobre K3 y las tarifas estándar de API más bajas crean una razón práctica para probar la actualización. Comienza con el modelo estándar, mide la calidad y el costo de tareas aceptadas, y elige Highspeed cuando una generación más rápida mejore materialmente la experiencia del usuario. Usa el modelo de CometAPI para comprobar el acceso y los precios actuales antes de integrar los ejemplos anteriores.