
TL;DR
Muse Ember es el modelo de razonamiento multimodal más pequeño de Meta, creado para tareas de agente de alto volumen como enrutamiento, extracción, llamadas a herramientas y codificación focalizada. Meta presentó Muse Ember el 9 de noviembre de 2026.
Su ventana de contexto de 1,048,576 tokens admite material fuente sustancial. Meta ofrece acceso mediante Model API y Muse Code; CometAPI lista muse-ember, con el estado de activación cubierto más abajo. Comience con una tarea repetida cuyo resultado pueda verificar y luego compare el costo por resultado exitoso, incluyendo razonamiento, herramientas y reintentos.
Puntos clave
- Rol: Muse Ember está diseñado para ejecución repetida de agentes, incluyendo clasificación, extracción, llamadas a herramientas y tareas de codificación acotadas.
- Entradas y capacidad: Muse Ember acepta texto, imágenes, audio y video, con una ventana de contexto de 1M de tokens y hasta 512K tokens de salida.
- Rendimiento: Los resultados de Meta favorecen a Muse Ember en varios benchmarks de agentes, mientras que pruebas de analítica independientes muestran que precios bajos por token no siempre producen el menor costo por tarea.
- Precios: Las solicitudes por encima de 200K tokens de entrada pasan a un tramo de precio superior; el costo total por tarea también depende del razonamiento y el uso de herramientas.
- Acceso: Meta Model API y Muse Code están disponibles; el listado de CometAPI actualmente marca el modelo como Coming soon.
¿Para qué es mejor Muse Ember?
Muse Ember maneja los pasos de ejecución en un flujo de trabajo de agente mientras un modelo más grande gestiona la planificación. Encaja en tareas de alto volumen con entradas claras, un alcance limitado y un resultado que su aplicación puede verificar. Sus trabajos principales son:
- Clasificación y enrutamiento: Etiquetar solicitudes y enviarlas a la cola o servicio correcto.
- Extracción: Convertir documentos y medios en campos estructurados con evidencia de origen.
- Llamada a herramientas: Seleccionar una función y proporcionar los argumentos que su aplicación ejecuta.
- Procesamiento por lotes: Aplicar una operación repetible a archivos o registros.
Enrutamiento de tickets de soporte
Un flujo práctico de soporte puede pedir a Ember que extraiga una referencia de pedido, asigne una categoría y marque información faltante. Su aplicación puede validar la referencia contra sus registros antes de enrutar el ticket. Mantenga reembolsos, cambios de cuenta y otras acciones de consecuencia detrás de los controles de autorización de la aplicación.
Extracción de documentos con evidencia
Para el procesamiento de facturas o contratos, solicite tanto el valor extraído como la página o pasaje que lo respalda. Trate los campos ausentes e ilegibles como resultados explícitos en lugar de invitar al modelo a adivinar. Esto produce registros que los revisores pueden inspeccionar sin releer cada documento.
Trabajo de codificación focalizado
Dé a un trabajador de codificación un límite de propiedad pequeño: los archivos que puede cambiar, el comportamiento que debe conservar y las pruebas que definen la finalización. El ejemplo de migración de código en paralelo de Meta ilustra esta división del trabajo. El agente circundante ejecuta comandos y verifica resultados; la respuesta del modelo por sí sola no es evidencia de que un cambio pasó sus pruebas.
El visual de lanzamiento de Muse Ember de Meta acompaña su guía para combinar un modelo de ejecución con un modelo de planificación más grande.
Meta dice que Muse Ember es el primer modelo entrenado usando Muse Wonder Full, extendiendo su estrategia de usar modelos más grandes para desarrollar modelos especializados.
Especificaciones de Muse Ember
Las especificaciones principales son:
| Especificación | Muse Ember |
|---|---|
| Desarrollador | Meta Superintelligence Labs |
| Fecha de anuncio | 9 de noviembre de 2026 |
| Categoría del modelo | Razonamiento multimodal y ejecución de agentes |
| Ventana de contexto | 1,048,576 tokens |
| Salida máxima | 524,288 tokens |
| Modalidades de entrada | Texto, imágenes, audio, video |
| Archivos de entrada | Compatible a través de Responses API |
| Modalidad de salida | Texto |
| Esfuerzo de razonamiento | Minimal, Low, Medium, High, XHigh, Max |
| Esfuerzo de razonamiento predeterminado | Max |
| Invocación de herramientas | Compatible |
| Salida estructurada | Compatible |
| Anclaje de búsqueda | Compatible a través de Model API |
Meta no ha publicado los pesos de Muse Ember ni ha revelado su conteo de parámetros. Los límites de solicitudes y tokens aplican por equipo, compartiendo todos los keys del equipo la asignación del modelo.
Contexto y entradas multimodales
Para flujos con PDF, Meta extrae texto de las primeras 100 páginas e imágenes de las primeras 50, por lo que divida archivos más largos antes de procesarlos. Envíe el material necesario para la tarea; los tokens de razonamiento comparten la asignación de 524,288 tokens de salida con la respuesta final.
Use capturas de pantalla cuando el diseño importe, escaneos para extracción de documentos, audio para análisis de reuniones y video para eventos que se desarrollan con el tiempo. Una transcripción es suficiente para un resumen solo de texto. Los archivos son compatibles mediante Responses API, y los resultados se devuelven como texto.
Esfuerzo de razonamiento configurable
Muse Ember ofrece seis niveles de razonamiento: Minimal, Low, Medium, High, XHigh y Max. Meta usa por defecto Max; ninguno está no soportado y devuelve HTTP 400. Inicie el enrutamiento y la clasificación rutinarios en un nivel más bajo y auméntelo solo cuando la mejora en respuestas aceptadas justifique la mayor latencia y el costo de tokens de salida.
Invocación de herramientas y salida estructurada
Muse Ember es compatible con invocación de herramientas y salida estructurada. Las llamadas a herramientas conectan decisiones del modelo con funciones de la aplicación, mientras que la salida estructurada facilita validar campos extraídos y pasarlos al siguiente paso.
Este resultado ilustrativo de ticket de soporte proporciona a una aplicación de enrutamiento una categoría, una prioridad y una marca de revisión:
{
  "category": "billing",
  "priority": "high",
  "requires_human_review": true
}
Meta Model API también admite anclaje de búsqueda y flujos de trabajo de uso de computadora. La aplicación conectada proporciona las herramientas, ejecuta acciones y controla permisos.
¿Cómo rinde Muse Ember en benchmarks?
Los resultados de lanzamiento de Meta usan el esfuerzo de razonamiento máximo. Agents’ Last Exam cubre el subconjunto de Linux en la evaluación interna de Meta, mientras que Terminal-Bench usa el mejor arnés publicado de cada modelo. Combinan resultados de Artificial Analysis reportados externamente con evaluaciones internas de Meta; el Personal Superintelligence Index es un compuesto interno de Meta, no un ranking independiente separado.
Resultados de benchmarks de Muse Ember
| Benchmark | Muse Ember | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| AutomationBench-AA | 37.8 | 13.9 | 20.2 |
| Agents' Last Exam | 61.6 | 57.0 | 57.1 |
| Personal Superintelligence Index | 46.8 | 36.1 | 37.0 |
| Terminal-Bench 4.0 | 40.9 | 39.2 | 16.4 |
| Coding Agent Index-AA | 46 | 37 | 31 |
| FrontierCode 2.0-AA | 27.2 | 34.9 | 25.2 |
| GDP.pdf-AA | 22.8 | 20.8 | 22.8 |
| OSWorld 2.1 (puntuación parcial) | 69.5 | 68.9 | 50.5 |
| OSWorld 2.1 (puntuación binaria) | 33.8 | 27.8 | 17.0 |
| PerceptionBench (con herramientas) | 80.6 | 78.6 | 62.8 |
| Artificial Analysis Intelligence Index | 36 | 36 | 28 |
Terminal-Bench 4.0 usa mini-swe-agent para Muse Ember, Claude Code para Haiku 5.5 y Codex para GPT-6 Luna. No son entornos de ejecución idénticos. OSWorld 2.1 reporta puntuaciones tanto de crédito parcial como binarias, mientras que PerceptionBench incluye herramientas. Los resultados del Artificial Analysis Intelligence Index provienen de la versión 5 publicada el 9 de noviembre de 2026.
Análisis de benchmarks de Muse Ember
El área más fuerte de Muse Ember es la ejecución de agentes.
En AutomationBench-AA, Muse Ember obtiene 37.8, comparado con 13.9 para Haiku 5.5 y 20.2 para GPT-6 Luna. Esto respalda la posición de Meta de Muse Ember como un modelo para flujos de trabajo empresariales de extremo a extremo y operaciones repetidas de agentes.
El rendimiento en codificación es competitivo, pero no universalmente superior.
Muse Ember obtiene 40.9 en Terminal-Bench 4.0 y 46 en Coding Agent Index-AA. Sin embargo, obtiene 27.2 en FrontierCode 2.0-AA, por debajo de 34.9 de Haiku 5.5. Esto sugiere que Muse Ember es un candidato útil para subtareas de codificación acotadas, mientras que trabajos de ingeniería más difíciles deberían probarse contra alternativas más fuertes.
Resultados multimodales y de uso de computadora prometedores.
Muse Ember obtiene 80.6 en PerceptionBench con herramientas y 69.5 en OSWorld 2.1 con puntuación de crédito parcial. Estos resultados respaldan su posicionamiento para flujos de trabajo que involucran comprensión visual e interacción con computadoras.
La inteligencia general es comparable a Haiku 5.5.
Muse Ember y Haiku 5.5 redondean a 36 en el Artificial Analysis Intelligence Index, por delante de GPT-6 Luna con 28. Para una decisión de selección, combine esa comparación amplia con los resultados específicos por tarea anteriores.
Inteligencia de Muse Ember vs. costo por tarea
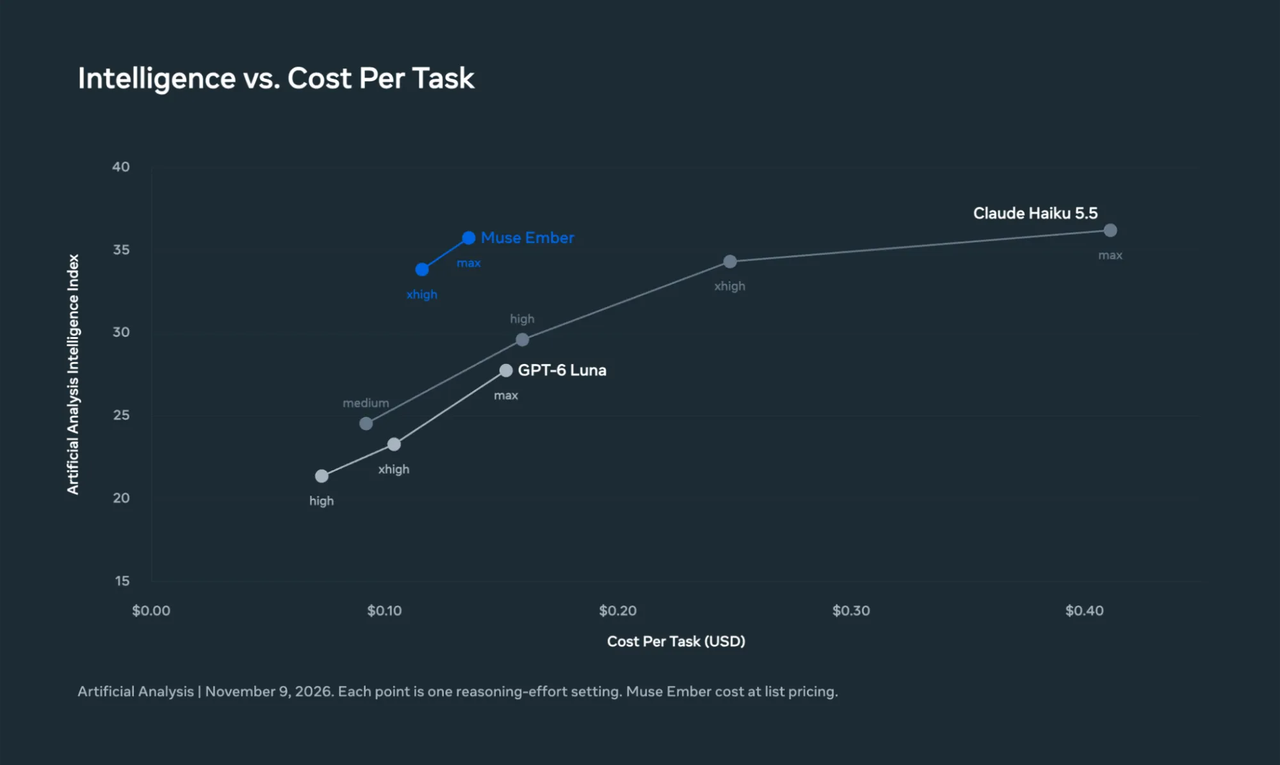
El gráfico de Meta compara puntuaciones del Artificial Analysis Intelligence Index con el costo estimado por tarea en diferentes configuraciones de esfuerzo de razonamiento.
Con esfuerzo de razonamiento máximo, Muse Ember obtiene 35.8 en el Artificial Analysis Intelligence Index con un costo estimado de $0.136 por tarea. Haiku 5.5 obtiene 36.2 a $0.411, mientras que GPT-6 Luna obtiene 27.8 a $0.152. En este benchmark, Ember se acerca a la puntuación de Haiku por aproximadamente un tercio del costo por tarea y supera la de Luna con un costo ligeramente menor.
Estas estimaciones usan consumo de tokens del benchmark y precios de lista. La siguiente evaluación muestra por qué la actividad de herramientas importa al elegir un modelo para un flujo de trabajo específico.
Resultados independientes de análisis de datos
La evaluación de análisis de datos de Plotly del 10 de noviembre de 2026 probó 43 preguntas en Plotly Studio Embedded contra un conjunto de datos sintético de energía eólica. Muse Ember se ejecutó mediante OpenRouter; los costos reportados usan los precios disponibles cuando cada modelo corrió. Son resultados específicos de la carga de trabajo, no una prueba de facturación nativa de la API de Meta.
| Métrica de evaluación | Muse Ember | GPT-6 Luna | Claude Haiku 5.5 |
|---|---|---|---|
| Preguntas superadas | 38/43 | 38/43 | 37/43 |
| Costo total de la prueba | $1.04 | $0.13 | $0.38 |
| Tiempo mediano por pregunta | 28 segundos | 18 segundos | 14 segundos |
Para esta carga de trabajo de análisis de datos, GPT-6 Luna entregó el mismo 38/43 superadas que Ember por una octava parte del costo total, con un tiempo de respuesta mediano menor. Haiku fue el más rápido con 14 segundos por pregunta, con 37/43 superadas. Luna es el candidato inicial más sólido para un flujo de trabajo de analítica similar y sensible a costos; la tarifa baja por token de Ember por sí sola no lo convierte en la opción más barata.
Plotly encontró que Muse Ember realizó un promedio de 78 consultas en preguntas que implicaban patrones ocultos, frente a una mediana de 25 entre los modelos probados. La actividad adicional de herramientas incrementó su consumo de tokens y el costo total.
La prueba también mostró fortalezas: Muse Ember respondió correctamente las 20 preguntas de analítica claramente definidas, las cinco preguntas ambiguas, las cinco solicitudes imposibles y las tres verificaciones de calidad de datos. Tuvo más dificultades con patrones ocultos en los datos.
Plotly ejecutó cada modelo una vez y observó variaciones de hasta tres preguntas al repetir otros modelos. Considere 38 versus 37 superadas como una diferencia pequeña; la diferencia más clara aquí es el uso de herramientas y el costo total.
Muse Ember vs Muse Wonder vs Muse Spark
Elija un modelo Muse según la responsabilidad que asumirá: planificación, el bucle principal del agente o la ejecución repetida.
| Dimensión | Muse Wonder | Muse Spark 1.3 | Muse Ember |
|---|---|---|---|
| Rol principal | Razonamiento de frontera e ingeniería compleja | Modelo principal de codificación y agentes | Ejecución de alto volumen |
| Fortaleza principal | Planificación, tareas de larga duración, codificación compleja | Codificación y flujos agentivos | Subtareas repetitivas y llamadas a herramientas |
| Carga de trabajo típica | Ingeniería a escala de repositorio | Ejecución principal del agente | Clasificación, enrutamiento, extracción |
| ID del modelo en API | muse-wonder-1.0 | muse-spark-1.3 | muse-ember-1.0 |
| Ventana de contexto | 1M tokens | 1M tokens | 1M tokens |
| Razonamiento predeterminado | Max | High | Max |
| Precio estándar de entrada / 1M | $4.00 | $1.25 | $0.10 |
| Precio estándar de salida / 1M | $20.00 | $4.25 | $0.50 |
La tabla usa los precios de tokens en modo Estándar de Meta. Los precios de Ember aquí aplican a solicitudes de hasta 200K tokens de entrada; Wonder y Spark no llevan la prima de contexto largo de Ember.
Selección de modelos Muse
Elija Wonder para planificación difícil, ingeniería a escala de repositorio y recuperación a lo largo de largas secuencias de pasos. Elija Spark para ejecutar la codificación principal o el bucle del agente. Elija Ember para subtareas repetidas con salidas verificables de forma independiente, como enrutamiento, extracción y cambios de archivos focalizados.
Por ejemplo, una migración de repositorio puede asignar el análisis de dependencias a un modelo más grande y un cambio de archivo estrechamente acotado a Ember. La transferencia debe nombrar los archivos, el comportamiento esperado y las comprobaciones de aceptación. Esa división es útil solo cuando coordinar y revisar las tareas más pequeñas cuesta menos que completar todo el trabajo con el modelo principal.
Para elegir entre ellos, ejecute las mismas tareas representativas en sus candidatos con las mismas comprobaciones de aceptación. Primero descarte configuraciones que no cumplan su tasa de éxito o objetivo de latencia. Entre las que pasen, compare el gasto total dividido por resultados aceptados, incluyendo reintentos y llamadas a herramientas. Asigne a Ember los tipos de tarea donde reduzca ese costo y reencamine los casos no resueltos a Spark o Wonder.
¿Cuánto cuesta Muse Ember?
La tabla empareja las tarifas oficiales de Meta con una estimación de descuento del 20% para CometAPI, en USD por millón de tokens. Cada celda muestra Meta / estimación con descuento. El listado de CometAPI aún no publica una tarifa en vivo; use las cifras con descuento para planificación presupuestaria.
| Uso por 1M tokens (Meta / estimación -20%) | Hasta 200K tokens de entrada | Más de 200K tokens de entrada |
|---|---|---|
| Entrada | $0.10 / $0.08 | $0.30 / $0.24 |
| Entrada en caché | $0.004 / $0.0032 | $0.012 / $0.0096 |
| Salida | $0.50 / $0.40 | $1.50 / $1.20 |
El total de tokens de entrada de la solicitud, incluyendo la entrada en caché, determina el tramo. Una solicitud por encima de 200K tokens de entrada usa las tarifas más altas para toda la solicitud, incluida su salida. Con previous_response_id de Meta, el historial de conversación almacenado cuenta para ese total de entrada.
Costos típicos de solicitudes con Muse Ember
Con entrada no almacenada en caché y 20K tokens de salida facturados, incluyendo razonamiento, una solicitud con 200K de entrada cuesta $0.0300 a tarifas de Meta, o $0.0240 en el escenario con 20% de descuento. Aumentar la entrada a 220K mueve la solicitud completa al tramo superior: los mismos 20K de salida llevan el total a $0.0960 a tarifas de Meta, o un estimado de $0.0768 con el descuento. Estos ejemplos excluyen cargos separados por herramientas. Mantener el contexto relevante dentro del tramo inferior puede ahorrar más que un descuento del 20% por sí solo.
| Escenario | Tokens de entrada | Tokens de salida facturados | Costo Meta | Costo CometAPI |
|---|---|---|---|---|
| Solicitud estándar | 200K | 20K | $0.0300 | $0.0240 |
| Solicitud de contexto largo | 220K | 20K | $0.0960 | $0.0768 |
Los tokens de razonamiento cuentan como salida facturada. Para la API nativa de Meta, el anclaje de búsqueda web cuesta $2.50 adicionales por 1,000 consultas, y Ember no tiene variante en Contributor-mode. La comparación de precios de tokens anterior no aplica el descuento del 20% a los cargos separados por herramientas.
¿Cómo acceder a Muse Ember?
Listado en CometAPI: la página del modelo identifica el modelo como muse-ember, pero su estado en el catálogo es Coming soon a 16 de noviembre de 2026. Siga esa página para activación y precios; para acceso ahora, use Meta Model API o Muse Code.
A través de Meta Model API: use muse-ember-1.0 con https://api.meta.ai/v1. La API nativa admite formatos de Responses, Chat Completions y Messages. Las entradas de archivo usan Responses. Mantenga juntos el endpoint y el identificador de modelo de cada proveedor al configurar su cliente.
Límites de la API nativa y otros accesos: Meta lista 3,000 solicitudes por minuto y 4,000,000 tokens por minuto por equipo, compartidos por los keys del equipo. Muse Ember también está disponible en Muse Code. Revise los límites de la ruta elegida al dimensionar un lote y use la guía de integración de Meta para la configuración de la API nativa.
¿Cuáles son las limitaciones de Muse Ember?
Tres factores determinan si Ember es una buena opción para su próximo flujo de trabajo:
- La ingeniería compleja sigue dependiendo de la carga de trabajo. Ember queda detrás de Haiku 5.5 en FrontierCode 2.0-AA a pesar de su mejor resultado en Terminal-Bench. Una victoria estrecha en codificación no establece idoneidad para cada cambio a escala de repositorio.
- Contexto largo y precios bajos por token no garantizan un costo por tarea bajo. Las solicitudes grandes pasan a un tramo de precio superior, y el uso repetido de herramientas puede consumir suficientes tokens como para contrarrestar la tarifa baja por token.
- El soporte de herramientas aún requiere una aplicación. El sistema circundante ejecuta llamadas, controla permisos y valida resultados. La capacidad del modelo para solicitar una acción no proporciona por sí sola un flujo de trabajo confiable.
Conclusión
Adopte Ember donde los criterios de aceptación sean lo suficientemente claros como para medirse. Un primer despliegue útil es un paso de alto volumen que ya tiene un resultado conocido, como enrutar tickets etiquetados o extraer campos de documentos revisados. Compare el costo por tarea exitosa, las tasas de error y la latencia frente a su modelo actual antes de ampliar su rol. Esa evidencia le dirá si Ember reduce el costo de su flujo de trabajo mientras preserva la calidad necesaria.
Preguntas frecuentes
¿Cómo debe validar los resultados de extracción de Muse Ember?
Cree un conjunto de referencia de documentos con respuestas verificadas por humanos, incluyendo campos faltantes, escaneos ilegibles y valores conflictivos. Mida la precisión por campo en lugar de tratar cada respuesta JSON válida como un éxito. Verifique si cada valor extraído está respaldado por el pasaje de origen citado y envíe las discrepancias a revisión. Esto separa la confiabilidad de formato de la confiabilidad factual.
¿Cuándo debe un subencargo de Muse Ember volver al agente principal?
Defina condiciones de escalado antes de la ejecución: un archivo requerido está fuera del alcance asignado, las fuentes discrepan, una comprobación de aceptación falla repetidamente o la tarea requiere una decisión que el trabajador no estaba autorizado a tomar. Devuelva la evidencia, los pasos intentados y la cuestión no resuelta al agente principal. Una transferencia clara es más útil que permitir que el trabajador amplíe su encargo indefinidamente.
¿Qué debe registrar al probar Muse Ember en producción?
Registre el proveedor e identificador de modelo exactos, la configuración de razonamiento, tokens de entrada y de salida facturados, tokens en caché, número de llamadas a herramientas, reintentos, latencia y resultado final de aceptación. Mantenga el resultado de validación junto al registro de uso para poder calcular el costo por tarea aceptada. Compare tipos de tarea similares por separado; un promedio entre enrutamiento, codificación y trabajo con documentos largos puede ocultar dónde el modelo ayuda o añade costo.
¿Cómo puede prevenir acciones duplicadas en un flujo de trabajo con Muse Ember?
Haga que la aplicación sea responsable de la identidad de la acción y del estado de finalización. Para una operación como crear un ticket, asigne una clave de operación estable, verifique si ya se ha completado y use el soporte de idempotencia de la API de destino cuando esté disponible. Tras un tiempo de espera, inspeccione el estado de la acción antes de reintentar. Este diseño evita tratar una respuesta incierta como prueba de que la acción original nunca ocurrió.