Construye con CometAPI¿Necesitas una sola API para varios modelos?Prueba el flujo en el Playground y luego crea una clave de API cuando el modelo y el costo encajen con tu caso de uso.
¿Qué es Step 5 Preview? Especificaciones, benchmarks, precios y pesos abiertos
Explora StepFun Step 5 Preview, su arquitectura MoE de 600B, contexto de 1M tokens, benchmarks de programación, precios, pesos abiertos y acceso a la API.
Deon GoodwinEquipo de investigación de modelos de IA y API
Step 5 Preview es el modelo de IA insignia de StepFun para ingeniería de software, investigación financiera y flujos de trabajo complejos de agentes. Combina un rendimiento competitivo en tareas con inferencia rentable, aunque sus resultados varían entre benchmarks. Los desarrolladores pueden acceder a él a través de una API alojada o implementar sus pesos abiertos, según su presupuesto, infraestructura y requisitos de rendimiento.
Key Takeaways
Architecture: Step 5 Preview usa una arquitectura MoE dispersa con 600B de parámetros totales y 27B activos por token, equilibrando la capacidad del modelo y la eficiencia de inferencia.
Context and multimodal support: El modelo admite una ventana de contexto de 1M tokens, entradas de texto, imagen y video, y hasta 64K tokens de salida a través de su API alojada.
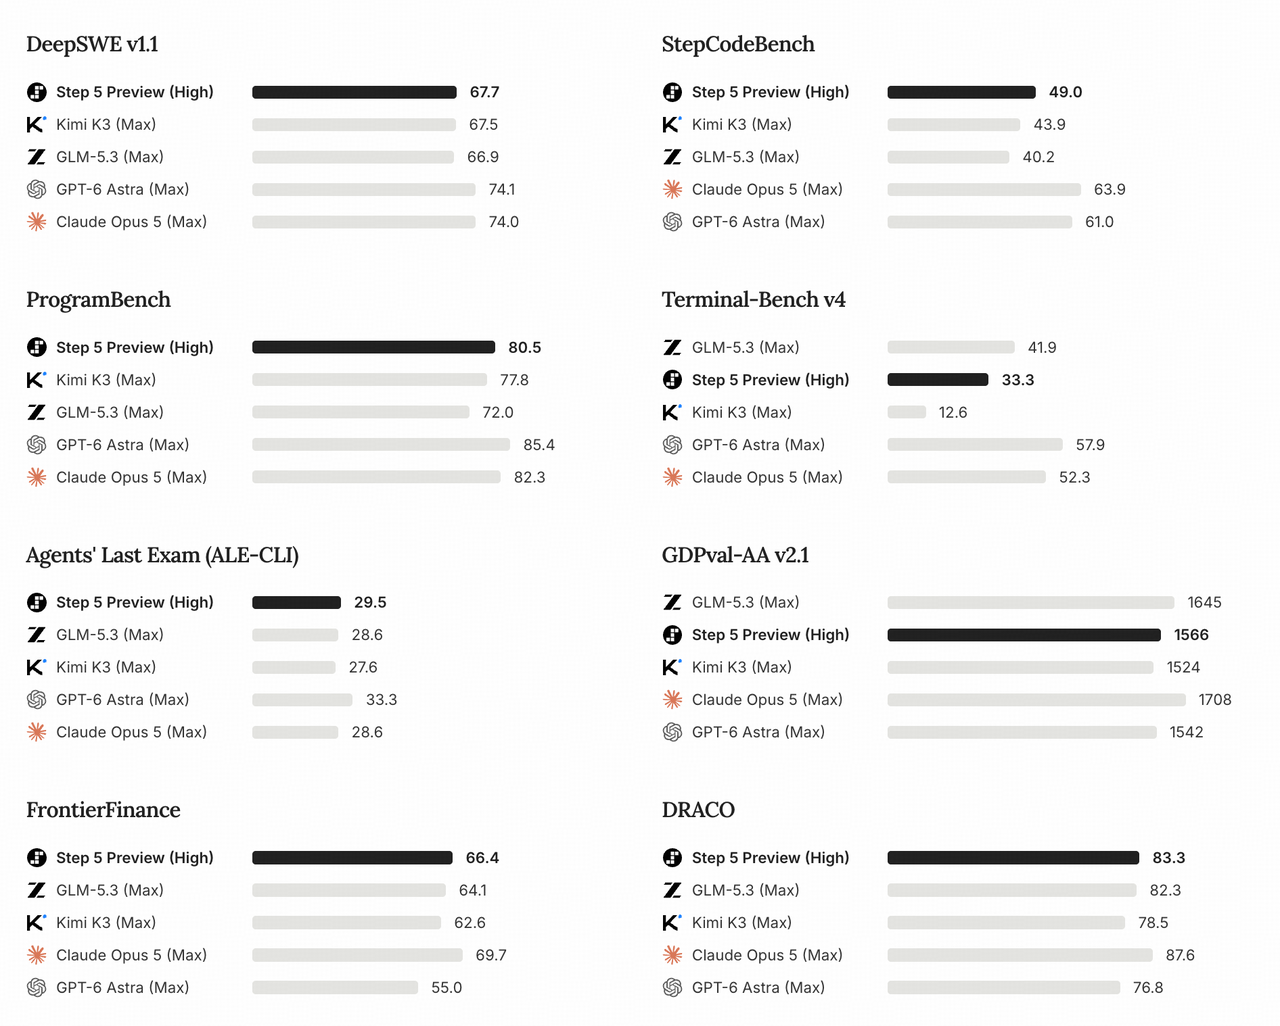
Step 5 Preview alcanza 67.7% en DeepSWE v1.1 y 66.4% en FrontierFinance, aunque queda por detrás de varios competidores en Terminal-Bench v4.
Revisado para mayor claridad, atribución de fuentes y terminología API actual.
Benchmark performance:
API pricing: StepFun cobra $1.00 por entrada no almacenada en caché, $0.10 por entrada almacenada en caché y $2.70 por salida por millón de tokens.
Deployment flexibility: Los desarrolladores pueden acceder a Step 5 Preview mediante la API alojada de StepFun o autohospedar sus pesos liberados usando marcos compatibles como vLLM, SGLang y Transformers.
What Is Step 5 Preview?
Step 5 Preview es un gran modelo multimodal de razonamiento desarrollado por StepFun (阶跃星辰). Está orientado a cargas de trabajo que requieren razonamiento extendido, ejecución repetida de herramientas y análisis sobre grandes colecciones de información. StepFun ofrece acceso mediante una API alojada y publica pesos descargables del modelo.
A diferencia de los asistentes de propósito general optimizados principalmente para respuestas conversacionales, Step 5 Preview enfatiza la ejecución agéntica: la capacidad de planificar, usar herramientas, inspeccionar resultados intermedios, corregir errores y continuar hacia un objetivo complejo.
Key Specifications
La ficha oficial del modelo documenta su arquitectura dispersa, recuentos de parámetros y configuraciones de despliegue. Las especificaciones de la API alojada definen por separado entradas admitidas, límites de generación y características de servicio. Son capas diferentes del contrato de despliegue.
Specification (model card and API documentation linked above)
Step 5 Preview
Developer
StepFun
Model identifier
step-5-preview
Model category
Multimodal reasoning and agentic LLM
Architecture
Sparse Mixture-of-Experts
Total parameters
Approximately 600B
Active parameters per token
Approximately 27B
Active parameter proportion
Approximately 4.5%
Context window
Up to 1M tokens
Supported inputs
Text, images, and video on the hosted API
Hosted API maximum output
64k tokens
Primary output
Text
Reasoning modes
low, medium, high; reasoning_effort on Chat Completions
Tool calling
Supported
Structured output
JSON Mode and JSON Schema on the hosted API
Prompt caching
Supported
Hosted API status
Available as of October 19, 2026
Weight availability
La API alojada documenta un máximo de salida de 64k tokens, mientras que la ficha del modelo lista una capacidad de generación de secuencia de hasta 1M tokens. Esto último no es una promesa de que el endpoint alojado acepte una completion de 1M tokens. En ejemplos autohospedados con vLLM, el presupuesto de secuencia configurado de 1M tokens cubre entrada y salida juntas; la memoria disponible para KV cache y la concurrencia pueden reducir la capacidad utilizable.
How the 600B/27B MoE Architecture Works
Un transformer denso convencional activa la mayoría de sus parámetros del modelo durante la inferencia. Step 5 Preview, en cambio, usa enrutamiento disperso para seleccionar expertos relevantes. Con aproximadamente 27B parámetros activos de 600B, alrededor de 4.5% del recuento total de parámetros participa en el cómputo típico de un token.
Esta distinción ayuda a explicar la estrategia de eficiencia de costos del modelo. Sin embargo, 27B activos no significa una huella de despliegue de 27B. Los pesos completos de los expertos aún deben almacenarse y accederse, por lo que la capacidad de memoria GPU, el paralelismo de expertos y el ancho de banda de interconexión son consideraciones esenciales.
Supported Inputs and Output Limits
La API alojada acepta texto, imágenes y video, con una ventana de contexto de hasta 1M tokens y un máximo de salida de 64k tokens. Estas entradas admiten tareas como análisis de repositorios, investigación de documentos financieros e interpretación visual. Para autohospedaje, la longitud de secuencia utilizable depende de la configuración en tiempo de ejecución, la memoria disponible y la concurrencia.
El soporte multimodal y las capacidades de la API pueden diferir entre configuraciones alojadas y autodesplegadas.
How Does Step 5 Preview Perform on Benchmarks?
Los siguientes son resultados reportados por StepFun. Step 5 Preview usa la configuración High de razonamiento; los modelos de comparación usan Max. Igualar etiquetas no establece cómputo equivalente, y estas puntuaciones publicadas no miden la latencia de aplicación ni el costo por tarea exitosa.
El gráfico oficial original resume los resultados de evaluación del editor. Las tablas a continuación extraen las puntuaciones de codificación, razonamiento y finanzas relevantes para este análisis.
Coding and Agentic Performance
Benchmark
Step 5 Preview (High)
Kimi K3 (Max)
GLM-5.3 (Max)
GPT-6 Astra (Max)
Claude Opus 5 (Max)
DeepSWE v1.1
67.7
67.5
66.9
74.1
74.0
StepCodeBench
49.0
43.9
40.2
61.0
63.9
ProgramBench
80.5
77.8
72.0
85.4
82.3
Terminal-Bench v4
33.3
12.6
41.9
57.9
52.3
Agents’ Last Exam (ALE-CLI)
29.5
27.6
28.6
33.3
28.6
Las puntuaciones son porcentajes; valores más altos indican mejor desempeño en cada benchmark. DeepSWE v1.1 usa el arnés SWE-agent con temperature=1.0 y top_p=0.95; StepCodeBench reporta avg@4, mientras que ProgramBench reporta pass rate. Cada benchmark mide una tarea diferente bajo su propio entorno de evaluación, por lo que los porcentajes no son medidas de exactitud intercambiables. La comparación publicada no establece hardware ni presupuestos de ejecución idénticos entre modelos.
En DeepSWE v1.1, Step 5 Preview obtiene 67.7%, superando por poco a Kimi K3 y GLM-5.3. Esto sugiere un rendimiento competitivo para agentes de codificación que trabajan con repositorios y tareas automatizadas de ingeniería de software.
ProgramBench proporciona otra señal positiva. Step 5 Preview alcanza 80.5%, frente a 77.8% de Kimi K3 y 72.0% de GLM-5.3.
Sin embargo, Terminal-Bench v4 expone una limitación significativa: el resultado de 33.3% de Step 5 Preview queda por detrás de GLM-5.3 con 41.9%, mientras que GPT-6 Astra llega a 57.9%. La implicación es que Step 5 Preview es competitivo en ingeniería de software orientada a repositorios, pero su ventaja relativa no se extiende de forma uniforme a la ejecución orientada a terminal y depuración compleja.
Reasoning and Knowledge Performance
Benchmark
Step 5 Preview (High)
GLM-5.3 (Max)
Kimi K3 (Max)
GPT-6 Astra (Max)
GPQA Diamond
93.5%
91.7%
93.5%
96.1%
Humanity’s Last Exam
46.5%
42.3%
46.9%
54.7%
AA-LCR v1.1
88.3%
79.7%
88.7%
80.7%
CritPt
20.9%
19.1%
23.4%
31.7%
Step 5 Preview obtiene 93.5% en GPQA Diamond, igualando a Kimi K3 y por detrás de GPT-6 Astra con 96.1%. En AA-LCR v1.1, su resultado de 88.3% está ligeramente por debajo del 88.7% de Kimi K3 y por encima del 80.7% de GPT-6 Astra. También queda por detrás de Kimi K3 y GPT-6 Astra en Humanity’s Last Exam y CritPt. Los resultados apuntan a conocimiento competitivo y razonamiento de largo contexto, con fortalezas relativas que varían según la tarea.
Financial Research and Valuation Performance
La investigación financiera es una de las áreas de aplicación más distintivas de Step 5 Preview. El modelo está diseñado para combinar razonamiento cuantitativo, recuperación de evidencia y análisis estructurado. Estas capacidades son especialmente relevantes para valoración, interpretación de documentos financieros e investigación de inversión.
StepFun introdujo FinStepBench para evaluar investigación financiera en múltiples etapas, desde reunir información hasta producir conclusiones defendibles.
Benchmark
Step 5 Preview (High)
Kimi K3 (Max)
GLM-5.3 (Max)
GPT-6 Astra (Max)
Claude Opus 5 (Max)
FrontierFinance
66.4
62.6
64.1
55.0
69.7
FinStepBench LiveSearch
74.5
70.9
73.3
74.5
76.2
FinStepBench CorporateValuation
60.6
60.6
56.1
77.3
69.7
FinStepBench DeepResearch
55.8
48.9
53.3
45.0
59.1
Puntuaciones más altas indican un mejor rendimiento en el benchmark. FinStepBench fue desarrollado por StepFun, por lo que la validación independiente es particularmente importante.
Step 5 Preview alcanza 66.4% en FrontierFinance, superando a Kimi K3, GLM-5.3 y GPT-6 Astra bajo las configuraciones reportadas. Sin embargo, Claude Opus 5 se mantiene por delante con 69.7%.
El resultado en FinStepBench DeepResearch es especialmente notable. Step 5 Preview llega a 55.8%, frente a 48.9% de Kimi K3 y 53.3% de GLM-5.3. Esto sugiere que el modelo puede adaptarse bien a flujos de trabajo de investigación financiera que requieren recuperación, síntesis y análisis extendido.
Su puntuación en CorporateValuation cuenta una historia más matizada. Con 60.6%, Step 5 Preview queda por detrás de 77.3% de GPT-6 Astra por un margen considerable. Por lo tanto, Step 5 Preview no debe considerarse universalmente superior para análisis financiero. Su clasificación relativa es más fuerte en DeepResearch que en CorporateValuation, respaldando la evaluación específica por tarea en lugar de una afirmación general de superioridad financiera.
Para aplicaciones en producción, las salidas financieras aún requieren cálculos validados de forma independiente, supuestos documentados y evidencia de soporte rastreable.
Step 5 Preview vs Other AI Models
Step 5 Preview compite con alternativas alojadas y servicios propietarios de frontera. Los resultados de benchmarks ayudan a identificar modelos candidatos; el acceso a la API, el soporte de entradas, el control de despliegue y el costo real de la carga determinan qué candidato encaja en una aplicación de producción.
CometAPI ofrece acceso a Kimi K3, GLM-5.3, GPT-6 Astra y Claude Opus 5. Estas alternativas proporcionan puntos de comparación útiles para calidad de carga, latencia y costo.
Step 5 Preview ofrece un checkpoint MoE documentado de 600B/27B y una opción de autohospedaje. Para las alternativas, la disponibilidad de pesos, recuentos de parámetros, límites de contexto y entradas aceptadas dependen del modelo y del endpoint. Los benchmarks publicados pueden ayudar a crear una lista corta; tareas representativas de codificación e investigación revelan cómo se comporta cada servicio en la práctica.
Step 5 Preview vs Kimi K3
Step 5 Preview rinde ligeramente mejor en DeepSWE v1.1, ProgramBench y FrontierFinance. Kimi K3 sigue siendo competitivo en razonamiento y ciertas otras evaluaciones técnicas. La diferencia práctica se centra menos en una ventaja decisiva de inteligencia y más en el costo, las condiciones de servicio y la fiabilidad específica por tarea disponibles para los desarrolladores.
Step 5 Preview vs GLM-5.3
Step 5 Preview supera a GLM-5.3 en varias evaluaciones de finanzas y desarrollo de software. Sin embargo, la puntuación más fuerte de GLM-5.3 en Terminal-Bench v4 sugiere una ventaja en las tareas orientadas al terminal reportadas. Para agentes de codificación, compare modificaciones de repositorio exitosas, errores de llamadas a herramientas, tiempo de ejecución y corrección de parches en lugar de confiar en una puntuación agregada.
Step 5 Preview vs GPT-6 Astra and Claude Opus 5
Los modelos propietarios de frontera generalmente rinden mejor en los benchmarks más difíciles de ingeniería de software. La principal atracción de Step 5 Preview es que se acerca a capacidades competitivas en cargas seleccionadas mientras ofrece una opción de despliegue con pesos abiertos y precios de API relativamente accesibles.
Elija un modelo premium cuando el costo del fracaso sea alto y la precisión incremental de la tarea justifique un gasto adicional. Considere Step 5 Preview cuando el precio, el control del despliegue y la ejecución repetida por agentes tengan mayor peso.
How Much Does Step 5 Preview API Cost?
El valor de Step 5 Preview depende tanto de la capacidad de la tarea como del costo operativo. Los flujos de trabajo de agentes pueden implicar docenas de llamadas, recuperación repetida de documentos y reintentos, por lo que un precio por token más bajo solo ayuda cuando el modelo completa la tarea de manera fiable. El costo por tarea completada con éxito es un complemento útil a las tarifas siguientes.
API Availability and Token Pricing
Esta instantánea del 19 de octubre de 2026 compara las tarifas nativas de la API de StepFun con las tarifas de CometAPI enlazadas en la sección de comparación de modelos. Todos los precios son en dólares estadounidenses por millón de tokens. Los servicios tienen diferentes condiciones de facturación, caché y endpoint; “not listed” significa que la fuente de esta instantánea no proporciona una tarifa para entrada en caché.
Model
Service channel
Model ID
Uncached input / 1M tokens
Cached input / 1M tokens
Output / 1M tokens
Step 5 Preview
StepFun native API
step-5-preview
$1.00
$0.10
$2.70
Kimi K3
CometAPI
kimi-k3
$2.40
Not listed
$12.00
GLM-5.3
CometAPI
glm-5.3
$1.12
Not listed
$3.53
GPT-6 Astra
CometAPI
gpt-6-astra
$8.00 (short-context tier)
Not listed
$40.00 (short-context tier)
Claude Opus 5
CometAPI
claude-opus-5
$4.00
Not listed
$20.00
El nivel de contexto corto de GPT-6 Astra aplica hasta 272,000 tokens; las tarifas de contexto largo citadas son $16 para entrada y $60 para salida por millón de tokens. Las tarifas listadas excluyen herramientas, reintentos e infraestructura. La disponibilidad de Step 5 Preview a través de CometAPI no queda establecida por esta comparación; el ejemplo de Step 5 Preview a continuación usa el endpoint nativo de StepFun.
La tarifa de entrada con acierto de caché es 90% inferior a la tarifa de entrada sin caché. El precio de la entrada sin caché incluye escribir nuevo contenido en la caché, mientras que la facturación de salida incluye tanto tokens de razonamiento como de respuesta final. El texto de prompt repetido solo obtiene la tarifa inferior cuando el servicio informa un acierto de caché calificable; la longitud visible de la respuesta subestima la salida facturable.
Example Cost Calculations
API workload
Uncached input
Cached input
Output
Estimated cost
Short analytical request
10K
0
5K
$0.0235
Medium coding workflow
100K
0
20K
$0.154
Repeated agent request
10K
90K
20K
$0.073
Large document analysis
500K
0
30K
$0.581
Long-context cached workflow
100K
400K
50K
$0.275
Fórmula de coste: C = (Tu × Pu + Tc × Pc + To × Po) / 1,000,000, donde Tu/Tc/To representan entrada no almacenada, entrada almacenada y salida facturable en tokens, respectivamente, y Pu/Pc/Po son sus precios por millón de tokens.
Considere dos solicitudes a StepFun con los mismos 100,000 tokens de entrada y 20,000 tokens de salida facturable:
Cache miss: los 100,000 tokens de entrada no están en caché. Coste = (100,000 × $1.00 + 20,000 × $2.70) / 1,000,000 = $0.154.
Cache hit: 90,000 tokens de entrada califican para la tarifa de caché y 10,000 permanecen sin caché. Coste = (10,000 × $1.00 + 90,000 × $0.10 + 20,000 × $2.70) / 1,000,000 = $0.073.
El ejemplo con acierto de caché ahorra $0.081, o alrededor de 52.6%, con los mismos volúmenes de entrada y salida. El ahorro depende de un acierto de caché calificable informado por el servicio. Ambos ejemplos excluyen herramientas externas, reintentos y costos de infraestructura.
Los precios por token por sí solos no determinan el modelo de mejor valor. Un agente que requiere varios reintentos puede ser más caro que un modelo con precio más alto que tiene éxito en el primer intento. Para una comparación de costos fiable, use el costo por tarea completada con éxito junto con el precio por token.
Is Step 5 Preview Open Source, and Can It Run Locally?
StepFun publica pesos descargables a través de sus repositorios oficiales en Hugging Face, con variantes FP8, BF16 y NVFP4 disponibles al 19 de octubre de 2026. El acceso a los pesos permite el autodespliegue, pero no convierte al modelo en equivalente a un pequeño modelo denso en cuanto a requisitos de memoria.
Los archivos disponibles incluyen el checkpoint de Step 5 Preview, versión BF16 y versión NVFP4.
La terminología importa: Step 5 Preview proporciona pesos abiertos bajo la StepFun Model License 1.0. La licencia incluye atribución específica del modelo y condiciones de licencia comercial. Evalúe esos términos para su uso y distribución previstos antes del despliegue.
FP8 con vLLM: 4 × NVIDIA B300 o 8 × NVIDIA H200, sirviendo una API compatible con OpenAI.
BF16 con vLLM: 8 × NVIDIA B300 o 16 × NVIDIA H200, sirviendo una API compatible con OpenAI.
FP8 con SGLang: 4 × NVIDIA B300, sirviendo una API compatible con OpenAI; FP8 con Transformers: 8 × NVIDIA H200 para generación offline.
Estas son configuraciones de referencia, no garantías mínimas para cada checkpoint, runtime, longitud de contexto o configuración de concurrencia. La activación dispersa reduce el cómputo, pero el almacenamiento de pesos de expertos y la memoria de KV cache siguen siendo consideraciones importantes.
Un modelo de 600B también presenta retos más allá de la capacidad de memoria, incluyendo comunicación multi-GPU, compatibilidad de marcos, carga de checkpoints y rendimiento de largo contexto. Para equipos sin grandes clústeres de GPU, una API alojada suele ser el punto de partida más práctico.
How Can Developers Use the Step 5 Preview API?
StepFun admite una interfaz de Chat Completions compatible con OpenAI. Establezca STEPFUN_API_KEY en el entorno antes de ejecutar el siguiente ejemplo en Python; max_tokens limita la salida generada de esta solicitud. Use la clave de API y los términos de facturación para la plataforma regional seleccionada: este ejemplo mantiene el endpoint api.stepfun.ai, mientras que los precios en dólares anteriores provienen de la plataforma internacional de StepFun.
Ejemplo en Python: envía una solicitud de texto acotada a la API de StepFun e imprime la respuesta devuelta.
import os
from openai import OpenAI
client = OpenAI(
    api_key=os.environ["STEPFUN_API_KEY"],
    base_url="https://api.stepfun.ai/v1",
)
response = client.chat.completions.create(
    model="step-5-preview",
    messages=[{
        "role": "user",
        "content": (
            "Analyze the architectural risks of migrating "
            "a monolithic application into microservices."
        ),
    }],
    max_tokens=4000,
)
print(response.choices[0].message.content)
Antes de usar en producción, confirme los parámetros aceptados y los límites de generación del endpoint de StepFun seleccionado. El esfuerzo de razonamiento, el almacenamiento en caché del prompt, los esquemas de herramientas y los presupuestos de salida pueden afectar la fiabilidad, la latencia y la factura final.
Step 5 Preview in Agent Workflows
Leer la documentación del repositorio y los archivos relevantes.
Identificar el cambio solicitado y proponer un plan.
Modificar el código seleccionado y ejecutar pruebas mediante herramientas externas.
Inspeccionar fallos y revisar la implementación.
Producir una explicación final de los cambios validados.
El modelo genera razonamiento y solicitudes de herramientas; la aplicación proporciona el acceso real a archivos, entornos de ejecución, permisos y comprobaciones de seguridad. La capacidad del modelo por sí sola no garantiza ejecución autónoma.
Alternative Model APIs in CometAPI
CometAPI ofrece acceso a los modelos alternativos enlazados arriba a través de un servicio de integración compartido. Seleccione el endpoint y formato de solicitud documentados de cada modelo, luego compare tasas de éxito, uso de tokens, reintentos y latencia de extremo a extremo en la misma carga de trabajo.
El ejemplo anterior usa el endpoint nativo de StepFun. Cambiar a una pasarela requiere confirmar la disponibilidad de Step 5 Preview y el identificador de modelo, endpoint y términos de facturación documentados de la pasarela.
When Should You Choose Step 5 Preview?
Elíjalo para codificación en repositorios e investigación con documentos voluminosos cuando pruebas representativas confirmen resultados fiables. Su contexto largo y las puntuaciones publicadas en codificación y finanzas lo convierten en candidato, mientras que los resultados en Terminal-Bench v4 y CorporateValuation muestran por qué las pruebas específicas por carga de trabajo importan.
Elija la API alojada cuando quiera empezar sin operar un gran clúster de GPU. Compare el costo por tarea aceptada, tasas de acierto de caché, reintentos y latencia; una ventana de contexto grande no garantiza respuestas rápidas ni menor costo total.
Elija el autohospedaje cuando el control del despliegue justifique la carga de hardware y operaciones. Presupueste el almacenamiento completo de pesos de expertos, KV cache, comunicación multi-GPU y requisitos de licencia. Para trabajo financiero o de ingeniería de consecuencias, incluya comprobaciones de origen, detección de errores y revisión humana.
FAQ
How should you choose Step 5 Preview’s reasoning effort?
Comience con un pequeño conjunto de tareas representativas y compare low, medium y high usando los mismos criterios de aceptación. Registre corrección, salida facturable, latencia y fallos de herramientas. Use la configuración más baja que cumpla consistentemente el umbral de calidad; las puntuaciones publicadas en High no predicen el comportamiento de low o medium. Siga la guía de configuración de razonamiento y establezca reasoning_effort explícitamente en Chat Completions al comparar configuraciones.
Why can a Step 5 Preview request stop before 64k output tokens?
El máximo documentado es un techo, no una longitud objetivo. Una solicitud puede detenerse antes porque alcanzó su presupuesto de max_tokens, devolvió una detención natural o produjo una llamada a herramienta que la aplicación debe manejar. Inspeccione el finish reason devuelto y cualquier solicitud de herramienta antes de reintentar automáticamente. Una respuesta más corta completada no indica un fallo de la ventana de contexto.
How should you test Step 5 Preview video inputs?
Comience con un clip corto y representativo y una pregunta cuya respuesta pueda verificar. La especificación de entrada de video de la API alojada acepta video por URL, Base64 o una referencia stepfile; sus formatos documentados incluyen MP4, QuickTime y Matroska. Para entrada por URL, la documentación especifica archivos MP4 individuales de menos de 128 MB y recomienda menos de cinco minutos. Confirme los límites de formato y tamaño antes de procesar por lotes, y pruebe preguntas temporales así como reconocimiento de frames individuales.
Which metrics reveal Step 5 Preview’s real agent cost?
Mida tareas aceptadas, total de tokens de entrada y salida en todos los turnos, aciertos de caché, reintentos, cargos de herramientas externas y tiempo transcurrido. Divida el costo total de ejecución por las completaciones exitosas, manteniendo fijo el criterio de éxito entre modelos. Esto captura el efecto económico de una llamada más barata que requiere más intentos, o una ejecución de mayor esfuerzo que reduce fallos posteriores.
Conclusion
Step 5 Preview vale la pena evaluarlo cuando una aplicación necesita procesamiento de largo contexto, uso repetido de herramientas o control sobre el despliegue del modelo. Los resultados publicados por StepFun lo convierten en candidato para codificación en repositorios e investigación financiera, mientras que Terminal-Bench v4 y CorporateValuation muestran áreas donde las alternativas listadas puntúan más alto. Compare modelos usando criterios de aceptación fijos, costo total por tarea aceptada y latencia de extremo a extremo. Para autohospedaje, incluya costos de infraestructura y requisitos de licencia en la decisión.
Official FP8, BF16, and NVFP4 repositories available