TL;DR
MiMo-V2.6 es la nueva familia de modelos de razonamiento nativos multimodales y orientados a agentes de pesos abiertos de Xiaomi. MiMo-V2.6-Pro usa un diseño MoE disperso con 1.02 billones de parámetros totales y alrededor de 42 mil millones de parámetros activados por token, mientras que MiMo-V2.6-Flash usa 309 mil millones de parámetros totales y alrededor de 15 mil millones activados. Ambos soportan una ventana de contexto de 1M de tokens y entradas multimodales que incluyen texto, imágenes, video y audio.
Key Takeaways
- MiMo-V2.6-Pro es un modelo MoE disperso de 1.02T parámetros con unos 42B parámetros activados por token; Flash usa 309B totales y unos 15B parámetros activos.
- Ambos modelos soportan una ventana de contexto de 1M de tokens, entrada multimodal y hasta 128K tokens de salida a través de la API de Xiaomi.
- La familia está diseñada para razonamiento, uso de herramientas, búsqueda web, salida estructurada y flujos de trabajo de agentes de largo horizonte.
- Xiaomi entrenó V2.6 con aprendizaje por refuerzo mixto en codificación, agentes generales, tareas visuales y entornos de ciberseguridad.
- Los resultados oficiales posicionan a Pro como la opción de mayor capacidad y a Flash como la opción de menor costo y alto volumen; sigue siendo necesaria la evaluación específica por carga de trabajo.
What Is Xiaomi MiMo-V2.6?
MiMo-V2.6 es la última generación de la familia de modelos MiMo de Xiaomi. Su énfasis no es solo generar mejores respuestas, sino ejecutar secuencias largas de acciones: inspeccionar un entorno, llamar herramientas, observar resultados, corregir errores y continuar hasta completar un objetivo. Xiaomi enmarca el lanzamiento alrededor de la Auto-mejora recursiva (RSI), lo que significa un bucle de entrenamiento de RL en el que el modelo explora repetidamente entornos, recibe señales de recompensa más ricas, compara trayectorias y aprende estrategias más efectivas. No debe interpretarse como que el modelo reescribe y entrena autónomamente a su propio sucesor.
Pro vs Flash vs UltraSpeed: What is the differnence
| Feature | MiMo-V2.6-Pro | MiMo-V2.6-Flash | MiMo-V2.6-Pro-UltraSpeed |
|---|---|---|---|
| Positioning | Buque insignia en razonamiento | Alto volumen / valor | Buque insignia de baja latencia |
| Total parameters | 1.02T | 309B | Mismo modelo Pro |
| Active parameters | 42B | 15B | Misma capacidad Pro |
| Architecture | MoE dispersa | MoE dispersa | Modo de servicio Pro |
| Context | 1M | 1M | 1M |
| Max output | 128K | 128K | 128K |
| Text / image / video / audio input | Sí | Sí | Sí |
| Deep reasoning / tool calling | Sí | Sí | Sí |
| Structured output / context caching | Sí | Sí | Sí |
| Main advantage | Capacidad máxima | Eficiencia de costos | Hasta 20× más rápido al servir |
MiMo-V2.6-Pro or Flash: Which One Should You Use?
Elección práctica: elige MiMo-V2.6-Pro para ingeniería de largo horizonte difícil, investigación, ciberseguridad y trabajo agéntico de alto valor; elige MiMo-V2.6-Flash para automatización de alto volumen, procesamiento de documentos y multimodal, y llamadas repetidas sensibles al costo; elige MiMo-V2.6-Pro-UltraSpeed cuando se requiera razonamiento de nivel Pro pero la latencia domine. UltraSpeed es una capa de servicio más que un modelo de capacidad diferente y se anuncia con hasta 20× la velocidad de salida del Pro estándar.
How Does Xiaomi MiMo-V2.6 Work?
Sparse Mixture-of-Experts architecture
MiMo-V2.6 no activa todo su conjunto de parámetros en cada token. El checkpoint insignia Pro contiene 1.02 billones de parámetros totales, pero solo alrededor de 42 mil millones están activos por token. La ficha del modelo de Xiaomi describe 70 capas Transformer, 384 expertos enrutados y ocho expertos activados a la vez. Flash es sustancialmente más pequeño con 309B totales / 15B activos, 48 capas Transformer y 256 expertos enrutados.
| Architecture specification | MiMo-V2.6-Pro | MiMo-V2.6-Flash |
|---|---|---|
| Total parameters | 1.02T | 309B |
| Activated parameters | 42B | 15B |
| Transformer layers | 70 | 48 |
| Hidden size | 6,144 | 4,096 |
| Routed experts | 384 | 256 |
| Experts activated | 8 | 8 |
| Maximum context | 1M | 1M |
| MiMo ViT | 681M parámetros | 681M parámetros |
| AudioTokenizer | 308M parámetros | 308M parámetros |
| Audio patch encoder | 127M parámetros | 127M parámetros |
| Speculative decoder | 5 capas | 5 capas |
La arquitectura combina atención de ventana deslizante con capas de atención global e incluye un decodificador especulativo de predicción multi‑token de cinco capas. La implicación práctica es que la cifra titular de parámetros y el cómputo por token son cantidades muy diferentes: el enrutamiento disperso permite a Xiaomi mantener una gran reserva de expertos sin realizar inferencia densa a través de todos los pesos para cada token.
Native multimodal understanding
MiMo-V2.6 utiliza el MiMo ViT de 681M parámetros de Xiaomi para la codificación visual junto con componentes de audio dedicados. Esto proporciona al mismo agente la capacidad de procesar instrucciones de texto, capturas de pantalla, fotografías, video y audio. Para agentes de uso de computadora, la multimodalidad nativa importa porque la percepción y la toma de decisiones pueden ocurrir dentro del mismo bucle de razonamiento en lugar de estar separadas en modelos orientados al usuario y desconectados.
Why Is Reinforcement Learning So Important to MiMo-V2.6?
Xiaomi informa que tanto Flash como Pro pasaron por aproximadamente 30 pasos de RL y alrededor de 750,000 trayectorias en un experimento de entrenamiento público de seis días. Los costos de entrenamiento reportados fueron cerca de $850,000 para Flash y $2.62 millones para Pro. Cada actualización utilizó 1,568 muestras de entrenamiento, con pasos individuales alcanzando aproximadamente 3.5–3.7 mil millones de tokens. La mezcla de tareas cubrió código, agentes generales, tareas visuales, ciberseguridad y múltiples arneses de agentes.
Durante este proceso de RL, Xiaomi reporta que la puntuación de DeepSWE v1.1 fuera de muestra subió de 48.8 a 65.7 para Flash y de 58.4 a 72.6 para Pro. Estos números describen el experimento de RL en vivo y no deben confundirse con cada puntuación final de benchmark para los checkpoints publicados, porque la configuración de evaluación puede diferir.
Groupwise agentic grading
Para el entrenamiento de agentes, una recompensa binaria de aprobado/suspenso puede ocultar diferencias significativas entre dos trayectorias exitosas. Una solución puede terminar rápido con pocas llamadas a herramientas, mientras que otra puede desperdiciar decenas de pasos. Xiaomi describe por ello Groupwise Reward Synthesis y Groupwise Advantage Redistribution como mecanismos para comparar trayectorias dentro de un grupo y redistribuir la señal de aprendizaje hacia soluciones más limpias. El objetivo es mejorar no solo la finalización de la tarea, sino también la eficiencia del camino seguido.
How Good Is Xiaomi MiMo-V2.6 on Agent Benchmarks?
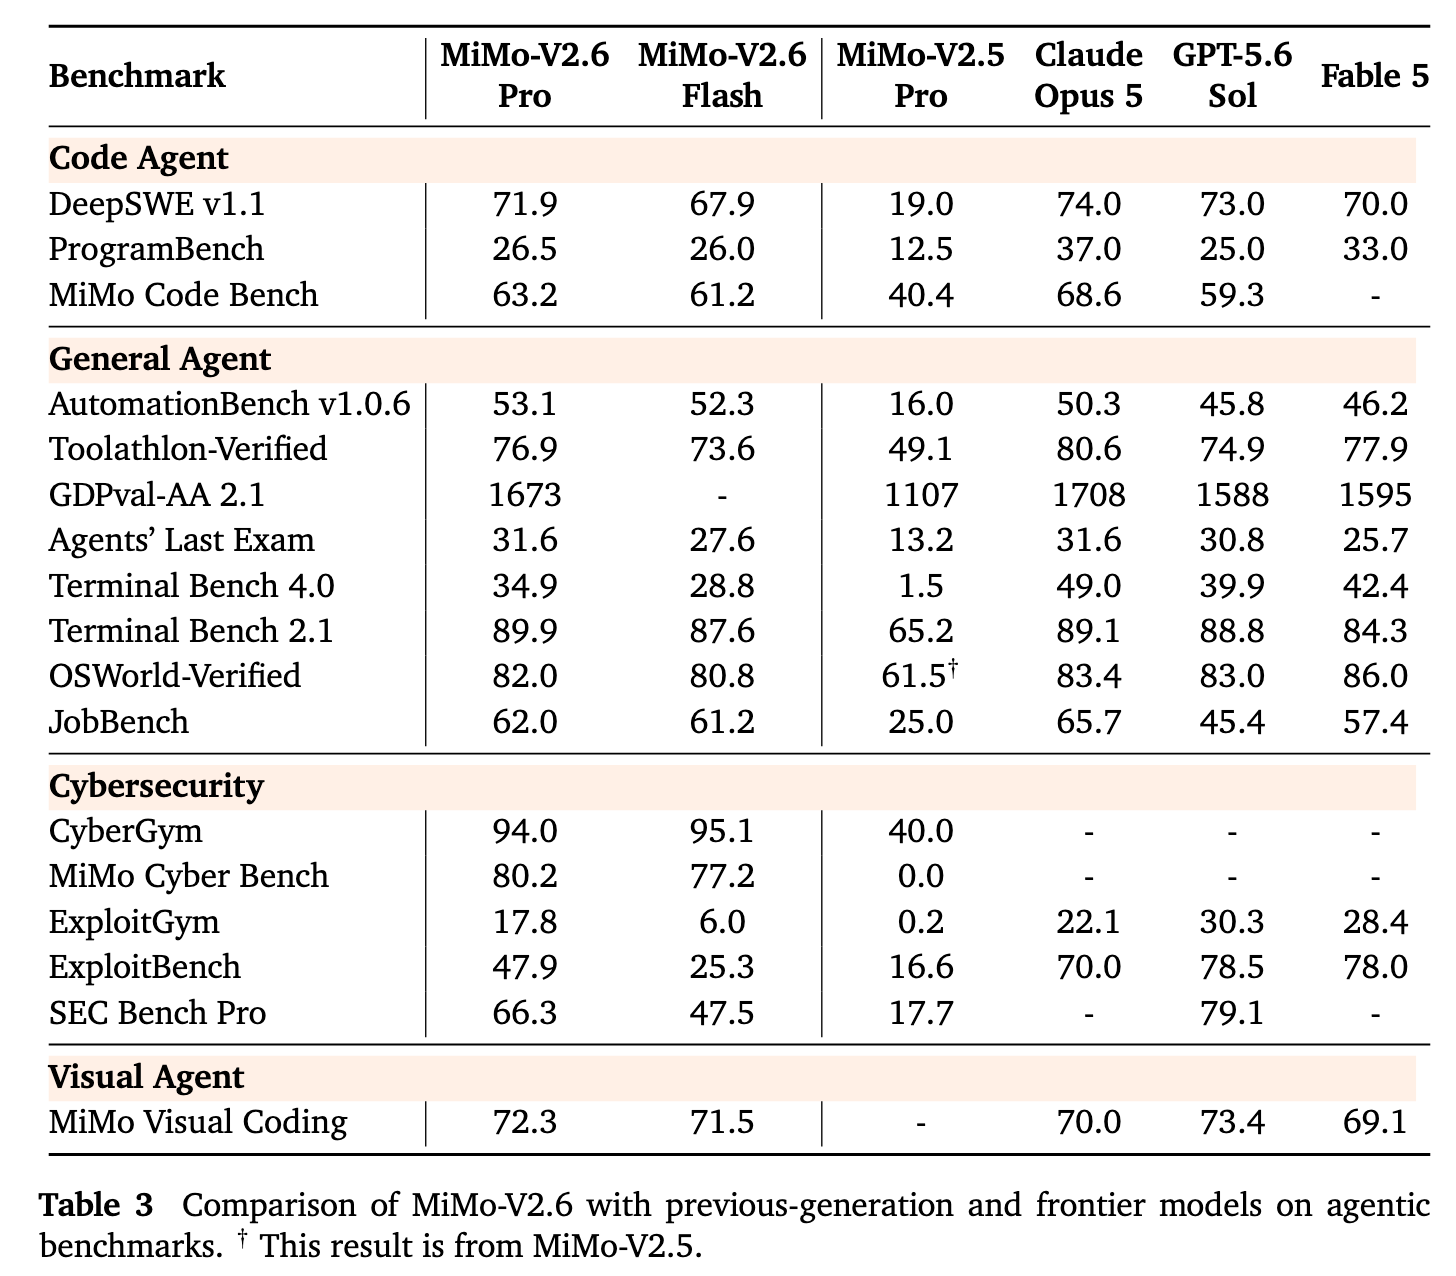
La evidencia pública más sólida para V2.6 se concentra en benchmarks agénticos en lugar de pruebas convencionales de opción múltiple. El gráfico oficial de Xiaomi compara Pro y Flash con MiMo-V2.5-Pro, Claude Opus 5, GPT-5.6 Sol y Fable 5 en tareas de codificación, agentes generales, ciberseguridad y agentes visuales.
| Benchmark | MiMo-V2.6-Pro | MiMo-V2.6-Flash | Claude Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| DeepSWE v1.1 | 71.9 | 67.9 | 74.0 | 73.0 |
| ProgramBench | 26.5 | 26.0 | 37.0 | 25.0 |
| MiMo Code Bench | 63.2 | 61.2 | 68.6 | 59.3 |
| AutomationBench v1.0.6 | 53.1 | 52.3 | 50.3 | 45.8 |
| Toolathlon-Verified | 76.9 | 73.6 | 80.6 | 74.9 |
| Agents' Last Exam | 31.6 | 27.6 | 31.6 | 30.8 |
| Terminal Bench 2.1 | 89.9 | 87.6 | 89.1 | 88.8 |
| OSWorld-Verified | 82.0 | 80.8 | 83.4 | 83.0 |
| JobBench | 62.0 | 61.2 | 65.7 | 45.4 |
| MiMo Visual Coding | 72.3 | 71.5 | 70.0 | 73.4 |
Coding Progress
Las ganancias en programación son más claras en la ejecución de largo horizonte. Durante la ejecución de RL en vivo, Xiaomi informa que DeepSWE v1.1 fuera de muestra mejoró de 48.8 a 65.7 para Flash y de 58.4 a 72.6 para Pro. En la tabla cruzada de modelos publicada, Pro alcanza 71.9 en DeepSWE v1.1 y 63.2 en MiMo Code Bench, mientras que Flash alcanza 67.9 y 61.2. Pro no gana cada prueba de codificación—Claude Opus 5 se mantiene por delante en DeepSWE, ProgramBench y MiMo Code Bench—pero V2.6 combina un desempeño competitivo a escala de repositorio con pesos abiertos y precios de API sustancialmente más bajos.
Reasoning and Agentic Progress
El avance en razonamiento se entiende mejor como una mejora en planificación, uso de herramientas y recuperación que como una única puntuación abstracta de inteligencia. Pro registra 89.9 en Terminal Bench 2.1, 53.1 en AutomationBench y 76.9 en Toolathlon-Verified; Flash registra 87.6, 52.3 y 73.6. Pro supera ligeramente los resultados listados de Claude Opus 5 y GPT-5.6 Sol en Terminal Bench 2.1, mientras que ambos modelos V2.6 lideran a esos comparadores en AutomationBench. Xiaomi atribuye la mejora a la comparación de trayectorias por grupos, evaluadores más ricos, entrenamiento multi‑arnés y señales de recompensa que favorecen caminos de solución más cortos y limpios.
Knowledge and Research Progress
El progreso intensivo en conocimiento está más respaldado por evaluaciones y demostraciones agénticas que por un conjunto convencional de exámenes de conocimiento. Pro iguala a Claude Opus 5 con 31.6 en Agents' Last Exam y alcanza 62.0 en JobBench. Xiaomi también informa flujos de trabajo de investigación de materiales que involucran recuperación de literatura y patentes, generación de hipótesis y tamizado computacional, además de un proyecto de formalización en Lean 4 que supera 6,000 líneas verificadas. Estos ejemplos sugieren una recuperación más sólida, síntesis, razonamiento formal y trabajo de conocimiento basado en herramientas, pero no deben tratarse como prueba independiente de superioridad universal del conocimiento.
En conjunto: El progreso de V2.6 es amplio pero irregular. Es más sólido como evidencia de mejora en codificación de largo horizonte y ejecución agéntica, mientras que las afirmaciones sobre razonamiento general y conocimiento deben permanecer vinculadas al benchmark, arnés y demostración específicos.
Nota sobre benchmarks: Salvo indicación contraria, los resultados entre modelos a continuación son reportados por Xiaomi en la ficha de MiMo-V2.6. Las puntuaciones pueden depender de las versiones de los benchmarks, arneses de agentes, configuraciones de herramientas, presupuestos de inferencia y protocolos de evaluación, por lo que no deben interpretarse como un ranking reproducido de forma independiente.
MiMo-V2.6 vs MiMo-V2.5: What Changed?
| Dimension | MiMo-V2.5 generation | MiMo-V2.6 breakthrough |
|---|---|---|
| Training focus | Agentes multimodales sólidos, contexto largo y eficiencia de tokens | Programa de RL mixto mucho mayor en código, agentes generales, visión, ciberseguridad y múltiples arneses |
| Agent capability | V2.5-Pro apuntaba a trabajos difíciles de largo horizonte | Xiaomi informa que V2.6-Flash supera de forma integral a V2.5-Pro en su suite de benchmarks de agentes |
| Learning efficiency | Punto de control de producción previo | Cerca de 750,000 trayectorias a lo largo de 30 pasos de RL; mejoras retenidas en DeepSWE de ~17 puntos para Flash y ~14 para Pro durante el entrenamiento |
| Openness | Pesos abiertos y soporte del ecosistema | Añade código completo de RL, más de 7,000 entornos de tareas, marco de entrenamiento, arneses ligeros y un checkpoint de destilación de 9B |
| Economics | Nivel de precios de la API de V2.5 existente | Mayor inteligencia reportada al mismo precio oficial de la API, desplazando la frontera capacidad‑costo |
Coding and agent execution
En comparación con V2.5, el cambio más claro es una política de agente más fuerte en lugar de una ventana de contexto más larga. Xiaomi informa que V2.6-Flash supera a V2.5-Pro en su suite de benchmarks de agentes. Durante la ejecución de entrenamiento de V2.6, DeepSWE v1.1 retenido mejoró de 48.8 a 65.7 para Flash y de 58.4 a 72.6 para Pro; estas puntuaciones de la ejecución de entrenamiento no son directamente intercambiables con la tabla de benchmarks del modelo publicado arriba.
Reasoning, knowledge, and training breadth
V2.6 extiende el aprendizaje por refuerzo a través de codificación, agentes generales, visión, ciberseguridad y múltiples arneses. Xiaomi reporta unas 750,000 trayectorias a lo largo de aproximadamente 30 pasos de RL. Esto respalda una planificación, uso de herramientas y recuperación más amplios, pero no establece por sí mismo una ganancia universal en cada benchmark de conocimiento o razonamiento; compare tareas y configuraciones de evaluación emparejadas.
Migration and openness
El lanzamiento también añade código de RL, más de 7,000 entornos de tareas, infraestructura de entrenamiento y un checkpoint de destilación de 9B. El contexto de 1M tokens y las entradas multimodales son continuidades desde V2.5, no avances nuevos de V2.6.
El cambio práctico, por tanto, no es un nuevo sobre de contexto—el contexto de 1M y la multimodalidad completa ya existían en V2.5—sino una política de agente más fuerte entrenada con un cómputo de aprendizaje por refuerzo sustancialmente mayor y entornos verificables más amplios. Xiaomi ha anunciado que los nombres de modelo V2.5 y V2.5-Pro dejarán de funcionar el 21 de octubre de 2026, por lo que las nuevas implementaciones deben apuntar a V2.6 y las implementaciones existentes deben planificar pruebas de migración.
How V2.6 compares with other frontier models
| Dimension | MiMo-V2.6-Pro | Closed frontier models | Other open-weight models |
|---|---|---|---|
| Weights | Pesos abiertos | Generalmente cerrados | Dependiente del modelo |
| Verified MiMo context | 1M tokens | Verificar cada página oficial del modelo | Verificar cada ficha oficial del modelo |
| Verified MiMo modalities | Texto, imagen, video, audio | Dependiente del proveedor | Dependiente del modelo |
| Agent-focused RL | Fuerte énfasis en el lanzamiento | Dependiente del modelo y del sistema | Dependiente del modelo y del checkpoint |
| Self-hosting | Sí, con infraestructura sustancial | Generalmente no | A menudo posible para checkpoints abiertos |
| Primary MiMo advantage | Pesos abiertos, multimodalidad nativa, bajo costo de API | Ecosistema del proveedor y herramientas gestionadas | Varía según licencia, tamaño y pila de despliegue |
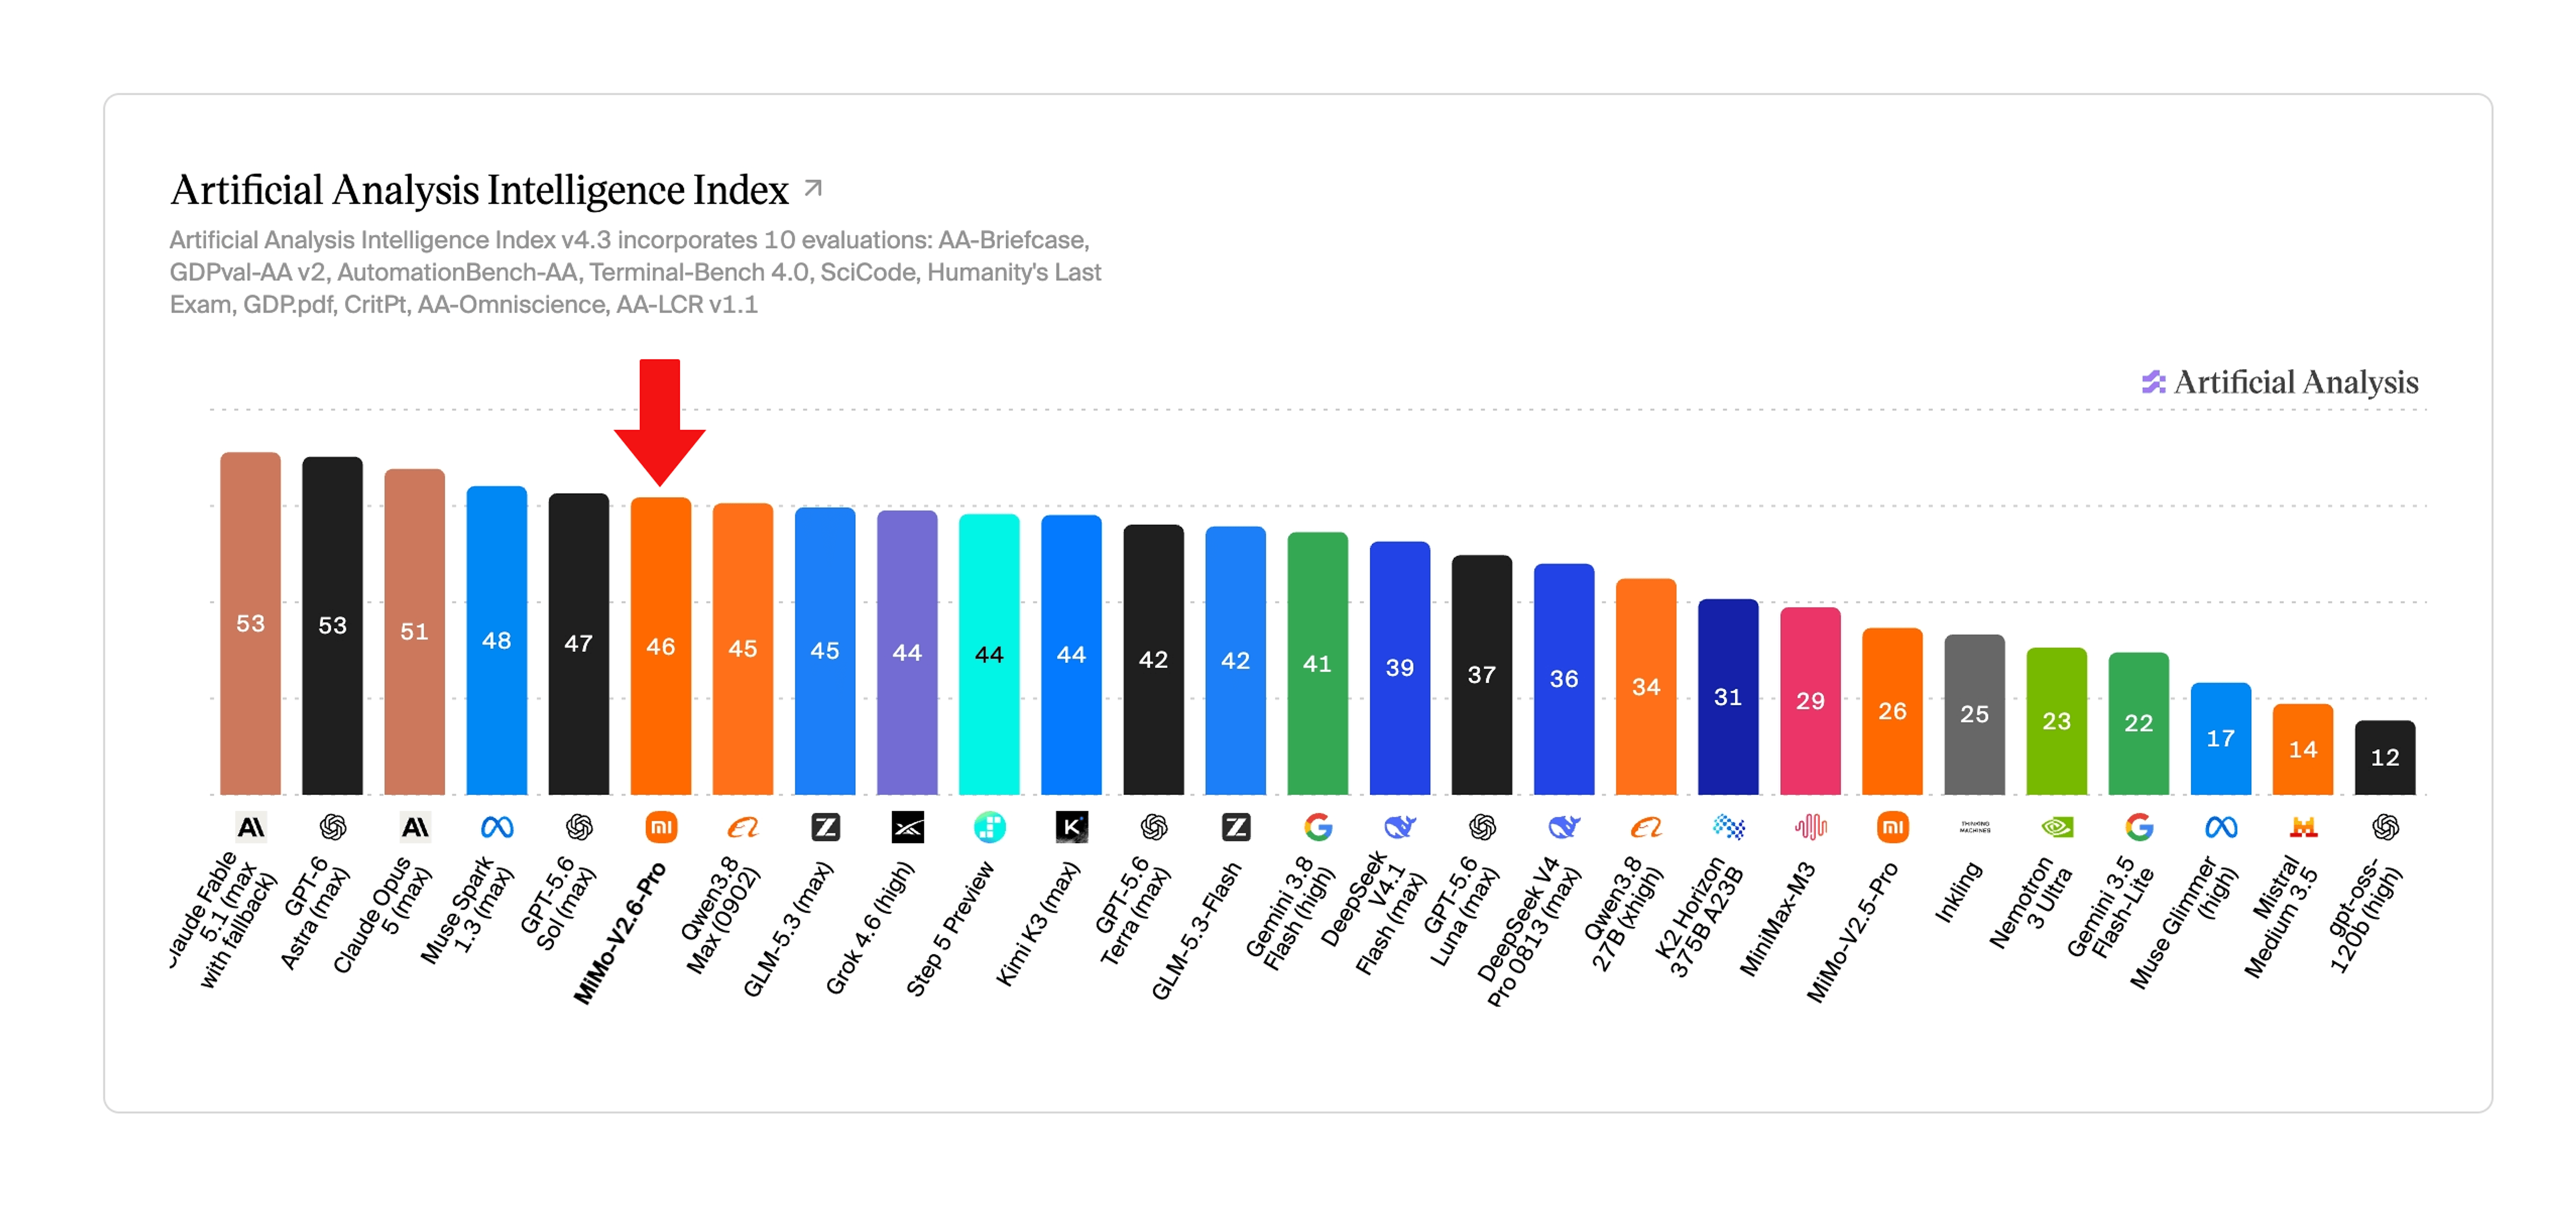
Para un conjunto de comparación actual, evalúa MiMo-V2.6 frente a Claude Opus 5.5 para codificación agéntica de larga ejecución, Claude Fable 5.1 para el trabajo autónomo más difícil, GPT-6 Sol y Gemini 4 Pro. La disponibilidad de modelos y los precios son dinámicos, por lo que las comparaciones de producción deben usar el catálogo en vivo y prompts, herramientas, presupuestos de esfuerzo y criterios de aceptación emparejados.
What Can Xiaomi MiMo-V2.6 Actually Do?
Coding and software-engineering agents
MiMo-V2.6 está diseñado para trayectorias largas de ingeniería de software: inspeccionar repositorios, modificar código, usar herramientas de terminal, ejecutar pruebas, diagnosticar fallos y continuar hasta satisfacer un objetivo. Sus resultados en DeepSWE, Terminal Bench, AutomationBench y Toolathlon indican que Xiaomi está optimizando para la ejecución más que para el autocompletado de código únicamente. Las cargas de trabajo prácticas incluyen agentes de codificación, depuración automatizada, refactorización de repositorios, resolución de incidencias en CI y flujos de trabajo de ingeniería multi‑herramienta.
Computer use
Xiaomi demuestra explícitamente un Agente de Uso de Computadora (CUA). El modelo puede interpretar interfaces gráficas, recuperar información, editar contenido, procesar datos, inspeccionar resultados, diagnosticar problemas y cambiar acciones posteriores según la retroalimentación visual. En este flujo, la salida del modelo a menudo no es el producto final; puede, en cambio, determinar la siguiente acción de software o navegador.
3D worlds and Blender workflows
Bajo el concepto "Vibe World", MiMo-V2.6 puede tomar referencias de texto, imagen o video y descomponer una solicitud 3D en construcción de escena, programación de interacciones y tareas de verificación visual. Xiaomi también demuestra el control del modelo sobre Blender para crear objetos y escenas 3D a partir de descripciones o imágenes de referencia. Esto extiende el vibe coding más allá del código de aplicaciones hacia entornos interactivos.
Robotics and embodied agents
Xiaomi demuestra MiMo-V2.6 en un entorno de simulación encarnado utilizando imágenes de cámara multivista y un brazo robótico Franka Panda. Las tareas de ejemplo incluyen agarre de objetos, combinación de colores y colocación precisa. Esto no establece a V2.6 como un modelo base universal de robótica, pero muestra cómo la visión nativa y la toma de decisiones de largo horizonte pueden conectarse a bucles de control encarnados.
Scientific research and formal reasoning
Xiaomi reporta un caso en ciencia de materiales en el que MiMo-V2.6-Pro asistió a investigadores con armazones metalorgánicos para adsorción de PFAS, incluyendo búsqueda de literatura y patentes, formulación de candidatos y llamadas a herramientas computacionales. En otro experimento, el modelo ayudó a formalizar el teorema principal de "Period Three Implies Chaos" en Lean 4. Xiaomi informa un proyecto completado que supera las 6,000 líneas de código en Lean, verificadas por el kernel de Lean sin marcadores no probados. Estos ejemplos se interpretan mejor como demostraciones de flujos de trabajo de investigación agéntica, no como prueba de descubrimiento científico autónomo.
Websites, presentations, video, and music
MiMo-V2.6 puede coordinar codificación front‑end, flujos de diseño, diapositivas, activos SVG, pipelines de video y herramientas de producción musical. Xiaomi demuestra la orquestación con sistemas especializados de medios, incluida la narración mediante MiMo-V2.5-TTS, en lugar de afirmar que V2.6 reemplaza por sí solo a cada generador de imagen, video o audio. Por tanto, el modelo encaja de forma natural como orquestador de producción creativa.
Los casos de uso en esta sección son demostraciones de Xiaomi, no evidencia independiente de que cada implementación reproducirá los mismos resultados. Los equipos de producción deben probar el modelo con sus propias herramientas, permisos, recuperación ante fallos y criterios de evaluación.
How Much Does Xiaomi MiMo-V2.6 Cost?
| Pricing | MiMo-V2.6-Pro | MiMo-V2.6-Flash | Pro UltraSpeed |
|---|---|---|---|
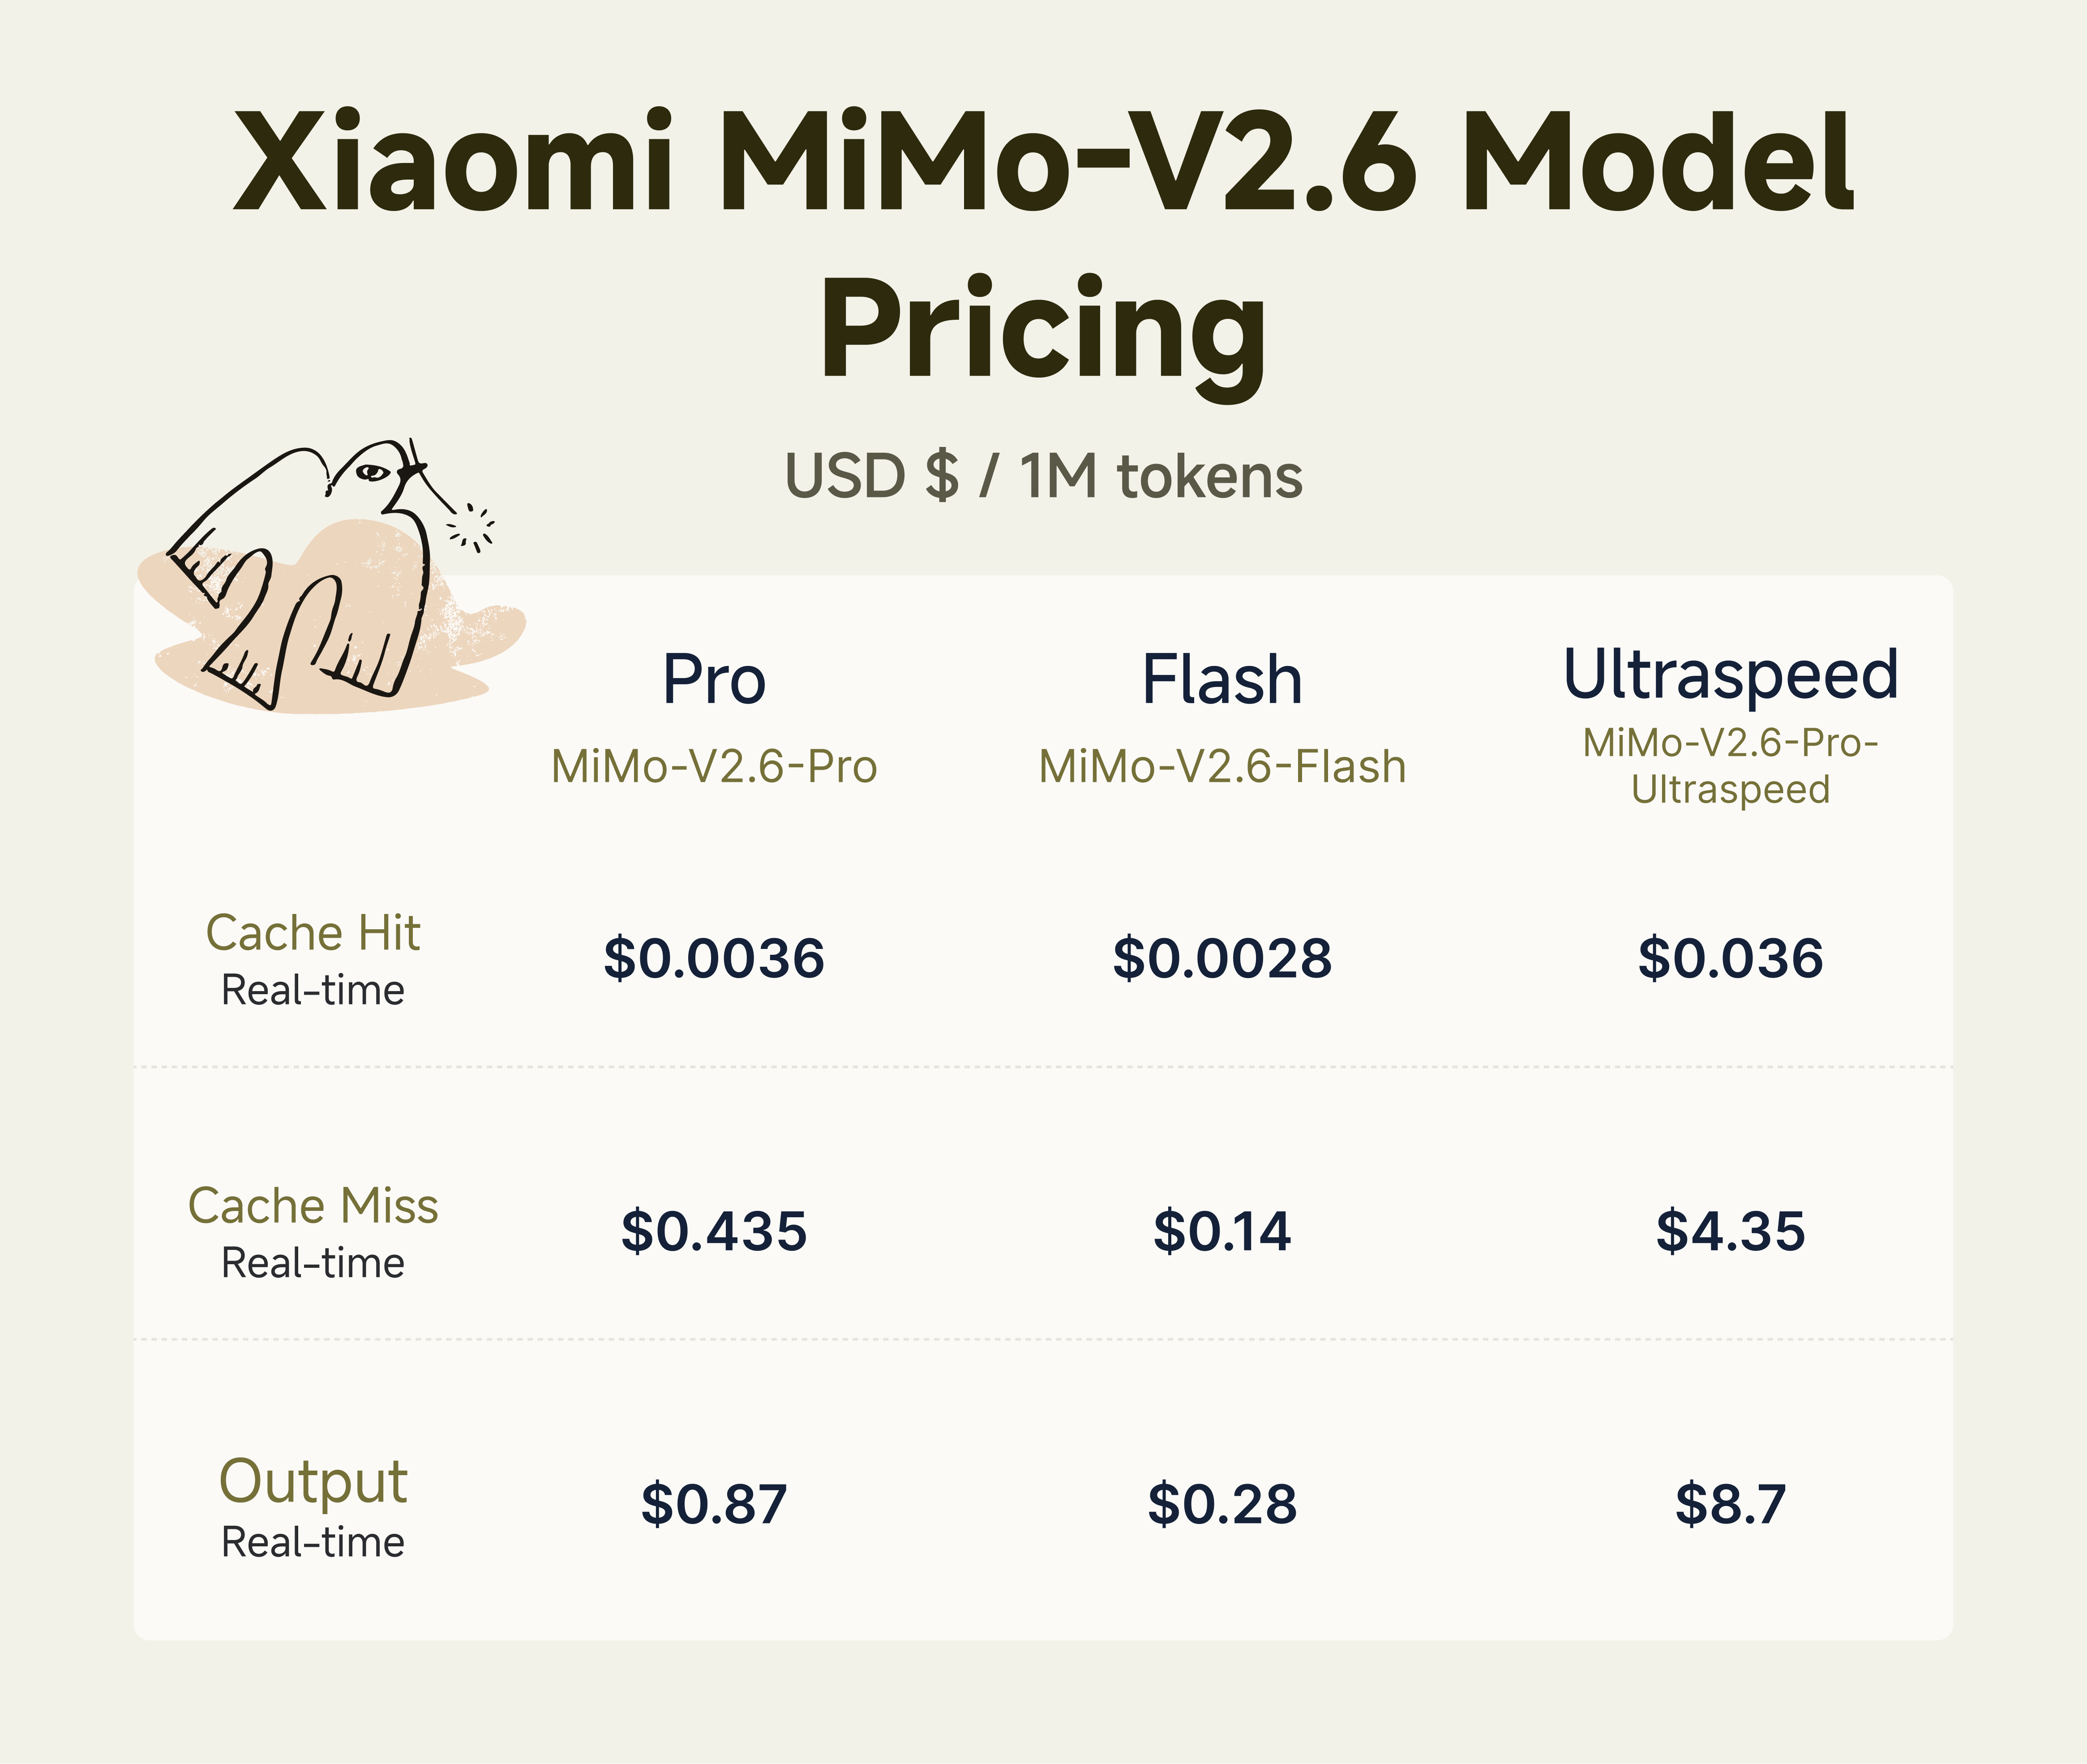
| Cached input / 1M tokens | $0.0036 | $0.0028 | $0.036 |
| Uncached input / 1M tokens | $0.435 | $0.14 | $4.35 |
| Output / 1M tokens | $0.87 | $0.28 | $8.70 |
Xiaomi mantiene los precios de la API de V2.6 en el mismo nivel general que su generación V2.5. Flash es especialmente notable para cargas de trabajo de alto volumen: el precio oficial de Xiaomi muestra $0.14 por millón de tokens de entrada sin caché y $0.28 por millón de tokens de salida.
CometAPI Pricing and Availability
| CometAPI route | Input / 1M | Output / 1M | Catalog status |
|---|---|---|---|
| mimo-v2.6-pro-ultraspeed | $3.48 | $6.96 | Disponible; 20% por debajo de las tarifas oficiales sin caché listadas |
| mimo-v2.6-pro | $0.348 | $0.6960 | Disponible; 20% por debajo de las tarifas oficiales sin caché listadas |
| mimo-v2.6-flash | $0.112 | $0.2240 | Disponible; 20% por debajo de las tarifas oficiales sin caché listadas |
How Can Developers Access Xiaomi MiMo-V2.6?
Xiaomi expone los modelos a través de una API compatible con OpenAI y documenta compatibilidad con el protocolo de Anthropic en sus páginas oficiales de modelo. Los identificadores oficiales son mimo-v2.6-pro, mimo-v2.6-flash y mimo-v2.6-pro-ultraspeed. Xiaomi documenta llamadas a herramientas, salida estructurada, streaming, controles de razonamiento, caché de contexto y búsqueda web. La interfaz compatible con OpenAI usa valores de thinking.type como enabled o disabled, con deep thinking habilitado por defecto para los modelos V2.6.
Los desarrolladores tienen tres vías prácticas de acceso. Primero, descarga el checkpoint de pesos abiertos de Pro o Flash para una integración autoalojada, sujeta a requisitos de servicio sustanciales. Segundo, utiliza la API gestionada de Xiaomi con una clave de Xiaomi y su endpoint documentado. Tercero, usa una ruta soportada de CometAPI con una clave de CometAPI y URL base; esto puede simplificar la evaluación multi‑modelo y la facturación. Asistentes de codificación como Claude Code pueden usar una ruta compatible con Anthropic cuando esa ruta y modelo estén soportados, pero la compatibilidad debe probarse y no asumirse.
Accessing MiMo-V2.6 through CometAPI
CometAPI proporciona un endpoint unificado y una capa de facturación para los modelos soportados. La principal ventaja operativa es la simplicidad de migración: los equipos pueden mantener un SDK familiar, cambiar la URL base y el ID del modelo, comparar MiMo con otros modelos frontera en la misma cuenta y centralizar comprobaciones de uso, precios y disponibilidad. Esto es útil para enrutamiento multi‑modelo, estrategias de fallback, facturas consolidadas y evaluaciones que necesitan prompts idénticos entre proveedores.
CometAPI documenta tres formatos de solicitud de texto a nivel de plataforma: OpenAI Chat Completions, Anthropic Messages y OpenAI Responses. Para un SDK compatible, la migración generalmente significa cambiar la URL base, la clave de API y el ID del modelo en lugar de reescribir toda la aplicación. El soporte de endpoint y parámetros puede variar según el modelo, por lo que prueba la variante exacta de MiMo‑V2.6 y el formato de solicitud antes de afirmar que las tres rutas funcionan para él.
Consultado el 23 de septiembre de 2026, MiMo-V2.6-Pro-UltraSpeed tiene una ruta de catálogo disponible con precios de entrada y salida listados. Las páginas dedicadas de Pro y Flash muestran Coming soon en sus capturas de catálogo aunque sus paneles de estado de API dicen Available. Trátalo como una señal de página inconsistente, no como disponibilidad o precios de producción confirmados. Verifica el catálogo en vivo, el panel y una solicitud de prueba antes del despliegue.
El siguiente ejemplo sigue el patrón publicado de Anthropic-SDK de CometAPI y llama a la ruta de UltraSpeed listada actualmente. Guarda la clave de API en una variable de entorno.
import Anthropic from '@anthropic-ai/sdk';

const client = new Anthropic({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: 'https://api.cometapi.com',
});

const message = await client.messages.create({
  model: 'mimo-v2.6-pro-ultraspeed',
  max_tokens: 4096,
  messages: [{ role: 'user', content: 'Analiza este proyecto y propón los próximos pasos de implementación.' }],
});
Is Xiaomi MiMo-V2.6 Open Source?
Xiaomi ha publicado pesos del modelo, material técnico, recursos de RL, entornos de entrenamiento e infraestructura relacionada. La publicación incluye más de 7,000 entornos de tareas de RL que abarcan ingeniería de software, reproducción de vulnerabilidades, trabajos intensivos en conocimiento y diseño/desarrollo web. Xiaomi también liberó MiMo-V2.6-Distill-Qwen-9B para que investigadores puedan estudiar la canalización de RL a una escala mucho menor.
Fichas oficiales del modelo: MiMo-V2.6-Pro-RL | MiMo-V2.6-Flash-RL
What Are the Limitations of Xiaomi MiMo-V2.6?
El titular de billones de parámetros no debe tomarse como prueba de que V2.6 es universalmente más fuerte que los sistemas frontera cerrados. La propia tabla de benchmarks de Xiaomi muestra un panorama mixto: Claude Opus 5 sigue por delante en algunas pruebas de codificación, uso de herramientas y OS, mientras que GPT-5.6 Sol también lidera en pruebas seleccionadas. Por lo tanto, la evaluación específica por carga de trabajo es más significativa que una etiqueta de ganador general.
Alojar por cuenta propia el checkpoint completo de Pro también es una tarea con mucha infraestructura. Pesos abiertos no significan despliegue sencillo en una estación de trabajo. Además, varias demostraciones destacadas—investigación, control encarnado, mundos 3D y producción de video—dependen de herramientas externas y arneses de agentes. MiMo‑V2.6 debe evaluarse como un modelo dentro de un sistema, no solo como un modelo de chat independiente.
Why Does Xiaomi MiMo-V2.6 Matter?
MiMo‑V2.6 combina tres direcciones importantes: modelos MoE dispersos muy grandes, multimodalidad nativa y aprendizaje por refuerzo en entornos reales de agentes. La cifra de 1.02T parámetros atrae atención, pero la elección de diseño más consecuente es la inversión de Xiaomi en interacción repetida con entornos, calificación de trayectorias, uso de herramientas y autocorrección.
Si este enfoque continúa escalando, los modelos abiertos pueden diferenciarse cada vez más no solo por cuánta información estática contienen, sino por qué tan efectivamente actúan, evalúan, se recuperan y completan tareas largas. Por lo tanto, MiMo‑V2.6 se entiende mejor como un modelo base abierto orientado a agentes y no simplemente como otro chatbot de un billón de parámetros.
Conclusion
MiMo‑V2.6 es una publicación de pesos abiertos sustancial porque combina entrada nativa de texto, imagen, video y audio con contexto largo, inferencia MoE dispersa y aprendizaje por refuerzo en entornos reales de agentes. Pro es el mejor ajuste para tareas difíciles de largo horizonte, Flash apunta a cargas de trabajo de alto volumen y sensibles al costo, y UltraSpeed intercambia un precio de API significativamente mayor por menor latencia.
La familia de modelos es competitiva en varios benchmarks agénticos reportados por el proveedor, pero no lidera todas las evaluaciones y no debe tratarse como reemplazo universal de modelos frontera cerrados. La vía de adopción más confiable es probar MiMo‑V2.6 frente a las herramientas exactas, objetivos de latencia, modos de fallo y perfil de costos del flujo de trabajo de producción previsto.
FAQ
What should teams test before moving MiMo-V2.6 into production?
Prueba el sistema completo en lugar del modelo solo. Mide finalización de tareas, precisión de llamadas a herramientas, recuperación ante acciones fallidas, latencia, consumo de tokens, gestión de contexto y límites de permisos. Los benchmarks de agentes proporcionan orientación, pero las evaluaciones internas deben reflejar el repositorio, navegador, documento o flujo de investigación real.
Why can self-hosting MiMo-V2.6-Pro be difficult despite its sparse architecture?
La activación dispersa reduce el cómputo por token en comparación con un modelo denso de un billón de parámetros, pero el checkpoint completo aún tiene una huella de memoria y de servicio distribuido muy grande. El despliegue en producción puede requerir inferencia multinodo, paralelismo de expertos, kernels especializados y una planificación de capacidad cuidadosa.
How should developers interpret Xiaomi's cross-model benchmark table?
Trátala como evidencia reportada por el proveedor, no como un ranking universal reproducido de forma independiente. Los resultados pueden cambiar con el arnés de agentes, el presupuesto de inferencia, las herramientas, la imagen del entorno, el método de muestreo y la versión del benchmark. Compara tendencias en múltiples tareas y reproduce internamente las cargas de trabajo más relevantes.
When is MiMo-V2.6-Flash a better choice than Pro?
Flash es la opción más sólida por defecto cuando el volumen de llamadas y el costo dominan, especialmente para procesamiento de documentos, análisis multimodal y pasos agénticos repetidos. Pro es más apropiado cuando el razonamiento difícil o la ejecución de largo horizonte aportan suficiente valor empresarial para justificar el precio más alto.
Does a 1M-token context window eliminate the need for retrieval or prompt management?
No. Una ventana más grande incrementa la capacidad, pero enviar historial innecesario puede elevar la latencia y el costo y diluir la evidencia relevante. Recuperación, resumen, memoria estructurada y poda de contexto siguen siendo importantes para agentes de producción confiables.