

TL;DR
Claude Opus 5.5 est un excellent candidat de départ, car il propose des tarifs par token nettement plus bas tout en égalant ou dépassant Fable 5.1 sur plusieurs évaluations publiées, avec un prix de $4 par million de tokens en entrée et $20 par million de tokens en sortie, contre $10 et $50 pour Fable 5.1.
Fable 5.1 conserve un rôle lorsque la tâche est exceptionnellement difficile, longue, coûteuse à relancer ou censée fonctionner sans supervision étroite. La règle pratique est simple : commencer avec Opus 5.5, puis n’escalader vers Fable 5.1 que lorsque des tests représentatifs en production montrent que Fable 5.1 réduit suffisamment les échecs, corrections ou relances pour justifier son surcoût.
Claude Opus 5.5 vs Claude Fable 5.1 en un coup d’œil
| Dimension | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|
| Release date | Sep. 22, 2026 | Sep. 1, 2026 |
| API model ID | claude-opus-5-5 | claude-fable-5-1 |
| Context / max output | 1M / 128K | 1M / 128K |
| Input / output per MTok | $4 / $20 | $10 / $50 |
| Cache read per MTok | $0.20 | $0.25 |
| Terminal-Bench 4.0 | 66.4% | 55.8% |
| FrontierCode v1.1 | 54.4% | 50.3% |
| CursorBench 4.0 | 57.8% | 51.8% |
| GDPval-AA v2.1 | 1846 Elo | 1735 Elo |
| HAProxy C-to-Rust migration | 9.5 hours; 51% lower task cost | 12 hours; baseline task cost |
| Speed option | Fast mode, up to 2.5× normal speed | No equivalent launch mode |
| Effort starting point | Medium-oriented | High |
| Best default use | Daily frontier coding, agents, supervised production, and high-volume API traffic | Highest-value, difficult, long-running, or unattended autonomous work |
| API access | Anthropic API and compatible providers including CometAPI | Anthropic API and compatible providers including CometAPI |
Note de lecture : les chiffres de benchmarks sont fournis par Anthropic et dépendent du niveau d’effort, du harnais, des garde-fous, de la version des tâches, du nombre d’essais et de l’erreur standard. Ils ne doivent être comparés que dans des conditions d’évaluation assorties.
Points clés
- Les tarifs standard d’entrée et de sortie d’Opus 5.5 sont inférieurs de 60% à ceux de Fable 5.1.
- Les deux modèles prennent en charge une fenêtre de contexte de 1M de tokens et jusqu’à 128K en sortie, donc les coûts, les réglages d’effort et l’adéquation au workload comptent plus que la taille nominale du contexte.
- Les résultats publiés par Anthropic favorisent Opus 5.5 sur de nombreux benchmarks de code et d’agents, mais les paramètres de benchmark influencent fortement le résultat.
- Des évaluations indépendantes confirment la position de pointe d’Opus 5.5 tout en rapportant des scores absolus différents, ce qui renforce la nécessité de tests appariés.
- Pour la plupart des travaux supervisés en production, Opus 5.5 est le meilleur point de départ. Fable 5.1 est un niveau d’escalade, pas le choix par défaut automatique.
Qu’est-ce que Claude Opus 5.5 ?
Claude Opus 5.5 est le premier modèle Claude 5.5 d’Anthropic. Il est positionné pour le code agentique, les agents de longue durée, le travail de connaissance professionnel, les workflows d’entreprise, l’analyse financière, la vision et l’utilisation de l’ordinateur.
Son ID de modèle API est claude-opus-5-5. La réflexion adaptative est toujours activée, tandis que les développeurs contrôlent l’intensité du raisonnement via des niveaux d’effort low, medium, high, xhigh et max. Anthropic propose également Fast mode, qui peut fonctionner jusqu’à 2.5 fois plus vite que la normale pour $8/M en entrée et $40/M en sortie.
Qu’est-ce que Claude Fable 5.1 ?
Claude Fable 5.1 est positionné pour des projets exigeants et de longue durée, tels que le codage sur plusieurs heures, la recherche complexe, l’interaction navigateur, les agents autonomes et les workflows couvrant plusieurs applications.
Son ID de modèle API est claude-fable-5-1. Il utilise une réflexion adaptative, démarre avec un niveau d’effort API plus élevé et doit être traité comme l’option premium lorsque le coût attendu d’un échec ou de relances répétées dépasse le coût d’inférence additionnel.
Une lecture simplifiée serait qu’Opus 5.5 offre presque la même enveloppe pour 40% du prix standard de Fable. Mais c’est précisément là qu’un simple tableau de spécifications peut être trompeur.
Comparaison du code et des benchmarks
Anthropic rapporte Opus 5.5 devant Fable 5.1 sur Terminal-Bench 4.0, FrontierCode v1.1, CursorBench 4.0, GDPval-AA v2.1, AutomationBench, Humanity’s Last Exam avec outils, Terminal-Bench-Science, OSWorld 2.0 et Chartography.
Comment lire les résultats de benchmark
Anthropic rapporte Opus 5.5 devant Fable 5.1 sur Terminal-Bench 4.0, FrontierCode v1.1, CursorBench 4.0, GDPval-AA v2.1, AutomationBench, Humanity’s Last Exam avec outils, Terminal-Bench-Science, OSWorld 2.0 et Chartography. Ces chiffres sont des résultats d’évaluation, pas des constantes de modèle indépendantes de la configuration.
La plupart des scores phares d’Opus 5.5 ont été obtenus au niveau d’effort max, tandis que Terminal-Bench 4.0 a utilisé xhigh. La conception du harnais, la configuration des outils, les garde-fous, le nombre d’essais, l’erreur standard, les comportements de repli et les plafonds de coût peuvent tous modifier le résultat. Anthropic souligne que les marges de benchmark peuvent surestimer l’écart pratique entre modèles de pointe.
Performances en codage
| Benchmark | Claude Opus 5.5 | Claude Fable 5.1 | Interprétation |
|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | 55.8% | Avantage rapporté de 10,6 points pour les tâches d’agent en terminal |
| FrontierCode v1.1 | 54.4% max; 54.6% medium | 50.3% | Opus 5.5 en medium reste compétitif pour l’économie de production |
| CursorBench 4.0 | 57.8% max; 52.5% medium | 51.8% | Le niveau medium dépasse légèrement le résultat rapporté de Fable |
| GDPval-AA v2.1 | 1846 Elo | 1735 Elo | Avantage rapporté sur le travail agentique professionnel |
Ces chiffres sont des résultats de benchmarks rapportés par Anthropic. Le tableau doit être lu conjointement avec les mises en garde sur les paramètres d’évaluation dans les sections suivantes et la page officielle du modèle Claude Opus.
Les trois premiers résultats se distinguent car ils couvrent la charge de travail où Claude gagne une importance commerciale croissante : les agents d’ingénierie logicielle. Terminal-Bench 4.0 montre une différence absolue de 10,6 points de pourcentage ; FrontierCode montre 4,1 points ; CursorBench 4.0 montre 6 points.
GDPval-AA, qui mesure le travail agentique professionnel, rapporte également 1846 Elo pour Opus 5.5 contre 1735 pour Fable 5.1. Si ces chiffres résumaient toute l’histoire, la hiérarchie produit semblerait inversée. Ce n’est pas si simple.
Évaluation indépendante
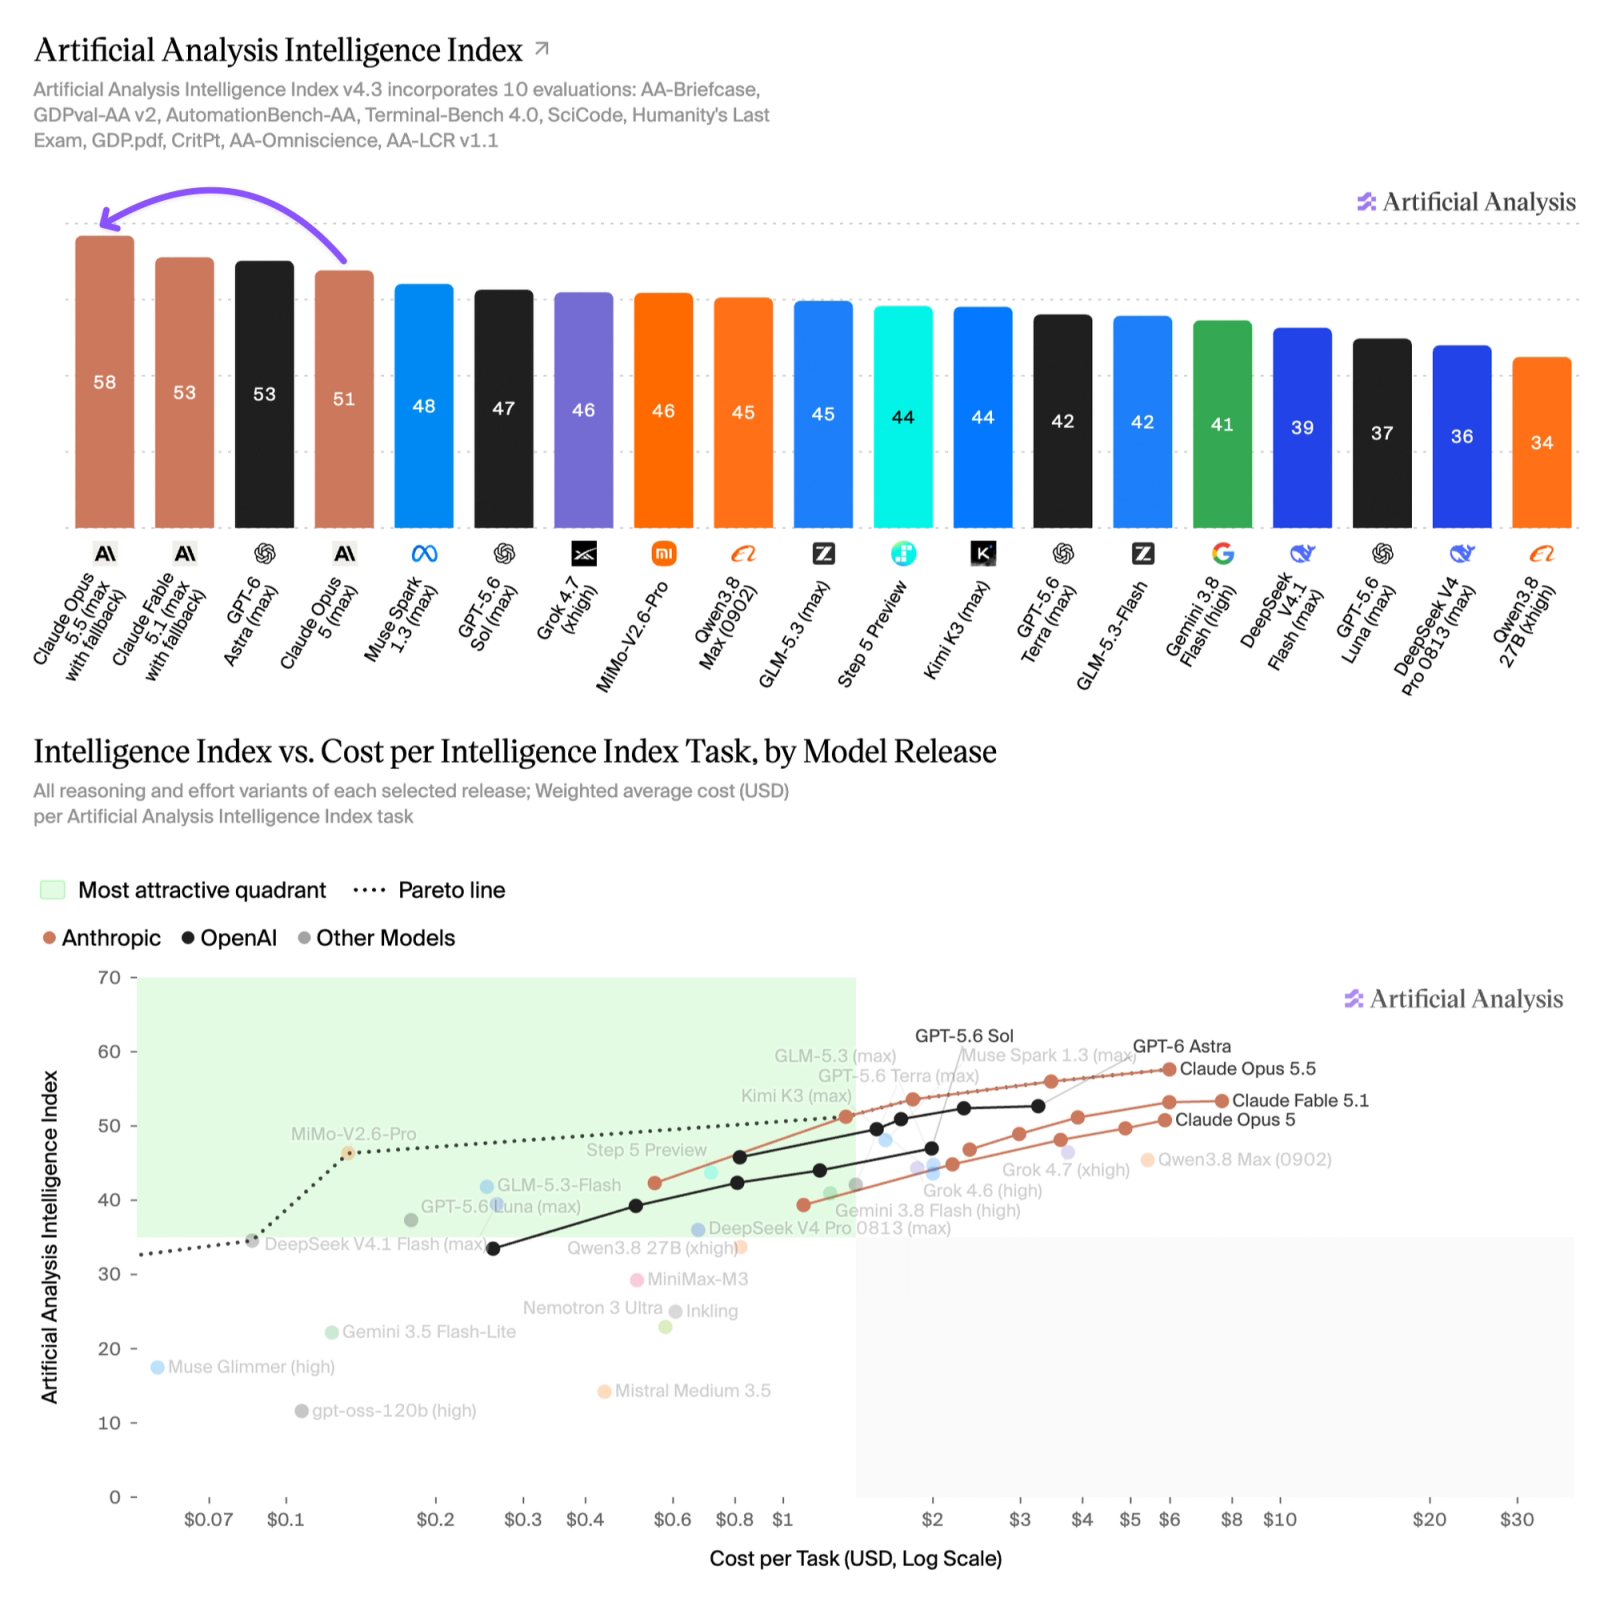
Artificial Analysis a placé Opus 5.5 Max à 58 sur son Intelligence Index et a rapporté de solides résultats sur AA-Briefcase, GDPval-AA, AutomationBench-AA, Terminal-Bench 4.0, SciCode et Humanity’s Last Exam. Son résultat Terminal-Bench 4.0 était de 59.6%, inférieur aux 66.4% d’Anthropic, démontrant pourquoi les équipes doivent documenter la version du modèle, le niveau d’effort, le harnais, les outils, le nombre d’essais et la limite de coût chaque fois que les scores divergent.
Comparaison des prix et du coût par tâche terminée
CometAPI offre des prix par token inférieurs aux tarifs officiels, permettant aux développeurs d’obtenir les mêmes performances que l’API officielle en utilisant le format de requête de message standard.
Tarification des tokens
| Pricing | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|
| Input | $4 | $10 |
| Output | $20 | $50 |
| 5-min cache write | $5 | $12.50 |
| 1-hour cache write | $8 | $20 |
| Cache read | $0.20 | $0.25 |
| Batch input/output | 50% discount | 50% discount |
Supposons qu’une charge de travail consomme 10 millions de tokens d’entrée frais et 2 millions de tokens de sortie. Sans effets de cache :
10 × $4 + 2 × $20 = $80
10 × $10 + 2 × $50 = $200
Dans ces hypothèses, Opus 5.5 coûte 60% de moins. Cependant, ce chiffre ne doit pas être confondu avec l’affirmation d’Anthropic selon laquelle Opus 5.5 coûte environ 40% de moins à exécuter qu’Opus 5.
Ce sont deux comparaisons totalement différentes. Le chiffre de 40% inclut les prix plus bas au sein de la gamme Opus pour Opus 5.5 et une réduction de la consommation de tokens par tâche par rapport à Opus 5. Le chiffre de 60% provient directement de la comparaison des prix de liste standard d’Opus 5.5 et de Fable 5.1.
Coût par tâche terminée
Une API de modèle ne vend pas vraiment des tokens. Les développeurs achètent du travail accompli.
Une équipe de développement ne se soucie pas qu’un modèle ait consommé 6,2 millions de tokens. Elle veut savoir si le modèle a corrigé le bogue, terminé la migration, passé la suite de tests ou achevé la tâche de recherche.
Anthropic le souligne directement dans son analyse What a task costs on Opus 5.5 : deux modèles aux prix similaires peuvent avoir des coûts par tâche très différents si l’un nécessite plus d’échanges, relit plus de contexte, relance plus souvent ou génère davantage de tokens de réflexion.
Task Cost = Fresh Input Cost
          + Cache Read Cost
          + Cache Write Cost
          + Output / Thinking Cost
          + Retry Cost
Ce dernier élément est souvent négligé. Un modèle moins cher qui échoue deux fois peut devenir plus coûteux qu’un modèle plus cher qui termine la tâche en une seule exécution. De même, un niveau d’effort élevé qui évite dix tours de relance peut en réalité réduire le coût total.
Économie du cache de prompt
Les agents fortement basés sur le cache réutilisent à répétition les définitions d’outils, le contexte du référentiel, les instructions système, l’historique de conversation et les sorties de tests. Comme le prix de lecture du cache est de $0.20/M pour Opus 5.5 et de $0.25/M pour Fable 5.1, l’écart est bien plus faible que la différence de $6/M pour l’entrée fraîche. Les équipes devraient donc suivre séparément l’entrée fraîche, les lectures de cache, les écritures de cache, la sortie, les tours d’outils et les relances.
Économie des niveaux d’effort
Potentiellement, oui. Artificial Analysis a testé cinq niveaux d’effort d’Opus 5.5 et a trouvé une courbe claire capacité-coût.
| Effort Opus 5.5 | Artificial Analysis Intelligence Index | Coût par tâche de l’indice |
|---|---|---|
| Low | 42 | $0.55 |
| Medium | 51 | $1.34 |
| High | 54 | $1.82 |
| Xhigh | 56 | $3.46 |
| Max | 58 | $5.98 |
Le niveau medium est un point de départ sensé pour les changements de code routiniers, les refactorisations connues et le débogage supervisé. High ou xhigh peuvent être justifiés pour des pannes système ambiguës, des migrations nocturnes ou des tâches où un mauvais plan crée beaucoup de reprises.
Comparaison de la sécurité et de la fiabilité
Aucun des deux modèles ne doit être qualifié de plus sûr uniquement à partir de benchmarks de capacité. Une comparaison défendable nécessite des prompts, outils, permissions, niveaux d’effort, limites de relance et critères d’acceptation appariés. Une plus grande capacité peut réduire les erreurs accidentelles, mais une autonomie accrue et des exécutions plus longues augmentent aussi l’impact d’un mauvais plan, d’une injection de prompt, d’un appel d’outil non sûr ou d’une dérive non détectée.
| Dimension de sécurité | Comparaison pratique | Contrôle en production |
|---|---|---|
| Reasoning and effort | Opus 5.5 expose plusieurs niveaux d’effort, tandis que Fable 5.1 démarre avec une posture d’effort plus élevée. Davantage de raisonnement ne remplace pas l’application des politiques. | Fixez la politique d’effort par workload et retestez le comportement de sécurité à chaque changement. |
| Long-running autonomy | Fable 5.1 est positionné pour des travaux difficiles et non supervisés ; Opus 5.5 prend aussi en charge des workflows agentiques. Le risque croît avec la durée, les permissions et le nombre d’actions irréversibles. | Utilisez des checkpoints, des portes d’approbation, des plafonds de temps et de coût, et des conditions d’annulation ou de rollback automatiques. |
| Tool and computer use | Les deux modèles peuvent utiliser des outils ; le seul choix du modèle ne contrôle donc pas l’exposition des données ou les actions destructrices. | Appliquez le moindre privilège, des listes d’autorisation, des bacs à sable, l’isolation des secrets et des confirmations avant les actions externes ou irréversibles. |
| Evaluation and auditability | Les scores de benchmarks publics n’établissent pas la qualité des refus, la résistance à l’injection de prompts ni les taux d’incidents en production. | Journalisez les appels d’outils et les décisions de politique ; mesurez le taux d’obéissance non sûre, les faux refus, la réussite des injections, les fuites de secrets et la qualité de la récupération. |
Règle de sécurité pratique : commencez avec la configuration Opus 5.5 la moins privilégiée qui satisfait la tâche, et n’escaladez vers Fable 5.1 qu’après le passage de la même suite de sécurité. Pour les workflows à fort impact, exigez une approbation humaine quel que soit le modèle qui obtient un score de capacité plus élevé.
- Exécutez des tests adversariaux d’injection de prompts et d’exfiltration de données avec l’ensemble d’outils de production réel.
- Séparez les permissions de lecture, écriture, publication, suppression et financières au lieu d’accorder un large rôle unique.
- Définissez des déclencheurs de rollback pour les violations de politique, les échecs d’outils répétés, l’expansion de périmètre inattendue et les dépassements de coûts.
- Revalidez après toute modification du modèle, du prompt système, du niveau d’effort, des outils, des permissions ou du routage.
Comment choisir entre Opus 5.5 et Fable 5.1
| Workload | Point de départ recommandé | Condition d’escalade |
|---|---|---|
| Daily coding and code review | Opus 5.5, medium effort | N’escalader que pour les cas inhabituellement difficiles ou risqués |
| Multi-file feature work | Opus 5.5, medium ou high | Utilisez Fable quand les échecs répétés de planification dominent le coût |
| Repository-wide migration | Testez Opus 5.5 en high ou xhigh d’abord | Escaladez pour les projets non supervisés les plus difficiles |
| Overnight autonomous runs | Opus 5.5 avec des checkpoints stricts | Préférez Fable lorsque le coût d’une mauvaise direction est extrême |
| High-volume API traffic | Opus 5.5 | N’escaladez que la minorité de tâches sujettes à l’échec |
| Existing validated Fable deployment | Conservez le déploiement actuel durant les tests | Basculez seulement après qu’Opus ait atteint les mêmes seuils d’acceptation |
Un test pratique en production
Exécutez les mêmes tâches représentatives, prompts, outils, politique d’effort, critères d’acceptation et limites de relance sur les deux modèles. Enregistrez le taux de tâches acceptées, la latence, l’entrée fraîche et mise en cache, les tokens de sortie et de réflexion, les appels d’outils, les relances, les corrections humaines et le coût total par résultat accepté. Incluez des tâches routinières et des cas d’échec difficiles.
Conseils de migration pour les utilisateurs actuels de Claude Opus 5
Les utilisateurs d’Opus 5 doivent tester Opus 5.5 comme successeur plutôt que de supposer qu’un simple échange d’ID de modèle est sans risque. Comparez la profondeur de planification, les schémas d’appels d’outils, la longueur des réponses, la conformité de format, la latence, le comportement du cache de prompt, la récupération après des appels d’outil échoués, le routage de sécurité et le coût par tâche terminée. Conservez des critères de rollback et le modèle existant jusqu’à ce qu’Opus 5.5 franchisse des tests d’acceptation de type production.
Les utilisateurs actuels de Fable 5.1 n’ont pas besoin d’une section de migration générique. Ils doivent plutôt traiter Opus 5.5 comme une optimisation candidate et l’évaluer selon les mêmes critères d’acceptation en production avant de modifier un déploiement validé.
Accès via CometAPI
Les développeurs évaluant l’un ou l’autre modèle peuvent consulter les guides associés de CometAPI pour Claude Opus 5.5 et Claude Fable 5.1. Lors de l’intégration via tout fournisseur d’API compatible, confirmez l’ID exact du modèle, les paramètres d’effort pris en charge, le comportement du cache, les limites de débit, la disponibilité régionale et le prix actuel avant le déploiement en production.
Utilisez claude-opus-5-5 pour Opus 5.5 et claude-fable-5-1 pour Fable 5.1 lorsque ces identifiants sont pris en charge. Évitez de router silencieusement les deux classes de workload via un seul niveau d’effort fixe ; la sélection du modèle et la politique d’effort doivent être configurées indépendamment.
Python — API Messages d’Anthropic via CometAPI
import os
import anthropic

client = anthropic.Anthropic(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com",)

message = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=2048,
    messages=[{"role": "user","content": ("Analysez cette base de code et proposez un plan de migration sûr."),}],)print(message.content[0].text)
Conclusion
Claude Opus 5.5 modifie la frontière pratique entre le modèle de pointe quotidien d’Anthropic et son niveau premium d’escalade. Il est sensiblement moins cher aux tarifs standard par token, arrive en tête de nombreux benchmarks de code et d’agents publiés, et offre suffisamment de flexibilité d’effort pour couvrir un large éventail de productions.
Claude Fable 5.1 reste pertinent lorsque la tâche est difficile, de grande valeur, longue ou non supervisée et que le coût d’un échec dépasse la facture d’inférence plus élevée. Pour la plupart des équipes, la meilleure politique est de commencer avec Opus 5.5, de mesurer les résultats par tâche terminée et d’escalader sélectivement.
FAQ
Comment les équipes doivent-elles concevoir un test A/B en production pour Opus 5.5 et Fable 5.1 ?
Utilisez les mêmes tâches représentatives, prompts, outils, politique d’effort, critères d’acceptation et limites de relance pour les deux modèles. Enregistrez le taux de tâches acceptées, la latence, l’entrée fraîche et mise en cache, les tokens de sortie et de réflexion, les appels d’outils, les relances, les corrections humaines et le coût total par résultat accepté. Exécutez suffisamment de tâches pour couvrir le travail routinier ainsi que des cas d’échec difficiles.
Quand des tarifs plus bas par token peuvent-ils ne pas réduire le coût par tâche ?
Un modèle moins cher peut quand même coûter plus cher s’il nécessite plus de tours, relit davantage de contexte, produit davantage de tokens de réflexion ou nécessite des relances répétées. Le comportement du cache compte aussi : l’écart de prix d’entrée se réduit dans les longues sessions dominées par les lectures de cache. Comparez le coût par tâche terminée plutôt que le prix de liste seul.
Que faut-il documenter lorsque des résultats de benchmark sont en désaccord ?
Enregistrez la version du modèle, le niveau d’effort, le harnais, les paramètres de repli et de sécurité, le nombre d’essais, la version des tâches, l’erreur standard et le plafond de coût. Étiquetez chaque résultat comme officiel ou indépendant et évitez de combiner des scores provenant de configurations non appariées dans un seul classement.
Quels risques de migration les utilisateurs actuels de Fable 5.1 doivent-ils surveiller ?
Surveillez les changements de profondeur de planification, de schémas d’appels d’outils, de longueur des réponses, de conformité de format, de latence, de comportement du cache de prompt, de récupération après échecs d’outils et de routage de sécurité. Conservez le déploiement existant durant l’évaluation, établissez des critères de rollback et ne migrez qu’après qu’Opus 5.5 a atteint les mêmes seuils d’acceptation sur des tâches similaires à la production.
SEO Metadata
Meta title: Claude Opus 5.5 vs Fable 5.1 : code, coûts et benchmarks
Meta description: Comparez Claude Opus 5.5 et Claude Fable 5.1 sur les benchmarks de code, les tarifs API, la vitesse, le cache, les niveaux d’effort, le coût par tâche terminée et l’adéquation au workload.
Keywords: Claude Opus 5.5 vs Claude Fable 5.1, Claude Opus 5.5, Claude Fable 5.1, benchmarks de code Claude, tarification de l’API Claude, CometAPI, modèles d’IA pour le code
URL slug: claude-opus-5-5-vs-claude-fable-5-1