
TL;DR
Claude Fable 5.1 présente de meilleurs résultats de référence pour le codage autonome difficile et le travail à long horizon. GPT-5.6 Sol offre des coûts de jetons ordinaires plus faibles, un vaste ensemble d’outils natifs et un délai plus court jusqu’au premier jeton dans la comparaison indépendante à effort maximal. Le bon défaut dépend du coût d’un échec de tâche, pas seulement du score de benchmark le plus élevé.
Dans l’instantané de l’Intelligence Index du 8 septembre 2026, Fable 5.1 obtient 53, contre 47 pour GPT-5.6 Sol. Le débit de sortie est pratiquement à égalité à 69.9 contre 69.8 jetons/s. Ces résultats appuient un choix qualité vs coût ; ils n’établissent pas un vainqueur universel en vitesse.
Points clés
- Choisissez Fable 5.1 pour les tâches autonomes les plus difficiles lorsque vos propres évaluations justifient le prix plus élevé.
- Commencez avec GPT-5.6 Sol pour l’inférence de frontière sensible aux coûts et les applications qui bénéficient de ses outils intégrés.
- Comparez séparément le délai de démarrage et la vitesse de sortie : GPT-5.6 Sol a un temps jusqu’au premier jeton plus faible mesuré, tandis que le débit est presque égal.
- Modélisez séparément les écritures, lectures, rétention du cache et les tarifs long-contexte. Les prix d’entrée/sortie en gros titre ne décrivent pas toutes les charges de travail d’agent.
Données vérifiées le 8 septembre 2026. Les résultats indépendants utilisent GPT-5.6 Sol à effort maximal et Fable 5.1 avec Adaptive Reasoning, Max Effort, Default Fallback. Les benchmarks du fournisseur et les benchmarks indépendants utilisent des configurations d’évaluation différentes. Les prix sont en USD par million de jetons (MTok), sauf indication contraire.
GPT-5.6 Sol vs Fable 5.1 : verdict rapide
| Dimension | GPT-5.6 Sol | Claude Fable 5.1 | Meilleur choix |
|---|---|---|---|
| Independent Intelligence Index v4.3 (Sep 8) | 47 | 53 | Fable 5.1 |
| Independent Terminal-Bench 4.0 (Sep 7) | 39.9% | 52.0% | Fable 5.1 |
| Anthropic-run Terminal-Bench 4.0 | 37.3% | 55.8% | Fable 5.1 |
| Context window | 1.05M | 1M | Pratiquement à égalité |
| Maximum output | 128K | 128K | Égalité |
| Text/image input | Yes | Yes | Égalité |
| Official input price / MTok | $4 | $10 | Sol |
| Official output price / MTok | $20 | $50 | Sol |
| Official cache read / MTok | $0.40 | $0.25 | Fable 5.1 |
| Independent output speed (Sep 8) | 69.8 tok/s | 69.9 tok/s | Pratiquement à égalité |
| API tool breadth | Très large | Solide | Sol |
| Long-running autonomous work | Excellent | Force principale | Fable 5.1 |
| Cost-sensitive production | Meilleur défaut | Montée en gamme | Sol |
Une politique de départ utile est Sol pour le travail de frontière courant, avec Fable 5.1 comme voie d’escalade lorsqu’une tâche échoue à votre seuil de qualité ou d’autonomie. Validez cette politique par le coût par tâche réussie.
GPT-5.6 Sol expose six niveaux d’effort de raisonnement, de aucun à maximal, avec moyen par défaut. Fable 5.1 utilise une réflexion adaptative permanente ; l’effort contrôle la profondeur du raisonnement, et la valeur par défaut est élevée.
Les 50 000 jetons supplémentaires dans le contexte de GPT-5.6 Sol ne décideront probablement pas la plupart des architectures. La facturation et la réutilisation du cache deviennent plus conséquentes à l’approche du million de jetons ; la section long-contexte ci-dessous explique pourquoi.
Qu’est-ce que GPT-5.6 Sol ?
GPT-5.6 Sol est un niveau haute capacité de la famille GPT-5.6 d’OpenAI pour le codage exigeant, la recherche, la planification et les flux d’agents. Son principal attrait dans cette comparaison est la combinaison de contrôles de raisonnement et de l’environnement d’exécution environnant.
Via la Responses API, GPT-5.6 Sol prend en charge un vaste portefeuille d’outils natifs : web search, file search, code interpreter, hosted shell, apply patch, computer use, MCP, skills et tool search. Cela peut réduire le nombre de composants d’exécution séparés qu’une application doit intégrer.
OpenAI décrit également l’appel programmatique d’outils et l’exécution multi-agents pour la famille. Ces fonctionnalités de plateforme comptent lorsqu’un modèle doit coordonner le travail à travers des outils plutôt que de renvoyer une seule réponse.
Qu’est-ce que Claude Fable 5.1 ?
Claude Fable 5.1 vise le codage exigeant, le travail de connaissance professionnel, la recherche et les agents de longue durée. Ses résultats de benchmark directs en font un solide candidat pour les tâches où la récupération, la persistance et l’achèvement réussi comptent plus qu’une réponse courte.
Anthropic met l’accent sur l’exécution autonome soutenue à travers les applications, incluant la planification, la récupération après étapes échouées et la communication d’avancement. Considérez ce positionnement comme une raison de tester des tâches plus longues, pas comme une garantie que chaque flux de travail se terminera correctement.
Fable 5.1 diffère aussi de GPT-5.6 Sol dans le comportement d’API : ses restrictions de choix d’outil imposé comptent pour les flux nécessitant que le modèle appelle un outil spécifique. Vérifiez les modes tool_choice pris en charge lors de la migration d’une boucle d’agent déterministe.
La question d’intégration est donc pratique : votre application peut-elle tolérer une boucle de raisonnement plus autonome, ou nécessite-t-elle un contrôle plus fin de chaque étape ? Testez le comportement exact des outils avant de choisir une voie.
Comparaison des benchmarks : Fable 5.1 dispose de preuves directes plus solides
Les comparaisons de benchmarks entre fournisseurs concurrents sont faciles à mésinterpréter. Les évaluations de lancement initiales de GPT-5.6 par OpenAI sont antérieures à Fable 5.1, tandis que la sortie de Fable 5.1 par Anthropic contient des comparaisons directes plus récentes avec GPT-5.6 Sol.
La lecture la plus claire des preuves se fait donc en trois couches : la comparaison directe d’Anthropic, les tests indépendants actuels, et le profil de capacité de GPT-5.6 Sol selon OpenAI.
Résultats directs d’Anthropic : Fable 5.1 vs GPT-5.6 Sol
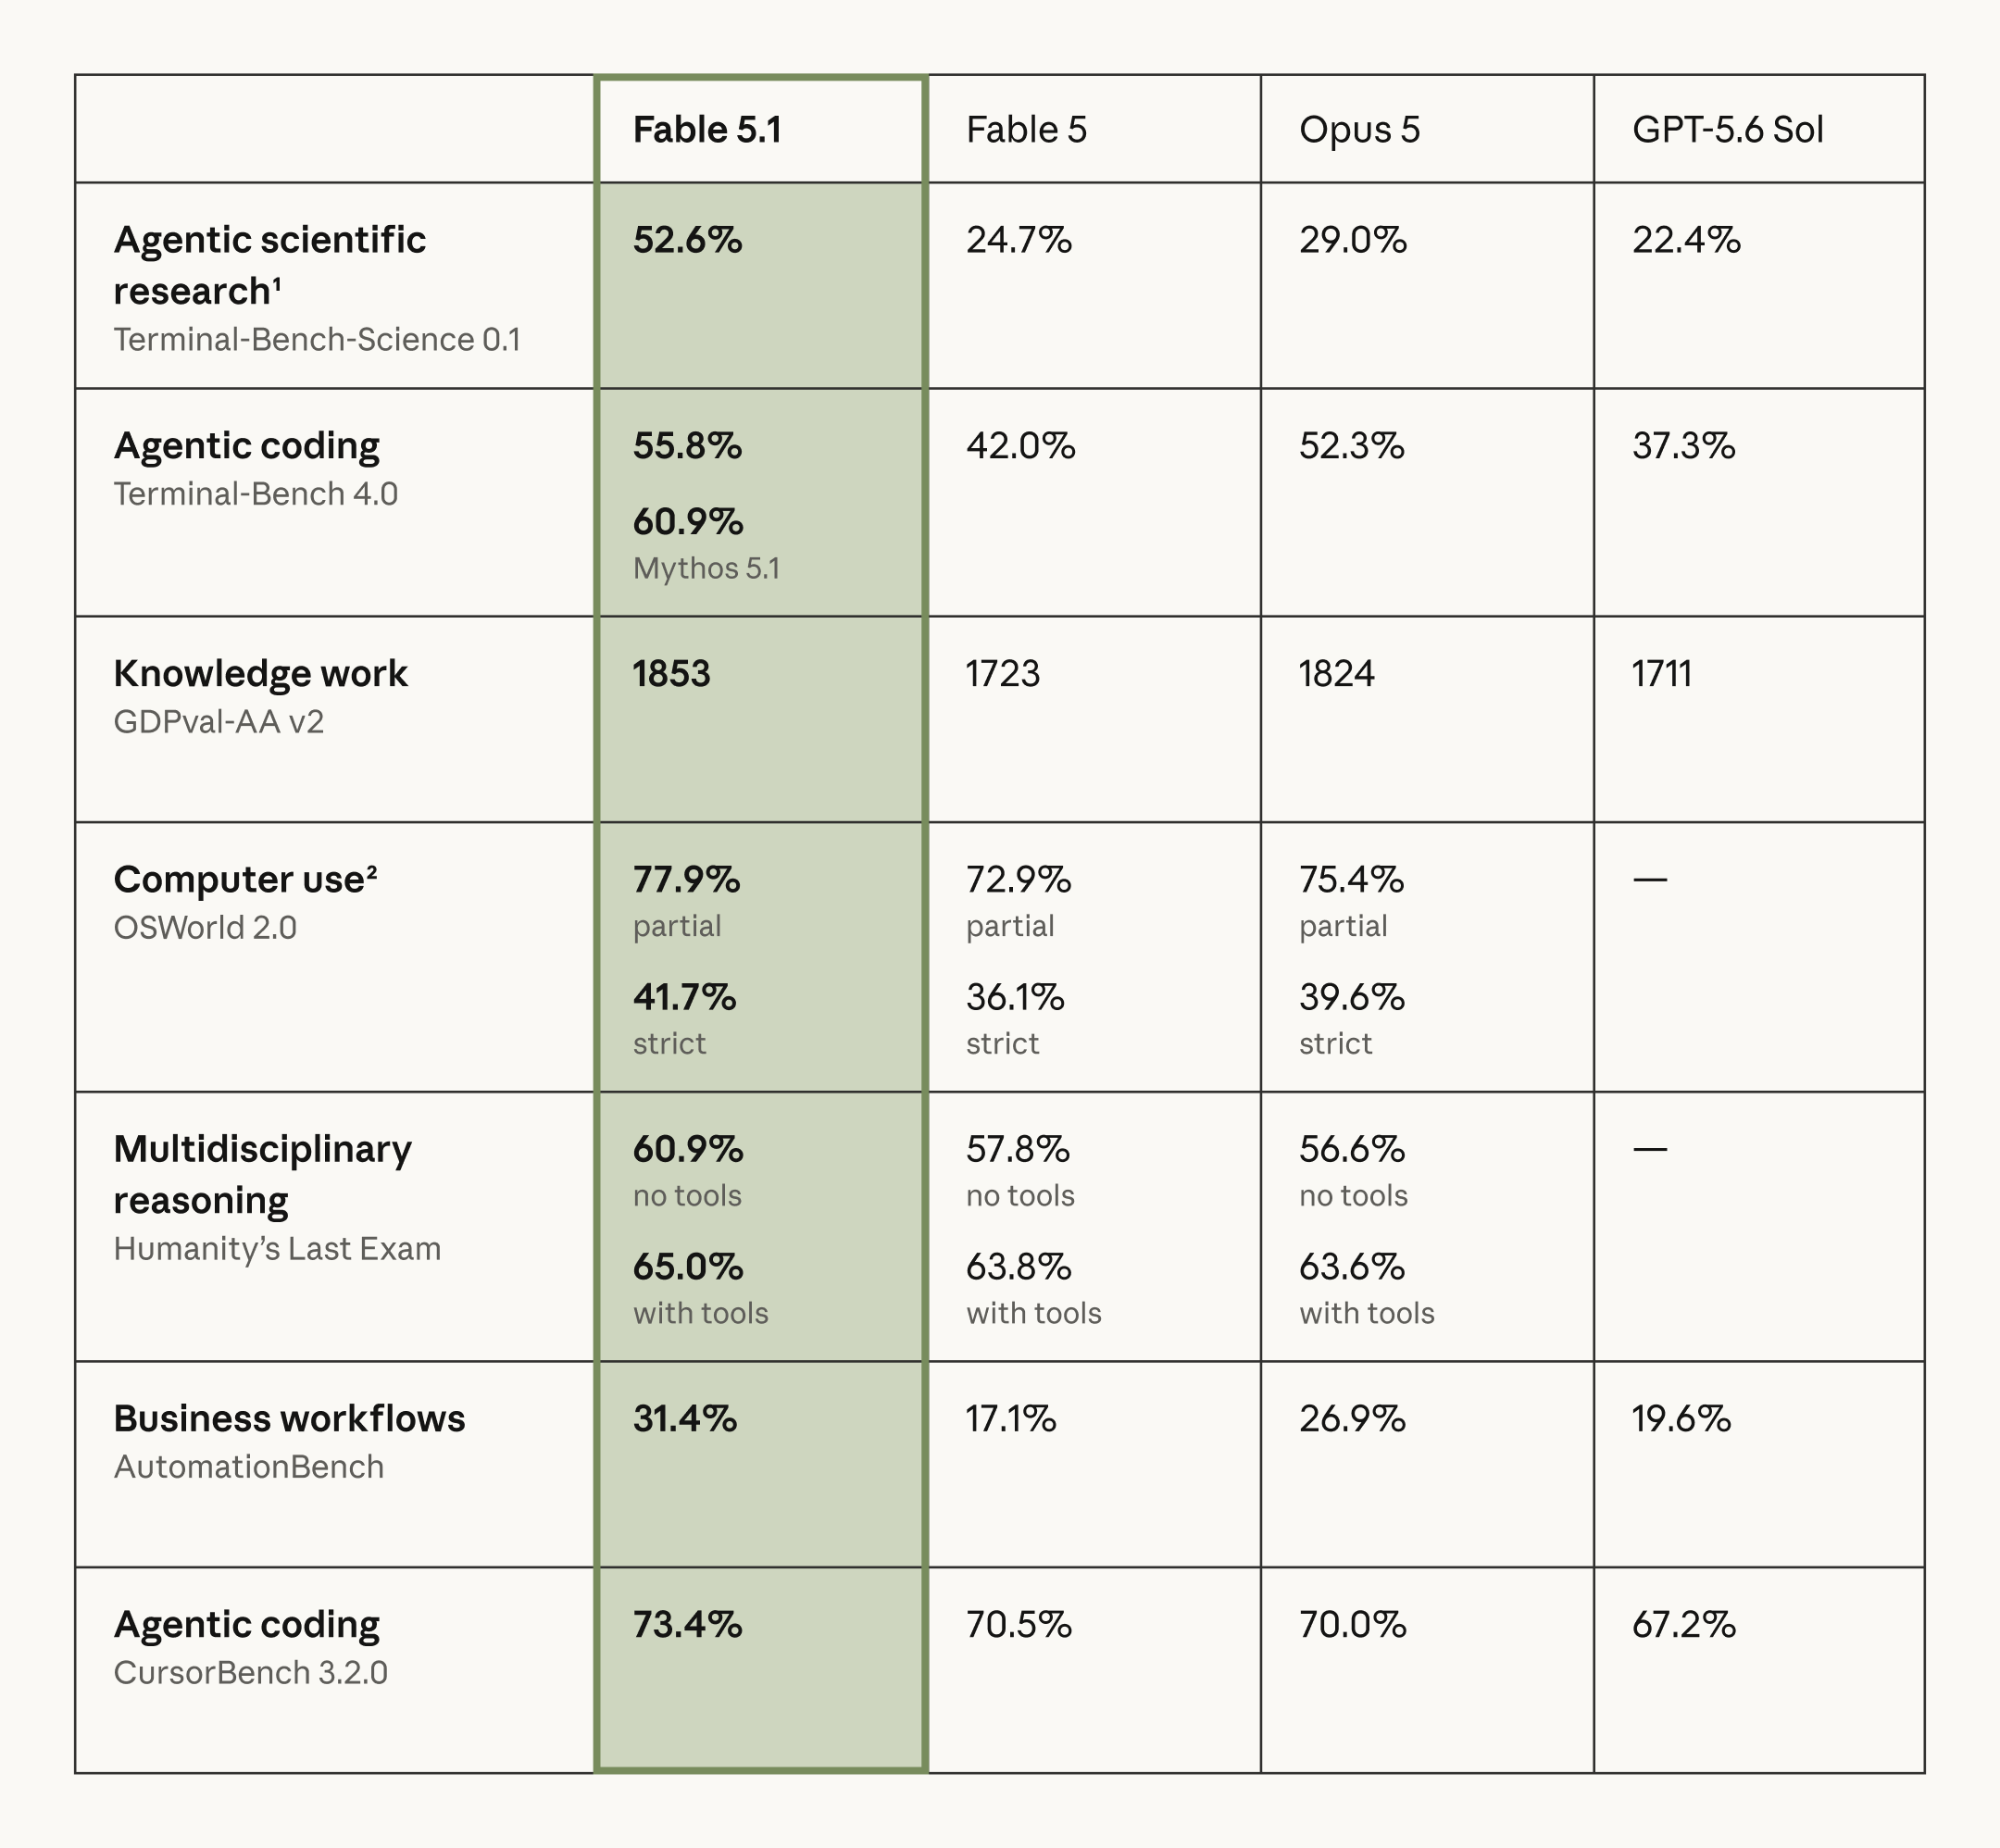
Les résultats officiels de benchmark incluent cinq tâches avec des scores rapportés pour les deux modèles. Les différences en points de pourcentage et en Elo ci-dessous sont calculées à partir de ces valeurs publiées.
| Benchmark | GPT-5.6 Sol | Claude Fable 5.1 | Avantage Fable 5.1 |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 22.4% | 52.6% | +30.2 pts |
| Terminal-Bench 4.0 | 37.3% | 55.8% | +18.5 pts |
| GDPval-AA v2 | 1711 Elo | 1853 Elo | +142 Elo |
| AutomationBench | 19.6% | 31.4% | +11.8 pts |
| CursorBench 3.2.0 | 67.2% | 73.4% | +6.2 pts |
Le résultat est inhabituellement cohérent : Fable 5.1 devance GPT-5.6 Sol dans chaque ligne directe publiée par Anthropic. Les plus grands écarts apparaissent dans la recherche scientifique agentique et le codage basé sur terminal plutôt que dans le raisonnement court ordinaire.
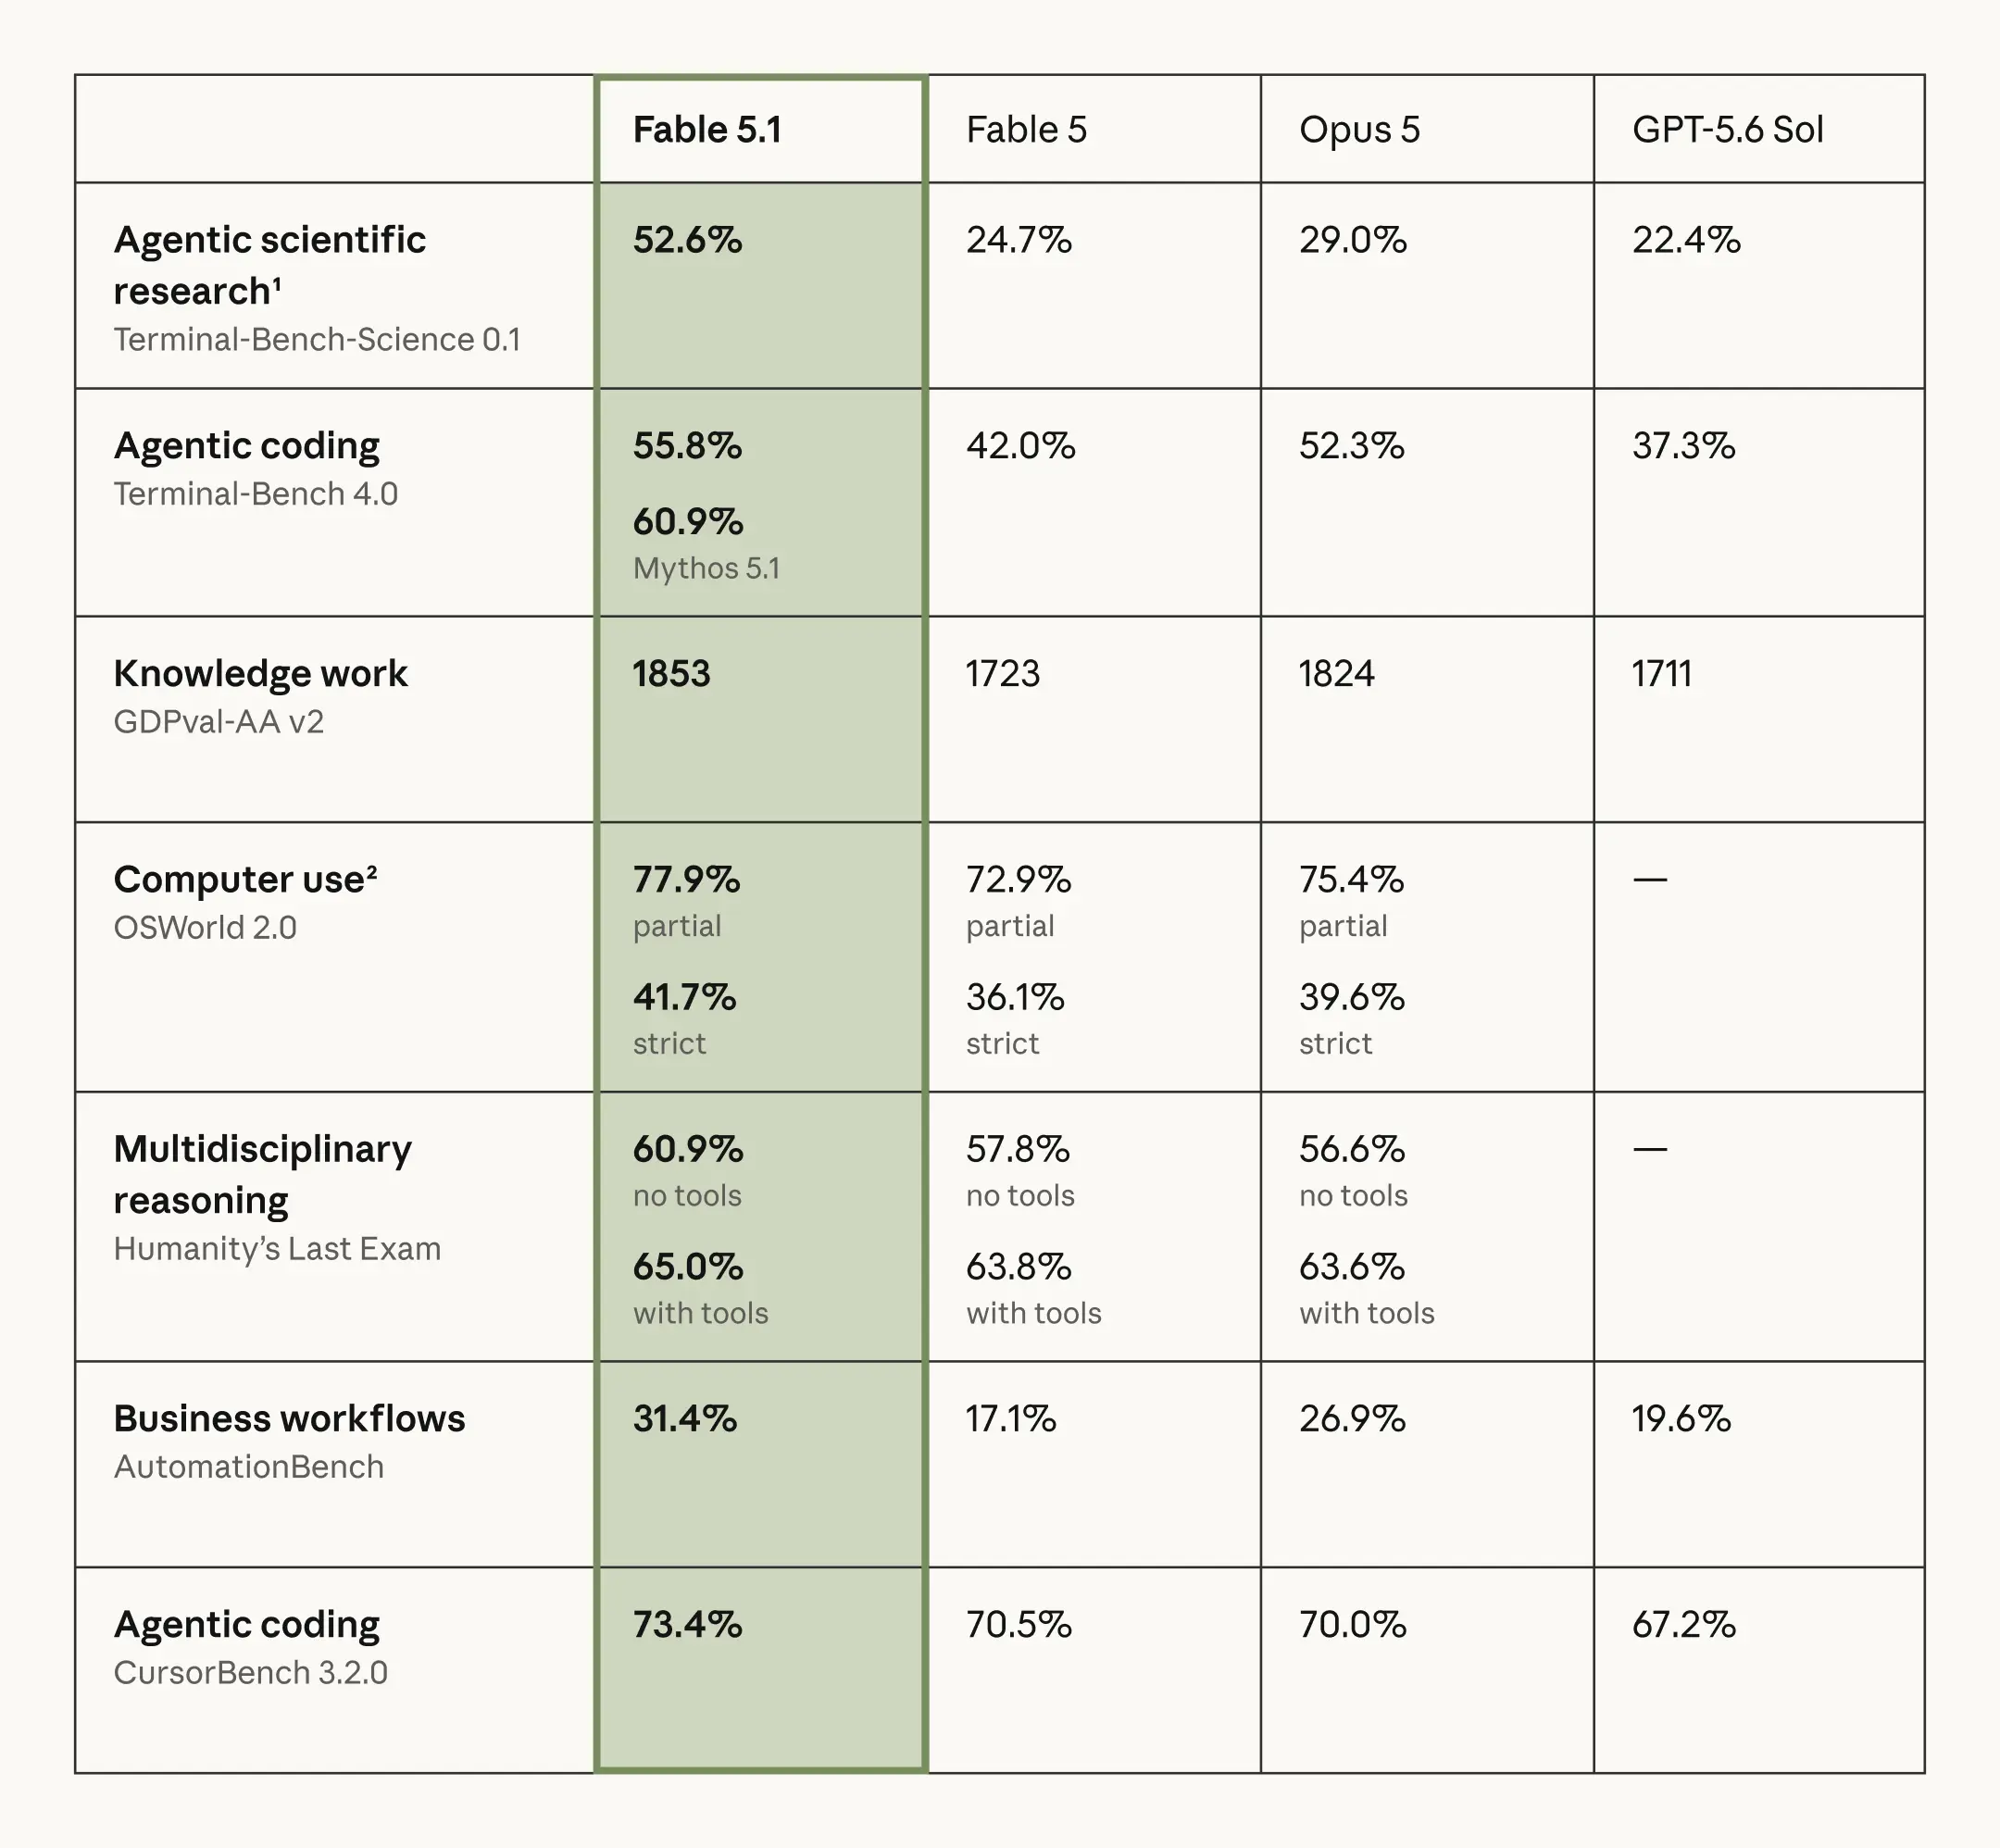
Source : Anthropic — graphique de benchmark original.
Il s’agit d’évaluations menées par le fournisseur : Anthropic a testé à la fois son modèle et le modèle concurrent. Elles fournissent des preuves comparatives directes, mais ce ne sont pas des tests indépendants. Anthropic rapporte une erreur standard de ±3.5–4.5 points de pourcentage par modèle sur Terminal-Bench-Science ; le tableau ci-dessus montre des estimations ponctuelles, pas des intervalles de confiance.
Les résultats du fournisseur favorisent Fable 5.1, mais les preuves indépendantes nécessitent leurs propres dates et configurations.
Benchmarks indépendants : séparer des résultats datés des mesures en direct
Artificial Analysis a introduit Intelligence Index v4.3 le 7 septembre, remplaçant Terminal-Bench 2.1 par Terminal-Bench 4.0 et ajoutant AutomationBench-AA. La publication a reporté 53 pour Fable 5.1 et 47 pour GPT-5.6 Sol, correspondant aux scores arrondis de la comparaison du 8 septembre. Le tableau distingue les résultats terminaux de la sortie du 7 septembre de l’instantané de performance ultérieur.
| Indicateur indépendant AA / publication v4.3 | GPT-5.6 Sol (max) | Claude Fable 5.1 (max) | Résultat |
|---|---|---|---|
| Intelligence Index v4.3 (Sep 8) | 47 | 53 | Fable |
| Terminal-Bench 4.0 (parution du 7 Sep) | 39.9% | 52.0% | Fable |
| OSWorld 2.0 | 62.6% | 41.7% | |
| Output speed (Sep 8) | 69.8 tok/s | 69.9 tok/s | Pratiquement à égalité |
| Time to first token (Sep 8) | 132.10 s | 277.47 s | Sol |
| AA normalized token-mix price / MTok | $3.08 | $7.175 | Sol |
Instantané : 8 septembre 2026, sauf la ligne Terminal-Bench du 7 septembre explicitement datée. Fable 5.1 utilise Adaptive Reasoning, Max Effort, Default Fallback ; Sol utilise max. Les mesures en direct peuvent changer. Le prix normalisé du mix de jetons d’AA utilise un ratio 7:2:1 cache hit/entrée/sortie ; ce n’est pas le coût de chaque requête API.
OSWorld 2.0 est l’avantage rapporté le plus important pour Sol dans cette comparaison : 62.6% contre 41.7% pour Fable 5.1, soit 20.9 points d’avance. Cela contrebalance les résultats plus forts de Fable sur l’Intelligence Index et Terminal-Bench.
Les preuves soutiennent un compromis spécifique : Fable 5.1 a l’Intelligence Index le plus élevé, tandis que Sol a un temps jusqu’au premier jeton plus bas et un prix normalisé plus faible. Le débit de sortie est pratiquement égal. Ces mesures soutiennent des choix différents pour le traitement par lots sensible à la qualité et les applications interactives.
La comparaison indépendante datée Terminal-Bench pointe dans la même direction que le test d’Anthropic : 52.0% contre 39.9%, comparé aux 55.8% contre 37.3% du fournisseur. Les deux écarts ne sont pas interchangeables car les configurations d’évaluation diffèrent.
Ce que les benchmarks d’OpenAI nous disent encore sur GPT-5.6 Sol
Les évaluations de lancement d’OpenAI fournissent un contexte supplémentaire sur les capacités de GPT-5.6 Sol. Elles sont antérieures aux nouvelles confrontations discutées ci-dessus, et ne doivent donc pas être utilisées comme comparaison directe avec Fable 5.1.
OpenAI rapporte 88.8% sur Terminal-Bench 2.1 pour GPT-5.6 Sol. C’est une preuve d’une forte capacité de codage agentique dans la configuration de lancement ; l’ancienne version du benchmark ne doit pas être comparée numériquement aux scores de Terminal-Bench 4.0.
GPT-5.6 Sol vs Fable 5.1 pour le codage
Pour la génération de code simple, chaque modèle est surqualifié pour de nombreuses charges de production. La séparation devient plus claire quand le codage se transforme en ingénierie logicielle agentique : inspection d’un grand dépôt, modification de plusieurs fichiers, exécution de commandes, diagnostic des échecs, écriture de tests et itération jusqu’à réussite.
Ici, Claude Fable 5.1 a l’argument de benchmark actuel le plus solide. Il mène à la fois les comparaisons Terminal-Bench 4.0 du fournisseur et indépendantes, et le résultat CursorBench d’Anthropic le favorise aussi 73.4% contre 67.2%.
Pour une évaluation de codage pratique, incluez des changements à l’échelle du dépôt, des tests, une revue et du travail de performance. Un court extrait de code réussi est un faible proxy pour achever une tâche qui s’étend sur plusieurs fichiers et tentatives échouées.
GPT-5.6 Sol reste convaincant lorsque l’environnement d’exécution environnant compte autant que la qualité brute du modèle. La prise en charge native de l’exécution shell, d’apply-patch, du code interpreter, de la recherche de fichiers, de computer use et de MCP peut réduire l’infrastructure d’orchestration que vous devez construire vous-même.
Verdict pour le codage : choisissez Fable 5.1 lorsque vos évaluations mettent l’accent sur le travail autonome le plus difficile sur dépôt. Choisissez GPT-5.6 Sol lorsque des performances de benchmark légèrement inférieures sont acceptables en échange d’un coût plus bas et d’un vaste stack d’exécution intégré.
Contrôles de raisonnement et expérience développeur
Les deux API exposent l’intelligence différemment.
La plage d’effort de raisonnement de Sol, de aucun à maximal, permet à une équipe de tester qualité et délai à plusieurs réglages. Un effort plus faible peut réduire le travail de raisonnement, mais le bon réglage dépend du coût d’un échec.
La réflexion adaptative permanente de Fable fait de l’ajustement d’effort un exercice différent. Comparez les réglages que votre application déploiera au lieu de traiter des étiquettes d’effort identiques comme des budgets de calcul identiques.
Il n’y a donc pas de comparaison universellement équitable entre un « Sol par défaut » et un « Fable par défaut ». Leurs configurations de raisonnement par défaut diffèrent. Les évaluations de production doivent comparer soit des budgets d’effort équivalents, soit les réglages exacts que votre application déploiera réellement.
GPT-5.6 Sol vs Fable 5.1 : lequel est meilleur pour les agents IA ?
Le choix dépend de savoir si le goulet d’étranglement est un raisonnement difficile ou l’environnement d’exécution qui l’entoure.
L’avance de Fable dans les benchmarks cités de terminal, d’automatisation et de travail professionnel en fait un candidat sensé pour les tâches les plus difficiles. Mesurez le taux d’achèvement et la récupération après étapes échouées avant de généraliser cette avance à votre agent.
Le portefeuille d’outils Responses documenté de GPT-5.6 Sol le rend attrayant pour les applications construites autour de la recherche, des fichiers, de l’exécution shell et des correctifs. C’est un avantage d’intégration à évaluer en parallèle de l’exactitude des tâches, pas un substitut.
| Exigence de l’agent | GPT-5.6 Sol | Claude Fable 5.1 |
|---|---|---|
| Raisonnement difficile à long horizon | Excellent | Meilleur choix |
| Autonomie terminale/dépôt | Excellent | Preuves plus fortes |
| Portefeuille d’outils natifs intégré | Plus fort | Fort |
| Sélection d’outil imposée | Pris en charge ; vérifier l’API choisie | Restreinte ; vérifier les modes tool_choice |
| Intégration plateforme multi-agents | Avantage fort | Disponible via l’architecture d’agent |
| Communication de progrès sur longues tâches | Bon | Comportement central |
| Agents volumétriques sensibles au coût | Meilleur | Premium |
| Réutilisation de contexte massif mis en cache | Bonne | Potentiellement très attractive |
L’utilisation des deux peut être économique lorsque seule une petite part des tâches nécessite une escalade. Mesurez si les achèvements supplémentaires compensent le prix plus élevé et le délai de démarrage du second modèle.
Long contexte : 1.05M vs 1M n’est pas la différence importante
Les chiffres en gros titres paraissent presque identiques : GPT-5.6 Sol offre 1.05M de jetons et Fable 1M. Un écart de capacité de 5% déterminera rarement votre capacité à analyser un grand dépôt, un corpus juridique, une archive de recherche ou un historique d’agent de plusieurs heures. Les deux sont déjà de classe million de jetons.
Pour GPT-5.6 Sol, une entrée au-dessus de 272K déclenche des tarifs long-contexte plus élevés pour la requête : $8/MTok en entrée, $0.80/MTok en lecture de cache, et $30/MTok en sortie. Les écritures de cache passent aussi de $5 à $10/MTok.
Fable 5.1 conserve ses tarifs standard pour 1M de contexte : $10/MTok en entrée, $50/MTok en sortie, et $0.25/MTok pour les lectures de cache. Il n’y a pas de supplément distinct au-dessus de 272K dans cette configuration documentée.
Considérez un tour avec 100K jetons d’entrée non mis en cache, 900K jetons en lecture de cache, et 20K jetons de sortie totaux facturés. GPT-5.6 Sol coûte 0.1 × $8 + 0.9 × $0.80 + 0.02 × $30 = $2.12. Fable 5.1 coûte 0.1 × $10 + 0.9 × $0.25 + 0.02 × $50 = $2.225.
Ce tour lourd en cache rapproche presque l’écart de prix parce que Fable a des lectures de cache moins chères. Le résultat dépend du mix de jetons de la charge de travail ; cela ne signifie pas que les deux modèles coûtent le même prix pour une session d’agent complète.
Hypothèses de coût : le préfixe de 900K jetons est déjà mis en cache, et les 100K d’entrée fraîche ne sont pas facturés comme une nouvelle écriture de cache. L’estimation exclut l’écriture initiale du cache et les frais d’outils. L’allocation de 20K de sortie inclut toute sortie facturée, incluant les jetons de raisonnement facturés le cas échéant.
Tarification : Sol gagne sur les charges de travail ordinaires, Fable gagne un indicateur de cache important
Aux tarifs vérifiés, Sol coûte $4 en entrée / $20 en sortie par MTok, avec $0.40 par lecture de cache. Fable 5.1 coûte $10 en entrée, $50 en sortie, et $0.25 par lecture de cache. Le tableau sépare les prix du fournisseur des tarifs via GPT-5.6 Sol API dans CometAPI et Claude Fable 5.1 API dans CometAPI.
| Composant de prix | Prix officiels GPT-5.6 Sol | Prix officiels Claude Fable 5.1 |
|---|---|---|
| Entrée officielle / MTok | $4.00 | $10.00 |
| Sortie officielle / MTok | $20.00 | $50.00 |
| Lecture officielle du cache / MTok | $0.40 | $0.25 |
| Écriture officielle du cache / MTok | $5.00 (30 minutes) | $12.50 (5 minutes) |
| Au-dessus de 272K d’entrée : entrée / lecture cache / écriture cache / sortie | $8 / $0.80 / $10 / $30 | Même tarifs de base documentés |
| Entrée CometAPI / MTok | $3.20 | $8.00 |
| Sortie CometAPI / MTok | $16.00 | $40.00 |
Les durées d’écriture du cache diffèrent : Sol utilise une période de rétention par défaut de 30 minutes, tandis que le tarif de Fable 5.1 indiqué est pour une écriture de 5 minutes. Vérifiez le comportement de création, d’actualisation et d’expiration du cache pour le fournisseur et la route que vous utilisez réellement.
Aux tarifs directs du fournisseur vérifiés, Fable 5.1 coûte 2.5× plus que Sol pour l’entrée non mise en cache ($10 vs $4/MTok) et la sortie ($50 vs $20/MTok). Considérez ces tarifs vérifiés comme une comparaison datée, car les promotions des fournisseurs et les prix des passerelles peuvent changer.
Une requête à court contexte avec 100K d’entrée et 10K de sortie totale facturée coûte environ $0.60 avec Sol ou $1.50 avec Fable aux tarifs directs du fournisseur. Aux tarifs CometAPI ci-dessus, le même mix coûte $0.48 ou $1.20. Ces exemples excluent les écritures de cache et les frais d’outils.
Le tarif de lecture de cache à court contexte de Fable est inférieur de 37.5% : ($0.40 − $0.25) ÷ $0.40. Cela peut compter pour les agents réutilisant un grand préfixe stable, mais l’économie totale dépend toujours de l’entrée fraîche, de la fréquence d’écriture et du volume de sortie.
Verdict tarification : Sol est le point de départ moins cher pour le trafic à contexte frais. Fable devient plus compétitif à mesure que la part de lectures de cache augmente ; comparez le coût de la session complète, y compris la création et l’actualisation du cache.
Vitesse et latence
Les tests à effort maximal peuvent passer un temps substantiel à raisonner avant le premier jeton visible.
Les mesures de débit et de latence du 8 septembre montrent 69.9 jetons/s en sortie pour Fable et 69.8 pour Sol. Le temps jusqu’au premier jeton est de 277.47 secondes contre 132.10 secondes. Le débit de sortie est pratiquement égal ; Sol commence à produire une sortie visible plus tôt dans cette configuration.
Ce sont des mesures de benchmark à effort maximal, pas une latence promise pour chaque appel API. La longueur du prompt, la configuration de raisonnement, la charge du fournisseur, les outils et l’état du cache peuvent changer le résultat. Le temps jusqu’au premier jeton et le temps de réponse complet sont des métriques différentes.
Pour le travail interactif, le délai de démarrage observé plus faible peut favoriser Sol. Pour la recherche asynchrone ou le travail sur dépôt de nuit, l’achèvement réussi peut importer davantage que l’attente du premier jeton. Évaluez les deux modèles aux réglages et à la concurrence que vous comptez déployer.
Les garde-fous sont une différence de production
Les deux modèles appliquent des garde-fous plus forts car leurs capacités s’étendent à des domaines sensibles de cybersécurité et de science, mais ils les implémentent différemment.
OpenAI décrit des protections et une surveillance en couches pour la famille GPT-5.6. Les applications dans des domaines sensibles doivent évaluer les garde-fous pertinents dans leur comportement de déploiement.
Les routages et conditions de rétention d’Anthropic décrivent le routage de certaines demandes sensibles de cybersécurité ou de biologie vers des modèles moins capables, sans facturer le tarif Fable pour ces requêtes reroutées. La période de rétention des données par défaut est de 30 jours, avec des exceptions pour les accords d’entreprise éligibles.
Pour le codage ordinaire et le travail de connaissance, ces différences peuvent ne jamais apparaître. Pour les produits de sécurité, les charges de travail réglementées ou les déploiements sensibles à la vie privée, elles appartiennent à la checklist d’évaluation aux côtés de la qualité des benchmarks et du prix.
Quel modèle devriez-vous choisir ?
La comparaison globale peut être réduite à la forme de la charge de travail.
| Charge de travail | GPT-5.6 Sol | Claude Fable 5.1 | Recommandation |
|---|---|---|---|
| Codage autonome difficile | Excellent | Benchmarks actuels plus forts | Fable 5.1 |
| Recherche à long horizon | Excellent | Force principale | Fable 5.1 |
| API de frontière à haut volume | Beaucoup moins cher | Cher | Sol |
| Assistant de codage interactif | Temps jusqu’au premier jeton max-effort plus faible | Temps jusqu’au premier jeton max-effort plus élevé | Tester les réglages déployés |
| Agent d’API riche en outils | Stack d’outils natifs plus large | Fort | Sol |
| Agent à contexte million de jetons mis en cache | Compétitif | Tarif de lecture de cache très bas | Tester les deux |
| Qualité de raisonnement maximale | Excellent | Avantage indépendant | Fable 5.1 |
| Coût par requête ordinaire | Avantage clair | Premium | Sol |
| Raisonnement image/document | Fort | Fort | Tester sur la charge |
| Pile OpenAI monofournisseur | Ajustement naturel | Nécessite migration/passerelle | Sol |
| Routage indépendant du modèle | Fort | Fort | Utiliser les deux via CometAPI |
Une politique de routage doit justifier sa complexité. Comparez une base à un seul modèle avec une politique Sol d’abord qui escalade les tâches difficiles vers Fable 5.1, et ne conservez le routeur que si cela améliore le coût par tâche réussie à la qualité requise.
Comment comparer GPT-5.6 Sol et Fable 5.1 via CometAPI
CometAPI intègre déjà GPT-5.6 Sol et Claude Fable 5.1. Accédez aux deux modèles avec leurs formats de requête natifs, envoyez le même ensemble d’évaluation et comparez les résultats renvoyés sous des réglages appariés.
Utilisez des requêtes au format natif pour chaque modèle et maintenez constants prompts, jeux de données, réglages d’effort, concurrence et règles de scoring. Répétez les exécutions ; une seule requête séquentielle par modèle ne suffit pas pour estimer de manière fiable la latence ou la qualité.
Pour une évaluation de production, utilisez un ensemble de prompts fixe, répétez les exécutions en ordre alterné, consignez le réglage d’effort, et mesurez la justesse, le taux de tests passés, la réussite des outils, les réessais, l’usage de jetons, le temps écoulé et le coût total par tâche réussie. Réglez chaque modèle séparément après la base commune.
Verdict final : GPT-5.6 Sol ou Claude Fable 5.1 ?
Fable 5.1 présente des preuves directes plus solides pour le codage autonome le plus difficile et le travail à long horizon. Il mène les cinq lignes de benchmark partagées du fournisseur et la comparaison terminale indépendante datée. Cela en fait un solide candidat d’escalade, sous réserve de validation sur vos propres tâches.
Sol a des prix de jetons ordinaires plus bas, des contrôles de raisonnement plus fins et un vaste stack d’outils natifs. Dans la configuration indépendante à effort maximal vérifiée, il a aussi un temps jusqu’au premier jeton plus faible ; le débit de sortie est pratiquement égal.
Priorisez Fable 5.1 lorsque les tâches autonomes les plus difficiles déterminent votre taux de réussite. Commencez avec Sol pour l’inférence de frontière soucieuse des coûts ou les applications riches en outils. Pour les charges interactives, testez les réglages d’effort déployés pour confirmer si son avantage de délai de démarrage observé persiste.
Choisissez un seul modèle lorsqu’il répond simplement à vos exigences. Ajoutez du routage lorsque les résultats d’évaluation montrent qu’alterner entre les deux améliore la qualité ou le coût par tâche réussie.
FAQ
Claude Fable 5.1 est-il meilleur que GPT-5.6 Sol ?
Il a un Intelligence Index indépendant plus élevé dans l’instantané du 8 septembre : 53, contre 47 pour Sol. Il mène aussi le test terminal indépendant daté. Cela soutient un avantage de qualité sur ces évaluations, pas l’affirmation qu’il est meilleur pour chaque charge de travail.
GPT-5.6 Sol est-il moins cher que Claude Fable 5.1 ?
Pour le trafic API ordinaire non mis en cache, oui : les tarifs directs vérifiés sont $4/$20 par MTok pour Sol et $10/$50 pour Fable 5.1. Les charges lourdes en cache peuvent réduire cet écart car le tarif de lecture de cache de Fable est plus bas. Incluez le comportement d’écriture et d’expiration dans l’estimation.
Quel modèle est meilleur pour le codage ?
Fable 5.1 a des preuves de benchmark plus fortes pour le codage autonome dans cette comparaison. Sol reste attractif pour les flux à moindre coût et ses outils d’exécution intégrés. Utilisez des tâches sur dépôt avec tests exécutables pour décider si l’écart de capacité mesuré importe pour votre application.
Quel modèle a la plus grande fenêtre de contexte ?
Sol mène techniquement à 1.05M contre 1M de jetons pour Fable 5.1, tandis que les deux autorisent jusqu’à 128K de sortie. En pratique, le seuil de tarification >272K de Sol et les lectures de cache bon marché de Fable sont généralement plus importants que l’écart de 50K de capacité.
Puis-je accéder aux deux modèles via CometAPI ?
Oui. La GPT-5.6 Sol API dans CometAPI et la Claude Fable 5.1 API dans CometAPI offrent un point de départ commun pour les évaluations texte. Vérifiez le raisonnement, la mise en cache et la prise en charge des outils spécifiques à la route avant d’étendre la base à un agent de production.