Caractéristiques techniques de GLM-5.3-Flash
| Spécification | GLM-5.3-Flash |
|---|---|
| Fournisseur | Z.ai (Zhipu AI) |
| Famille de modèles | GLM-5 |
| Type de modèle | Modèle Mixture-of-Experts nativement multimodal |
| Paramètres totaux | 320B |
| Paramètres actifs | 18B |
| Architecture | Attention hybride clairsemée + linéaire |
| Fenêtre de contexte | 1,048,576 tokens (1M) |
| Sortie maximale | 131,072 tokens |
| Modalités d’entrée | Texte, images, vidéo |
| Modalité de sortie | Texte |
| Raisonnement | Pris en charge |
| Vision | Pris en charge |
| Appel de fonctions | Pris en charge |
| Utilisation d’outils | Pris en charge |
| Recherche Web | Pris en charge via des intégrations d’API prises en charge |
| Poids ouverts | Oui |
| Licence | MIT |
| Publication | 26 août 2026 |
Z.ai décrit GLM-5.3-Flash comme le premier modèle nativement multimodal de la famille GLM-5. Il contient 320B de paramètres totaux mais n’active que 18B de paramètres par étape d’inférence. Le modèle introduit une architecture hybride combinant attention clairsemée et attention linéaire et utilise mHC pour améliorer l’efficacité de passage à l’échelle.
Qu’est-ce que GLM-5.3-Flash ?
GLM-5.3-Flash est le membre orienté efficacité de la génération GLM-5, conçu pour combiner un raisonnement de pointe et des capacités de codage agentique avec un coût d’inférence nettement inférieur.
Sa distinction la plus importante par rapport à un modèle « Flash » classique est que Flash ne signifie pas un petit modèle. GLM-5.3-Flash contient 320B de paramètres totaux, mais son architecture MoE n’active que 18B de paramètres par token. Cela permet à Z.ai de viser une computation d’inférence beaucoup plus faible tout en conservant un grand réservoir de paramètres pour la capacité du modèle.
C’est également le premier modèle GLM-5 avec une capacité multimodale native. Le modèle prend en charge des entrées visuelles en plus du texte et se positionne pour le codage, l’interaction avec le navigateur, la compréhension de documents, le codage visuel et les workflows agentiques.
Z.ai indique que GLM-5.3-Flash a été entraîné à partir d’un nouveau modèle de base plutôt que d’une simple version compressée de GLM-5.2. Son entraînement utilise un corpus de pré-entraînement multimodal de 30 billions de tokens, tandis que l’architecture a été repensée autour des capacités et de l’efficacité d’inférence.
Principales fonctionnalités de GLM-5.3-Flash
- 320B MoE avec 18B de paramètres actifs : GLM-5.3-Flash combine une très grande capacité totale en paramètres avec une empreinte de paramètres actifs relativement petite, ce qui rend le modèle beaucoup plus efficace à servir qu’un modèle dense de 320B.
- Compréhension multimodale native : contrairement aux modèles GLM-5 précédents, GLM-5.3-Flash traite nativement des entrées visuelles. Sa fiche modèle fournit des exemples de compréhension d’images et identifie le modèle comme multimodal.
- Contexte de 1M de tokens : le modèle est conçu pour des applications à long contexte impliquant de grands dépôts, des documents étendus, de longues trajectoires d’agents et des workflows multi-étapes complexes. Cloudflare et Vercel indiquent tous deux une fenêtre de contexte de 1,048,576 tokens.
- Attention hybride clairsemée + linéaire : GLM-5.3-Flash est le premier modèle GLM à combiner attention clairsemée et attention linéaire. Z.ai indique que cette architecture réduit les coûts de service à long contexte tout en préservant des capacités précises sur long contexte.
- Codage agentique et utilisation d’outils : le modèle est optimisé pour l’ingénierie logicielle, les tâches terminal, l’interaction avec le navigateur et les workflows pilotés par outils. Son score Terminal-Bench 2.1 rapporté est de 84.3.
- Déploiement à poids ouverts : les poids sous licence MIT peuvent être déployés avec Transformers, vLLM, SGLang, TokenSpeed et KTransformers, offrant aux développeurs des options d’auto-hébergement et d’optimisation de l’inférence.
Performances de référence de GLM-5.3-Flash
GLM-5.3-Flash présente un profil particulièrement solide sur les benchmarks de codage et agentiques.
| Benchmark | GLM-5.3-Flash | GLM-5.2 | Notes |
|---|---|---|---|
| Terminal-Bench 2.1 | 84.3 | 81.0 | Terminal / codage agentique |
| DeepSWE v1.1 | 63.4 | 46.2 | Ingénierie logicielle |
| AutomationBench | 48.8 | 26.2 | Automatisation de l’usage d’ordinateur |
| Toolathlon-Verified | 78.4 | 59.9 | Capacité d’utilisation d’outils |
| NL2Repo-Bench | 56.3 | 48.9 | Du langage naturel à un dépôt de code |
| Agent's Last Exam | 26.3 | 20.4 | Raisonnement agentique |
| Humanity's Last Exam | 55.3 | — | Avec outils |
| GDPval-AA v2 | 1773 Elo | 1504 Elo | Productivité / travail de connaissance |
| OfficeQA-Pro | 62.4 | — | Productivité multimodale |
| CharXiv RQ | 89.4 | — | Raisonnement multimodal |
La section d’évaluation officielle sur Hugging Face liste 84.3 sur Terminal-Bench 2.1, 63.4 sur DeepSWE et 55.3 sur HLE. Les documents de lancement de Z.ai rapportent des résultats supplémentaires, notamment AutomationBench, Toolathlon, NL2Repo et GDPval.
Independent Artificial Analysis attribue actuellement à GLM-5.3-Flash un Indice d’intelligence de 57, le plaçant à la 3e place parmi 108 modèles dans son ensemble de comparaison actuel.
Ces chiffres doivent néanmoins être interprétés avec les réserves propres aux benchmarks : plusieurs résultats sont rapportés par le fournisseur, les harnais d’évaluation diffèrent, et les scores de benchmark ne doivent pas être pris pour un classement universel de la qualité des modèles.
GLM-5.3-Flash vs GLM-5.3 vs GLM-5.2
| Fonctionnalité | GLM-5.3-Flash | GLM-5.3 | GLM-5.2 |
|---|---|---|---|
| Génération de modèle | GLM-5 | GLM-5 | GLM-5 |
| Positionnement | Modèle multimodal/agentique efficace | Modèle de raisonnement haut de gamme | Modèle de génération précédente |
| Vision native | Oui | Non | Dépend du modèle |
| Paramètres totaux | 320B | Configuration phare plus grande | Modèle à grande échelle |
| Paramètres actifs | 18B | — | — |
| Contexte | 1M | Déploiement classe 200K | Déploiement classe 200K |
| Attention hybride clairsemée/linéaire | Oui | Non | Non |
| Codage agentique | Excellent | Excellent | Fort |
| Poids ouverts | Oui | Dépend du déploiement | Dépend du déploiement |
| Principal avantage | Capacité par unité de compute d’inférence | Capacité de raisonnement GLM-5 maximale | Génération GLM mature et moins coûteuse |
La distinction clé est que GLM-5.3-Flash n’est pas simplement GLM-5.3 à plus petite taille. Z.ai indique qu’il part d’un nouveau modèle de base entraîné et introduit une architecture d’attention hybride repensée, mHC et un pré-entraînement multimodal.
GLM-5.3-Flash vs DeepSeek V4 Flash — Résumé de la comparaison
| Dimension | GLM-5.3-Flash (Z.ai / Zhipu) | DeepSeek V4 Flash (DeepSeek) | Avantage |
|---|---|---|---|
| Date de sortie | 26 août 2026 | Aperçu avril 2026 ; checkpoint majeur (0731) 31 juillet 2026 | — |
| Paramètres totaux / actifs | 320B / 18B | 284B / 13B | Légère avance GLM |
| Fenêtre de contexte | 1M tokens | 1M tokens | Égalité |
| Sortie max | ~131K tokens | Jusqu’à 384K tokens | DeepSeek |
| Modalités | Multimodal natif (entrée texte + image + vidéo) | Principalement texte (variantes vision expérimentales disponibles) | GLM |
| Points forts d’architecture | Attention clairsemée + linéaire hybride (~3× moins de compute d’attention, ~4.4× moins de KV cache vs GLM-5.3 complet) | Compressed Sparse Attention (CSA) + Heavily Compressed Attention (HCA) | Forces distinctes |
| Licence | MIT (poids sur Hugging Face) | MIT (poids disponibles) | Égalité |
| Tarification API standard ($ / 1M tokens) | Entrée $0.15 / Sortie $0.50 (entrée mise en cache ~$0.03) | Plage courante $0.14–$0.44 entrée / $0.28–$1.32 sortie (heures pleines/creuses variables) | GLM moins cher |
| Tarifs promotionnels de lancement | ~$0.075 entrée / $0.25 sortie (durée limitée, ~début sept. 2026) | Pas de promotion équivalente | GLM |
| Indice d’intelligence AA | 57 (rapporté par le fournisseur) | ~50 (mesure indépendante) | GLM |
| Terminal-Bench 2.1 | 84.3 | 82.7 | GLM |
| DeepSWE | 63.4 | 54.4 | GLM |
| SWE-bench Verified | Données indépendantes limitées pour l’instant | ~79% (résultats indépendants solides) | DeepSeek |
| Points forts clés | Prix plus bas, multimodal natif, en tête sur plusieurs scores agentiques/codage, long contexte efficace | Validation indépendante plus mature, excellente réputation en codage/agents, long contexte très efficace, écosystème solide | — |
| Points faibles clés | Sortie plus récente (certains scores encore rapportés par le fournisseur) ; vitesse moyenne | Multimodal plus faible ; tarification effective plus élevée sur de nombreuses routes | — |
| Idéal pour | Usage général, charges multimodales, projets sensibles au coût, capacités agentiques équilibrées | Agents de codage purs, raisonnement texte long contexte, scénarios nécessitant des benchmarks indépendants éprouvés | — |
Phrase résumée en une ligne :
À fin août 2026, GLM-5.3-Flash est actuellement en tête sur le prix, la capacité multimodale et plusieurs benchmarks chevauchants, offrant une meilleure valeur globale. DeepSeek V4 Flash reste un choix très fiable pour des agents axés sur le codage grâce à une validation indépendante plus solide et une grande efficacité sur long contexte. Testez les deux sur vos charges réelles avant de décider.
Cas d’usage de GLM-5.3-Flash
1. Ingénierie logicielle agentique
GLM-5.3-Flash est particulièrement bien adapté aux agents de codage qui doivent inspecter des dépôts, modifier plusieurs fichiers, exécuter des commandes terminal, lancer des tests et itérer sur l’implémentation.
Ses scores de 84.3 sur Terminal-Bench 2.1 et 63.4 sur DeepSWE montrent que l’ingénierie logicielle est l’un de ses domaines d’application les plus forts.
2. Codage visuel
Parce que GLM-5.3-Flash est nativement multimodal, les développeurs peuvent fournir des captures d’écran, des schémas et d’autres entrées visuelles en plus des instructions de codage. Cela est utile pour l’implémentation d’UI, le débogage visuel et les workflows de design-to-code.
3. Analyse de documents à long contexte
La fenêtre de contexte de 1M de tokens rend le modèle adapté aux ensembles de documentation technique volumineux, aux dépôts, aux rapports longs et aux historiques d’agents multi-étapes.
4. Agents de navigation et d’usage d’ordinateur
Les capacités d’utilisation d’outils et multimodales du modèle le rendent adapté aux workflows impliquant des navigateurs, des interfaces graphiques et des outils externes.
5. Travail de connaissance en entreprise
GLM-5.3-Flash peut traiter de grands volumes d’informations structurées et non structurées tout en utilisant des outils pour effectuer des tâches multi-étapes, ce qui le rend adapté à l’analyse de documents, à l’assistance à la recherche et à l’automatisation de workflows.
6. Infrastructure IA auto-hébergée
La licence MIT et les poids publiquement disponibles rendent GLM-5.3-Flash attractif pour les organisations qui nécessitent un contrôle sur le déploiement, le traitement des données et l’infrastructure d’inférence.
Paramètres de l’API GLM-5.3-Flash
| Parameter | Description |
|---|---|
| model | Identifiant de modèle spécifique au fournisseur |
| messages | Entrée de conversation structurée |
| prompt | Entrée de prompt unique sur les API prises en charge |
| max_tokens / max_completion_tokens | Limite de tokens de sortie |
| temperature | Contrôle l’aléatoire de l’échantillonnage |
| tools | Définitions d’outil/fonction |
| stream | Active la diffusion en flux |
| reasoning | Contrôle l’effort de raisonnement sur les passerelles prises en charge |
| Image content | Pris en charge |
| Function calling | Pris en charge |
| Context | Jusqu’à 1M de tokens |
Vercel AI Gateway documente actuellement un maximum de 131,000 tokens de sortie, les tokens de raisonnement étant comptés dans la limite de sortie.
Comment utiliser l’API GLM-5.3-Flash dans CometAPI
Étape 1 : Obtenir un accès API
Connectez-vous à cometAPI. Si vous n’êtes pas encore utilisateur, enregistrez-vous d’abord. Connectez-vous à votre console CometAPI. Obtenez la clé d’accès API de l’interface. Cliquez sur « Add Token » dans la section API token du centre personnel, obtenez la clé de jeton : sk-xxxxx et validez.
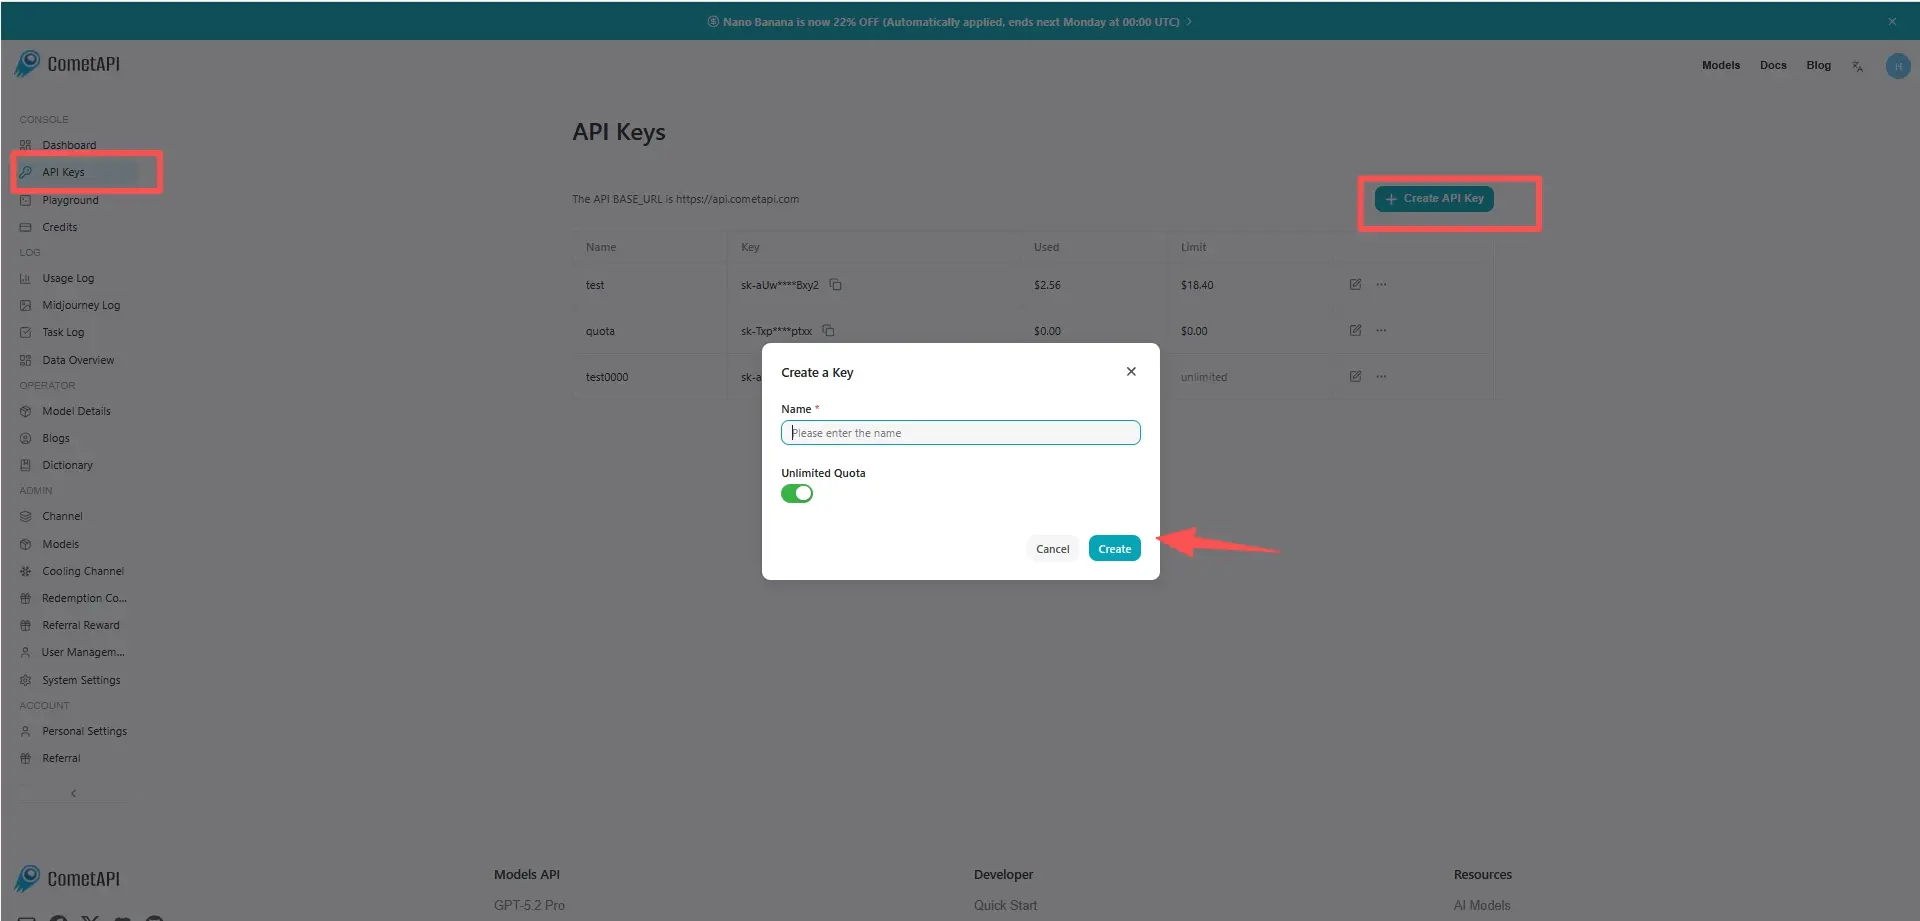
Étape 2 : Envoyer des requêtes à l’API GLM-5.3-Flash
Sélectionnez l’endpoint « GLM-5.3-Flash » pour envoyer la requête API et définissez le corps de la requête. La méthode et le corps de la requête sont disponibles dans la documentation API de notre site Web. Notre site fournit également un test Apifox pour votre commodité. Remplacez <YOUR_API_KEY> par votre clé CometAPI réelle issue de votre compte.
Insérez votre question ou demande dans le champ content — c’est ce à quoi le modèle répondra. Traitez la réponse API pour obtenir la réponse générée.
Étape 3 : Traiter les réponses
L’API renvoie des réponses candidates structurées comprenant du texte généré, des citations, des métadonnées de sécurité et des sorties d’outils optionnelles. Pour les requêtes multimodales, le contenu du message peut être structuré avec des entrées texte et image lorsque l’endpoint CometAPI sélectionné expose la capacité vision du modèle.
L’endpoint exact CometAPI, les paramètres pris en charge et la disponibilité actuelle doivent être pris depuis la documentation API en ligne de CometAPI plutôt que déduits de l’API native de Z.ai.
Pour CometAPI, l’intégration doit utiliser l’ID de modèle affiché sur l’endpoint modèle en ligne de CometAPI plutôt que de copier automatiquement des ID spécifiques au fournisseur issus de Z.ai, Cloudflare ou Vercel.
Limitations de GLM-5.3-Flash
- Empreinte de modèle importante : bien que seulement 18B de paramètres soient actifs, le modèle publié contient environ 321B de paramètres, rendant l’auto-hébergement nettement plus exigeant que le déploiement d’un modèle conventionnel de 7B–70B.
- La vitesse d’inférence n’est pas nécessairement « flash » en valeur absolue : Artificial Analysis mesure actuellement environ 50 tokens de sortie/seconde dans son environnement de comparaison, plaçant le modèle bien en dessous des petits modèles les plus rapides.
- Un très long contexte accroît les exigences d’infrastructure : une fenêtre de 1M de tokens est utile mais peut augmenter la mémoire et la complexité de service.
- Les performances aux benchmarks varient selon la tâche : GLM-5.3-Flash est particulièrement fort sur les benchmarks de codage agentique et d’utilisation d’outils, mais aucun benchmark unique n’établit une supériorité universelle par rapport aux modèles propriétaires de pointe.
- Sortie multimodale limitée : la capacité multimodale native du modèle concerne principalement l’entrée ; sa sortie standard est du texte plutôt que des images ou de la vidéo générées.