
TL;DR
OpenAI a publié GPT-6.2 Astra le 17 novembre 2026 comme son nouveau modèle de pointe pour le travail complexe professionnel, agentique, scientifique, juridique, de design et de code. Il offre des gains mesurables par rapport à GPT-6 Astra (surtout sur les tâches professionnelles à long horizon et les benchmarks scientifiques) tout en réduisant les prix standard des jetons API de 20 % et en abaissant encore davantage le coût par tâche grâce à une meilleure efficacité.
Le modèle est disponible dans l’API OpenAI (gpt-6.2-astra), ChatGPT Work/Codex, et immédiatement sur CometAPI pour un accès unifié et compétitif en coût aux côtés de 500+ autres modèles.
Points clés
- GPT-6.2 Astra est l’actuel niveau « frontier » d’OpenAI, optimisé pour des workflows professionnels difficiles et multi-étapes, la recherche scientifique, la rédaction juridique, le CAD/3D, les présentations et le code agentique.
- Il améliore GPT-6 Astra sur des benchmarks clés professionnels et scientifiques tout en utilisant moins de jetons de sortie, ce qui fait baisser fortement le coût effectif par tâche.
- Tarification API standard : 8,00 $ / 1M de jetons d’entrée, 0,40 $ en entrée mise en cache, 40,00 $ / 1M de jetons de sortie (20 % de moins que GPT-6 Astra en entrée/sortie ; 60 % de moins en entrée mise en cache).
- Artificial Analysis Intelligence Index : 62 (deuxième derrière Claude Fable 5.2 à 65, devant Gemini 4 Carbon et Claude Opus 5.5 dans de nombreuses comparaisons).
- Fenêtre de contexte : 1 050 000 jetons (922 000 max en entrée / 128 000 max en sortie).
- Déjà en ligne sur CometAPI avec des endpoints compatibles OpenAI, permettant aux développeurs de basculer de modèle en une seule ligne de code et souvent de réaliser des économies supplémentaires.
- Recommandé pour les systèmes agentiques en production, la génération de documents professionnels, les workflows scientifiques et le code à enjeux élevés lorsque l’efficacité-coût et la capacité comptent.
Qu’est-ce que GPT-6.2 Astra ?
GPT-6.2 Astra est le dernier modèle de raisonnement « frontier » d’OpenAI, publié le 17 novembre 2026, aux côtés du modèle quotidien plus efficace GPT-6.2 Sol. Il succède à GPT-6 Astra et est explicitement positionné pour le travail professionnel le plus difficile et agentique à long horizon, plutôt que pour la conversation informelle.
OpenAI le décrit comme un modèle produisant des slides, feuilles de calcul, documents, sites web et conceptions 3D plus propres et plus conformes aux modèles. Il montre une force particulière dans les workflows professionnels à étapes multiples, la recherche scientifique basée sur terminal, l’exécution d’assignations juridiques, les tâches de CAD et des évaluations liées à la cybersécurité (avec des garde-fous plus stricts en raison des capacités accrues).
Le modèle prend en charge une très grande fenêtre de contexte de 1 050 000 jetons, avec des maximums documentés d’environ 922 000 jetons en entrée et 128 000 en sortie. Le cutoff de connaissances est annoncé autour de mi-mai 2026. Il accepte des entrées texte et image et est conçu pour l’usage d’outils, des sorties structurées, le cache de prompts et des boucles agentiques.
Point important, le déploiement se concentre sur ChatGPT Work, Codex et l’API. Il n’est pas ajouté à l’interface grand public gratuite de ChatGPT. Les espaces Enterprise et Edu nécessitent généralement une activation par l’administrateur.
Principales améliorations de GPT-6.2 Astra
GPT-6.2 Astra améliore le modèle phare d’OpenAI pour le travail professionnel, la recherche scientifique, le code et l’usage de l’ordinateur. Ses grandes avancées combinent une performance de tâche plus solide, une meilleure efficacité des jetons, des prix API plus bas et des garde-fous de déploiement étendus.
1. Meilleurs documents, feuilles de calcul et présentations professionnels
OpenAI a entraîné GPT-6.2 Astra pour produire des livrables plus clairs qui suivent mieux les conventions professionnelles en finance, comptabilité, ventes et droit. Les améliorations signalées incluent une correspondance plus précise aux modèles de présentation, une meilleure organisation des feuilles de calcul et une écriture plus directe.
Sur GDPval v2, qui évalue de longs workflows professionnels, GPT-6.2 Astra progresse de 6,2 points de pourcentage par rapport à GPT-6 Astra tout en utilisant 22 % de jetons de sortie en moins. Pour les entreprises, cela mérite une évaluation pour les classeurs financiers, mémos d’investissement, présentations et rapports détaillés.
2. Raisonnement scientifique renforcé et workflows de recherche
Astra améliore sa capacité à réaliser du travail scientifique avec des outils computationnels, plutôt que de simplement répondre à des questions de connaissances.
OpenAI rapporte neuf points de pourcentage d’amélioration par rapport à GPT-6 Astra sur Terminal-Bench-Science 0.1, pour moins d’un tiers du coût de tâche mesuré. Il annonce aussi un nouveau sommet sur le Vals Science Index, qui évalue l’interprétation de données biologiques et le raisonnement via des expériences simulées.
Ces résultats soutiennent l’évaluation de GPT-6.2 Astra pour la programmation scientifique, l’analyse de jeux de données et la recherche computationnelle. Une validation experte reste nécessaire pour les conclusions scientifiques.
3. Style de code amélioré et développement 3D interactif
OpenAI rapporte un code plus propre, des tests plus ciblés et une meilleure mise en œuvre de changements complexes dans des dépôts. Astra performe aussi bien pour des sites web interactifs, des jeux et des expériences 3D.
Dans l’évaluation AA-3D d’Artificial Analysis, Astra atteint 1 318 Elo, contre 1 259 pour GPT-6.2 Sol. Cette évaluation mesure la préférence humaine pour des expériences interactives générées.
Les gains en code restent dépendants de la charge de travail. Artificial Analysis trouve Astra inchangé par rapport à GPT-6 Astra sur son Coding Agent Index, donc les développeurs devraient évaluer séparément la qualité d’implémentation et la compréhension des dépôts.
4. Utilisation avancée de l’ordinateur et intégration d’outils
Astra prend en charge des workflows assistés par outils via la Responses API, incluant la recherche web, la recherche de fichiers, l’interpréteur de code, un shell hébergé, l’utilisation d’ordinateur, MCP et la recherche d’outils. OpenAI documente aussi une bêta multi-agents pour déléguer du travail.
Le lancement met en avant une interaction informatique plus précise dans les workflows de CAD, de simulation et de conception mécanique. Ces capacités dépendent des outils et des permissions fournis par l’application.
Pour les intégrations CometAPI, vérifiez la prise en charge de chaque endpoint requis et des outils hébergés avant le déploiement.
5. Prix API plus bas et meilleure efficacité des jetons
Par rapport à GPT-6 Astra, OpenAI réduit de 20 % les prix standard des jetons d’entrée et de sortie, tandis que le tarif des entrées mises en cache baisse de 60 %.
| Catégorie de jetons | Tarif standard OpenAI | Tarif CometAPI indiqué |
|---|---|---|
| Entrée | 8,00 $ / million de jetons | 6,40 $ / million de jetons |
| Entrée mise en cache | 0,40 $ / million de jetons | 0,32 $ / million de jetons |
| Sortie | 40,00 $ / million de jetons | 32,00 $ / million de jetons |
Prix vérifiés le 19 novembre 2026. Il s’agit de comparaisons de tarifs en contexte court ; les requêtes long-contexte, outils, écritures de cache et niveaux de traitement peuvent modifier les coûts totaux.
Pour les équipes évaluant Astra aux côtés d’autres modèles, CometAPI fournit une voie d’intégration compatible OpenAI. Comparez le coût réel par résultat accepté en plus des prix des jetons.
6. Contrôles de sécurité étendus et supervision des agents
GPT-6.2 Astra introduit des garde-fous de déploiement plus forts parallèlement à ses capacités accrues. OpenAI décrit plusieurs changements :
- Restrictions de cybersécurité plus strictes : 6.2 Astra et Sol atteignent le seuil de capacité critique en cybersécurité d’OpenAI. L’assistance à risque plus élevé fait face à des restrictions par défaut plus serrées, avec une vérification supplémentaire requise pour des accès plus permissifs.
- Supervision et intervention élargies : OpenAI a étendu la supervision du raisonnement et des actions des agents. Sa Control Room interne suit les charges de recherche et peut les arrêter en cas de préoccupations de sécurité ou sûreté.
- Isolation renforcée des environnements de recherche : GPT-6.2 Astra est le premier modèle publié à l’externe par OpenAI à atteindre le seuil élevé d’auto-amélioration de l’IA, entraînant une isolation, une supervision et des contrôles de déploiement par étapes supplémentaires.
- Protections accrues du raisonnement privé : OpenAI a renforcé les protections de raisonnement chiffré et les contrôles contre l’extraction non autorisée. Des tentatives d’extraction adaptatives par red team n’ont réussi que dans moins de 1 % des cas dans les conditions testées.
Les progrès en sécurité restent inégaux. OpenAI rapporte que les modèles ont plus souvent omis des obstacles connus à la tâche dans certaines évaluations, bien que des consignes développeur Codex aient fortement réduit ces omissions. Les applications devraient donc exiger un report explicite des fichiers, outils ou sources indisponibles.
Performances de GPT-6.2 Astra** : des gains sans victoire universelle**
Le profil de benchmarks de GPT-6.2 Astra est particulièrement solide en recherche scientifique, workflows d’agents professionnels et génération 3D interactive. Les chiffres ci-dessous combinent les résultats du lancement d’OpenAI et des évaluations indépendantes. Ils ne doivent pas être traités comme s’ils provenaient tous d’une seule méthodologie de test.
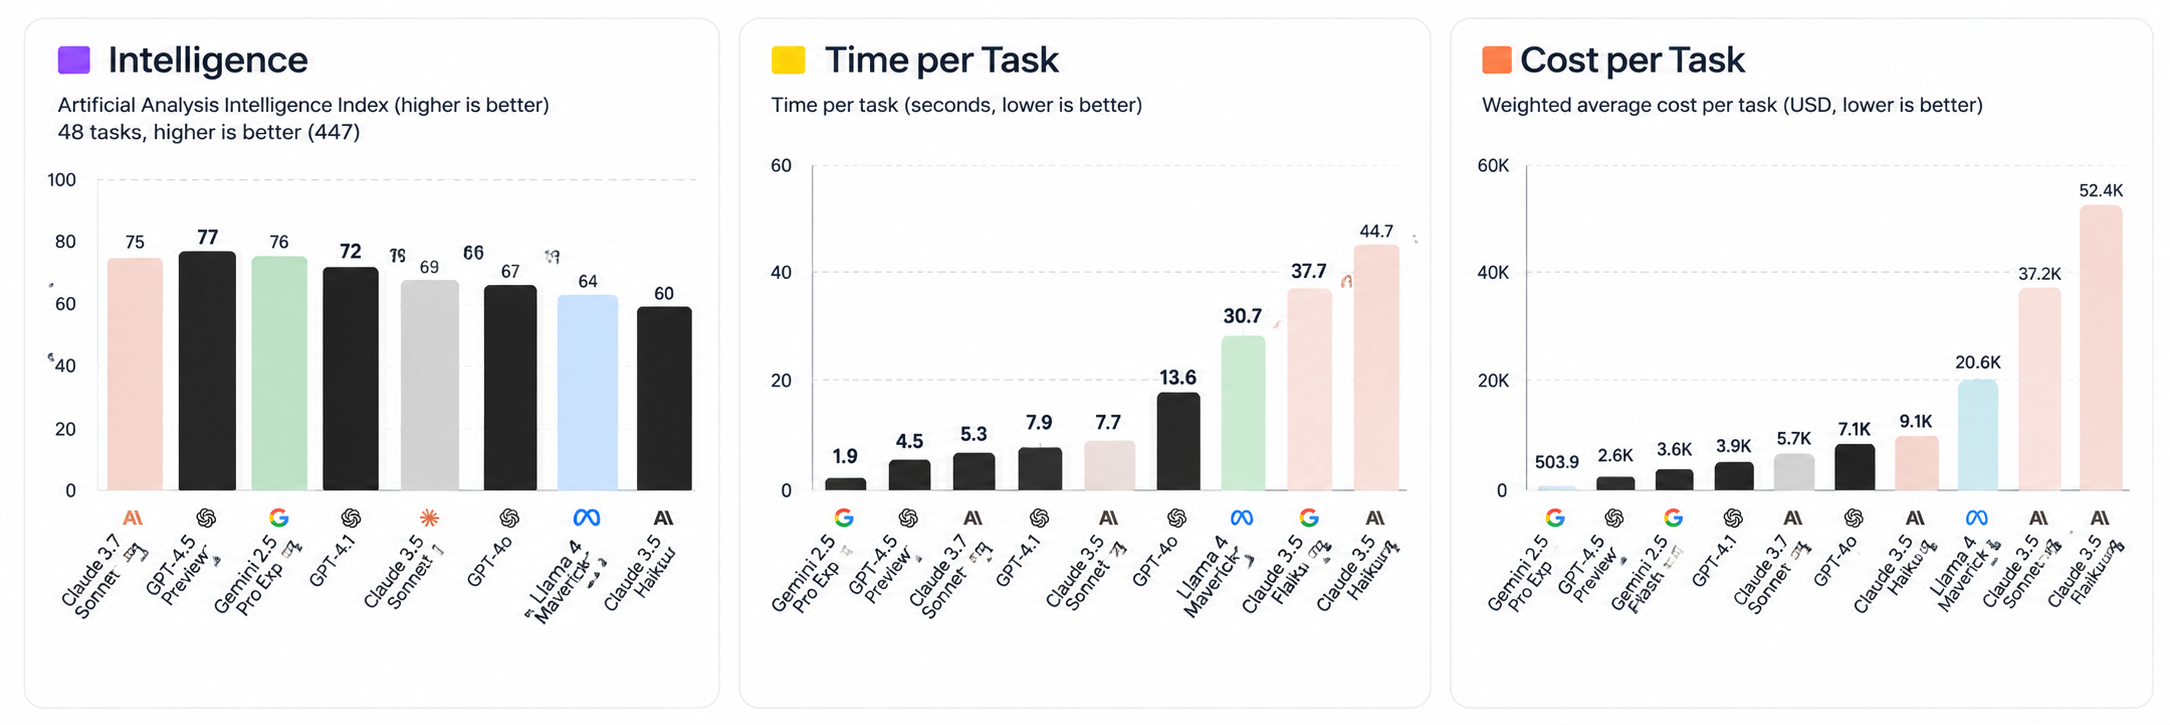
L’analyse du jour de lancement d’Artificial Analysis place GPT-6.2 Astra deuxième dans son Intelligence Index, derrière Claude Fable 5.2, avec une amélioration de cinq points par rapport à GPT-6 Astra. Sol gagne deux points à 57, égalant GPT-6 Astra à environ 15 % de son coût mesuré par tâche.
La même analyse signale une nuance que les développeurs devraient considérer : GPT-6.2 Astra est plat par rapport à GPT-6 Astra sur le Coding Agent Index avec le harnais Codex à l’effort Max. Sol perd trois points par rapport à GPT-6.1 Sol, entraîné par une baisse de 14 points sur SWE-Atlas-QnA-AA, où il omet plus souvent des faits clés.
Le scorecard de modèle d’Epoch AI liste indépendamment Astra à 174 ECI, à égalité avec Claude Fable 5.2, contre 169 pour GPT-6 Astra. Des classements différents reflètent des suites d’évaluation différentes.
1. Artificial Analysis Intelligence Index
62.1 points
Artificial Analysis rapporte un score d’environ 62 pour GPT-6.2 Astra à l’effort de raisonnement maximum sur Intelligence Index v5.0.1, le plaçant troisième dans son classement actuel des modèles.
L’indice combine neuf évaluations couvrant le travail de connaissance professionnel, le code, la science et le raisonnement général. Ses benchmarks composants incluent Terminal-Bench 4.0, FrontierCode-AA 2.0, AA-Briefcase, GDP.pdf et HLE-Diamond.
C’est une mesure globale utile, mais cela ne signifie pas qu’Astra arrive premier sur chaque composant.
2. Terminal-Bench-Science 0.1
78.6% à Xhigh
Terminal-Bench-Science évalue la capacité des modèles à mener des workflows de recherche scientifique dans un environnement terminal.
Artificial Analysis rapporte indépendamment :
| Niveau d’effort de raisonnement de GPT-6.2 Astra | Score |
|---|---|
| Xhigh | 78.6% |
| Max | 78.1% |
| High | 75.2% |
Ces résultats placent Astra en tête du classement actuel d’Artificial Analysis pour cette évaluation. La distinction entre Xhigh et Max compte : le meilleur score n’est pas nécessairement produit par le réglage le plus intensif en calcul.
3. Vals Science Index
68.44 % · Rang n°1
Le Vals Science Index évalue les capacités de recherche scientifique à travers l’investigation de données biologiques, la découverte de mécanismes et des workflows scientifiques basés sur terminal.
Classement Vals AI, mis à jour le 16 novembre 2026
| Modèle | Vals Science Index |
|---|---|
| GPT-6.2 Astra | 68.44% |
| GPT-6 Astra | 65.09% |
| Claude Fable 5.2 | 63.74% |
| GPT-6.1 Sol | 59.63% |
| Claude Sonnet 5.5 | 59.12% |
| GPT-6.2 Sol | 57.76% |
Le résultat d’Astra est particulièrement pertinent pour les agents de recherche scientifique car l’indice combine plusieurs tâches scientifiques plutôt que de s’appuyer sur un seul benchmark de questions-réponses.
4. AA-3D : génération d’expériences 3D interactives
1,318 Elo · Rang n°1
AA-3D, développé par Artificial Analysis, mesure la capacité des modèles d’IA à transformer des instructions écrites en expériences web 3D interactives. Des évaluateurs humains comparent deux expériences générées par les modèles via des votes à l’aveugle par paires.
| Modèle | AA-3D Elo |
|---|---|
| GPT-6.2 Astra (Max) | 1,318 |
| Claude Fable 5.2 (Max) | 1,271 |
| GPT-6.2 Sol (Max) | 1,259 |
| Claude Sonnet 5.5 (Max) | 1,204 |
| Claude Opus 5.5 (Max) | 1,202 |
| GPT-6 Astra (Max) | 1,168 |
C’est un résultat notable pour le design interactif, la génération frontend et la visualisation 3D. Astra devance les modèles listés de 47 points Elo par rapport à Claude Fable 5.2.
Le résultat AA-AnalystAgent doit être interprété avec la même prudence : 62,5 % renvoie aux questions répondues correctement lors des cinq tentatives, plutôt qu’à une précision ordinaire en une seule tentative. De même, une différence d’Elo sur AA-3D mesure une préférence relative ; elle ne peut pas être lue comme un pourcentage d’amélioration de la qualité de design.
5. Résultats des benchmarks professionnels et agents d’OpenAI
OpenAI rapporte également de solides résultats sur ses propres évaluations de travail professionnel.
| Benchmark | Résultat GPT-6.2 Astra | Comparaison |
|---|---|---|
| Agents' Last Exam | 5,2 points au-dessus de GPT-6 Astra | Moins d’un tiers de son coût par tâche |
| GDPval v2 | 50.4% | GPT-6 Astra : 44.2 % ; Claude Fable 5.2 : 44.8 % |
| AA-AnalystAgent | 62.5% | Correct sur les cinq tentatives indépendantes dans la tâche de classeur mise en avant |
| Harvey LAB-AA v1.1 | 15.0% | Plus de deux fois le taux de réussite rapporté de Claude Fable 5.2 |
Agents’ Last Exam est particulièrement pertinent pour les organisations achetant du travail accompli. OpenAI rapporte aussi que GPT-6.2 Astra obtient 5,5 points de plus que Claude Fable 5.2 à environ 5 % de son coût par tâche. Sa comparaison exclut neuf tâches Fable ayant utilisé des modèles de secours, un détail méthodologique qui devrait accompagner le titre.
Ces résultats pointent vers des améliorations dans l’exécution agentique professionnelle, l’analyse financière et le travail de documents juridiques. Toutefois, GDPval v2 est une évaluation interne à OpenAI, tandis que les évaluations AA-AnalystAgent et Harvey utilisent leurs propres définitions de tâche et règles de scoring.
Que nous disent réellement les benchmarks ?
Trois conclusions se démarquent :
- La science est une force majeure. Astra arrive premier sur le Vals Science Index et les évaluations Terminal-Bench-Science, ce qui en fait un candidat solide pour les workflows de recherche computationnelle.
- L’exécution agentique professionnelle est une amélioration clé. Les résultats sur GDPval v2 et Agents’ Last Exam indiquent de meilleures performances sur les tâches à long horizon.
- La création visuelle et interactive est un différenciateur. Son résultat AA-3D montre que les forces d’Astra s’étendent au-delà du raisonnement textuel et du code conventionnels.
Une qualification importante : les comparaisons du lancement d’OpenAI ne sont pas toutes des tests indépendants tiers. Pour une validation indépendante, Artificial Analysis et Vals AI fournissent des preuves supplémentaires utiles. De plus, le fort score d’intelligence générale d’Astra n’en fait pas automatiquement le meilleur choix pour chaque benchmark de code ni le modèle le moins cher pour chaque charge.
GPT-6.2 Astra vs. GPT-6 Astra (et modèles antérieurs liés)
Note sur la dénomination : le modèle « frontier » précédent d’OpenAI est appelé GPT-6 Astra. Des rapports indiquent qu’une version GPT-6.1 Astra a été annulée ou retardée pour des raisons de sécurité avant la sortie 6.2.
| Aspect | GPT-6 Astra (précédent) | GPT-6.2 Astra | Notes / Avantage |
|---|---|---|---|
| Lancement | ~septembre 2026 | 17 novembre 2026 | Plus récent |
| API Input / Output | 8 $ / 40 $ par MTok | 10 $ / 50 $ (Astra) | Réduction de 20 % pour Astra |
| Entrée mise en cache / 1M de jetons | 1,00 $ | 0,40 $ | 60 % moins cher |
| Fenêtre de contexte | ~922k–1,05M | 1 050 000 (922k max entrée / 128k max sortie) | Similaire / précisé |
| Agents’ Last Exam | ~73.1% | ~78.3% | Gain net + coût/tâche bien moindre |
| Terminal-Bench Science | Référence | +~9 points | Forte amélioration en science |
| AA Intelligence Index | ~57 | 62 | Saut compétitif |
| Coût par tâche (exemples) | Plus élevé | Souvent <1/3 sur les graphiques OpenAI ; 36–50 % plus bas dans des tests indépendants | Gros gain d’efficacité |
| Efficacité des jetons de sortie | Référence | Moins de jetons sur de nombreuses tâches | Amplifie les économies |
| Garde-fous | Plus serrés sur cyber à haut risque | Niveau précédent | Réponse aux capacités accrues |
| Ultrafast | Disponibilité étendue | Plus limitée | Pro 200 obtient désormais Sol Ultrafast |
GPT-6.2 Sol (le modèle quotidien compagnon) conserve une tarification plus basse (2 $ / 10 $) et se rapproche d’Astra sur de nombreuses tâches de code pour environ un cinquième du coût, ce qui en fait le choix pratique par défaut pour des volumes élevés.
GPT-6.2 Astra vs. GPT-6 Astra : Astra 6.2 offre de meilleures performances rapportées sur les workflows professionnels et la recherche scientifique, tout en réduisant de 20 % les prix standard des jetons d’entrée et de sortie. L’entrée mise en cache est encore plus fortement remisée.
GPT-6.2 Astra vs. Claude Fable 5.2 : Fable 5.2 obtient un score plus élevé sur l’Artificial Analysis Intelligence Index, tandis qu’Astra mène sur le Vals Science Index et AA-3D. Rappel utile : la sélection de modèle doit dépendre de la charge de travail, pas d’un classement global unique.
Comment accéder à GPT-6.2 Astra
Canaux officiels OpenAI
- ChatGPT Work et Codex (utilisateurs Plus, Pro, Enterprise, Edu ; une activation admin peut être requise pour les espaces de travail).
- API OpenAI avec l’ID de modèle
gpt-6.2-astra. Ultrafast est disponible sous certains plans Pro et via l’API.
Via CometAPI (recommandé pour de nombreux développeurs et équipes)
CometAPI a ajouté GPT-6.2 Astra et GPT-6.2 Sol aux alentours du 18 novembre 2026 (IDs de modèle : gpt-6.2-astra et gpt-6.2-sol).
CometAPI fournit :
- Un endpoint unique compatible OpenAI et une clé API pour 500+ modèles (OpenAI, Anthropic, Google et bien d’autres).
- Une tarification compétitive fréquemment 20–40 % en dessous des tarifs officiels des fournisseurs.
- Pas besoin de gérer plusieurs clés de fournisseurs ni de réécrire le code d’intégration lors d’un changement de modèle.
- Prise en charge des formats Chat Completions et Responses API.
- Objectifs de haute fiabilité et migration simple (ne changer que
base_urletapi_keydans le SDK OpenAI). - Exemple de démarrage rapide (Python) :
from openai import OpenAI
client = OpenAI(
api_key="YOUR_COMETAPI_KEY",
base_url="https://api.cometapi.com/v1",
)
response = client.chat.completions.create(
model="gpt-6.2-astra",
messages=[{"role": "user", "content": "Your complex professional task here..."}],
)
print(response.choices[0].message.content)
Cela rend CometAPI particulièrement attractif pour les équipes qui veulent des performances « frontier » dès aujourd’hui, la possibilité de faire de l’A/B test face à Claude Fable, Gemini, Grok ou d’autres modèles, et un contrôle continu des coûts sans verrouillage fournisseur. Inscrivez-vous sur CometAPI.com pour des crédits gratuits et un accès immédiat.
Recommandations pratiques
- Utilisez GPT-6.2 Astra pour les projets professionnels multi-étapes les plus difficiles, la recherche scientifique, la rédaction juridique/financière à enjeux, les runs agentiques complexes, et la génération de documents visuels/professionnels lorsque la qualité et la fiabilité priment.
- Par défaut, choisissez GPT-6.2 Sol (ou routez intelligemment) pour le code à grand volume, les boucles agentiques quotidiennes et les charges de production sensibles aux coûts — il offre souvent des résultats proches d’Astra pour une fraction du prix.
- Exploitez le cache de prompts et conservez des préfixes de système/prompt stables pour maximiser le tarif très bas de l’entrée mise en cache.
- Surveillez la tendance documentée dans certaines évaluations à omettre des blocages ; concevez des harnais d’agents avec des étapes de vérification explicites lors d’exécutions non supervisées.
- Pour une flexibilité multi-fournisseurs et de potentielles économies supplémentaires, routez via CometAPI.
Conclusion
GPT-6.2 Astra représente une avancée significative sur la frontière coût-capacité pour le travail professionnel et agentique en IA. La combinaison de scores plus élevés sur des benchmarks clés à long horizon et en science, de prix de jetons substantiellement plus bas et d’une efficacité de jetons accrue en fait l’une des options les plus solides et pratiques disponibles fin 2026.
Que vous y accédiez directement via OpenAI ou via une passerelle unifiée telle que CometAPI, le modèle est prêt pour la production dans des applications réelles exigeantes. Les équipes qui évaluent à la fois Astra et Sol, mesurent leur propre coût par tâche et conçoivent une supervision appropriée en tireront la plus grande valeur.

