
TL;DR
Grok 4.7 et Xiaomi MiMo-V2.6 sont sortis à un jour d’intervalle, mais incarnent deux approches différentes de l’IA de pointe. Grok 4.7 met l’accent sur une pile d’agents propriétaire et étroitement intégrée pour le code et le travail professionnel, tandis que MiMo-V2.6-Pro combine des poids ouverts, une fenêtre de contexte plus grande, une compréhension multimodale native et une tarification API agressive.
SpaceXAI positionne Grok 4.7 comme son modèle de pointe pour le codage, les tâches agentiques et le travail de connaissance avec une fenêtre de contexte de 500K tokens et un effort de raisonnement configurable.
Xiaomi présente MiMo-V2.6-Pro comme un flagship multimodal avec contexte 1M doté de poids ouverts et prenant en charge la compréhension du texte, de l’image, de l’audio et de la vidéo.
En bref : Grok 4.7 est un produit d’agent géré plus verticalement intégré ; MiMo-V2.6-Pro offre aux développeurs davantage de contrôle de déploiement et un coût de tokens bruts bien plus faible. Le meilleur choix dépend de la charge de travail plutôt que d’un score unique de benchmark.
Points clés
- Grok 4.7 est conçu pour le codage à long horizon et les agents professionnels. Dans l’évaluation publiée par SpaceXAI, il obtient 46,3 % sur CursorBench 4.0, 71,0 % sur DeepSWE v1.1 avec effort élevé et 1 657 sur AA Briefcase v1.1.
- MiMo-V2.6-Pro est exceptionnellement compétitif pour un modèle ouvert. Xiaomi publie les poids du modèle et rapporte des résultats proches des systèmes propriétaires de pointe sur plusieurs benchmarks de codage et d’agents, mais les scores inter-fournisseurs ne sont pas directement interchangeables.
- MiMo a l’avantage en contexte et en multimodal. MiMo-V2.6-Pro prend en charge une fenêtre de contexte de 1M tokens ainsi que la compréhension du texte, de l’image, de l’audio et de la vidéo, contre le contexte 500K de Grok 4.7 avec entrée texte et image.
- MiMo est nettement moins cher en tokens API bruts. Le tarif standard officiel est de $0,435/$0,87 par million de tokens d’entrée/sortie non mis en cache pour MiMo-V2.6-Pro contre $2/$6 pour Grok 4.7.
- L’architecture de déploiement est l’arbitrage décisif. Grok offre une pile d’outils hébergée de premier ordre plus robuste ; les poids ouverts de MiMo permettent un déploiement privé, un service personnalisé et un contrôle plus profond de l’infrastructure.
Grok 4.7 vs MiMo-V2.6-Pro en un coup d’œil
| Dimension | Grok 4.7 | MiMo-V2.6-Pro |
|---|---|---|
| Sortie | 21 septembre 2026 | 22 septembre 2026 |
| Accès et contrôle | API propriétaire et écosystème d’agents gérés | Poids ouverts, option d’auto-hébergement et accès API |
| Preuves de performance | Force déclarée par le fournisseur en codage et tâches d’agents de longue durée ; valider sur le même harnais | Force déclarée par le fournisseur sur des tâches de raisonnement, de codage et multimodales ; valider sur le même harnais |
| Points forts distinctifs | Outils de premier ordre, workflows gérés et agents connectés au web/X | Contrôle du déploiement, contexte 1M tokens et compréhension texte/image/audio/vidéo |
| Fenêtre de contexte | 500K tokens | 1M tokens |
| Modalités d’entrée | Texte et image | Texte, image, audio et vidéo |
| Entrée/sortie standard officielle non mise en cache par 1M tokens | $2 / $6 | $0,435 / $0,87 |
| Raisonnement | Faible à xÉlevé | Raisonnement profond |
| Poids ouverts | Non | Non |
| Meilleur ajustement | Workflows de codage et d’agents gérés | Déploiement privé, entrée multimodale et coût de token brut inférieur |
Qu’est-ce que Grok 4.7 ?
SpaceXAI a officiellement publié Grok 4.7 le 21 septembre 2026 comme son modèle le plus performant pour le codage et le travail de connaissance. Ce lancement est important, car des rapports préalables mélangeaient des faits confirmés et des fuites sur l’architecture. La documentation finale ne publie pas de nombre total ou actif de paramètres, donc les estimations préalables ne doivent pas être considérées comme des spécifications officielles.
Selon l’annonce officielle, Grok 4.7 utilise un nouveau modèle de base, plus grand que Grok 4.6 et a été entraîné avec une phase d’apprentissage par renforcement plus longue, pondérée vers des problèmes nécessitant plusieurs heures.
Les modèles optimisent différentes couches de la pile. Grok 4.7 fournit un environnement géré plus riche autour du modèle ; MiMo-V2.6-Pro expose davantage le modèle et la couche de déploiement aux développeurs.
Pour les prompts au-delà de 200K tokens, SpaceXAI applique une tarification pour contexte plus long. La tranche publiée est de $4 par million de tokens d’entrée, $1 par million de tokens d’entrée mis en cache et $12 par million de tokens de sortie.
Changements dans Grok 4.7
Le changement le plus significatif réside dans l’objectif d’entraînement, pas seulement dans un score de benchmark plus élevé. SpaceXAI indique que son mix d’apprentissage par renforcement a basculé vers des tâches plus longues, de plusieurs heures, tandis que le modèle a été entraîné à vérifier son propre travail plus soigneusement et à comprendre nativement le harnais Grok Bot. Cette combinaison cible l’exécution d’agents réelle : maintien d’état, utilisation d’outils, vérification des étapes intermédiaires et cohérence sur de longues trajectoires de tâches.
Performances de Grok 4.7
| Benchmark publié par SpaceXAI | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| CursorBench 4.0 | 46,3 % | 40,4 % | 41,7 % | 51,8 % |
| DeepSWE v1.1 | 71,0 %* | 65,2 % | 72,7 % | 70,0 % |
| EEBench | 64,0 % | 53,0 % | 39,4 % | 56,4 % |
| AA Briefcase v1.1 | 1 657 | 1 546 | 1 487 | 1 678 |
| Terminal-Bench 4.0 | 38,0 % | 20,3 % | 37,3 % | 57,9 % |
| Harvey Legal Agent Benchmark | 19,6 % | 15,8 % | 2,5 % | 6,7 % |
| HealthBench Professional | 56,7 % | 48,5 % | 60,5 % | 62,1 % |
SpaceXAI indique que le score DeepSWE de Grok 4.7 correspond à un effort élevé. Ces évaluations sont publiées par le fournisseur et doivent être interprétées selon le harnais et les réglages de raisonnement documentés.
SpaceXAI présente les graphiques de lancement sous forme de contenu web natif sur la page d’annonce officielle ; le tableau ci-dessus reprend les valeurs de benchmark divulguées sans substituer un graphique redessiné.
Qu’est-ce que Xiaomi MiMo-V2.6 ?
Xiaomi a officiellement publié et open-sourcé MiMo-V2.6 le 22 septembre 2026. La famille inclut MiMo-V2.6-Pro et MiMo-V2.6-Flash, avec une option Pro-UltraSpeed pour les charges sensibles à la latence. Pour une comparaison directe avec Grok 4.7, MiMo-V2.6-Pro est le flagship approprié.
Les documents officiels de Xiaomi détaillent séparément les poids ouverts, l’entrée multimodale native et la tarification API. Cette combinaison rend MiMo-V2.6 pertinent au-delà des classements de benchmarks.
MiMo-V2.6 vs MiMo-V2.5 : qu’est-ce qui a été amélioré ?
Le point saillant architectural n’est pas simplement un checkpoint plus grand. La publication publique de Xiaomi se concentre fortement sur le post-entraînement et le Live RL. Selon les notes de version officielles, Pro et Flash ont chacun complété 30 étapes d’apprentissage par renforcement et ont généré ensemble environ 750 000 trajectoires ; les coûts de la phase RL divulgués étaient d’environ $2,62 millions pour Pro et $850 000 pour Flash.
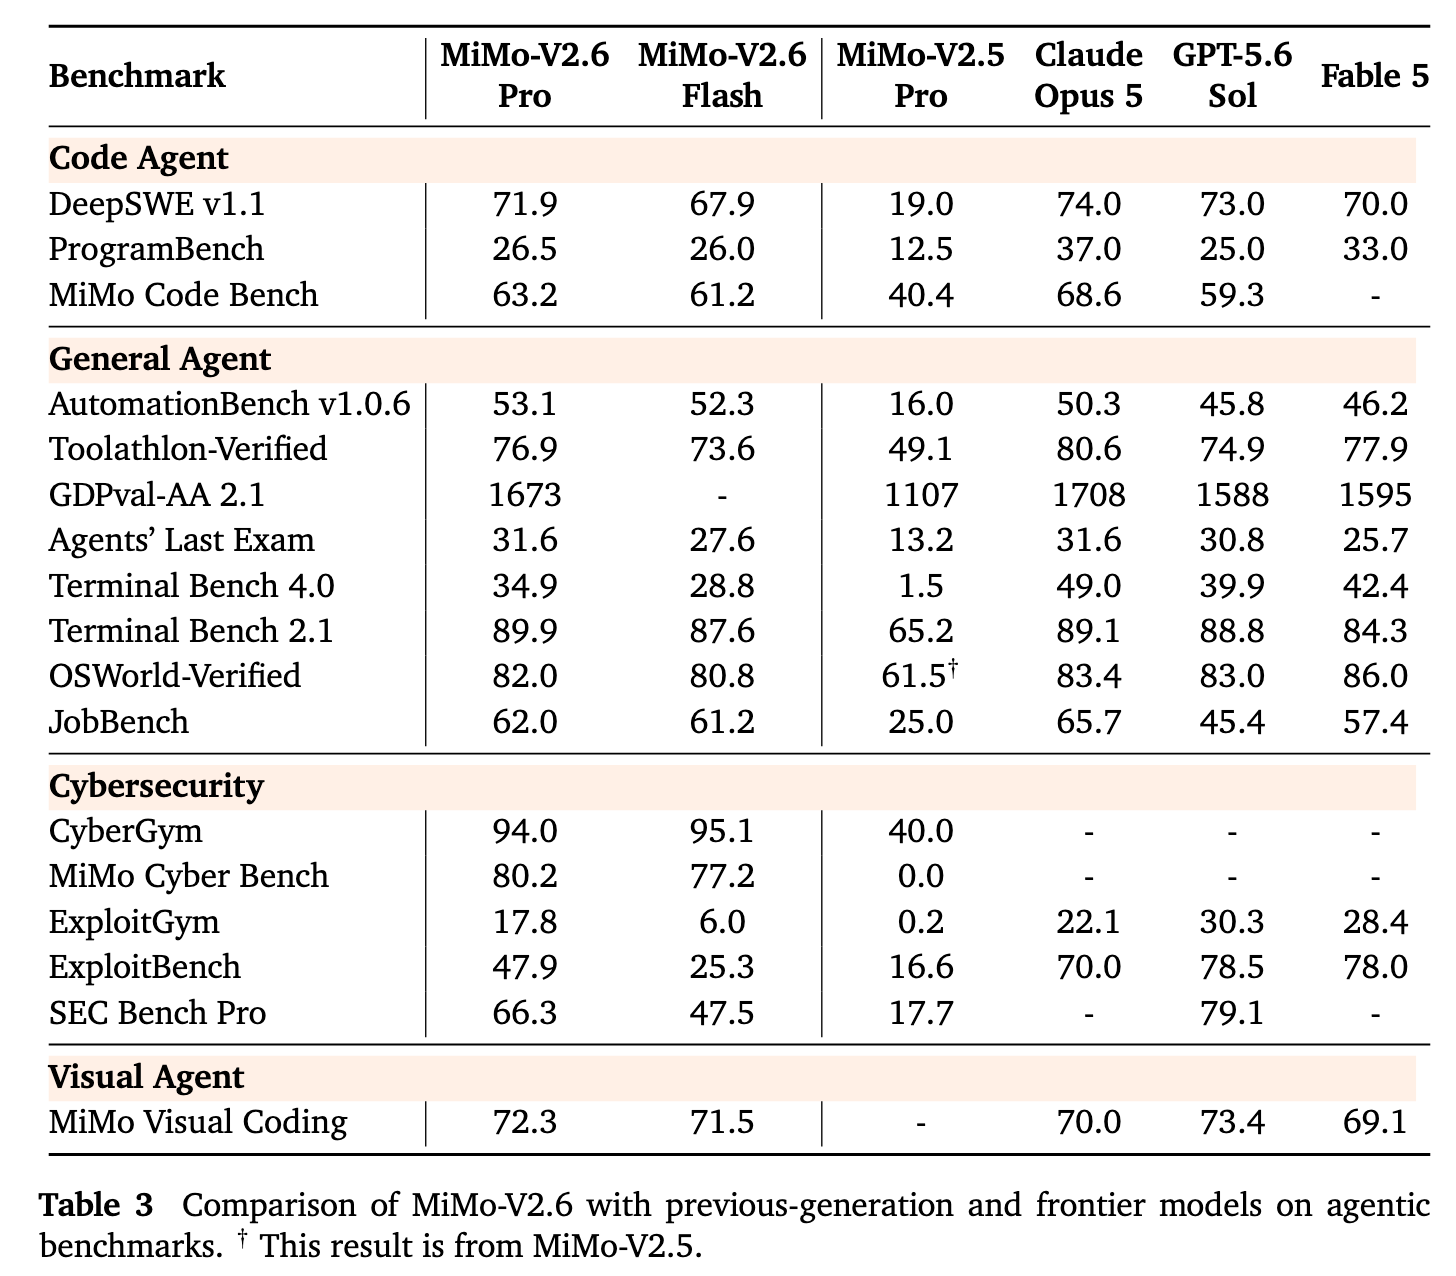
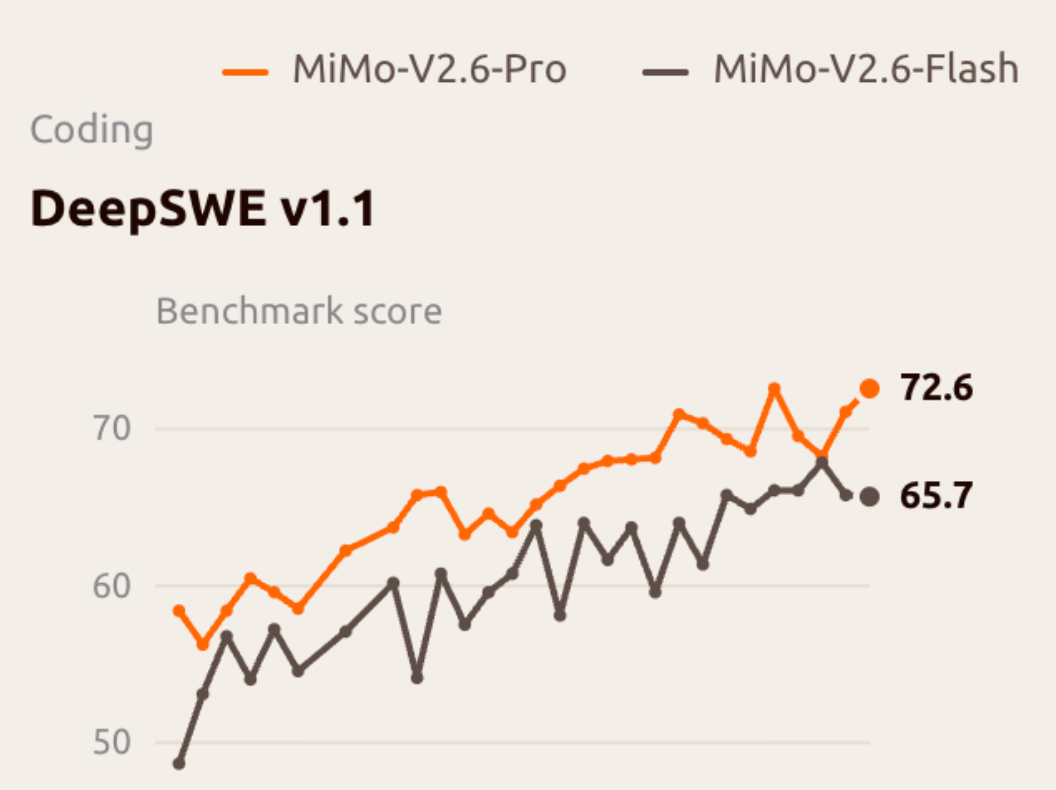
Un détail de benchmark mérite une attention particulière : la courbe Live RL de Xiaomi montre MiMo-V2.6-Pro atteignant environ 72,6 sur DeepSWE v1.1 pendant l’entraînement, tandis que le tableau de comparaison final indique 71,9. Ces chiffres se réfèrent à des contextes d’évaluation différents et ne doivent pas être fusionnés silencieusement.
Grok 4.7 vs MiMo-V2.6-Pro : comparaison des benchmarks
Les comparaisons directes de benchmarks exigent de la prudence. Les fournisseurs n’utilisent pas toujours des harnais, budgets de raisonnement, checkpoints ou configurations d’outils identiques. Même lorsque les noms de benchmarks coïncident, de petits écarts de score peuvent être moins significatifs qu’ils n’y paraissent. La comparaison la plus sûre consiste à séparer les mesures réellement alignées des indices directionnels.
Artificial Analysis Intelligence Index
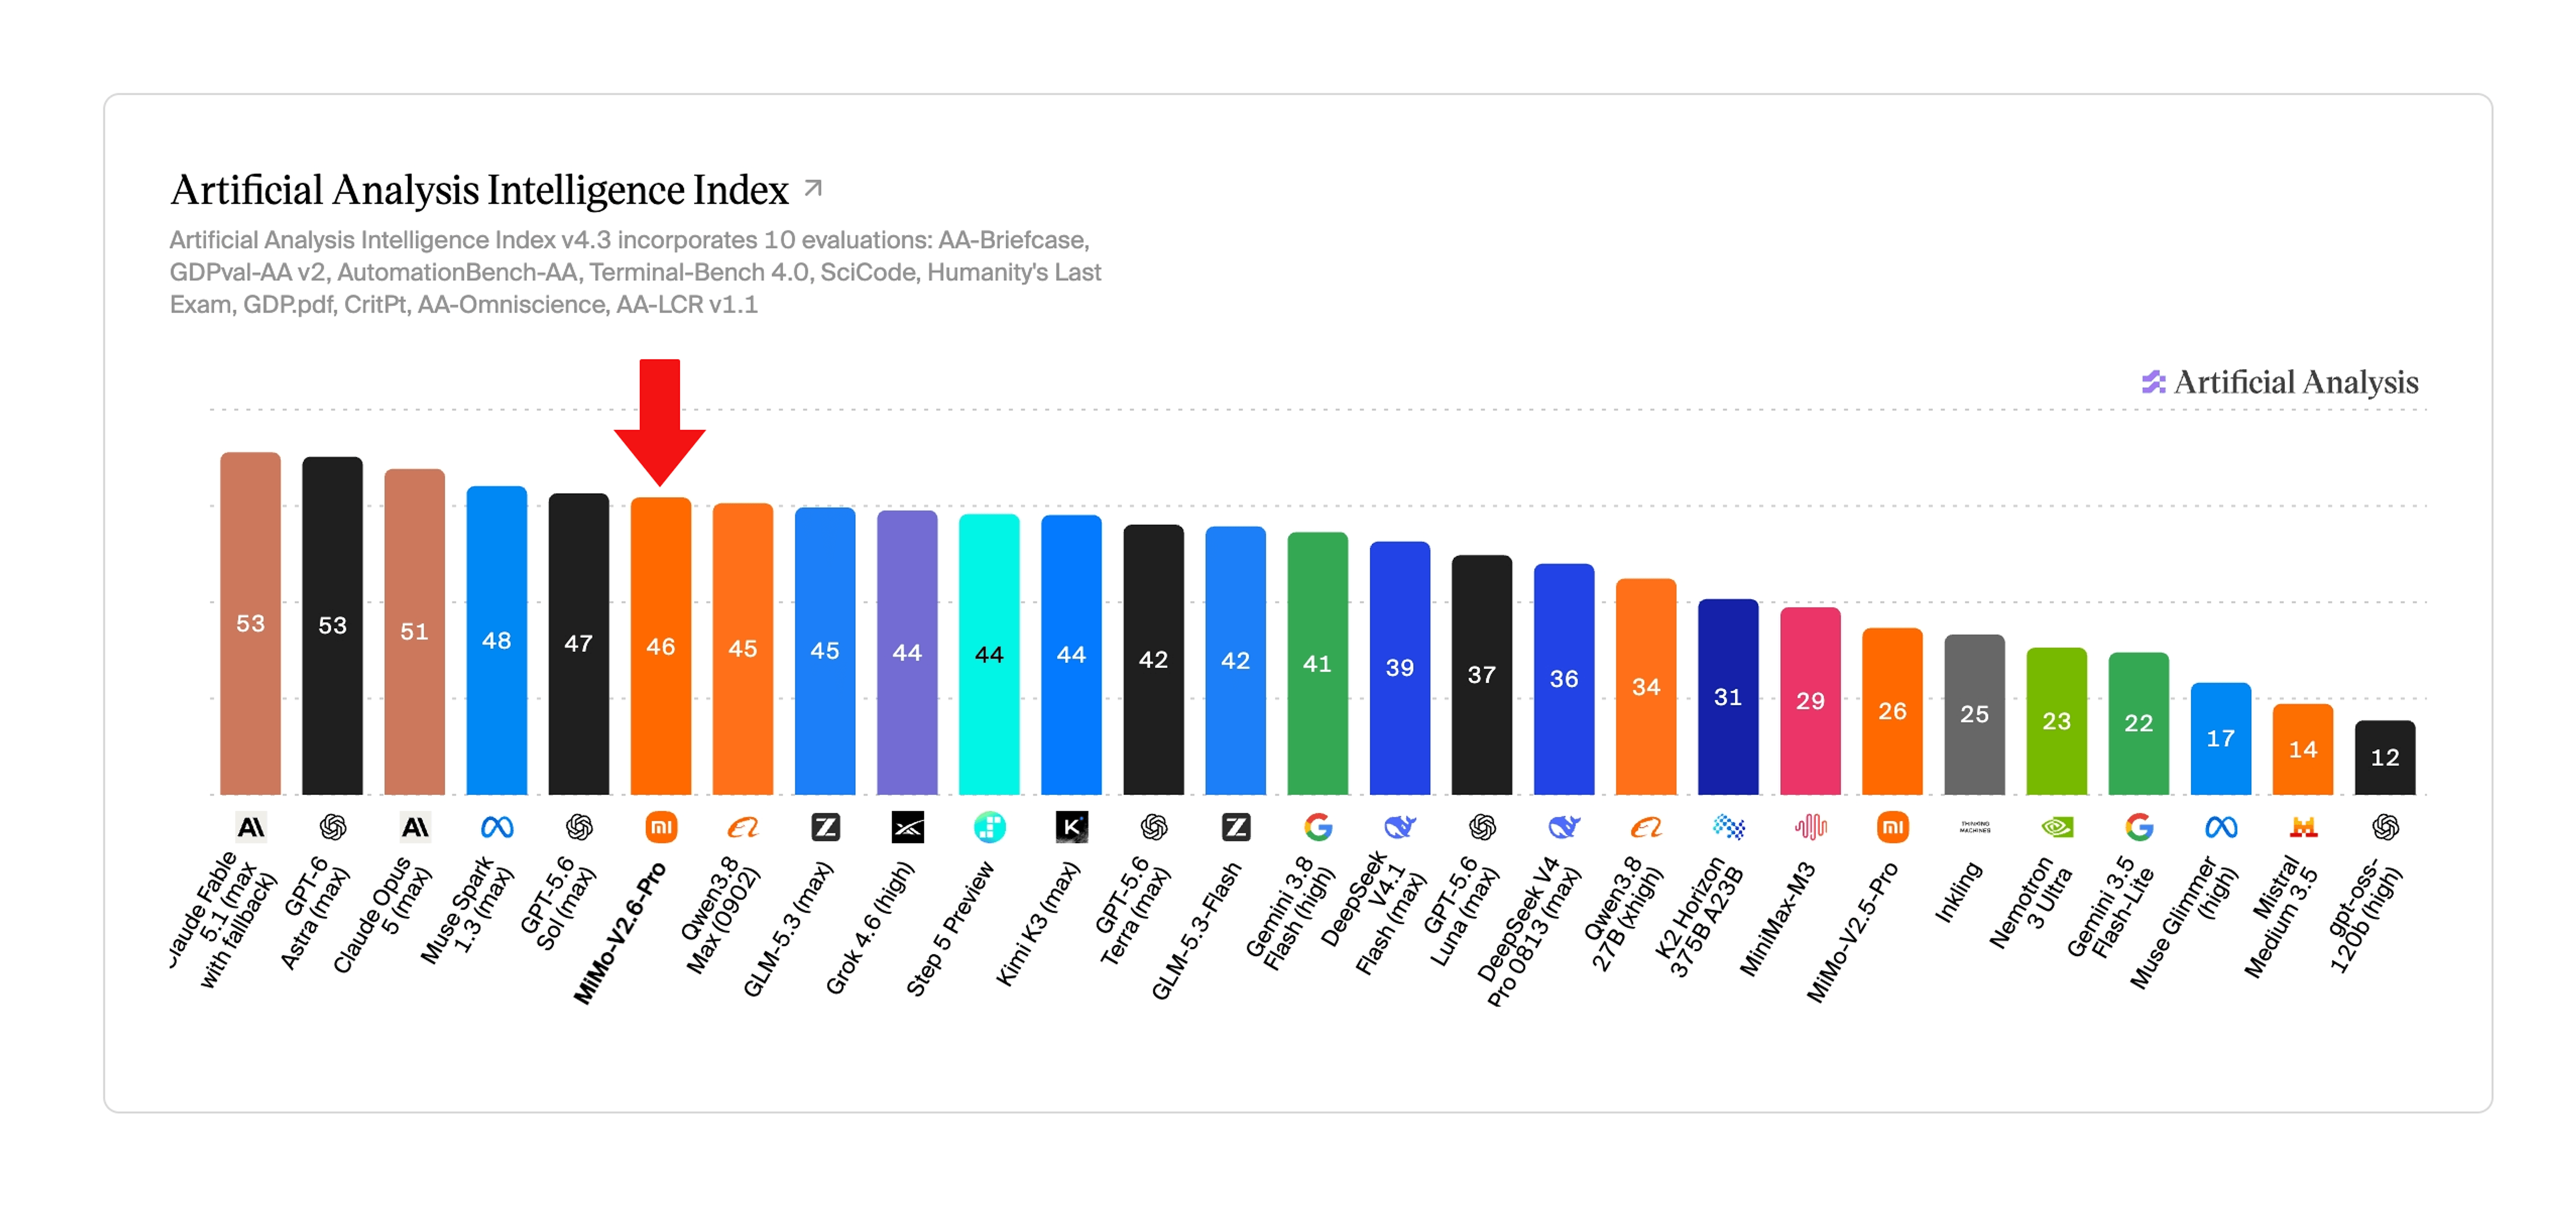
Xiaomi rapporte 46,32 pour MiMo-V2.6-Pro sur l’indice composite Artificial Analysis. Toute comparaison avec Grok devrait être liée au snapshot Artificial Analysis exact et à la configuration modèle utilisée ; une affirmation d’égalité arrondie ne doit pas être présentée sans cette source.
Performances en codage et agents
| Benchmark | Grok 4.7 — SpaceXAI | MiMo-V2.6-Pro — Xiaomi | Interprétation |
|---|---|---|---|
| DeepSWE v1.1 | 71,0* | 71,9** | Proches numériquement ; exécutions et réglages publiés différents |
| GDPval-AA | Voir graphique SpaceXAI | 1 673 | Directionnel uniquement tant que les harnais ne sont pas alignés |
| AA Briefcase | 1 657 | Voir graphique Xiaomi | Utiliser les valeurs déclarées avec leur contexte source |
| Terminal-Bench 4.0 | 38,0 | 34,9 | Direction similaire ; le harnais compte |
| Fenêtre de contexte | 500K | 1M | MiMo prend en charge davantage de contexte de travail |
*SpaceXAI rapporte DeepSWE de Grok 4.7 à effort élevé. *Le tableau final de Xiaomi indique 71,9 ; sa courbe d’entraînement Live RL atteint environ 72,6. Ces chiffres proviennent de contextes d’évaluation différents.
Adéquation aux workflows de codage
Pour le codage, la distinction dépend de ce que “codage” signifie : résolution brute de problèmes de dépôt ou expérience complète d’agent de codage géré. Sur DeepSWE v1.1, les chiffres publiés sont suffisamment proches pour qu’un écart inférieur à un point ne doive pas, à lui seul, dicter la sélection en production.
L’avantage de Grok 4.7 se situe plus haut dans la pile. Il s’intègre à Grok Build, est disponible dans Cursor, est conçu pour comprendre le harnais Grok Bot et est associé à des outils propriétaires d’exécution de code et de recherche.
L’avantage de MiMo-V2.6-Pro se situe plus bas dans la pile. Des poids ouverts rendent pratique la construction d’un assistant de codage privé, la personnalisation du service, l’application de contrôles de résidence des données ou l’expérimentation avec un harnais d’agent propriétaire.
Pour les équipes qui hésitent, un test A/B en production sur des dépôts représentatifs sera plus informatif qu’un unique benchmark public de codage.
Grok 4.7 vs MiMo-V2.6-Pro : différences de capacités multimodales
C’est l’une des différences les plus nettes. Grok 4.7 accepte des entrées texte et image et produit du texte. La plateforme Grok plus large propose des produits médias séparés, mais il ne faut pas les confondre avec la surface de modalités du modèle grok-4.7 lui-même.
MiMo-V2.6-Pro prend en charge la compréhension du texte, de l’image, de l’audio et de la vidéo. Combinée à une fenêtre de contexte de 1M tokens, cette capacité élargit la gamme de workflows gérables dans un même contexte de modèle.
- Analyse de captures d’écran et de code dans la même tâche
- Compréhension vidéo avec instructions associées
- Traitement audio longue durée
- Agents d’utilisation d’ordinateur avec retour visuel
- Assistants de recherche multimodaux
- Extraction et QA multimodales à grande échelle
Grok 4.7 vs MiMo-V2.6-Pro : comparaison des tarifs API
| Tarification API officielle | Grok 4.7 | MiMo-V2.6-Pro |
|---|---|---|
| Entrée / 1M tokens | $2,00 | $0,435 |
| Entrée mise en cache / 1M | $0,50 | $0,0036 |
| Sortie / 1M | $6,00 | $0,87 |
| Surcharge long contexte | Oui, au-delà de 200K tokens | Aucune tranche standard comparable publiée |
| Option poids ouverts/auto-hébergé | Non | Oui |
Au prix affiché, MiMo-V2.6-Pro est plusieurs fois moins cher tant sur l’entrée normale que sur la sortie générée, avec un écart particulièrement important pour le contexte mis en cache. Cela peut affecter sensiblement l’économie des agents qui traitent de manière répétée des dépôts, de longs documents ou un contexte persistant.
Remarque importante sur les tarifs : la fenêtre de contexte 500K de Grok 4.7 ne signifie pas que l’ensemble du contexte est facturé au tarif standard. Les requêtes dépassant 200K tokens d’invite sont facturées à la tranche long contexte.
Au 24 septembre 2026, CometAPI liste Grok 4.7 à $1,60 en entrée et $4,80 en sortie par 1M tokens, contre $2,00 et $6,00 officiels. Il liste MiMo-V2.6-Pro à $0,348 en entrée et $0,696 en sortie, contre $0,435 et $0,87 officiels. Ces tarifs standard listés sont inférieurs de 20 % aux tarifs officiels correspondants. Les prix et l’éligibilité peuvent changer ; confirmez les pages des modèles en ligne avant de budgéter.
Le prix du token n’est pas identique au coût par tâche achevée. Les modèles de raisonnement peuvent consommer des volumes de tokens différents, utiliser des nombres d’appels d’outils variés et nécessiter des taux de reprise différents. L’évaluation en production doit donc suivre conjointement le coût par tâche terminée, la latence et le taux de réussite.
Grok 4.7 vs MiMo-V2.6-Pro : accès et disponibilité
La différence d’accès est simple : Grok 4.7 est disponible via l’API et des workflows Grok gérés, tandis que ses poids ne sont pas proposés pour l’auto-hébergement. MiMo-V2.6-Pro est disponible via l’API et sous forme de poids ouverts, offrant aux équipes une voie supplémentaire d’auto-hébergement.
La disponibilité est distincte de la flexibilité de licence ou de déploiement. Au 24 septembre 2026, les deux modèles disposent aussi de pages de catalogue CometAPI en ligne. Les équipes doivent confirmer l’endpoint, la région, les limites de débit et l’éligibilité du compte avant un déploiement en production ; la présence d’un modèle au catalogue ne garantit pas une disponibilité ou des niveaux de service identiques pour chaque compte.
| Question de disponibilité | Grok 4.7 | MiMo-V2.6-Pro |
|---|---|---|
| API officielle | Disponible via xAI | Disponible via Xiaomi MiMo |
| Catalogue CometAPI | Listé comme disponible | Listé comme disponible |
| Poids auto-hébergés | Non disponibles | Option de poids ouverts |
| Vérification opérationnelle | Confirmer l’accès compte, la région, les limites de débit et la disponibilité des outils | Confirmer l’accès compte, la préparation de l’endpoint et les exigences d’auto-hébergement |
Poids ouverts et accès propriétaire
Le fait que MiMo-V2.6-Pro soit à poids ouverts change davantage la comparaison qu’un écart d’un point au benchmark. Cela crée des options pour un déploiement privé, l’optimisation du moteur d’inférence, un post-entraînement personnalisé, des contrôles de résidence des données et une intégration d’infrastructure plus profonde.
Grok 4.7 prend l’arbitrage inverse : moins de contrôle sur l’interne du modèle en échange d’un service géré, exploité en continu, et d’un écosystème propriétaire étroitement intégré. Pour de nombreuses organisations, les exigences de gouvernance et d’infrastructure détermineront la présélection avant la performance aux benchmarks.
Comment utiliser les API Grok 4.7 et MiMo V2.6 dans CometAPI
Les développeurs peuvent accéder à l’API Grok 4.7 dans CometAPI via un workflow API unifié, réduisant la nécessité de maintenir des intégrations spécifiques à chaque fournisseur.
Pour les équipes qui benchmarkent plusieurs modèles de pointe, une couche API unifiée est particulièrement utile car les mêmes prompts de production, harnais de test, comptages de tokens et code applicatif peuvent être rejoués sur différents modèles avec moins de variables d’intégration.
CometAPI liste désormais MiMo-V2.6-Pro comme disponible, avec une disponibilité API confirmée au 22 septembre 2026. Vérifiez le catalogue en ligne et l’accès de votre compte avant un usage en production.
Avec les deux pages de modèles désormais listées comme disponibles, un test A/B au niveau de l’application peut conserver aussi constants que possible les prompts, outils, réglages de raisonnement et critères de succès, puis comparer l’achèvement des tâches, la latence, l’utilisation des tokens et les modes d’échec.
Grok 4.7 vs MiMo-V2.6-Pro : adéquation des modèles par cas d’usage
| Exigence | Ajustement modèle / recommandations d’évaluation |
|---|---|
| Recherche web et X de premier ordre | Grok 4.7 |
| Agents gérés de longue durée | Grok 4.7 |
| Workflows Grok Build / Cursor | Grok 4.7 |
| Fenêtre de contexte 1M tokens | MiMo-V2.6-Pro |
| Compréhension audio/vidéo native | MiMo-V2.6-Pro |
| Poids ouverts, auto-hébergement, contrôle | MiMo-V2.6-Pro |
| Coût brut de tokens API le plus bas | MiMo-V2.6-Pro |
| Codage sur dépôt | Benchmarker les deux sur des dépôts représentatifs |
| Agents professionnels de connaissance | Benchmarker les deux sur des tâches de production |
La décision doit donc être cadrée autour de l’architecture de la charge de travail. Grok 4.7 est conçu pour rendre une pile d’agents gérés plus capable ; MiMo-V2.6-Pro est conçu pour rendre une intelligence haut de gamme plus économique, plus multimodale et plus contrôlable.
Lequel choisir ?
Choisissez Grok 4.7 si vous voulez une expérience d’agent gérée avec recherche web et X de premier ordre, exécution de code native et moins d’infrastructure à opérer. C’est l’option la plus pratique pour les équipes qui valorisent une pile d’outils intégrée et des workflows professionnels ou de codage de longue durée.
Choisissez MiMo-V2.6-Pro si vous avez besoin de poids ouverts, d’un déploiement privé, d’une fenêtre de contexte 1M tokens, d’une compréhension audio et vidéo native ou d’une tarification API sensiblement plus basse. C’est l’option la plus solide lorsque le contrôle du déploiement, la couverture multimodale et l’efficacité des coûts sont les contraintes principales.
Si le choix reste incertain, exécutez les deux modèles sur les mêmes tâches représentatives avec des prompts, outils, budgets de raisonnement, délais et politiques de reprise identiques. Sélectionnez le modèle qui offre la meilleure combinaison de taux d’achèvement, latence, coût total par tâche réussie et effort de relecture humaine.
Conclusion
Grok 4.7 vs MiMo V2.6 montre que l’intelligence brute n’est plus le seul différenciateur significatif. Les deux modèles occupent une bande de haute capacité similaire dans les évaluations publiques actuelles, mais leurs stratégies produit divergent fortement.
Grok 4.7 combine une fenêtre de contexte 500K, un raisonnement configurable, un entraînement fort pour agents à long horizon et une pile propriétaire mature de recherche et d’exécution. MiMo-V2.6-Pro combine une fenêtre de contexte 1M, des entrées multimodales natives, des poids ouverts et une tarification API bien inférieure à celle de nombreux systèmes propriétaires de pointe.
Pour les développeurs, la question pratique est donc moins “quel score de benchmark est plus élevé ?” que “où doit vivre l’intelligence ?” Un écosystème d’agents géré et une pile de modèle ouverte et personnalisable résolvent des problèmes opérationnels différents. Le bon choix est celui qui correspond le mieux à la charge de travail de production, aux contraintes d’infrastructure et au modèle de coûts.
FAQs
Grok 4.7 est-il un modèle à 2,1 trillions de paramètres ?
Un chiffre d’environ 2,1T a circulé avant la sortie, mais la documentation finale de SpaceXAI pour Grok 4.7 ne publie pas de nombre total ou actif de paramètres. La déclaration confirmée est que Grok 4.7 utilise un modèle de base plus grand que Grok 4.6.
MiMo-V2.6 est-il open source ?
Xiaomi a publié MiMo-V2.6 comme une famille de modèles ouverts avec des poids téléchargeables et des ressources de recherche associées. En planification de production, les équipes doivent tout de même examiner la licence exacte du modèle et les conditions de redistribution pour leur usage prévu.
Combien coûte une tâche d’agent achevée avec Grok 4.7 vs MiMo-V2.6-Pro ?
Normalisez l’ensemble des tâches, les prompts, les permissions d’outils, la politique de reprise et les critères de réussite. Suivez les tokens d’entrée, d’entrée mise en cache, de raisonnement et de sortie, les appels d’outils, la latence, les reprises et le temps de relecture humaine. Le prix brut des tokens n’est qu’un composant du coût par tâche achevée.
Quelle est la fiabilité des comparaisons de benchmark entre Grok 4.7 et MiMo-V2.6-Pro ?
Utilisez le même dépôt ou ensemble de tâches, le même harnais d’agent, les mêmes outils, budget de raisonnement, délai, politique de reprise et barème de notation. Publiez des intervalles de confiance ou la variation entre exécutions répétées, et séparez les chiffres publiés par les fournisseurs de vos résultats internes.
Grok 4.7 facture-t-il davantage pour les invites à long contexte ?
SpaceXAI documente des tarifs plus élevés dès que les tokens d’invite dépassent 200K. Comme la tranche supérieure s’applique à la requête, les équipes utilisant de grands dépôts ou un contexte d’agent persistant doivent modéliser explicitement ce seuil.