
TLDR Des benchmarks ayant fuité et des tests furtifs sur Arena.ai à la mi-septembre 2026 positionnent le Gemini 4 Pro non publié de Google comme le nouveau leader à la frontière, devançant GPT-6 Astra et Claude Fable 5.1 en ingénierie logicielle, tâches agentiques, travail de connaissance, raisonnement et benchmarks multimodaux.
À retenir
- Gemini 4 Pro mène les évaluations ayant fuité sur DeepSWE v1.1 (88.7%), GDPval-AA v2 (2064 Elo), Terminal-bench 2.1 (95.3%), OSWorld-2.0 (86.8%) et plusieurs autres suites agentiques/de raisonnement.
- Il sous-tarifie GPT-6 Astra ($12/$60) et Claude Fable 5.1 ($10/$50) sur les prix publics tout en égalant ou dépassant leurs fenêtres de contexte de classe 1M.
- Des tests furtifs sur Arena.ai sous des noms de substitution (par ex., gemini-3.8-flash) ont produit des démos remarquées en SVG, Three.js et codage agentique.
- Des rumeurs d’RSI (amélioration autonome récursive) circulent mais manquent de preuves publiques d’une amélioration autonome en boucle fermée du modèle Gemini 4 lui-même.
- Google a confirmé un investissement massif dans un modèle de base Gemini 4 plus grand ; le calendrier de lancement public reste non officiel.
- Des plateformes telles que CometAPI agrègent déjà Gemini, GPT-6 Astra, Claude Fable/Opus et des centaines d’autres modèles derrière un point de terminaison compatible OpenAI à des tarifs compétitifs — idéal pour benchmarker la nouvelle frontière une fois disponible.
Que savons-nous de Gemini 4 ? (Fuites, sources et contexte vérifié)
Au 20 septembre 2026, Gemini 4 Pro n’a pas fait l’objet d’une annonce officielle de Google, de fiche modèle ou de point de terminaison API public. Tout ce qui dépasse les déclarations antérieures de Google concernant l’investissement dans un « modèle de base Gemini 4 plus grand » (résultats de juillet 2026) provient de fuites communautaires, de tests à l’aveugle sur Arena.ai et de tableaux de benchmarks circulant.
Sources et affirmations clés :
- Leaker Pankaj Kumar et des messages ultérieurs (début à mi-septembre) ont fait référence à un checkpoint Pro interne avec une sortie publique attendue en octobre et une possible variante Flash-Lite plus tôt.
- Plusieurs développeurs ont signalé avoir tiré un modèle à haute capacité étiqueté « gemini-3.8-flash » (ou noms de substitution similaires) sur Arena.ai. Les sorties incluaient une génération SVG complexe (par ex., pélican sur un vélo, papillons mécaniques en Three.js), une génération JSON longue non répétitive et un fort comportement agentique. Certains utilisateurs ont évoqué des détails backend tels qu’un contexte de plusieurs millions de tokens, des plafonds de sortie à 256k, une mémoire inter-session et des capacités natives d’outillage/Internet.
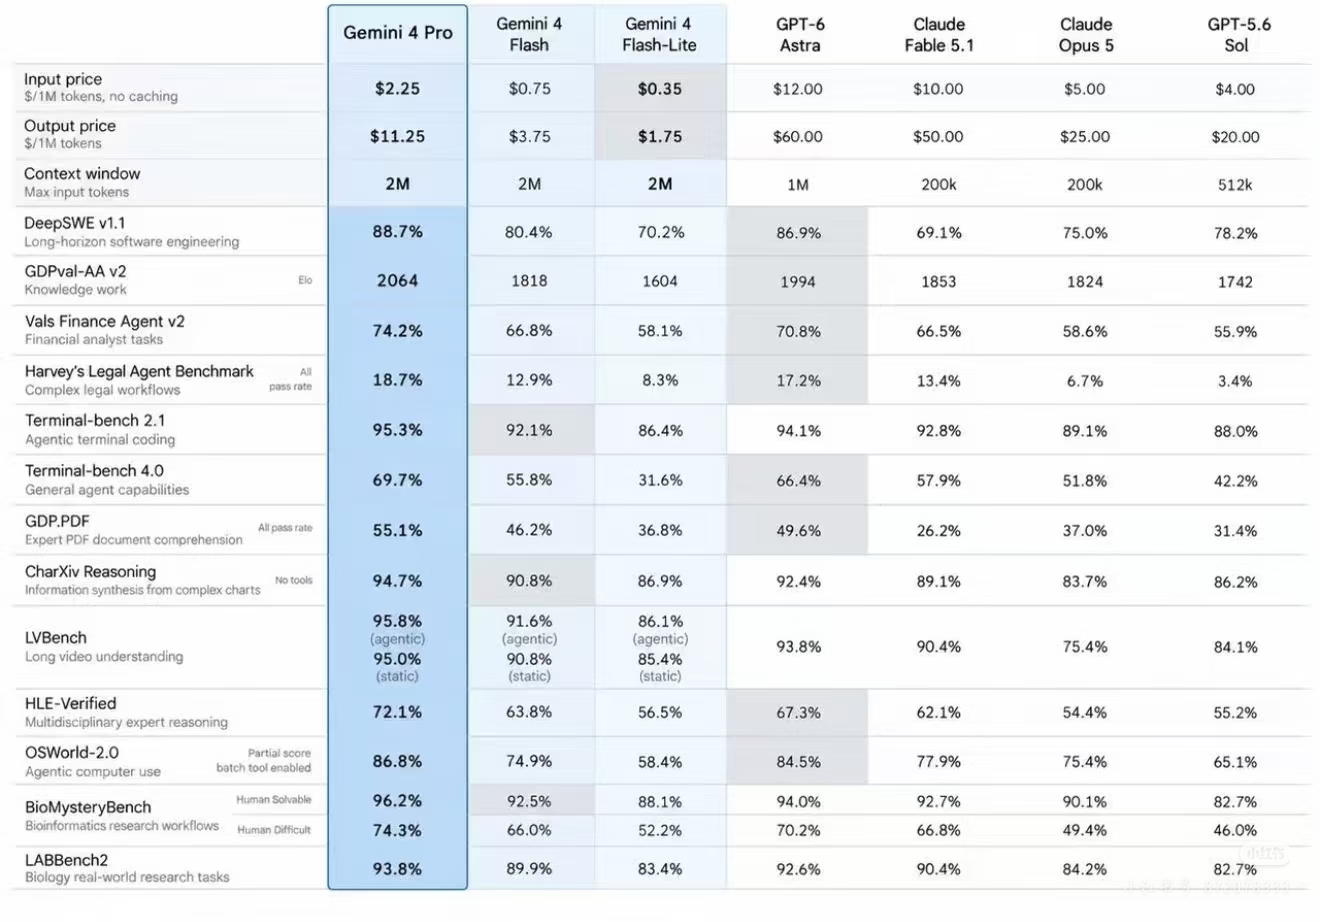
- Un tableau comparatif largement partagé liste Gemini 4 Pro face à Gemini 4 Flash, Gemini 4 Flash-Lite, GPT-6 Astra, Claude Fable 5.1, Claude Opus 5 et GPT-5.6 Sol.
- Google n’a confirmé ni les tests Arena ni le tableau. Le schéma historique montre que l’entreprise réalise souvent des évaluations furtives sur des plateformes publiques quelques semaines avant les lancements formels.
Fenêtre de contexte
Le tableau ayant fuité indique 2M de tokens d’entrée max pour la famille Gemini 4 — le double du 1M de GPT-6 Astra et bien au-dessus des 200k de la gamme Claude Fable/Opus 5 (certaines variantes de Claude ont proposé de plus grandes fenêtres effectives via d’autres mécanismes). Des affirmations de ghost-routing ont évoqué des plafonds à 10M ; elles restent non vérifiées.
Prix de Gemini 4 (chiffres ayant fuité)
Le tableau circulant liste :
- Gemini 4 Pro : $2.25 en entrée / $11.25 en sortie par 1M de tokens (sans mise en cache).
- Gemini 4 Flash : $0.75 / $3.75.
- Gemini 4 Flash-Lite : $0.35 / $1.75.
Ces chiffres sont nettement inférieurs aux tarifs rapportés de GPT-6 Astra ($12/$60) et de Claude Fable 5.1 ($10/$50) tout en égalant leur fenêtre de contexte. Les prix officiels actuels de Gemini 3.x Pro se situent dans la fourchette $2–$4 en entrée / $12–$18 en sortie selon la longueur de contexte, donc les chiffres Pro ayant fuité sont plausibles comme ajustement de nouvelle génération.
Les tarifs publics réels ne seront connus qu’au lancement. Google a historiquement utilisé des tarifs de tokens compétitifs et des paliers gratuits pour stimuler l’adoption.
Performance de Gemini 4 Pro : plongée dans les benchmarks ayant fuité
Le tableau circulant place Gemini 4 Pro en tête de presque toutes les catégories. Ces chiffres sont non officiels et non vérifiés par Google ou des laboratoires tiers indépendants au moment de la rédaction. Ils doivent être considérés comme des signaux directionnels plutôt que des classements définitifs.
Ingénierie logicielle et codage agentique
- DeepSWE v1.1 (ingénierie logicielle à long horizon) : 88.7% (vs. GPT-6 Astra 86.9%, Claude Fable 5.1 69.1%, Claude Opus 5 75.0%).
- Terminal-bench 2.1 (codage terminal agentique) : 95.3% (vs. Astra 94.1%, Fable 92.8%).
- Terminal-bench 4.0 (capacités agentiques générales) : 69.7% (plus grand écart relatif par rapport à Flash et aux concurrents).
Travail de connaissance et tâches professionnelles
- GDPval-AA v2 (Elo, travail de connaissance) : 2064 (seul modèle au-dessus de 2000 ; Astra 1994, Fable 1853).
- Vals Finance Agent v2 : 74.2%.
- Harvey’s Legal Agent Benchmark (workflows juridiques complexes, taux de réussite totale) : 18.7%.
Raisonnement, multimodal et spécialisé
- CharXiv Reasoning (synthèse d’information à partir de graphiques complexes, sans outils) : 94.7%.
- LVBench (compréhension de longues vidéos) : 95.8% agentique / 95.0% statique.
- HLE-Verified (raisonnement expert pluridisciplinaire) : 72.1%.
- OSWorld-2.0 (usage agentique de l’ordinateur, score partiel, outils par lots activés) : 86.8%.
- BioMysteryBench & LABBench2 (bio-informatique et workflows de recherche en biologie) : scores de tête sur les sous-ensembles résolubles par l’humain et difficiles.
Ces résultats, s’ils sont directionnellement corrects, montrent une force particulière sur des charges agentiques à long horizon, multi-étapes et avec usage d’outils — précisément le domaine où GPT-6 Astra et Claude Fable 5.1 étaient positionnés comme leaders après leurs sorties de début septembre.
Les tests qualitatifs sur Arena renforcent ce tableau : des générations SVG et Three.js complexes du modèle furtif ont été jugées supérieures ou très compétitives face à Astra dans des comparaisons côte à côte communautaires.
Comment Gemini 4 fonctionnera-t-il ?
Gemini 4 (Pro) n’est pas encore publié, donc toute description de « comment il fonctionnera » est nécessairement basée sur les déclarations officielles de Google, les rares détails ayant fuité sur un checkpoint interne précoce, la trajectoire de la série Gemini 3.x et des hypothèses d’ingénierie raisonnables. Rien ci-dessous ne doit être considéré comme des spécifications confirmées.
Entraînement de base et approche d’échelle
Google a décrit Gemini 4 comme son « run de pré-entraînement le plus ambitieux à ce jour », construit sur un modèle de base significativement plus grand que les générations précédentes. L’objectif explicite est de rester compétitif à la frontière, notamment en codage et agents autonomes.
Cela implique :
- Un nombre de paramètres plus élevé ou une capacité plus efficace (via mixture-of-experts, meilleure parcimonie ou montée en charge plus dense).
- Un investissement de calcul plus lourd pendant le pré-entraînement.
- Un accent continu sur des données multimodales (texte, image, vidéo, audio, code, trajectoires d’usage d’outils).
Le modèle devrait servir de nouveau socle à haute capacité à partir duquel des variantes rapides de type Flash pourront être dérivées plus tard.
Inférence et style de raisonnement
Des descriptions ayant fuité d’un checkpoint « argon » mentionnent un mode d’effort de réflexion élevé qui prenait environ 2.4 minutes pour une génération unique et supportait une limite de sortie bien plus élevée (rapportée à 256k tokens contre ~64k auparavant).
Cela indique :
- Des chemins de raisonnement optionnels intensifs en calcul (dans l’esprit des modes de pensée étendue ou « effort maximal » des modèles concurrents).
- La capacité de dépenser davantage de calcul interne sur des problèmes difficiles avant de produire une réponse.
- Un meilleur support pour des sorties longues et cohérentes telles que des bases de code complètes, des plans multi-étapes ou des rapports longs.
Les utilisateurs pourront vraisemblablement contrôler le compromis entre vitesse/coût et profondeur de raisonnement, comme avec les modèles Gemini Flash actuels qui offrent des niveaux de réflexion faible / moyen / élevé.
Axes clés de capacités
Sur la base des remarques publiques de Sundar Pichai et de la trajectoire de développement :
- Codage et ingénierie logicielle Renforcement à long horizon : refactorings multi-fichiers, débogage à travers des dépôts, boucles d’auto-correction et taux d’achèvement plus élevés sur des tâches logicielles réalistes.
- Comportement autonome/agentique Meilleure capacité à planifier, utiliser des outils, observer des résultats intermédiaires, récupérer après des erreurs et poursuivre un objectif sur de nombreuses étapes. S’appuie directement sur les fonctionnalités d’usage de l’ordinateur et agentiques déjà présentes dans Gemini 3.5/3.8 Flash.
- Fiabilité en long contexte Des rapports communautaires mentionnent des cibles dans la plage de 1,5 million de tokens (ou plus). Le but pratique n’est pas seulement des fenêtres plus grandes mais une meilleure fidélité de récupération et moins de dégradation avec de très longs documents, bases de code ou traces d’agent de plusieurs heures.
- Compréhension et génération multimodales Gestion native texte + image + vidéo + audio, avec des gains attendus en raisonnement spatial, compréhension vidéo et interactions voix/agent en temps réel (en s’appuyant sur les modèles Gemini 3.8 Live de septembre 2026).
- Usage d’outils et sorties structurées Appels de fonctions plus robustes, exécution de code, ancrage par la recherche et sorties structurées de type JSON/XML pour une intégration fiable dans des applications et agents.
En quoi il diffère de Gemini 3.x
- Échelle : Modèle de base explicitement plus grand plutôt qu’un raffinement incrémental.
- Capacité de sortie : Des limites de tokens plus élevées ayant fuité permettent des générations plus longues en un seul passage.
- Profondeur de raisonnement : Des modes d’effort plus prononcés pour les problèmes difficiles.
- Focalisation agentique : Accent accru sur le travail autonome soutenu et multi-étapes plutôt que des tâches à tour unique ou à court horizon.
- Positionnement : Conçu comme le nouveau modèle Pro de frontière, tandis que la ligne Flash continue l’itération rapide pour la vitesse et l’efficacité des coûts.
Relation avec le RSI
Des dirigeants de Google ont publiquement lié les dépenses d’investissement IA du groupe à l’objectif de plus long terme d’amélioration autonome récursive — des systèmes capables d’améliorer de manière significative eux-mêmes ou les processus qui produisent la génération suivante. Des recherches associées (comme l’article Dream-RSI) montrent des agents améliorant leurs propres stratégies d’exploration sans changer les poids du modèle.
Gemini 4 Pro surpassera-t-il GPT-6 et Claude Fable 5.1 ?
| Catégorie | Gemini 4 Pro | GPT-6 Astra | Claude Fable 5.1 | Notes |
|---|---|---|---|---|
| Prix entrée / sortie | $2.25 / $11.25 | $12.00 / $60.00 | $10.00 / $50.00 | Gemini 4 Pro ~5× moins cher qu’Astra |
| Fenêtre de contexte | 2M | 1M | 200k | Avantage significatif pour Gemini |
| DeepSWE v1.1 | 88.7% | 86.9% | 69.1% | Avance forte en codage |
| GDPval-AA v2 (Elo) | 2064 | 1994 | 1853 | Leader du travail de connaissance |
| Terminal-bench 4.0 | 69.7% | 66.4% | 57.9% | Capacités agentiques générales |
| OSWorld-2.0 | 86.8% | 84.5% | 77.9% | Usage de l’ordinateur |
| HLE-Verified | 72.1% | 67.3% | 62.1% | Raisonnement expert |
| LVBench (vidéo) | 95.8% / 95.0% | 93.8% | 90.4% | Force multimodale |
| Recherche bio/LAB | Scores les plus élevés | Solide | Compétitif | Flux de travail scientifiques |
Gemini 4 Pro arrive en tête de chaque ligne majeure du tableau, souvent avec une marge significative, tandis que son tarification alléguée est bien plus agressive que celle de GPT-6 Astra ou de Claude Fable 5.1.
Mises en garde importantes
- Ce tableau n’est pas une publication officielle de Google. Au 20 septembre 2026, Google n’a toujours pas publié de fiche modèle, point de terminaison API, tarification ou benchmarks confirmés pour Gemini 4 Pro. Les chiffres proviennent de sources communautaires / observations sur Arena / fuites d’un checkpoint interne (nom de code lié « argon »).
- Certaines feuilles circulant plus tôt ont ensuite été signalées comme prédictives ou partiellement copiées. Considérez chaque pourcentage et prix comme non vérifié jusqu’à confirmation par Google.
- La fenêtre de contexte de Claude Fable 5.1 est ici listée à 200k, inférieure au 1M communément rapporté dans la documentation officielle d’Anthropic. Cela peut refléter un réglage d’évaluation spécifique ou une erreur dans la feuille ayant fuité.
- GPT-6 Astra et Claude Fable 5.1 restent les seuls modèles de frontière entièrement publics et évalués indépendamment à ce jour. Artificial Analysis et d’autres traqueurs tiers les montrent toujours comme très proches globalement (avec des forces différentes).
Réalité pratique actuelle (20 septembre 2026)
| Modèle | Statut | Idéal pour | Niveau de prix |
|---|---|---|---|
| Gemini 4 Pro | Non publié (présumé performant) | Long contexte, code, agents, multimodalité, coût | Très agressif (présumé) |
| GPT-6 Astra | Publié | Math, usage ordinateur, terminal, automatisation, cyber | Premium |
| Claude Fable 5.1 | Publié | Agents à long horizon, raisonnement, qualité du code, efficacité du cache | Premium |
| Gemini 4 Flash / Flash-Lite | Apparentés présumés | Charges axées vitesse + coût | Extrêmement bas |
Points clés rapides
- Dominant sur toute la ligne : Gemini 4 Pro se classe n°1 dans chaque catégorie listée, souvent avec une marge nette.
- Forces particulières : codage/agents à long horizon (DeepSWE, Terminal-bench), travail de connaissance, multimodal (vidéo + graphiques) et domaines spécialisés (finance, juridique, biologie, usage de l’ordinateur).
- Positionnement prix : environ 1/5 du prix de GPT-6 Astra et de Claude Fable 5.1 en entrée comme en sortie, tout en affichant des scores supérieurs.
Astra met l’accent sur l’usage de l’ordinateur, les seuils de cybersécurité et la découverte scientifique ; Fable 5.1 insiste sur les agents longue durée, le raisonnement, la qualité du code avec des garde-fous affinés et de faibles coûts de lecture de cache. Le profil ayant fuité de Gemini 4 Pro semble le plus fort en ingénierie logicielle agentique large et en raisonnement multimodal.
Comment les développeurs peuvent se préparer : recommandations CometAPI
En attendant l’accès officiel à Gemini 4 Pro, les équipes bénéficient d’une passerelle unifiée qui supporte déjà la frontière actuelle (série Gemini 3.x, GPT-6 Astra, Claude Fable 5.1 / Opus 5 et 500+ autres modèles). CometAPI fournit exactement cela : un point de terminaison compatible OpenAI, une clé API unique, une facturation à l’usage généralement 20–40% en dessous des tarifs directs, et la possibilité de basculer de modèle avec un simple changement de paramètre.
Workflow pratique :
- Prototyper des pipelines agentiques sur les Gemini Flash/Pro actuels, GPT-6 Astra et Claude Fable 5.1 via CometAPI.
- Benchmarker les mêmes prompts à travers les modèles pour établir des bases.
- Lorsque Gemini 4 Pro (et ses variantes Flash) apparaîtront dans le catalogue CometAPI — historiquement, la plateforme ajoute rapidement les nouveaux modèles Google — remplacer l’ID de modèle et relancer les évaluations avec des changements de code minimaux.
- Utiliser le tableau de bord des coûts pour suivre la dépense en tokens entre fournisseurs et router le trafic à fort volume ou sensible à la latence vers le modèle le plus économique et capable.
Cette approche élimine la gestion multi-clés, réduit le risque de verrouillage fournisseur et positionne les équipes pour adopter Gemini 4 Pro dès le premier jour de disponibilité publique.
Gemini 4 Pro, si les fuites s’avèrent directionnellement correctes, représente l’effort le plus fort de Google pour reconquérir la frontière sur l’ingénierie logicielle agentique et le raisonnement multimodal en long contexte. La combinaison de performances revendiquées, grand contexte et tarification agressive en ferait un choix par défaut pour de nombreuses charges en production. Jusqu’au lancement officiel et aux évaluations indépendantes, la voie prudente est un benchmarking continu sur les modèles de frontière existants — facilement réalisable via des plateformes qui unifient déjà l’accès. Restez à l’écoute pour l’annonce formelle ; les prochaines semaines devraient clarifier quelle part du battage se traduit en réalité de production.
FAQ
Gemini 4 Pro est-il publié ?
Non. D’après le dernier catalogue et les déclarations de Google (mi-fin septembre 2026), il n’a pas été publié ni listé avec un ID de modèle officiel.
Quelle est la date de sortie prévue de Gemini 4 Pro ?
Les leakers évoquent octobre 2026 (avec quelques spéculations fin septembre). Google n’a donné aucune date officielle. Considérez cela comme une fenêtre en attente de confirmation via le catalogue API ou un billet de blog.
Google a-t-il atteint le RSI avec Gemini 4 Pro ?
Les preuves publiques montrent un usage avancé de boucles agentiques pour le raffinement de modèle et des recherches sur l’amélioration récursive au niveau des stratégies (par ex., Dream-RSI). Les affirmations d’un RSI complet ayant produit le modèle ne sont pas étayées par une vérification indépendante.
Comment se compare-t-il à GPT-6 Astra et Claude Fable 5.1 sur les benchmarks ?
Des graphiques communautaires ayant fuité revendiquent des avances sur plusieurs suites d’agents/codage. Des scores officiels et indépendants pour un Gemini 4 Pro publié n’existent pas encore. Les données publiques actuelles favorisent l’évaluation des modèles live (Astra et Fable 5.1) sur vos tâches.
Dois-je attendre Gemini 4 Pro avant de construire ?
Non. Livrez avec les meilleurs modèles disponibles aujourd’hui (accessibles via CometAPI ou des API directes), gardez vos jeux d’évaluation prêts, et adoptez le nouveau modèle si et quand des tests indépendants et internes justifient le basculement.
Où puis-je accéder facilement aux modèles de frontière actuels ?
Des fournisseurs unifiés comme CometAPI offrent un accès compatible OpenAI aux modèles de classe GPT-6 Astra, Claude Fable 5.1, aux modèles Gemini actuels et à d’autres, avec une facturation simplifiée et un changement aisé. Consultez la liste des modèles live et la documentation pour les derniers IDs et tarifs.