
La façon la plus rapide d’utiliser l’API GLM-5.3 Flash consiste à appeler le modèle via l’endpoint de chat-completions compatible OpenAI de CometAPI. Les détails de connexion sont regroupés dans le tableau des spécifications API ci-dessous ; conservez la clé API côté serveur.
Répondez d’abord : créez une clé CometAPI, installez un SDK compatible OpenAI, envoyez une requête POST vers /v1/chat/completions, puis ajoutez le streaming, la vision, la sortie JSON ou les outils uniquement après la réussite de la requête de base.
Qu’est-ce que l’API GLM-5.3 Flash ?
GLM-5.3 Flash est le modèle multimodal natif axé sur l’efficacité de Z.ai au sein de la famille GLM-5. Il expose des capacités de raisonnement, de long contexte, de compréhension visuelle et d’orientation agent via une API de chat. Le modèle contient 320B de paramètres au total mais en active 18B par token ; cette architecture est importante pour le coût, mais les développeurs perçoivent surtout un modèle capable de rester actif sur de longues invites et des appels d’outils répétés.
Ce guide réduit volontairement la couverture de l’architecture et des benchmarks. L’article de présentation du modèle compagnon explique déjà la conception d’attention hybride, les poids ouverts, la matrice complète de benchmarks de lancement, le contexte de tarification et la comparaison de la famille de modèles. Ici, l’accent est mis sur le comportement d’intégration et les décisions de production.
Spécifications API impactant l’intégration
| Spécification API | Valeur | Signification pratique |
|---|---|---|
| Base URL | https://api.cometapi.com/v1 | Configurez ceci une fois dans le client côté serveur. |
| Endpoint | POST /v1/chat/completions | Utilisez la route de chat-completions compatible OpenAI. |
| SDK compatibles | Clients Python et JavaScript compatibles OpenAI | Réutilisez des schémas clients familiers avec la Base URL CometAPI. |
| Authentification | Clé API Bearer | Conservez la clé dans une variable d’environnement côté serveur ou un gestionnaire de secrets. |
| Code du modèle | glm-5.3-flash | Utilisez exactement cette valeur dans le corps de la requête. |
| Fenêtre de contexte | 1 048 576 tokens | Adaptée aux grands dépôts, lots de documents et longues historiques d’agents. |
| Sortie maximale | Jusqu’à 131 072 tokens | Définissez un plafond spécifique à l’application pour contrôler coût et latence. |
| Entrées natives | Texte, image, vidéo, fichier | Le support des routes hébergées peut varier ; validez la route CometAPI exacte avant d’en dépendre. |
| Sortie | Texte | Le modèle interprète les médias mais ne retourne pas directement des images ou vidéos générées. |
| Raisonnement | low, high, max | Utilisez des niveaux d’effort pour échanger latence et tokens contre profondeur. |
| Thinking | Toujours activé | N’envoyez pas de paramètre cherchant à désactiver le thinking. |
| Fonctions dev | Streaming, function calling, caching, structured output | Utile pour les apps interactives, agents et pipelines lisibles par machine. |
La capacité du modèle et celle de la passerelle ne sont pas identiques. Considérez la page du modèle en ligne CometAPI et le schéma de l’API comme le contrat de la route que vous appelez réellement, en particulier pour la vidéo, les fichiers, le JSON Schema strict et les champs de thinking spécifiques au fournisseur.
Contexte de performance bref
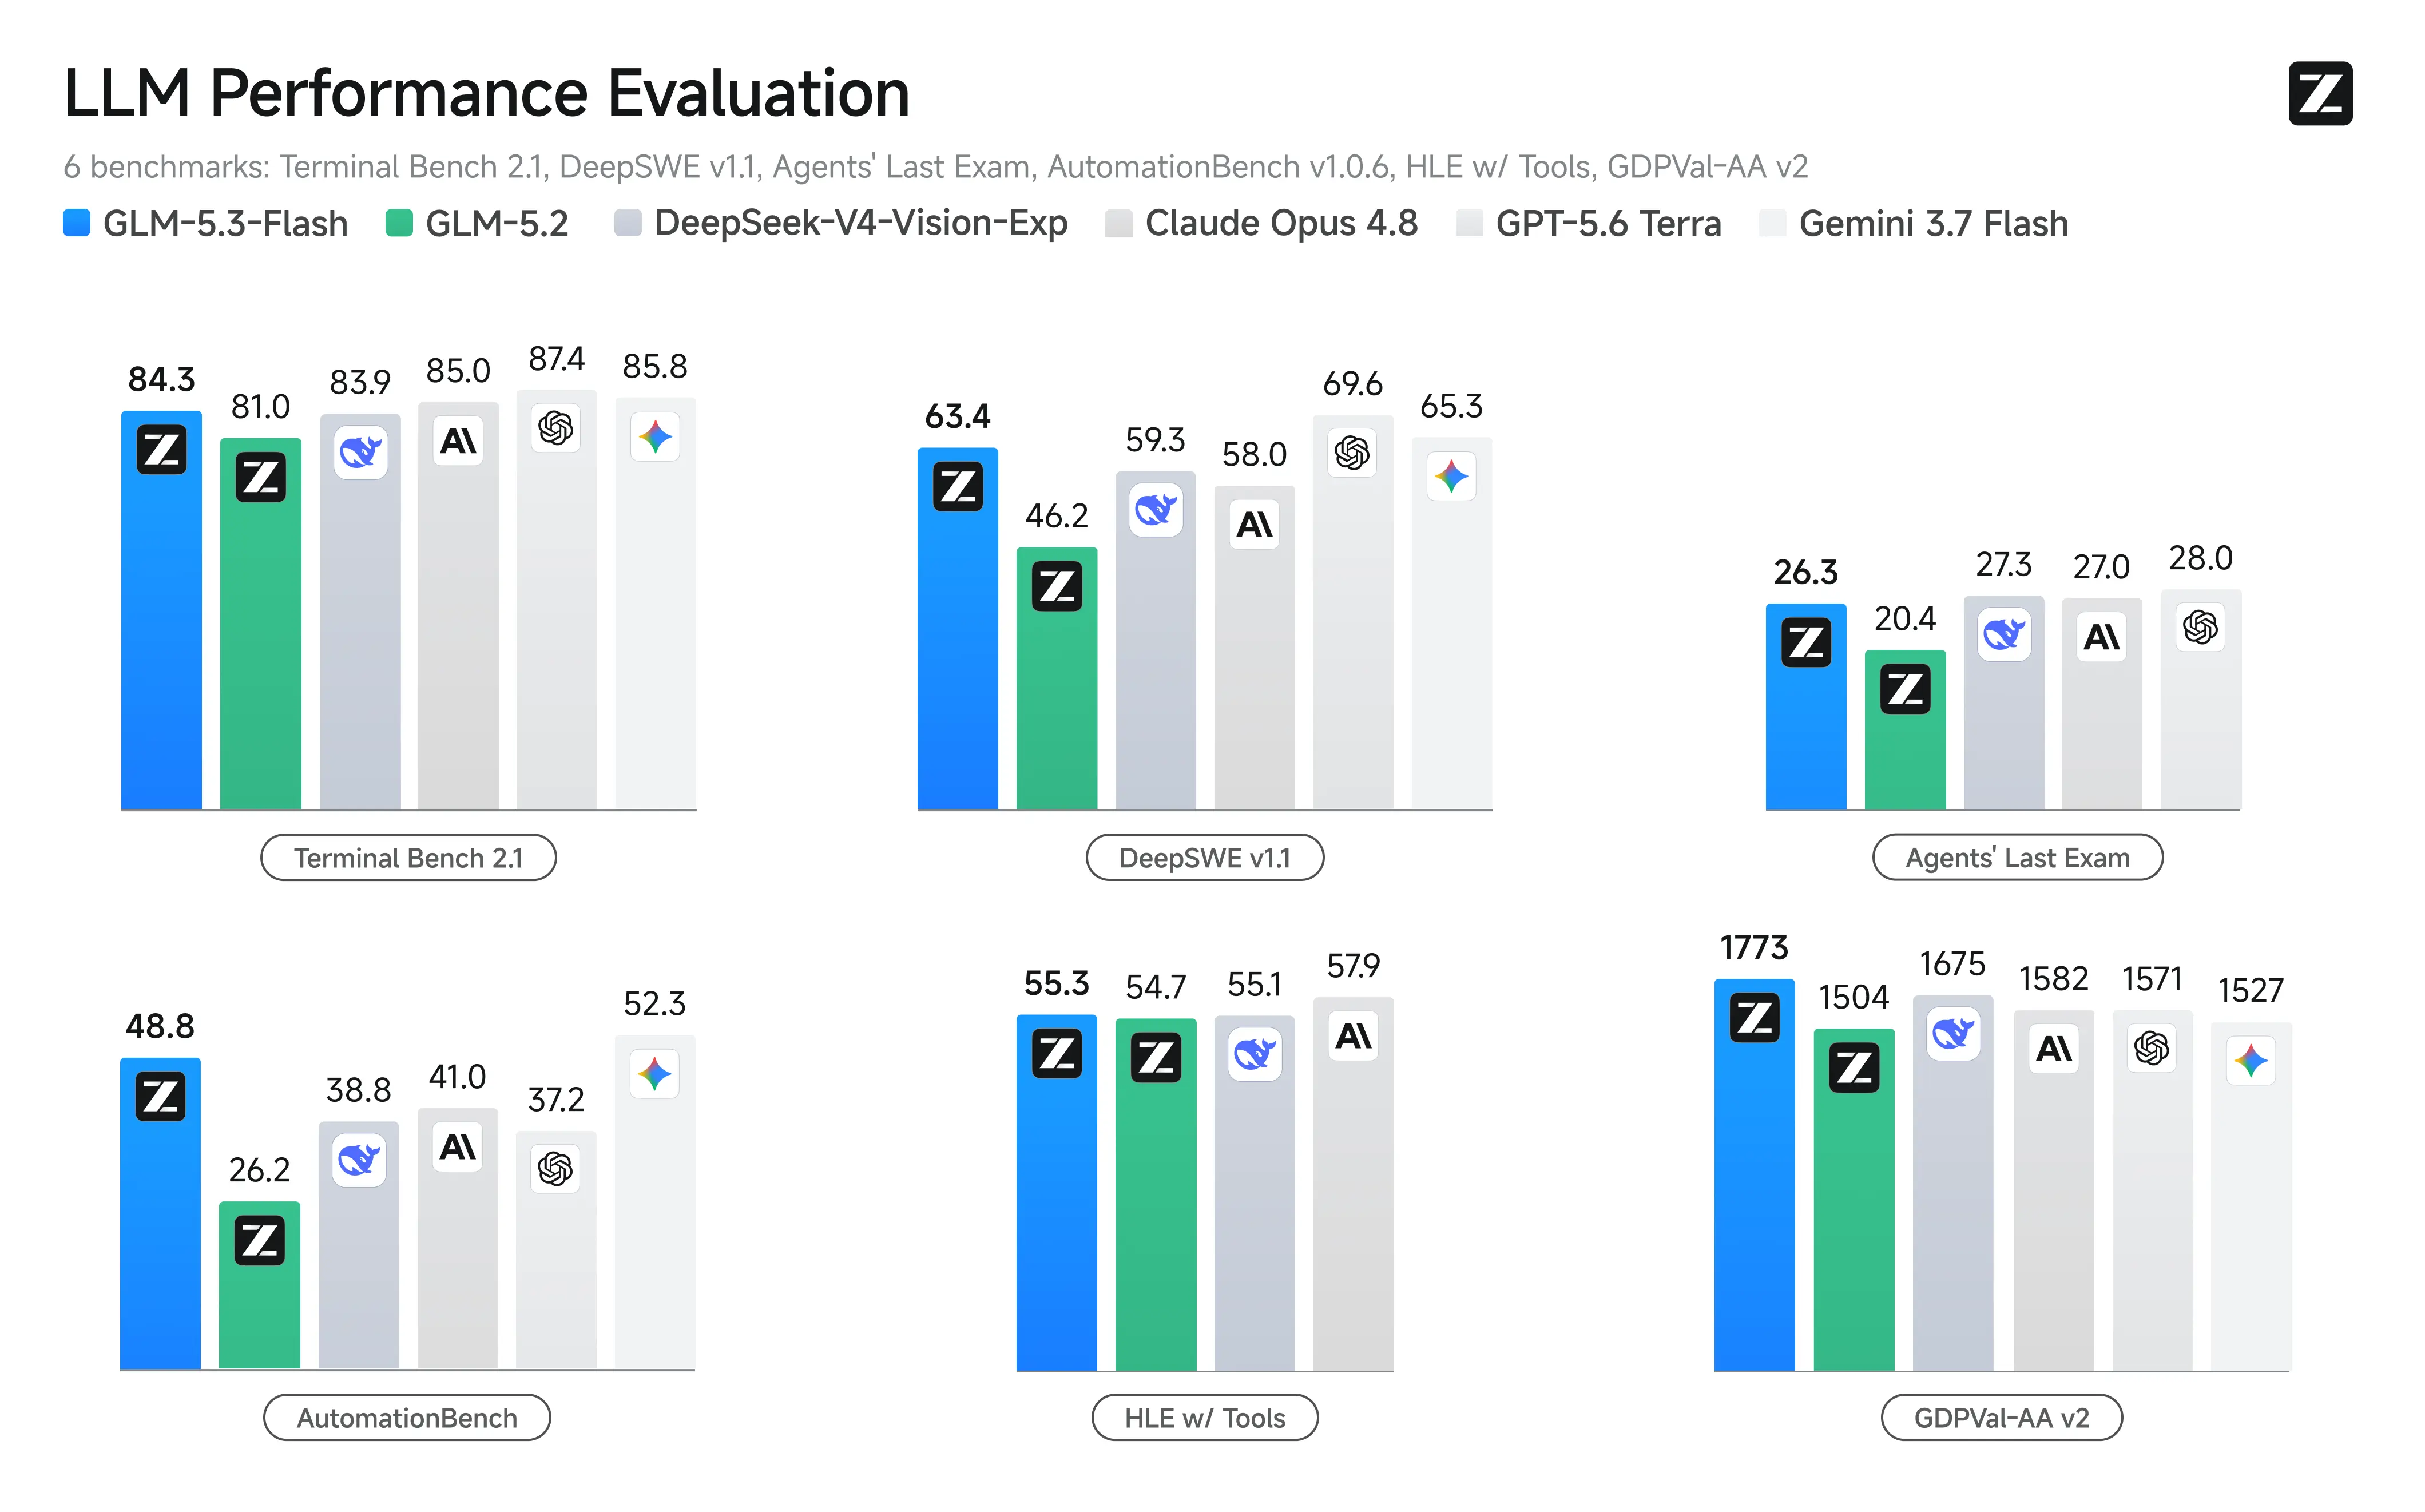
Z.ai rapporte de solides résultats de lancement sur les tâches qui comptent pour les bâtisseurs d’API : travail en terminal, ingénierie logicielle, utilisation d’outils et automatisation. Ce sont des scores fournis par le vendeur obtenus avec des harnais et politiques d’outils spécifiques ; ils aident donc à identifier des forces probables plutôt qu’à établir un classement universel.
| Benchmark | GLM-5.3 Flash | Ce que cela suggère pour les charges API |
|---|---|---|
| Terminal-Bench 2.1 | 84.3 | Fort adéquation pour des agents orientés terminal. |
| DeepSWE v1.1 | 63.4 | Prometteur pour l’ingénierie logicielle à l’échelle du dépôt. |
| Toolathlon Verified | 78.4 | Fort signal de sélection et d’utilisation d’outils. |
| AutomationBench | 48.8 | Automatisation multi-étapes améliorée vs prédécesseur. |
L’implication pratique est plus étroite que le tableau de benchmarks : GLM-5.3 Flash est un bon candidat lorsque le workflow combine long contexte, outils ou retour visuel. Pour une comparaison complète des modèles, utilisez l’aperçu du modèle existant plutôt que de le dupliquer ici.
Source : Graphique officiel de benchmark Z.ai
Le graphique officiel de benchmark compare les performances de GLM-5.3 Flash selon le modèle et les réglages d’effort. Pour ce guide API, il apporte un contexte concis plutôt que de répéter la matrice complète de lancement. Les applications doivent néanmoins mesurer la réussite des tâches, la latence de bout en bout et l’usage total de tokens sur leurs propres invites.
Pourquoi utiliser GLM-5.3 Flash via CometAPI ?
CometAPI expose GLM-5.3 Flash via une interface compatible OpenAI. Cela permet à une équipe de réutiliser des schémas SDK familiers, centraliser les identifiants et la facturation, et changer de modèle sans reconstruire toute la couche de requêtes.
• Un seul schéma d’intégration. Le même client de base peut appeler différents modèles pris en charge en changeant l’ID du modèle.
• Visibilité centralisée de l’usage. Les équipes peuvent examiner l’usage et le coût sans maintenir un tableau de bord distinct par fournisseur.
• Évaluation plus rapide. Un seul harnais de requêtes peut comparer qualité des réponses, latence et erreurs entre modèles candidats.
• Conception de repli simplifiée. Les applications peuvent conserver la logique de retry et de routage dans une seule couche passerelle.
• Prix de route affiché plus bas. La page actuelle du modèle indique 0,06 $ par million de tokens d’entrée et 0,20 $ par million de tokens de sortie ; vérifiez la page en ligne avant de budgéter.
Avant de commencer
Vous avez besoin d’un compte CometAPI, d’une clé API et de l’un des environnements locaux suivants :
• Python 3.9 ou version ultérieure avec pip
• Node.js 18 ou version ultérieure avec npm
• cURL pour un test minimal en ligne de commande
Ne placez jamais une clé CometAPI de production dans du JavaScript côté navigateur, une application mobile, un dépôt public, une capture d’écran ou des journaux côté client. Appelez CometAPI depuis un serveur de confiance et conservez la clé dans une variable d’environnement ou un gestionnaire de secrets.
Comment utiliser l’API GLM-5.3 Flash avec CometAPI
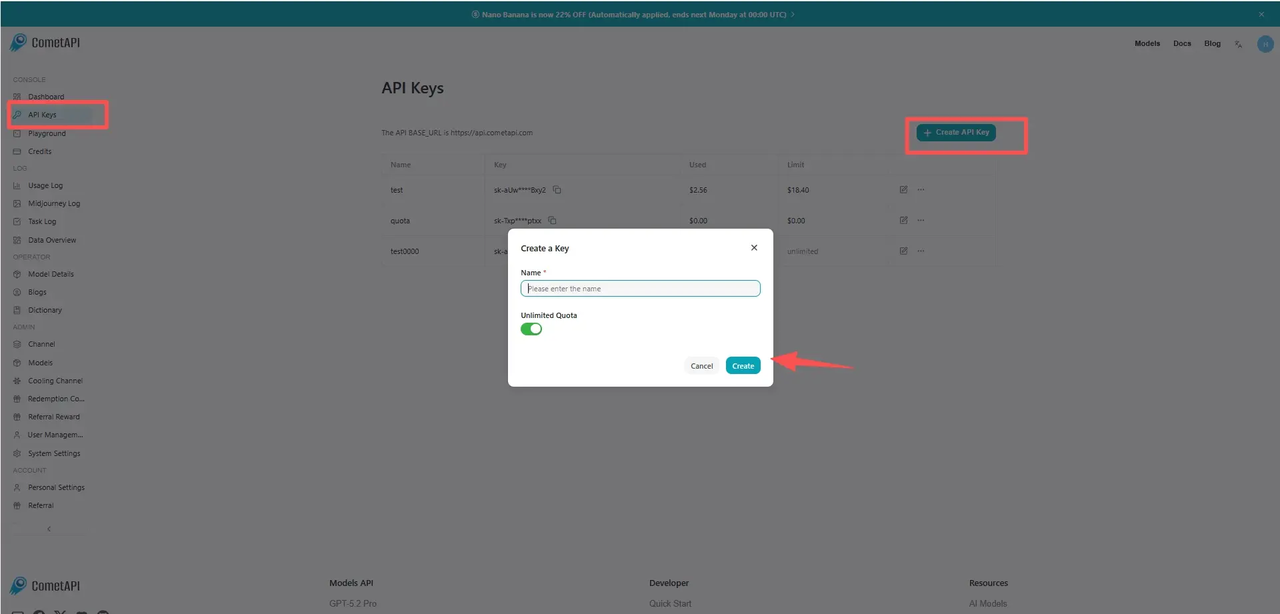
Étape 1 : Créer une clé API CometAPI
Connectez-vous à CometAPI, ouvrez la console des clés API, créez une clé et copiez-la une fois dans votre flux de gestion des secrets. Utilisez une clé distincte pour le développement et la production afin de pouvoir en faire la rotation ou la révoquer dans un environnement sans interrompre l’autre.
Source : Image officielle du guide de clé API CometAPI
Étape 2 : Stocker la clé comme variable d’environnement
$env:COMETAPI_KEY = "your_cometapi_key_here"
export COMETAPI_KEY="your_cometapi_key_here"
Pour la production, remplacez l’historique shell par un secret de déploiement, un secret de conteneur ou un coffre géré.

### Étape 3 : Installer un SDK compatible OpenAI
python -m pip install --upgrade openai
npm install openai
```

### Étape 4 : Faire la première requête avec cURL

```
curl https://api.cometapi.com/v1/chat/completions \
  -H "Authorization: Bearer $COMETAPI_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.3-flash",
    "messages": [
      {
        "role": "system",
        "content": "Vous êtes un assistant technique précis."
      },
      {
        "role": "user",
        "content": "Explique trois usages pratiques d’une fenêtre de contexte d’un million de tokens."
      }
    ],
    "max_completion_tokens": 800
  }'
```

Une réponse réussie contient un message assistant sous choices[0].message.content ainsi que des métadonnées d’usage lorsque la route les renvoie. Commencez par cette petite requête avant d’ajouter des paramètres optionnels.

### Étape 5 : Appeler l’API depuis Python

```
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["COMETAPI_KEY"],
    base_url="https://api.cometapi.com/v1",
    timeout=60.0,
    max_retries=2,
)

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "Vous êtes un assistant technique précis.",
        },
        {
            "role": "user",
            "content": "Passe en revue ce plan de migration et dresse la liste des cinq principaux risques.",
        },
    ],
    max_completion_tokens=1200,
)

print(completion.choices[0].message.content)
print(completion.usage)
```

### Étape 6 : Appeler l’API depuis JavaScript

```
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.COMETAPI_KEY,
  baseURL: "https://api.cometapi.com/v1",
  timeout: 60_000,
  maxRetries: 2,
});

const completion = await client.chat.completions.create({
  model: "glm-5.3-flash",
  messages: [
    { role: "system", content: "Vous êtes un assistant technique précis." },
    { role: "user", content: "Rédige une checklist de déploiement sûr pour cette API." },
  ],
  max_completion_tokens: 1200,
});

console.log(completion.choices[0].message.content);
console.log(completion.usage);
```

## Comment contrôler l’effort de raisonnement

La [documentation officielle du modèle](https://docs.z.ai/guides/vlm/glm-5.3-flash) prend en charge [les efforts low, high et max](https://docs.z.ai/guides/vlm/glm-5.3-flash). [Le thinking reste activé](https://docs.z.ai/guides/vlm/glm-5.3-flash) ; le réglage d’effort modifie la quantité de budget de raisonnement que le modèle peut utiliser.

| Effort | Bonnes charges de départ                          | Compromis                                             |
| ------ | ------------------------------------------------- | ----------------------------------------------------- |
| low    | Classification, réécriture, extraction courte     | Latence et tokens de sortie plus faibles ; moins de profondeur. |
| high   | Revue de code, planification, analyse de document | Équilibre par défaut pour de nombreuses tâches de production.   |
| max    | Débogage complexe, agents à outils, raisonnement difficile | Profondeur maximale ; latence et coût potentiellement plus élevés. |

```
completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": "Identifie des modes de défaillance cachés dans ce plan de déploiement distribué.",
        }
    ],
    max_completion_tokens=1800,
    extra_body={"reasoning_effort": "high"},
)

print(completion.choices[0].message.content)
```

*Si le SDK installé expose reasoning_effort comme argument de premier ordre, vous pouvez le passer directement. Si la route CometAPI rejette un champ spécifique au fournisseur, supprimez-le et utilisez la valeur par défaut de la route. N’essayez pas de désactiver le thinking.*

## Comment diffuser des réponses en streaming

Le streaming est utile pour le chat, les assistants de codage et les longues analyses, car il permet d’afficher la sortie à mesure qu’elle arrive. Il ne réduit pas le nombre total de tokens générés ; conservez donc les mêmes plafonds de sortie et contrôles de coût.

### Streaming Python

**Python**

```
stream = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {"role": "user", "content": "Crée un plan de migration de base de données en plusieurs étapes."}
    ],
    max_completion_tokens: 1600,
    stream=True,
)

for chunk in stream:
    delta = chunk.choices[0].delta
    if delta.content:
        print(delta.content, end="", flush=True)
print()
```

### Streaming JavaScript

**JavaScript**

```
const stream = await client.chat.completions.create({
  model: "glm-5.3-flash",
  messages: [
    { role: "user", content: "Crée un plan de migration de base de données en plusieurs étapes." },
  ],
  max_completion_tokens: 1600,
  stream: true,
});

for await (const chunk of stream) {
  const text = chunk.choices[0]?.delta?.content ?? "";
  process.stdout.write(text);
}
```

• Gérer l’annulation. Arrêtez de lire le flux lorsque le client se déconnecte et annulez le travail en amont lorsque c’est pris en charge.

• Mettre en tampon en sécurité. Ne supposez pas que chaque fragment contient un mot complet, un token JSON ou un objet d’appel d’outil complet.

• Enregistrer l’usage final. L’usage peut n’apparaître que dans l’événement final ou des métadonnées spécifiques à la route.

## Comment envoyer des images

[GLM-5.3 Flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) accepte du contenu visuel via des blocs image_url dans messages[].content[]. La documentation officielle recommande une URL d’image accessible ou une Data URL Base64. La page du modèle CometAPI identifie la capacité image-vers-texte, mais les applications doivent tout de même tester formats, taille de fichier et comportement de la route avant la production.

### Analyser une URL d’image

**Python**

```
completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": "https://example.com/dashboard.png"
                    },
                },
                {
                    "type": "text",
                    "text": (
                        "Passe en revue ce tableau de bord. Identifie les problèmes d’utilisabilité, "
                        "les métriques ambiguës et les risques possibles de qualité des données."
                    ),
                },
            ],
        }
    ],
    max_completion_tokens=1500,
)

print(completion.choices[0].message.content)
```

### Envoyer une image locale en Base64

**Python**

```
import base64
import mimetypes
from pathlib import Path

image_path = Path("dashboard.png")
mime_type = mimetypes.guess_type(image_path.name)[0] or "image/png"
encoded = base64.b64encode(image_path.read_bytes()).decode("utf-8")

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "user",
            "content": [
                {
                    "type": "image_url",
                    "image_url": {
                        "url": f"data:{mime_type};base64,{encoded}"
                    },
                },
                {
                    "type": "text",
                    "text": "Extrais le titre du graphique, les axes et la tendance principale.",
                },
            ],
        }
    ],
    max_completion_tokens=1000,
)

print(completion.choices[0].message.content)
```

• Rognez les espaces blancs non pertinents avant d’encoder une image.

• Réduisez les images beaucoup plus grandes que l’information inspectée.

• Posez une question visuelle spécifique plutôt que de demander une description générique.

• Ne supposez pas qu’une URL de page publique est une URL d’image directe.

• Testez l’ordre de plusieurs images, car chaque image doit être clairement référencée dans l’invite.

## Comment demander du JSON structuré

La sortie structurée est précieuse lorsque le composant suivant est du code plutôt qu’un lecteur humain. Utilisez un schéma étroit, validez le résultat et gardez un repli pour les routes qui n’exposent pas un JSON Schema strict sous exactement la même forme.

**Python**

```
import json

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "Retourne uniquement du JSON valide.",
        },
        {
            "role": "user",
            "content": (
                "Extrait l’équipement, la gravité, le symptôme observé et l’action suivante "
                "de ce rapport : Le feeder 12 a montré des pics répétés de courant de séquence zéro "
                "après la pluie ; inspecte l’isolation et compare les sections adjacentes."
            ),
        },
    ],
    response_format={"type": "json_object"},
    max_completion_tokens=800,
)

data = json.loads(completion.choices[0].message.content)
required = {"equipment", "severity", "symptom", "next_action"}
missing = required.difference(data)
if missing:
    raise ValueError(f"Missing fields: {sorted(missing)}")

print(data)
```

*Le mode JSON n’élimine pas le besoin de validation. Vérifiez les champs requis, les types, les valeurs autorisées et les longueurs maximales avant de stocker le résultat ou de déclencher un autre système.*

## Comment utiliser le Function Calling

Le function calling permet au modèle de décider quand il a besoin de données externes, tandis que le code de l’application reste responsable de l’autorisation et de l’exécution. Le schéma sûr est : le modèle propose un appel d’outil, le serveur le valide, le serveur exécute l’outil et le modèle reçoit le résultat.

**Python**

```
import json

completion = client.chat.completions.create(
    model="glm-5.3-flash",
    messages=[
        {
            "role": "system",
            "content": "Retourne uniquement du JSON valide.",
        },
        {
            "role": "user",
            "content": (
                "Extrait l’équipement, la gravité, le symptôme observé et l’action suivante "
                "de ce rapport : Le feeder 12 a montré des pics répétés de courant de séquence zéro "
                "après la pluie ; inspecte l’isolation et compare les sections adjacentes."
            ),
        },
    ],
    response_format={"type": "json_object"},
    max_completion_tokens=800,
)

data = json.loads(completion.choices[0].message.content)
required = {"equipment", "severity", "symptom", "next_action"}
missing = required.difference(data)
if missing:
    raise ValueError(f"Missing fields: {sorted(missing)}")

print(data)
```

• Validez les arguments. Traitez le JSON d’appel d’outil comme une entrée non fiable.

• Faites respecter l’autorisation. Le modèle ne décide pas de ce que l’utilisateur actuel est autorisé à faire.

• Séparez les outils de lecture et d’écriture. Exigez une confirmation pour les actions destructrices ou visibles à l’extérieur.

• Limitez l’inventaire d’outils. Exposez uniquement les outils pertinents au workflow actuel.

• Limitez la boucle. Fixez un maximum de tours d’outils, de tokens totaux, de temps écoulé et de coût.

## Paramètres de l’API [GLM-5.3 Flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/)

| Paramètre              | Objectif                          | Recommandations pratiques                              |
| ---------------------- | --------------------------------- | ------------------------------------------------------ |
| model                  | Sélectionne la route du modèle    | Utilisez glm-5.3-flash.                                |
| messages               | Conversation et entrée multimodale | Conservez l’ordre des rôles ; préservez les messages d’outil requis. |
| max_completion_tokens  | Plafonne la sortie générée        | Définissez-le par workflow au lieu de compter sur le maximum du modèle. |
| temperature            | Comportement d’échantillonnage    | La recommandation officielle est 1.                    |
| top_p                  | Nucleus sampling                  | La recommandation officielle est 0,95.                 |
| reasoning_effort       | Budget de raisonnement            | Utilisez low, high ou max ; testez le support de la route. |
| stream                 | Sortie incrémentale               | Utilisez true pour des réponses interactives.          |
| tools                  | Définitions de fonctions          | Gardez des schémas étroits et validez chaque appel.    |
| tool_choice            | Contrôle la sélection d’outils    | Commencez par auto sauf si le workflow exige un outil. |
| response_format        | Demande une sortie lisible par machine | Validez le support et le JSON retourné.            |

## API directe Z.ai vs CometAPI

Les deux routes peuvent convenir. La décision tient surtout à la propriété de l’intégration, l’étendue des modèles, la facturation et la rapidité avec laquelle l’application a besoin de fonctionnalités natives du fournisseur.

| Dimension       | API directe Z.ai                                 | CometAPI                                           | Résultat pratique                                               |
| --------------- | ------------------------------------------------- | -------------------------------------------------- | --------------------------------------------------------------- |
| Compte et clé   | Compte et clé Z.ai                                | Compte et clé CometAPI                             | Les clés ne sont pas interchangeables.                          |
| Schéma SDK      | Compatible OpenAI                                 | Compatible OpenAI                                  | Beaucoup de code client peut être réutilisé.                    |
| Couverture de modèles | Famille de modèles Z.ai                     | Plusieurs fournisseurs et familles de modèles      | CometAPI est utile pour le routage et la comparaison.           |
| Fonctionnalités natives | Accès le plus tôt au comportement spécifique fournisseur | Dépend de l’exposition et du pass-through par la passerelle | Testez les champs avancés sur la route sélectionnée.        |
| Facturation     | Spécifique au fournisseur                         | Centralisée sur les modèles pris en charge         | Une facturation unifiée peut simplifier les opérations multi-modèles. |
| Conception de repli | Nécessite une autre intégration fournisseur   | Peut rester dans une seule couche passerelle       | CometAPI peut réduire la friction de bascule.                   |
| Meilleur choix  | Engagement profond envers les capacités natives Z.ai | Accès unifié, évaluation et routage de production | Choisissez selon l’architecture du système, pas un « gagnant » générique. |

Utilisez l’API directe lorsque le paramètre natif le plus récent du fournisseur ou une fonctionnalité produit est essentiel. Utilisez CometAPI lorsque l’unicité du client, la facturation unifiée et la capacité à comparer ou remplacer des modèles comptent davantage. En production, exécutez la même suite de tests représentative contre la route exacte que vous prévoyez de déployer.

## Estimation des coûts et budgétisation des tokens

La [page du modèle CometAPI](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) actuelle indique [0,06 $ par million de tokens d’entrée](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) et [0,20 $ par million de tokens de sortie](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/). À ces tarifs, le coût estimé d’une requête est :

cost = input_tokens / 1,000,000 x 0.06 + output_tokens / 1,000,000 x 0.20

| Charge de travail       | Tokens d’entrée | Tokens de sortie | Coût estimé |
| ----------------------- | --------------- | ---------------- | ----------- |
| Question courte         | 2 000           | 400              | 0,00020 $   |
| Revue de code           | 50 000          | 4 000            | 0,00380 $   |
| Analyse de grand document | 250 000       | 10 000           | 0,01700 $   |
| Long run d’agent        | 800 000         | 30 000           | 0,05400 $   |

*Les prix évoluent dans le temps. Confirmez les tarifs en ligne d’entrée, d’entrée mise en cache et de sortie avant publication ou budgétisation de production. Le raisonnement et les boucles d’outils peuvent augmenter la sortie facturée et les entrées répétées ; estimez des workflows complets plutôt qu’une seule réponse visible.*

## Bonnes pratiques de production pour l’API GLM-5.3 Flash

### Contrôles de coût et de latence

#### Plafonds de sortie

Les réglages de génération de benchmark et les limites API en production diffèrent. L’évaluation HLE citée utilisait une longueur de génération maximale de 163 840 tokens, tandis que certaines évaluations utilisaient 64K de sorties ; aucun de ces réglages ne prouve que chaque route API hébergée peut retourner plus de 100 000 tokens. Fixez le plafond à partir du schéma de la route en ligne et du budget du workflow. Utilisez de petits plafonds pour la classification et l’extraction, des plafonds moyens pour l’analyse, et plus grands uniquement pour des tâches de longue durée ou des agents explicites.

**Contrôle du contexte**

Une fenêtre d’un million de tokens est une capacité, pas une cible. Récupérez les fichiers pertinents, retirez les journaux dupliqués, placez des instructions stables près du début et mesurez si un contexte supplémentaire améliore la réussite des tâches.

### État et fiabilité

#### Préserver l’état

Stockez les messages assistant complets nécessaires au tour suivant, y compris les appels d’outils et les champs spécifiques à la route que votre application a validés. Supprimer un historique structuré peut casser une boucle d’outils multi-étapes, même quand le texte visible semble complet.

#### Relancer sélectivement

• Relancez les erreurs transitoires 429, 500, 502, 503 et les timeouts réseau avec backoff exponentiel et jitter.

• Ne relancez pas sans discernement les erreurs d’authentification, paramètres invalides ou requêtes trop volumineuses.

• Attachez un ID de requête d’application afin que le travail en double puisse être reconnu.

• Utilisez des contrôles d’idempotence autour des opérations d’écriture externes, même si la requête modèle elle-même est relancée.

### Sécurité et validation

#### Valider les sorties lisibles par machine

La validation de schéma, les contrôles de valeurs autorisées, les limites de longueur et les règles de domaine doivent s’insérer entre le modèle et toute base de données, file d’attente ou API externe. Un JSON object syntaxiquement valide peut encore être incomplet ou non sûr.

#### Autoriser les appels d’outils

Traitez les appels d’outils proposés par le modèle comme des requêtes non fiables : validez les arguments, appliquez l’autorisation utilisateur, séparez lecture et écriture, et exigez une confirmation pour les actions destructrices.

### Observabilité et repli

#### Mesurer le workflow

• Taux de réussite des tâches ou d’acceptation humaine

• Temps jusqu’au premier token et latence totale

• Tokens d’entrée, d’entrée mise en cache, de raisonnement et de sortie

• Nombre d’appels d’outils et taux d’échec des outils

• Relances, limites de taux et erreurs fournisseur

• Coût par tâche complétée plutôt que coût par appel API isolé

#### Concevoir le repli

Choisissez un repli par charge de travail, pas par réputation. Un repli texte uniquement peut convenir à l’extraction de documents mais échouer pour une tâche basée sur capture d’écran. Définissez quelles entrées et schémas d’outils sont portables, quels paramètres doivent être supprimés, et quand l’utilisateur doit voir une erreur récupérable plutôt qu’un basculement automatique de modèle.

## Erreurs courantes et dépannage

| Symptôme                | Cause probable                                                | Points à vérifier                                                                 |
| ---------------------- | ------------------------------------------------------------- | --------------------------------------------------------------------------------- |
| 401 Unauthorized       | Clé manquante, mal formée ou révoquée                         | Confirmez l’en-tête Authorization et la variable d’environnement côté serveur.    |
| 404 ou modèle introuvable | Mauvais ID de modèle ou route indisponible                 | Utilisez glm-5.3-flash et confirmez la disponibilité sur la page du modèle en ligne. |
| 429 Rate Limit         | Quota de requêtes ou de tokens dépassé                        | Réduisez la charge, diminuez la concurrence, inspectez les limites de compte, et relancez avec jitter. |
| Paramètre non pris en charge | Champ natif fournisseur non exposé par la passerelle    | Supprimez les champs optionnels, puis réajoutez-les un par un.                   |
| Contexte trop long     | Invite plus sortie demandée dépassent la limite de la route   | Réduisez, récupérez, résumez ou baissez max_completion_tokens.                    |
| Image invalide         | URL inaccessible, format non pris en charge ou Base64 invalide | Testez une URL d’image HTTPS directe et corrigez le préfixe MIME.                |
| JSON en flux cassé     | Les fragments ont été parsés comme objets complets            | Mettez en tampon le flux et parsez uniquement après réception du JSON complet.    |
| Boucle d’outils sans fin | Pas de budget de pas ou résultats d’outils ambigus          | Limitez les tours, améliorez les descriptions d’outils et retournez des erreurs explicites d’outil. |

## Quand utiliser l’API GLM-5.3 Flash ?

### Bonnes correspondances

• Compréhension de code à l’échelle du dépôt et revue multi-fichiers

• Codage visuel, analyse de captures d’écran et QA d’interface

• Lots de documents longs et synthèse étayée par des preuves

• Agents utilisant des outils avec planification et vérification répétées

• Workflows à volume élevé où le coût des tokens affecte l’économie unitaire

• Applications qui bénéficient de la comparaison ou du basculement de modèles via une seule passerelle

### Utiliser une autre route ou un autre modèle lorsque

• Le produit nécessite une sortie image ou vidéo plutôt qu’une sortie texte.

• La tâche est minuscule, à faible risque, et un plus petit modèle peut la gérer de manière fiable.

• Une fonctionnalité native du fournisseur est obligatoire mais non exposée sur la route passerelle.

• Le workflow ne tolère pas un raisonnement toujours actif ni son profil de latence associé.

• L’application n’a pas encore testé le modèle sur ses propres outils, données et cas d’échec.

## FAQ

###

### Que faut-il vérifier sur la route CometAPI exacte avant le lancement ?

Vérifiez la disponibilité du modèle, les formats multimodaux acceptés, la sortie maximale, les champs de raisonnement, le comportement de sortie structurée, les limites de taux et la tarification actuelle avec des requêtes représentatives.

### Quelles métriques une évaluation de production doit-elle suivre ?

Suivez la réussite des tâches, le temps jusqu’au premier token, la latence totale, les tokens d’entrée et de sortie, les échecs d’appel d’outils, le taux de relance, et le coût par workflow complété, pas seulement le coût par appel API.

### Comment choisir entre Z.ai direct et CometAPI ?

Utilisez Z.ai direct lorsque l’accès immédiat au comportement natif du fournisseur est essentiel. Utilisez CometAPI lorsque l’authentification unifiée, la facturation, la comparaison de modèles et le repli au niveau passerelle sont plus importants.

### Qu’est-ce qui rend un repli sûr ?

Un repli sûr accepte la même modalité d’entrée, préserve les schémas d’outils requis, supprime les paramètres non pris en charge, reste dans les limites d’autorisation de la tâche et échoue de manière visible lorsque le comportement ne peut pas être préservé.

## Conclusion

[GLM-5.3 Flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) est le plus utile via une API lorsque long contexte, entrée visuelle, raisonnement et utilisation d’outils font partie d’un même workflow. L’intégration CometAPI de base est petite : une clé côté serveur, un client compatible OpenAI, l’ID de modèle [glm-5.3-flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) et l’endpoint chat-completions. La qualité de production vient de tout ce qui entoure cette requête : invites cadrées, plafonds de sortie, validation de schéma, autorisation des outils, relances, observabilité et évaluation spécifique au workflow.

Commencez par un court appel texte, ajoutez une capacité avancée à la fois et testez le parcours utilisateur complet avant de monter en charge. Confirmez la page du [modèle GLM-5.3 Flash](https://www.cometapi.com/models/zhipuai/glm-5-3-flash/) en ligne pour la disponibilité actuelle, le comportement de la route prise en charge et la tarification.

## Métadonnées SEO

**Meta title :** Comment utiliser l’API GLM-5.3 Flash : guide développeur

**Meta description :** Apprenez à utiliser l’API GLM-5.3 Flash avec CometAPI, avec des exemples Python et JavaScript, la vision, le streaming, les outils, la sortie JSON et les bonnes pratiques.

**Keywords :** GLM-5.3 Flash API, comment utiliser GLM-5.3 Flash, GLM-5.3 Flash Python, GLM-5.3 Flash JavaScript, GLM-5.3 Flash CometAPI, tutoriel API GLM, API multimodale, API de raisonnement, function calling

**URL slug :** how-to-use-glm-5-3-flash-api