
TL;DR
Kimi K3.1 Pro est la mise à niveau de Moonshot AI du 24 octobre 2026 pour Kimi K3. Un post-entraînement supplémentaire améliore le codage autonome, la recherche financière et les workflows étendus d’utilisation d’outils, tout en conservant la même capacité de contexte d’environ un million de tokens.
Des évaluations indépendantes montrent des performances globales plus solides, et les tarifs officiels standard par token d’entrée/sortie baissent d’un tiers. La mise à niveau nécessite toutefois des tests de charge : un raisonnement plus profond peut augmenter la latence des tâches et la dépense totale, tandis que K3 garde une petite avance sur AA-LCR et propose des poids déjà disponibles pour l’auto-hébergement.
Principaux points à retenir
- Les gains les plus nets concernent l’exécution agentique. Artificial Analysis rapporte des scores Terminal-Bench 4.0 d’environ 67 % pour K3.1 Pro contre 13 % pour K3 ; les scores internes de Moonshot en recherche financière passent de 58,8 à 70,4.
- Des prix de token plus bas ne garantissent pas des coûts de tâche plus faibles. Les tarifs officiels standard d’entrée/sortie passent de 3 $/15 $ à 2 $/10 $ par million de tokens, mais un raisonnement supplémentaire, des appels d’outils et des réessais peuvent compenser l’économie.
- La fenêtre de contexte reste la même. Les deux modèles prennent en charge jusqu’à 1 048 576 tokens. K3 reste légèrement en tête dans l’évaluation AA-LCR v1.1 citée ; testez l’exactitude en long contexte sur vos propres documents.
- La disponibilité des poids peut déterminer le choix. Au 24 octobre 2026, les poids de K3 sont disponibles ; ceux de K3.1 Pro doivent être publiés d’ici le 4 novembre. Les équipes ayant besoin d’un auto-hébergement immédiat doivent en tenir compte.
Kimi K3.1 Pro vs Kimi K3 : vue d’ensemble et spécifications
Kimi K3.1 Pro s’appuie sur K3 via un post-entraînement supplémentaire, avec des améliorations ciblant le codage, la recherche financière et les workflows d’agent étendus. Les deux conservent un contexte d’environ un million de tokens. Les principales différences portent sur la performance des tâches, la tarification des tokens, les options de service et la disponibilité des poids.
| Spécification | Kimi K3.1 Pro | Kimi K3 |
|---|---|---|
| Développeur | Moonshot AI | Moonshot AI |
| Date de sortie | 24 octobre 2026 | 16 juillet 2026 |
| Architecture | MoE dérivé de K3, post-entraîné plus | MoE avec KDA, AttnRes |
| Taille du modèle | classe 3T et 104B de paramètres actifs | 2.8T au total et 104B de paramètres actifs |
| Fenêtre de contexte | Jusqu’à 1 048 576 tokens | Jusqu’à 1 048 576 tokens |
| Prix API standard entrée/sortie | 2 $ / 10 $ par million de tokens | 3 $ / 15 $ par million de tokens |
| Version Highspeed | Disponible | Aucune variante K3 Highspeed distincte n’est répertoriée |
| Disponibilité des poids | Publication prévue d’ici le 4 nov. 2026 | Disponible sous la licence Kimi K3 |
La disponibilité des poids reflète les informations disponibles au 24 octobre 2026. Les prix API sont en USD pour l’entrée et la sortie standard, hors frais d’écriture de cache, taxes et autres frais applicables.
Architecture et post-entraînement
K3 a introduit une architecture à 2,8 billions de paramètres combinant Kimi Delta Attention, Attention Residuals et Stable LatentMoE. Environ 104 milliards de paramètres sont activés par token.
Moonshot décrit K3.1 Pro comme une version post-entraînée de K3 développée avec une puissance de calcul de post-entraînement sensiblement plus élevée. La mise à niveau se concentre sur l’application des capacités du modèle à des tâches multi-étapes, notamment l’utilisation d’outils, le débogage et la vérification des résultats. L’annonce n’introduit pas d’architecture de base nommée séparément.
Capacités communes et exigences API
Les deux modèles prennent en charge les entrées multimodales, les appels d’outils, les sorties structurées et la mise en cache du contexte. Les formats d’images et de vidéos dépendent de la route API choisie. Les deux raisonnent toujours et prennent en charge un effort de raisonnement low, high et max, avec max par défaut.
Pour les conversations multi-tours et les appels d’outils, les intégrations doivent conserver l’intégralité des messages assistant, y compris le contenu de raisonnement et les appels d’outils, comme l’exige l’API. Les limites de contexte réelles et la disponibilité des fonctionnalités doivent également être vérifiées pour le fournisseur, le produit et le niveau d’abonnement sélectionnés.
Kimi K3.1 Pro vs Kimi K3 : performances
Les éléments proviennent des tests internes de Moonshot et des comparaisons rapportées, ainsi que d’évaluations indépendantes tierces.
Il convient de les interpréter séparément, car les harnais de benchmark, les jeux de tests, les réglages de raisonnement et les critères de notation peuvent différer.
L’évaluation de lancement d’Artificial Analysis indique une hausse de 11 points sur son indice composite Intelligence Index, avec des améliorations particulièrement importantes sur le codage en terminal et les workflows agentiques.
| Benchmark indépendant (Artificial Analysis) | Kimi K3 | Kimi K3.1 Pro | Différence |
|---|---|---|---|
| Intelligence Index | 44 | 55 | +11 |
| Terminal-Bench 4.0 | ~13% | ~67% | +54 points de pourcentage |
| AutomationBench-AA | 58% | 73% | +15 pp |
| GDPval-AA Elo | 1 534 | 1 846 | +312 |
| AA-Omniscience Index | 20 | 30 | +10 |
| Humanity's Last Exam | ~47% | ~52% | +5 pp |
| Taux d’hallucination AA-Omniscience | 53% | 44% | −9 pp |
| AA-LCR v1.1 | 88,7% | 86,3% | −2,4 pp |
Il s’agit de résultats d’évaluations indépendantes. Des valeurs arrondies sont utilisées lorsque l’évaluateur rapporte des scores arrondis. Des taux d’hallucination plus faibles sont préférables.
L’amélioration la plus importante concerne le codage basé sur terminal. K3.1 Pro est nettement meilleur sur les tâches nécessitant l’exécution de commandes, l’interaction avec l’environnement, le débogage et la validation répétée.
AutomationBench-AA montre également un gain significatif, suggérant une exécution plus solide dans les workflows SaaS.
Les benchmarks de sortie de Moonshot se concentrent sur le codage, la science, la reconstruction 3D, la finance, le travail de connaissance et les agents autonomes.
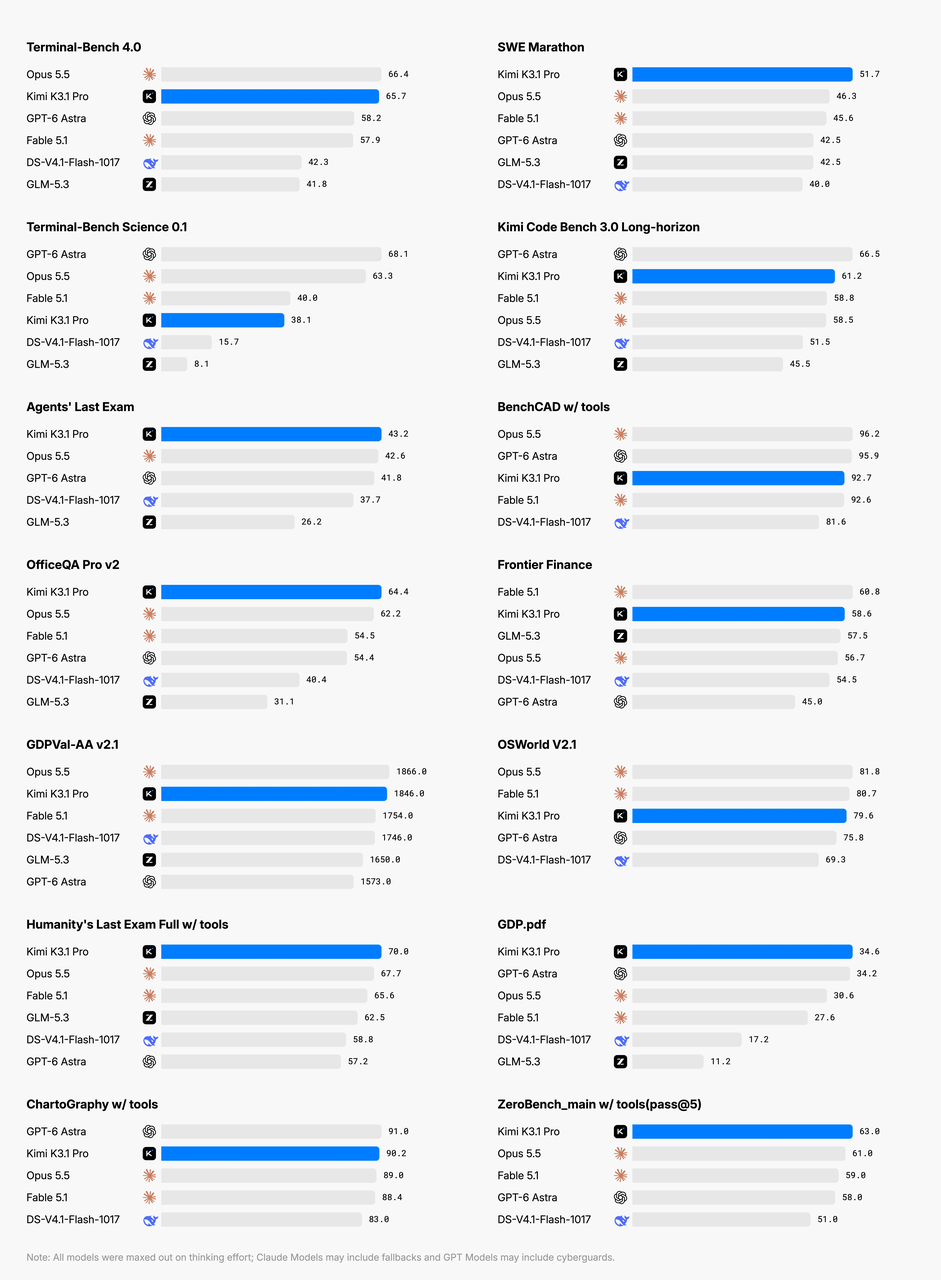
Les comparaisons sélectionnées incluent Claude Opus 5.5 et GPT-6 Astra. Comparez chaque résultat dans le cadre du benchmark nommé et de la configuration indiquée.
| Benchmark (Moonshot AI) | Kimi K3.1 Pro | Autre modèle | Score du modèle de comparaison |
|---|---|---|---|
| Terminal-Bench 4.0 | 65,7% | Claude Opus 5.5 | 66,4% |
| Terminal-Bench 4.0 | 65,7% | GPT-6 Astra | 58,2% |
| SWE-Marathon | 51,7% | Claude Opus 5.5 | 46,3% |
| Kimi Code Bench 3.0 | 61,2% | GPT-6 Astra | 66,5% |
| BenchCAD avec outils | 92,7% | Claude Opus 5.5 | 96,2% |
| OfficeQA Pro v2 | 64,4 | Claude Opus 5.5 | 62,2 |
| Frontier Finance | 58,6 | Claude Opus 5.5 | 56,7 |
| OSWorld 2.1 | 79,6% | Claude Opus 5.5 | 81,8% |
K3.1 Pro s’approche ou dépasse plusieurs modèles propriétaires de pointe sur des tâches sélectionnées. Mais il ne domine pas toutes les catégories.
Par exemple, il reste derrière Claude Opus 5.5 dans les comparaisons BenchCAD et OSWorld rapportées par le fournisseur, et le graphique officiel montre une faiblesse plus marquée sur Terminal-Bench Science.
Les configurations d’évaluation diffèrent : Artificial Analysis utilise le harnais mini-swe-agent pour Terminal-Bench 4.0, tandis que Moonshot utilise Claude Code. Comparez les scores au sein du même protocole de test ; les harnais, l’effort de raisonnement et les limites d’exécution peuvent influer sur les résultats.
Codage et génie logiciel
Pour le codage autonome complexe, K3.1 Pro est généralement le meilleur choix.
Les résultats internes de Moonshot sur Kimi Code Bench 3.0 Long-horizon augmentent de 55,95 % pour K3 à 61,2 % pour K3.1 Pro, soit un gain d’environ 5,25 points.
Les résultats indépendants de Terminal-Bench montrent également un gain substantiel. Ces tests évaluent l’exécution multi-étapes : compréhension d’un dépôt, modification de fichiers, exécution de commandes, diagnostic d’erreurs et vérification du résultat.
K3.1 Pro est le candidat le plus solide pour le développement multi-fichiers, le travail autonome en terminal et le débogage prolongé. Pour la simple génération de code, comparez les deux modèles sur vos propres tâches ; K3 reste l’option immédiate lorsque l’auto-hébergement est requis.
Une distinction importante est que les scores de benchmark de codage dépendent fortement du framework d’agent. Les outils, les invites, les limites d’exécution et les environnements de test influencent le résultat.
Pour le développement logiciel en production, la meilleure évaluation reste une comparaison contrôlée sur vos propres dépôts.
Recherche financière et opérations métiers
La modélisation financière offre certaines des comparaisons directes les plus claires entre les deux modèles.
Moonshot a testé K3 et K3.1 Pro sur des évaluations internes couvrant la construction de feuilles de calcul, la qualité de la recherche et des opérations métiers simulées.
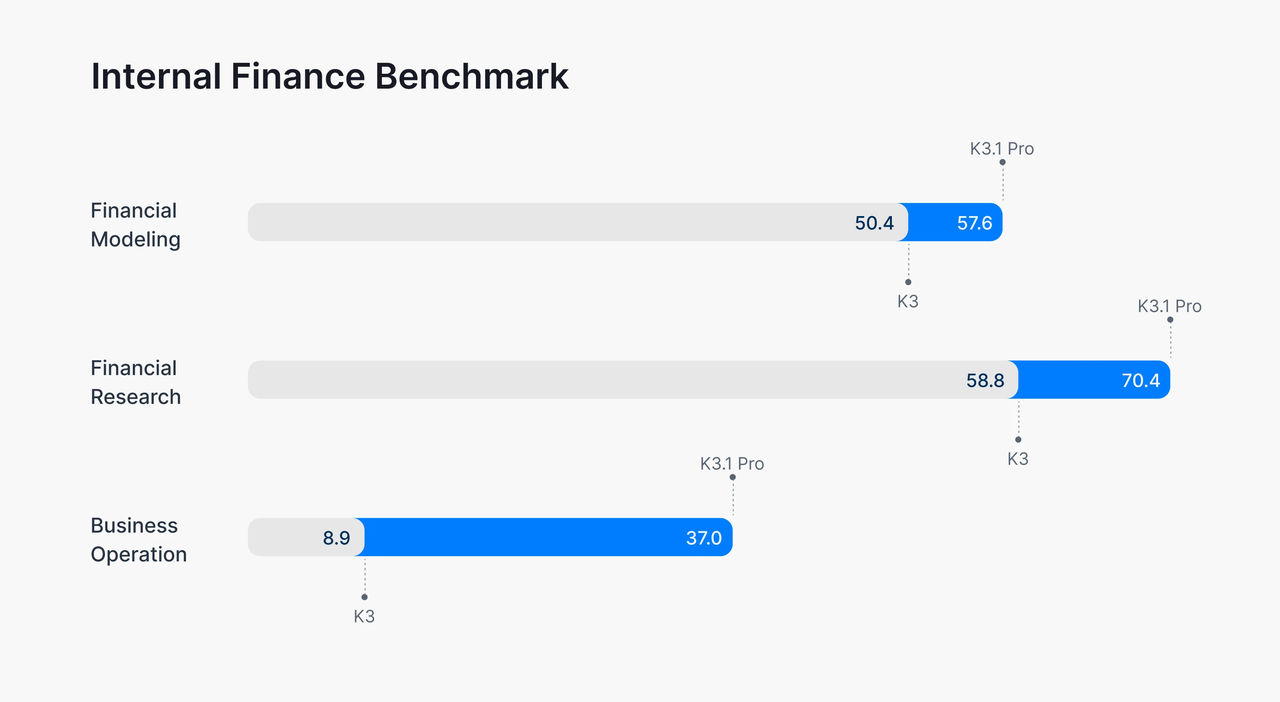
Les résultats financiers internes de Moonshot couvrent la modélisation financière, la recherche et des opérations métiers simulées. Ces scores de tâches rapportés par le fournisseur ne sont pas des mesures de rendement d’investissement. Les réglages par tâche ne doivent pas être supposés identiques à des benchmarks non liés.
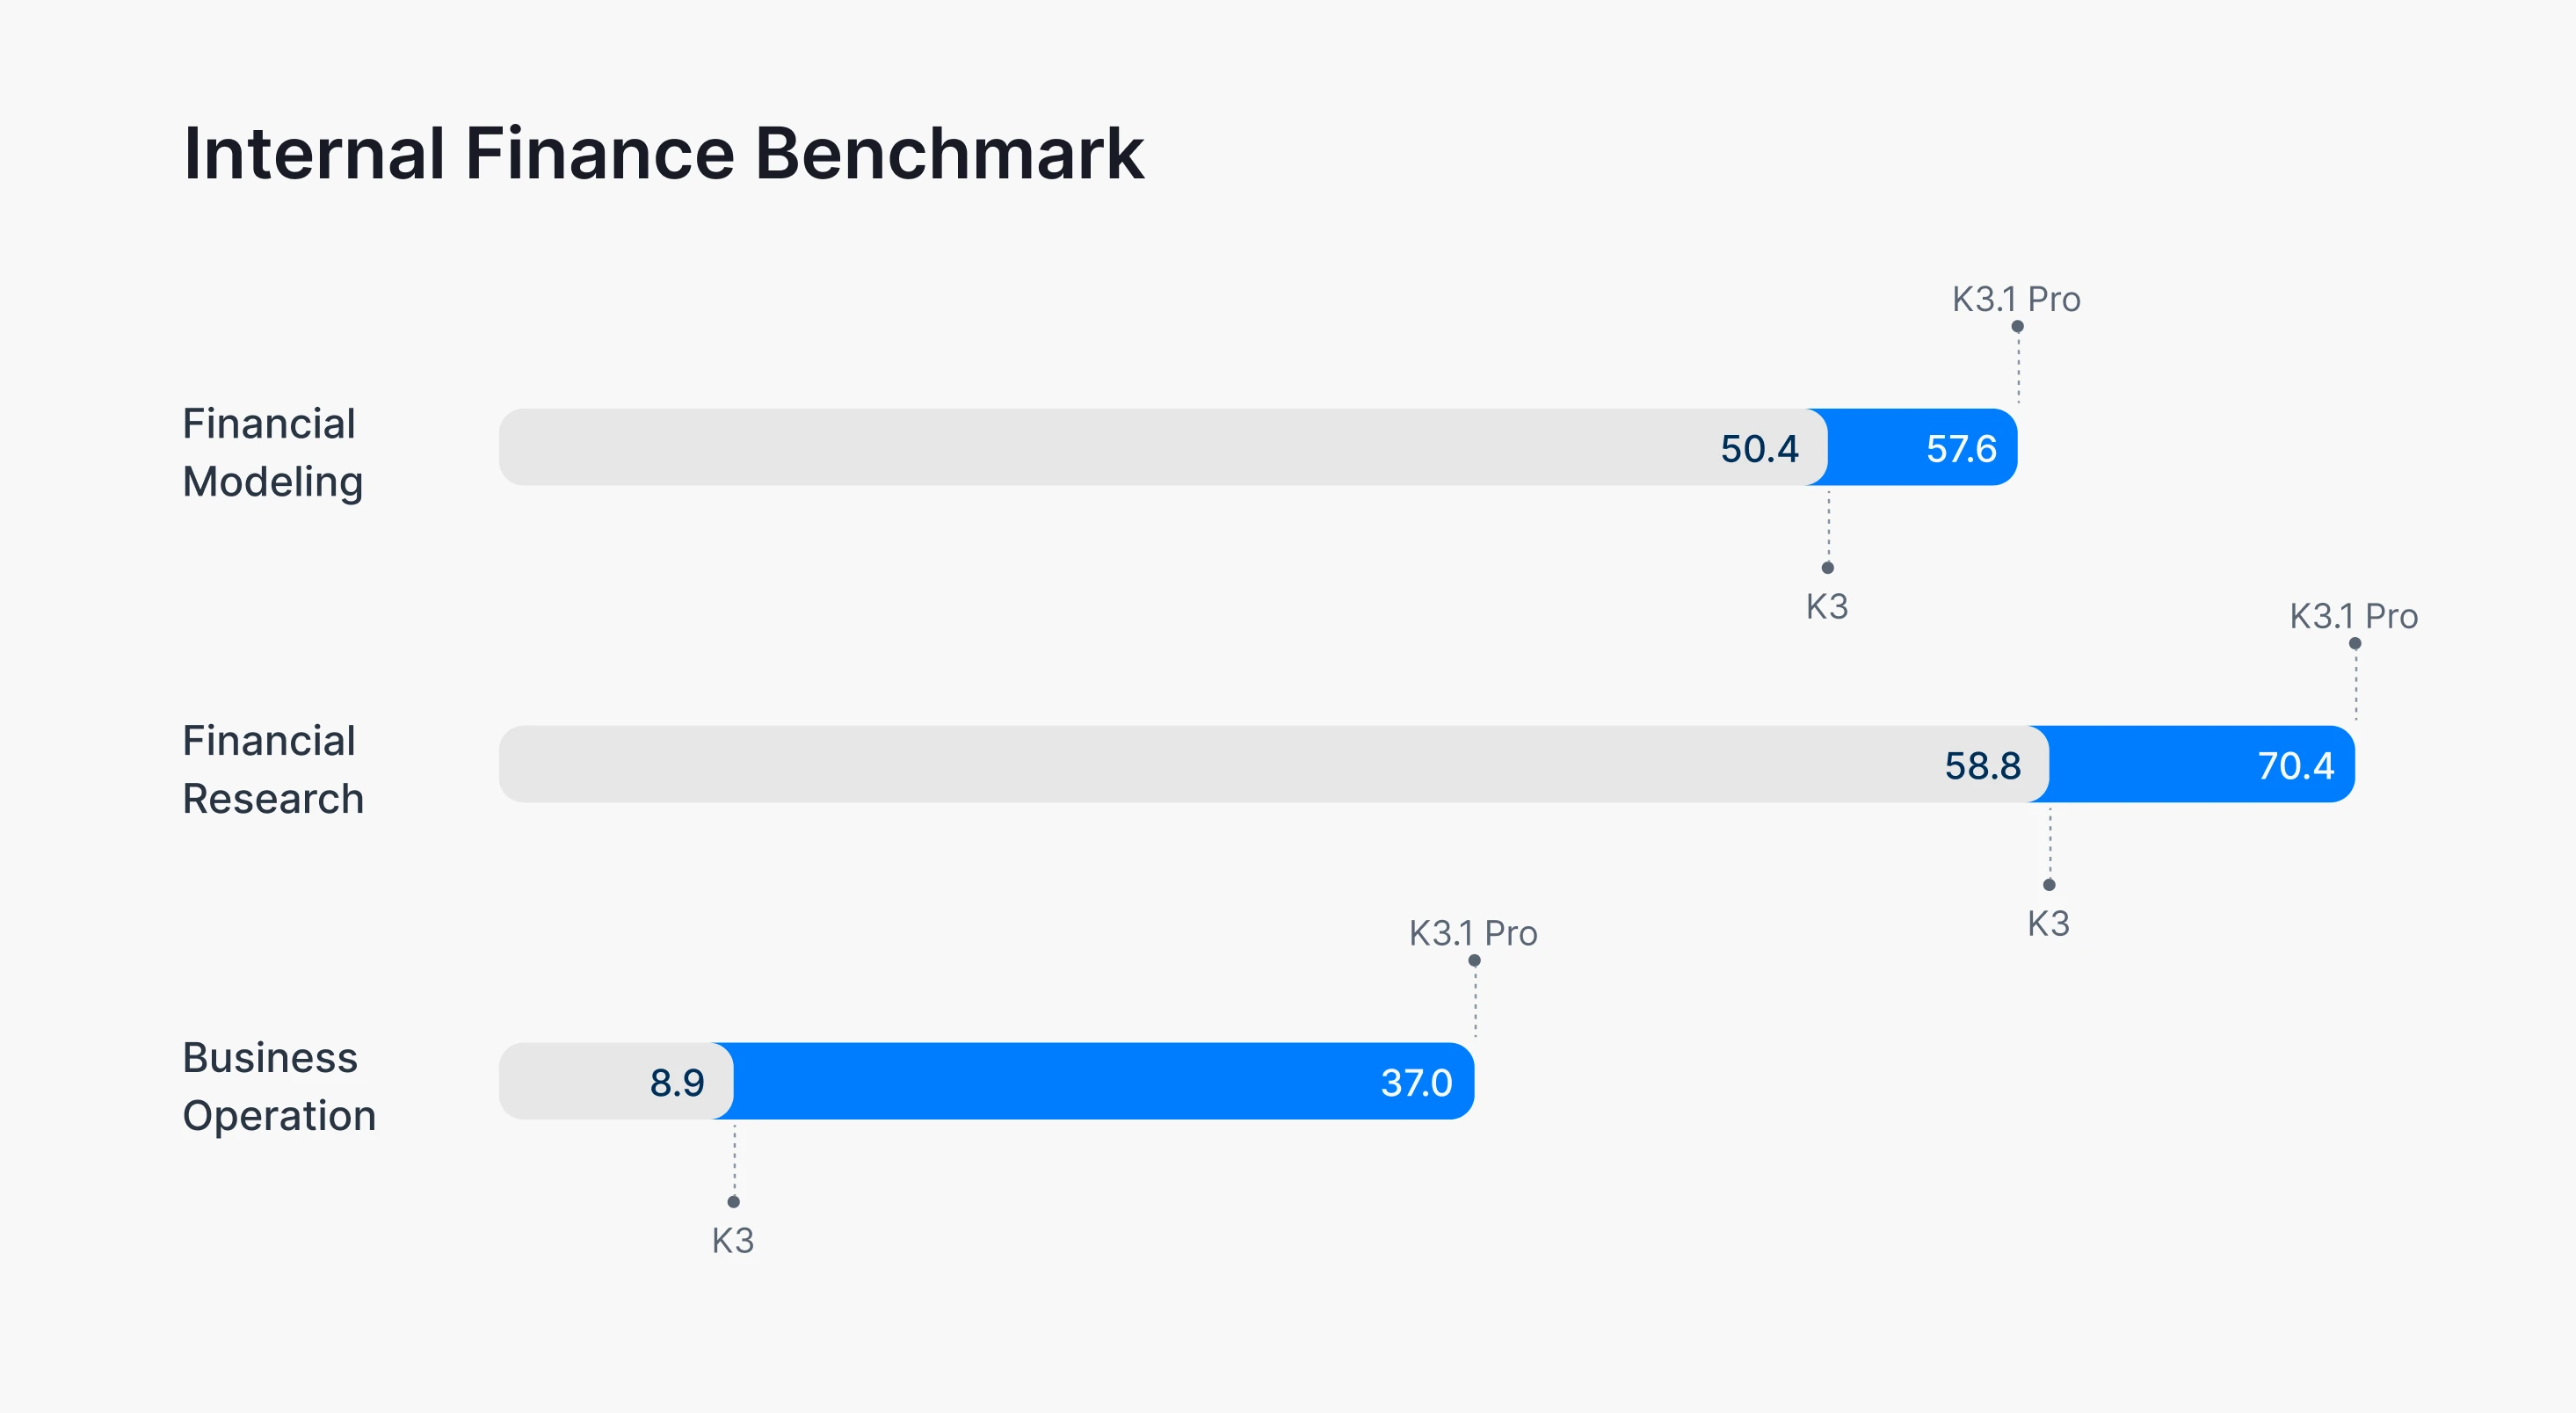
Dans les tests internes de Moonshot, Financial Modeling passe de 50,4 à 57,6, soit un gain de 7,2 points, et Financial Research de 58,8 à 70,4, soit un gain de 11,6 points. Business Operation augmente de 8,9 à 37,0, environ 4,2 fois le score de K3.
Ce benchmark évalue la gestion à long horizon et la prise de décision dans un environnement d’entreprise simulé. Il est donc plus étroitement lié à la planification agentique qu’à des questions financières simples.
Financial Research mesure la capacité à produire une recherche fondée sur des preuves tout en respectant les exigences de sources et les dates limites d’information. Financial Modeling se concentre sur les relations mathématiques, la logique des feuilles de calcul et la qualité des classeurs.
Le schéma suggère que K3.1 Pro est particulièrement précieux lorsque les tâches financières exigent un raisonnement soutenu, une vérification et des livrables structurés.
Pour les investisseurs, analystes et utilisateurs métiers, l’avantage pratique est une meilleure gestion des workflows multi-documents. Aucun des modèles ne doit être utilisé comme autorité incontestable pour des décisions financières.
Raisonnement long-contexte et fiabilité factuelle
Cependant, les résultats AA-LCR en long contexte montrent K3 légèrement en tête. C’est un rappel utile : un modèle plus récent peut s’améliorer considérablement globalement sans gagner chaque tâche spécialisée.
Les évaluations rapportées montrent moins d’erreurs factuelles sur leurs jeux de tests respectifs.
Sur Kimi Hallu Bench Hard avec outils, Moonshot rapporte que le taux d’erreur au niveau des affirmations a diminué de 23,4 % pour K3 à 8,3 % pour K3.1 Pro.
Il s’agit d’une réduction relative d’environ 65 % sur le test de résistance délibérément difficile de Moonshot, plutôt que d’une estimation des taux d’erreur quotidiens. Par ailleurs, Artificial Analysis rapporte une baisse du taux d’hallucination AA-Omniscience de 53 % à 44 %. Les deux évaluations utilisent des méthodes différentes ; leurs pourcentages ne sont donc pas directement comparables.
La leçon pratique est que K3.1 Pro paraît plus fiable sur les tâches évaluées, mais les améliorations factuelles n’éliminent pas le besoin de récupération, de citations, de vérifications de calculs et d’une revue humaine dans des workflows à enjeux.
Analyse de données : éléments issus de l’évaluation de Plotly
Plotly a évalué K3.1 Pro standard via OpenRouter à l’aide d’un test privé de 43 questions sur un entrepôt de données synthétique d’énergie éolienne. La version Highspeed n’a pas été testée. Les résultats illustrent le compromis entre qualité de réponse, temps d’exécution et coût dans ce workflow analytique spécifique basé sur SQL.
| Mesure d’analyse de données Plotly | Kimi K3 | Kimi K3.1 Pro |
|---|---|---|
| Réponses correctes | 35/43 | 42/43 |
| Précision | 81,4% | 97,7% |
| Motifs cachés découverts | 0/5 | 5/5 |
| Problèmes de qualité des données identifiés | 1/3 | 3/3 |
| Coût de l’évaluation complète | 5,01 $ | 13,47 $ |
| Temps médian par question | 43 s | 2,5 min |
Dans cette évaluation, K3.1 Pro a répondu correctement à plus de questions et a identifié davantage de motifs cachés et de problèmes de qualité des données, mais avec un coût plus élevé et un temps médian plus long.
Les frais rapportés sont des coûts d’évaluation observés, non des estimations calculées à partir des prix API standard de Moonshot. La configuration publiée n’établit pas que tous les paramètres du fournisseur étaient identiques entre les deux exécutions du modèle ; les différences ne peuvent donc pas être attribuées au modèle seul.
Ces résultats soutiennent l’évaluation de K3.1 Pro pour des tâches analytiques où des découvertes supplémentaires pourraient justifier plus de temps et de dépenses. Ils n’établissent pas la même précision ni un avantag
Kimi K3.1 Pro est-il plus rapide que Kimi K3 ?
Distinguez le débit de tokens de sortie de la latence de tâche de bout en bout.
Artificial Analysis rapporte 73,5 tokens de sortie par seconde pour K3.1 Pro, contre 38,5 pour K3 avec un effort de raisonnement maximal, via l’API de Kimi. Il s’agit de mesures de génération de tokens, vérifiées le 24 octobre 2026 ; la latence totale d’une tâche dépend aussi de la longueur du raisonnement et de l’exécution d’outils.
Cependant, une génération plus rapide de tokens ne garantit pas une finalisation plus rapide des tâches.
Moonshot propose également K3.1 Pro Highspeed, annoncé comme offrant environ deux à trois fois la vitesse de sortie de la variante standard. Il s’agit d’une amélioration de vitesse de service, pas d’une hausse d’intelligence vérifiée séparée.
K3.1 Pro a un débit de tokens de sortie plus élevé, mais n’achève pas nécessairement les tâches plus vite. Distinguez la vitesse de génération des tokens du temps requis pour raisonner, appeler des outils et terminer le travail.
Vitesse de sortie vs. temps d’achèvement de la tâche
Artificial Analysis rapporte des vitesses de sortie de 73,5 tokens/seconde pour K3.1 Pro et 38,5 pour K3 à effort de raisonnement maximal, via l’API de Kimi. Ces mesures ont été vérifiées le 24 octobre 2026 et décrivent le débit de génération de tokens plutôt que la latence de bout en bout.
Un modèle peut générer des tokens plus vite tout en prenant plus de temps au total s’il produit davantage de tokens de raisonnement ou effectue des appels d’outils supplémentaires. Dans l’évaluation Plotly évoquée ci-dessus, le temps médian d’achèvement était de 2,5 minutes par question pour K3.1 Pro, contre 43 secondes pour K3, avec une précision supérieure.
Pour les applications interactives, mesurez le temps jusqu’au premier token et le temps total d’achèvement sur la route fournisseur réelle. Le seul débit de sortie ne suffit pas à prédire la réactivité.
Envisager K3.1 Pro Highspeed
Moonshot annonce K3.1 Pro Highspeed comme offrant environ deux à trois fois la vitesse de sortie de K3.1 Pro standard. Cette affirmation concerne la vitesse de service ; elle ne doit pas être interprétée comme une réduction par deux à trois du temps total d’achèvement de la tâche.
Envisagez Highspeed pour le codage interactif ou les assistants où les utilisateurs attendent les réponses. Comparez la latence de bout en bout, la réussite des tâches et le coût total facturé avec l’endpoint standard avant de le choisir. Highspeed a des prix plus élevés pour l’entrée et la sortie standard, tandis que son tarif d’entrée mise en cache est identique.
Kimi K3.1 Pro vs Kimi K3 : coût
Tarifs officiels API et CometAPI
Les tarifs standard d’entrée, de sortie et de cache-hit de K3.1 Pro sont inférieurs d’un tiers à ceux de K3. Les tarifs d’entrée et de sortie listés par CometAPI sont encore 20 % en dessous des tarifs officiels correspondants.
| Modèle | Entrée officielle / 1M | Sortie officielle / 1M | Entrée mise en cache officielle / 1M | Entrée CometAPI / 1M | Sortie CometAPI / 1M |
|---|---|---|---|---|---|
| Kimi K3.1 Pro | 2,00 $ | 10,00 $ | 0,20 $ | 1,60 $ | 8,00 $ |
| Kimi K3 | 3,00 $ | 15,00 $ | 0,30 $ | 2,40 $ | 12,00 $ |
| Kimi K3.1 Pro Highspeed | 4,00 $ | 20,00 $ | 0,20 $ | Voir devis actuel | Voir devis actuel |
USD par million de tokens ; tarifs vérifiés le 24 octobre 2026. Les colonnes d’entrée montrent les tarifs standard pour l’entrée non mise en cache. Taxes et frais facturés séparément exclus.
La tarification officielle Kimi liste également les frais d’écriture de cache : 2 $/4 $ par million de tokens pour la version Pro standard avec une rétention de 5 minutes/1 heure, et 4 $/8 $ pour Highspeed. Les hits de cache, les écritures de cache et l’entrée standard sont des catégories de facturation séparées et mutuellement exclusives.
Kimi officiel et CometAPI sont des routes fournisseur distinctes. Confirmez la tarification actuelle et le support du cache pour la route choisie, y compris la disponibilité de Highspeed. Comparez le coût total facturé par tâche ainsi que les tarifs de tokens.
Exemple de coût à tokens fixes
Considérez une charge de travail consommant 100 000 tokens d’entrée non mis en cache et 20 000 tokens de sortie.
Pour cette charge fixe, le coût via l’API officielle est de 0,60 $ avec K3 et de 0,40 $ avec K3.1 Pro. Aux tarifs CometAPI listés, les mêmes quantités de tokens coûtent 0,48 $ et 0,32 $, respectivement. Ces totaux incluent uniquement les tokens d’entrée et de sortie indiqués.
Mais il s’agit d’une comparaison à tokens fixes. Les workflows d’agent complexes peuvent consommer des quantités différentes de tokens de raisonnement et d’appels d’outils selon le modèle.
Les économies de tokens disparaissent
Soit I le nombre identique de tokens d’entrée non mis en cache, O le nombre de tokens de sortie facturés de Kimi K3, et P le nombre de tokens de sortie facturés de Kimi K3.1 Pro, tous mesurés en millions. Aux tarifs officiels standards du tableau de prix, les coûts sont 3I + 15O et 2I + 10P dollars. Ils sont égaux lorsque P = 1.5O + 0.1I.
Pour des requêtes à forte sortie, K3.1 Pro peut donc utiliser environ 50 % de tokens de sortie facturés en plus avant de perdre son avantage prix. Ce calcul suppose des tarifs inchangés et exclut la mise en cache, les frais d’outils et autres usages facturés séparément. Utilisez les catégories de tokens effectivement facturées plutôt que la longueur visible de la réponse.
Coût par tâche réussie
Calculez le coût par tâche réussie comme le coût total facturé de toutes les tentatives d’évaluation divisé par le nombre de tâches uniques satisfaisant un critère d’acceptation prédéfini. Incluez les frais des tentatives infructueuses, des réessais et des expirations lorsque le fournisseur les facture ; ne diviser que le coût des exécutions réussies par leur nombre peut sous-estimer le coût par réussite.
Maintenez le jeu de tâches, les critères d’acceptation, la limite de réessais et la politique d’expiration identiques entre Kimi K3 et K3.1 Pro. Rapportez le taux de réussite en parallèle du coût par réussite afin qu’écarter des tâches difficiles ne puisse pas rendre un modèle artificiellement économique. Si aucune tâche ne réussit, le coût par réussite est non défini, pas zéro.
Kimi K3.1 Pro vs Kimi K3 : comparaison et sélection
Pour la plupart des workloads agentiques hébergés, K3.1 Pro est le meilleur point de départ. Néanmoins, la décision doit refléter la complexité des tâches et les exigences de déploiement.
| Cas d’utilisation | Modèle recommandé | Raison |
|---|---|---|
| Codage autonome | Kimi K3.1 Pro | Évaluer les modifications multi-fichiers, le travail en terminal, le débogage et les résultats des tests finaux. |
| Recherche financière multi-documents | Kimi K3.1 Pro | Benchmarks améliorés en recherche et opérations métiers |
| Analyse de données complexe | Kimi K3.1 Pro | Meilleure découverte de problèmes et tests de qualité des données |
| Création 3D et workflows CAO | Kimi K3.1 Pro | Capacités spécialisées solides avec outils |
| Tâches textuelles simples | Évaluer les deux | Comparez les tâches de routine et le codage simple sur les deux modèles ; un raisonnement supplémentaire peut ajouter de la latence sans améliorer un résultat acceptable. |
| Exactitude en récupération long-contexte | Évaluer les deux | K3 est légèrement en tête sur AA-LCR |
| Auto-hébergement immédiat | Kimi K3 | Poids téléchargeables déjà disponibles |
| Agents interactifs haute capacité | K3.1 Pro Highspeed | Service plus rapide, sous réserve de validation des coûts |
| Workflows de production sensibles au coût | Évaluer les deux | Des tokens moins chers ne signifient pas forcément un coût de tâche plus faible |
Automatisation hébergée et workflows professionnels
Pour les agents de codage hébergés et les workflows analytiques, évaluez K3.1 Pro sur les parties difficiles du travail réel : modifications multi-fichiers, collecte de preuves, vérifications de calcul et reprise après un appel d’outil échoué. Préférez des réductions mesurées des tâches échouées ou du travail correctif à un score global plus élevé seul.
Pour les applications K3 existantes, conservez la route actuelle comme référence. Les tâches de routine atteignent peut-être déjà le seuil d’acceptation, tandis que les tâches spécialisées en long contexte peuvent se comporter différemment des benchmarks agrégés. Priorisez les segments de workload où une mise à niveau apporte un bénéfice mesurable.
Auto-hébergement et contraintes de déploiement
Au 24 octobre 2026, les poids complets de K3 sont disponibles pour un déploiement soumis à la licence du modèle et aux exigences matérielles. Les poids complets de K3.1 Pro n’ont pas encore été publiés.
Moonshot prévoit de publier les poids K3.1 Pro d’ici le 4 novembre 2026. Il s’agit d’un plan de publication annoncé, pas d’un checkpoint disponible ; confirmez les poids publiés et les conditions applicables avant de planifier l’auto-hébergement.
Critères d’évaluation en production
Comparez K3 et K3.1 Pro sur des tâches représentatives en utilisant les mêmes invites, outils, critères d’acceptation, limites de réessais et délais d’expiration. Enregistrez les paramètres du fournisseur et du raisonnement, et conservez l’intégralité des messages assistant comme l’exige l’API.
Mesurez la réussite des tâches, la latence, l’usage de tokens et le coût par tâche réussie, y compris les échecs et réessais facturés. Examinez les cas où K3 réussit mais K3.1 Pro échoue. Pour l’évaluation humaine, masquez les étiquettes des modèles et randomisez l’ordre des sorties.
Si K3.1 Pro satisfait vos seuils de qualité, de latence et de coût, déployez-le progressivement avec un repli K3 testé.
Migration contrôlée et mécanismes de repli
Une approche pratique consiste à commencer par un petit pourcentage du trafic de production sur K3.1 Pro.
Gardez K3 comme repli durant la validation. Comparez la qualité des tâches, la latence, les taux d’échec et les dépenses avant d’augmenter l’usage de K3.1 Pro.
Portez une attention particulière aux schémas d’appels d’outils, aux champs de message liés au raisonnement, aux entrées multimodales et à l’analyse des sorties. La compatibilité API ne garantit pas automatiquement un comportement applicatif identique.
Gains et régressions de benchmark
Si les deux modèles ont répondu aux mêmes 43 questions et ont obtenu 35 et 42, K3.1 Pro a pu corriger sept échecs de K3 sans régression, ou huit échecs tout en perdant une réponse précédemment correcte. Le score total seul ne peut pas distinguer ces issues.
Inspectez les réponses appairées et classez-les comme les deux correctes, uniquement K3 correcte, uniquement K3.1 Pro correcte ou les deux incorrectes. Passez en revue les succès propres à K3 au regard de vos tâches à plus fort impact avant de migrer. Le résultat 42/43 décrit cet ensemble de test ; il ne garantit pas un taux de réussite de 97,7 % sur une charge de travail différente.
Évaluation à l’aveugle des sorties de modèles
Masquez les étiquettes des modèles et randomisez l’ordre dans lequel les réviseurs voient les sorties. Définissez le barème d’acceptation avant la relecture : pour le code, utilisez des tests exécutables et des vérifications de régression ; pour la recherche, vérifiez les sources, les calculs et la complétude du livrable demandé. Notez la correction avant de considérer la présentation ou le style.
Ne révélez l’identité du modèle, la latence et le coût facturé qu’après l’enregistrement de l’évaluation de qualité. Cela sépare la qualité de sortie des attentes liées au modèle plus récent. Résolvez les désaccords des réviseurs sur la base des mêmes tests ou sources, et conservez les décisions afin qu’un modèle ultérieur ou un changement d’invite puisse être évalué de manière cohérente.
Où pouvez-vous accéder à Kimi K3.1 Pro et Kimi K3 ?
Accès via le fournisseur officiel
Utilisez la Kimi K3 API ou la Kimi K3.1 Pro API documentées par Moonshot pour une intégration directe au fournisseur. Vérifiez l’identifiant du modèle de l’endpoint sélectionné, les champs de requête pris en charge et les limites de compte. L’accès public à l’API et les poids de modèle téléchargeables sont des options de déploiement distinctes.
Accès via CometAPI
Les développeurs peuvent accéder à la Kimi K3.1 Pro API et à la Kimi K3 API via l’interface unifiée de CometAPI et comparer les deux routes avec la même charge applicative.
Cela rend la migration K3 vers K3.1 Pro relativement simple, surtout pour les applications utilisant déjà une interface de chat compatible OpenAI.
Pour utiliser CometAPI, créez un compte et une clé API, puis configurez votre application avec l’endpoint et l’identifiant du modèle dans la documentation d’intégration. Sélectionnez kimi-k3 pour K3, kimi-k3.1-pro pour K3.1 Pro standard, ou kimi-k3.1-pro-highspeed pour la route Highspeed lorsque prise en charge. Commencez par une petite requête, puis comparez la même charge de travail entre modèles en vérifiant les résultats renvoyés, la latence et l’usage facturé.
Conclusion
Kimi K3.1 Pro est le meilleur candidat pour le codage autonome exigeant, la recherche financière et les workflows d’agent étendus dans les évaluations examinées ici. Kimi K3 reste pertinent pour l’auto-hébergement immédiat et les charges de travail où son profil actuel d’exactitude ou de latence satisfait déjà les besoins.
Choisissez à l’aide de tâches représentatives et de la route fournisseur réelle. Comparez les résultats réussis, la latence et les dépenses totales, puis migrez progressivement. Des prix de tokens plus bas et des scores de benchmark agrégés plus élevés sont des points de départ utiles, mais ils n’établissent pas la meilleure configuration pour chaque application.