Spécifications techniques de MiniMax M3.1-Flash
| Élément | MiniMax M3.1-Flash |
|---|---|
| ID du modèle | MiniMax-M3.1-Flash |
| Famille de modèles | Série MiniMax M3.1, modèle de codage |
| Date de sortie | 27 septembre 2026 |
| Objectif principal | Développement logiciel au quotidien, des corrections de bugs à la livraison de fonctionnalités complètes |
| Fenêtre de contexte | 1,000,000 tokens |
| Modalités d'entrée | Texte, image et vidéo |
| Modalité de sortie | Texte |
| Contrôle du raisonnement | reasoning_effort: low, medium, high, xhigh, max |
| Comportement de raisonnement | Un raisonnement adaptatif est requis ; la documentation publique examinée n’indique pas la possibilité de désactiver le raisonnement |
| Sortie maximale | Non publiée séparément dans les documents publics examinés |
| Nombre de paramètres | Non divulgué publiquement |
| Poids ouverts | Aucun checkpoint/dépôt de modèle public identifié |
MiniMax a annoncé M3.1-Flash pour MiniMax Code le 27 septembre 2026, le positionnant autour des tâches de développement quotidiennes telles que la correction de bugs et la livraison de fonctionnalités complètes. Les sources publiques actuelles indiquent de manière cohérente une fenêtre de contexte de 1M tokens et un effort de raisonnement ajustable, tout en notant qu’un tableau de benchmarks autonome et un prix par token n’ont pas été publiés.
Qu'est-ce que MiniMax M3.1-Flash ?
MiniMax M3.1-Flash est un modèle textuel orienté codage, conçu pour des workflows de développement logiciel itératifs plutôt que pour la seule génération de code. MiniMax décrit ce flux comme couvrant la compréhension des exigences, la localisation du problème, l’implémentation, les tests de régression et la vérification des modifications par rapport aux fonctionnalités existantes.
Ses commandes distinctives documentées sont son long contexte et une échelle d’effort de raisonnement à cinq niveaux. Les niveaux disponibles sont low, medium, high, xhigh et max, permettant aux développeurs d’arbitrer entre profondeur de raisonnement et latence selon la complexité de la tâche.
Principales caractéristiques de MiniMax M3.1-Flash
- Fenêtre de contexte de 1M tokens : La description publiée attribue au modèle une fenêtre de contexte d’un million de tokens, ce qui le rend adapté aux grands dépôts, longues spécifications et sessions prolongées d’agents de codage.
- Entrée multimodale native : Les descriptions publiques du modèle listent le texte, l’image et la vidéo comme entrées, tandis que le modèle renvoie du texte.
- Cinq niveaux d’effort de raisonnement :
low,medium,high,xhighetmaxoffrent un contrôle plus fin de la profondeur de raisonnement qu’un simple interrupteur de raisonnement activé/désactivé. - Flux de développement de bout en bout : MiniMax positionne spécifiquement le modèle pour la localisation de bugs, l’implémentation, la gestion des cas limites, l’achèvement des tests de régression et la validation des changements.
- Déploiement orienté : Le déploiement public initial se fait via MiniMax Code et Token Plan plutôt que sous la forme d’une offre autonome pay-as-you-go entièrement documentée.
- Adéquation aux agents de codage : Le modèle est conçu pour des interactions de développement répétées où le contexte du dépôt, la sortie des outils, les tests et les corrections itératives comptent plus qu’une génération de code en un seul passage.
MiniMax M3.1-Flash vs autres modèles de codage MiniMax
| Modèle | Focus | Contexte | Données de benchmark publiques | Accès / statut |
|---|---|---|---|---|
| M3.1-Flash | Programmation quotidienne, développement itératif | 1M | Pas encore publiées | MiniMax Code / Token Plan |
| M3 | Programmation de pointe + travail agentique, multimodalité native | Jusqu’à 1M | Publié par MiniMax | API, Token Plan, MiniMax Code |
| M2.7 | Ingénierie logicielle + large spectre agent/productivité | Non utilisé ici comme spécification M3.1 recopiée | Publié par MiniMax | API, Token Plan, Agent |
M3 constitue le point de référence le plus largement documenté : MiniMax publie son architecture, sa méthodologie d’évaluation pour le codage/les agents et la disponibilité de l’API. M2.7 dispose également d’un bilan public de benchmarks et d’une intégration API. M3.1-Flash est plus récent et dispose actuellement d’une documentation publique plus restreinte ; les comparaisons doivent donc se concentrer sur le positionnement documenté plutôt que de prétendre à un vainqueur sur benchmarks. 4
Cas d'utilisation représentatifs
- Correction de bugs à l’échelle d’un dépôt : Fournissez au modèle une grande base de code, la description du problème, des logs et des tests, et utilisez son long contexte pour préserver le contexte pertinent du projet.
- Implémentation de fonctionnalités : Utilisez le modèle pour passer d’une exigence en langage naturel aux changements de code et aux tests de régression.
- Revue de code et remédiation : Demandez-lui d’identifier les cas limites, de proposer des correctifs et de vérifier que les changements ne cassent pas le comportement existant.
- Débogage multimodal : Fournissez des captures d’écran, des diagrammes ou des vidéos en plus des exigences textuelles lorsque le contexte visuel fait partie du problème d’ingénierie.
- Sessions longues d’agents de codage : Exploitez la grande fenêtre de contexte pour les spécifications, les fichiers du dépôt, la sortie du terminal et les résultats de tests itératifs.
- Développement sensible à la vitesse : Sélectionnez un niveau d’effort de raisonnement plus faible pour les modifications de routine et augmentez l’effort pour des changements multi-étapes plus complexes.
Comment accéder à l'API MiniMax M3.1-Flash
Étape 1 : Inscription pour obtenir une clé API
Connectez-vous à cometapi.com. Si vous n’êtes pas encore utilisateur, veuillez d’abord vous inscrire. Connectez-vous à votre console CometAPI. Obtenez la clé d’accès API de l’interface. Cliquez sur “Add Token” dans la section API token du centre personnel, obtenez la clé de jeton : sk-xxxxx et soumettez.
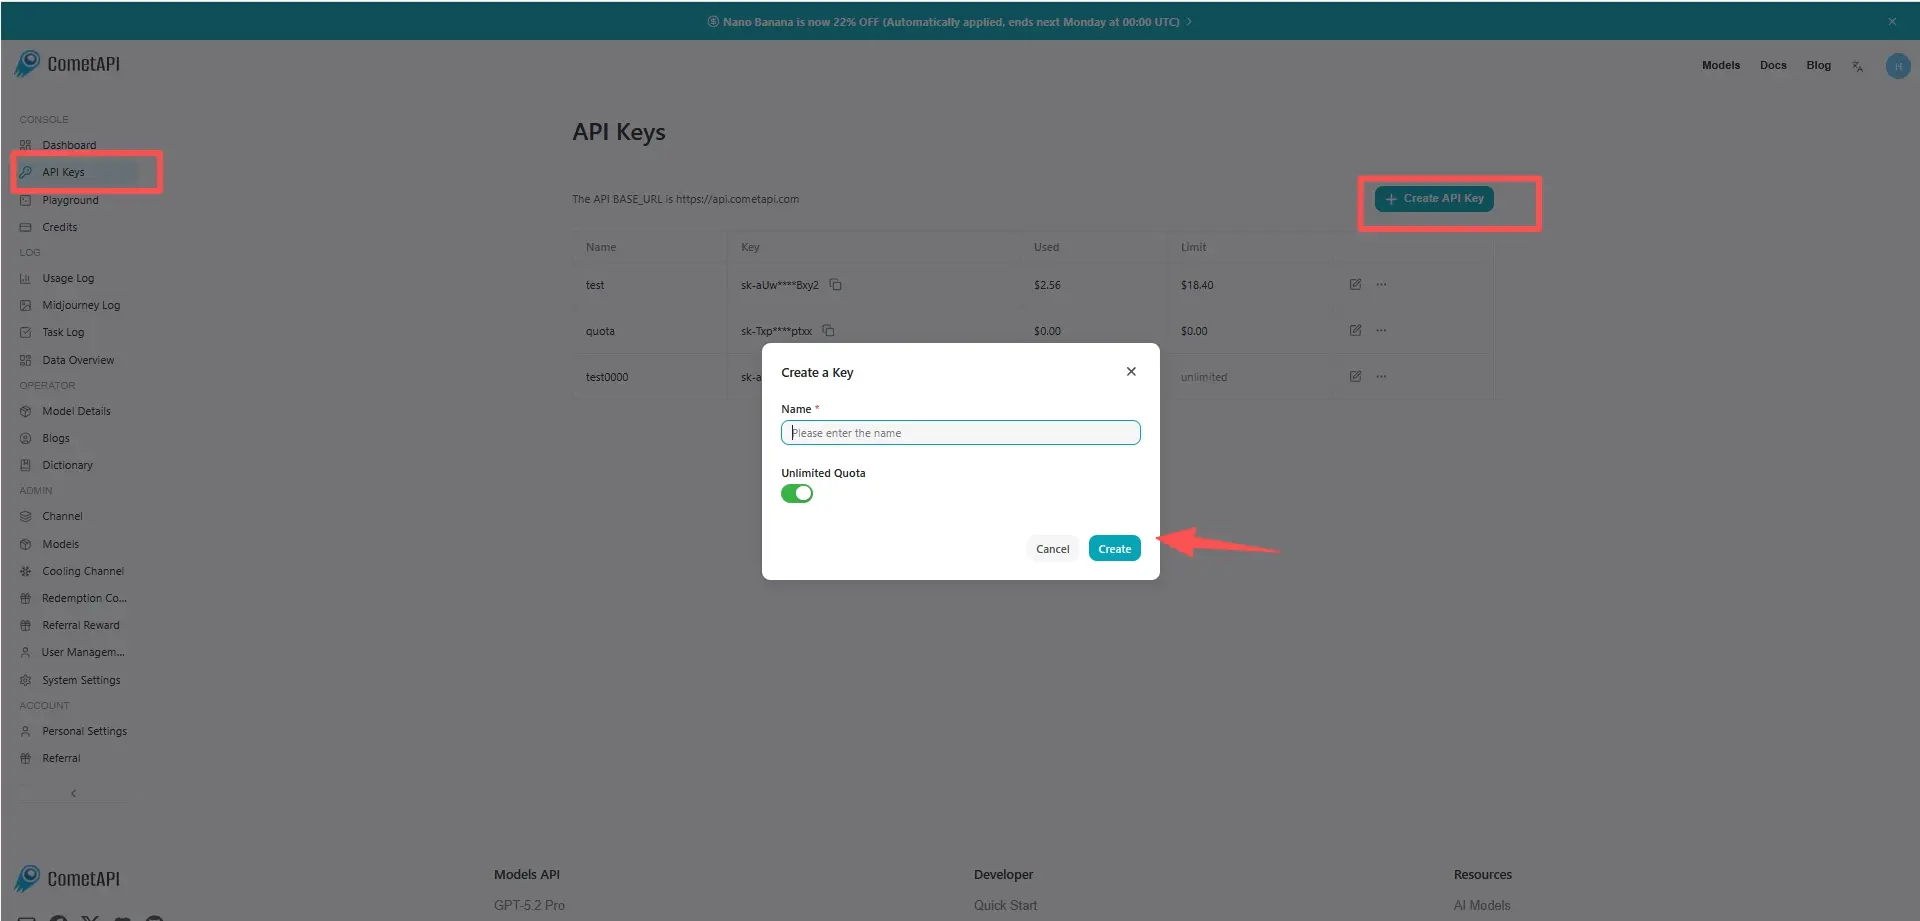
Étape 2 : Envoyer des requêtes à l’API MiniMax M3.1-Flash
Sélectionnez l’endpoint “minimax-m3.1-flash” pour envoyer la requête API et définissez le corps de la requête. La méthode et le corps de la requête sont obtenus à partir de la documentation API de notre site Web. Notre site propose également un test Apifox pour votre commodité. Remplacez <YOUR_API_KEY> par votre clé CometAPI réelle de votre compte. L’URL de base est Chat Completions.
Insérez votre question ou demande dans le champ content — c’est à cela que le modèle répondra. Traitez la réponse de l’API pour obtenir la réponse générée.
Étape 3 : Récupérer et vérifier les résultats
Traitez la réponse de l’API pour obtenir la réponse générée. Après traitement, l’API répond avec l’état de la tâche et les données de sortie.