Qu’est-ce que l’API GPT-5.2
L’API GPT-5.2 correspond à GPT-5.2 Thinking dans ChatGPT. GPT-5.2 Thinking est la version intermédiaire de la famille GPT-5.2 d’OpenAI, conçue pour un travail plus approfondi : raisonnement en plusieurs étapes, synthèse de longs documents, génération de code de qualité et tâches professionnelles où l’exactitude et une structure exploitable priment sur le simple débit. Dans l’API, elle est exposée sous le modèle gpt-5.2 (Responses API / Chat Completions) et se situe entre la variante Instant à faible latence et la variante Pro de qualité supérieure mais plus onéreuse.
Fonctionnalités principales
- Contexte très long et compactage : fenêtre effective de 400K et outils de compactage pour gérer la pertinence sur de longues conversations et documents.
- Effort de raisonnement configurable :
none | medium | high | xhigh(xhigh active le calcul interne maximal pour les raisonnements difficiles).xhighest disponible pour les variantes Thinking/Pro. - Prise en charge renforcée des outils et fonctions : appels d’outils de premier ordre, grammaires (CFG/Lark) pour contraindre les sorties structurées, et comportements agentiques améliorés qui simplifient l’automatisation complexe en plusieurs étapes.
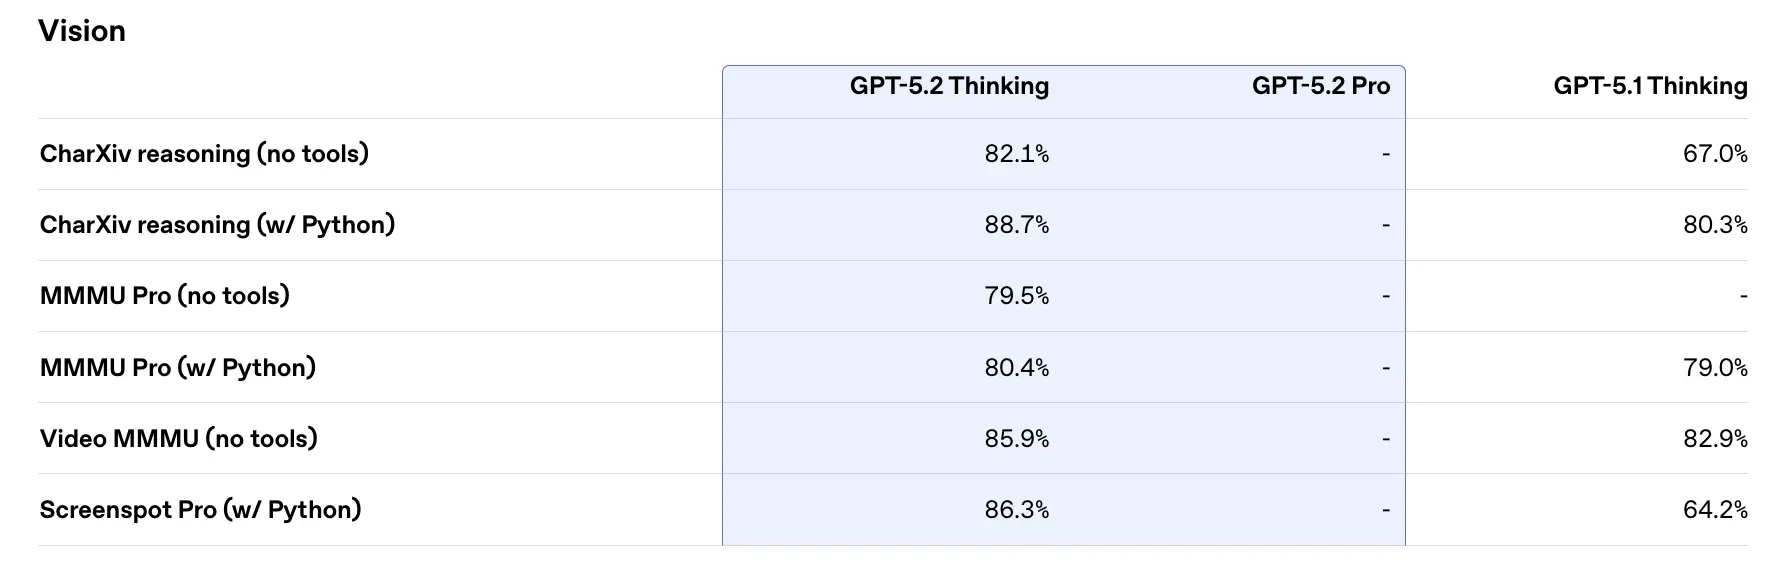
- Compréhension multimodale : compréhension image + texte plus riche et intégration dans des tâches en plusieurs étapes.
- Sécurité améliorée / gestion des contenus sensibles : interventions ciblées pour réduire les réponses indésirables dans des domaines comme l’automutilation et autres contextes sensibles.
Capacités techniques et spécifications (vue développeur)
- Points de terminaison API et IDs de modèle :
gpt-5.2pour Thinking (Responses API),gpt-5.2-chat-latestpour les workflows chat/instant, etgpt-5.2-propour la gamme Pro ; disponibles via Responses API et Chat Completions le cas échéant. - Jetons de raisonnement et gestion de l’effort : l’API prend en charge des paramètres explicites pour allouer du calcul (effort de raisonnement) par requête ; un effort plus élevé augmente la latence et le coût mais améliore la qualité de sortie pour les tâches complexes.
- Outils pour sorties structurées : prise en charge des grammaires (Lark / CFG) pour contraindre la sortie à un DSL ou une syntaxe exacte (utile pour SQL, JSON, génération de DSL).
- Appels d’outils parallèles et coordination agentique : parallélisme amélioré et orchestration d’outils plus nette, réduisant le besoin de prompts système élaborés et d’armatures multi-agents.
Performances de benchmark et données à l’appui
OpenAI a publié divers résultats de benchmarks internes et externes pour GPT-5.2. Extraits (chiffres rapportés par OpenAI) :
- GDPval (44 métiers, connaissances) — GPT-5.2 Thinking « bat ou égale les meilleurs professionnels du secteur dans 70,9 % des comparaisons » ; OpenAI rapporte que les sorties ont été produites à >11× la vitesse et à <1 % du coût des professionnels experts sur leurs tâches GDPval (estimations de vitesse et de coût basées sur l’historique). Ces tâches incluent des modèles de feuilles de calcul, des présentations et de courtes vidéos.
- SWE-Bench Pro (codage) — GPT-5.2 Thinking atteint ≈55,6 % sur SWE-Bench Pro et ~80 % sur SWE-Bench Verified (Python uniquement) selon OpenAI, établissant un nouvel état de l’art pour l’évaluation de la génération de code/ingénierie dans leurs tests. Cela se traduit, d’après les exemples d’OpenAI, par un débogage plus fiable et des corrections de bout en bout en pratique.
- GPQA Diamond (Q&R scientifiques niveau master) — GPT-5.2 Pro : 93,2 %, GPT-5.2 Thinking : 92,4 % sur GPQA Diamond (sans outils, raisonnement maximal).
- Série ARC-AGI — Sur ARC-AGI-2 (benchmark de raisonnement fluide plus difficile), GPT-5.2 Thinking a obtenu 52,9 % et GPT-5.2 Pro 54,2 % (OpenAI indique qu’il s’agit de nouveaux sommets pour les modèles de type chain-of-thought).
- Long-contexte (OpenAI MRCRv2) — GPT-5.2 Thinking affiche une précision proche de 100 % sur la variante MRCR à 4 aiguilles jusqu’à 256k tokens et des scores nettement améliorés vs GPT-5.1 dans les contextes longs. (OpenAI a publié des graphiques et tableaux MRCRv2.)
Comparaison avec les concurrents
- vs Google Gemini 3 (Gemini 3 Pro / Deep Think) : Gemini 3 Pro a été présenté avec une fenêtre de contexte de ~1 048 576 (≈1M) tokens et de larges entrées multimodales (texte, image, audio, vidéo, PDFs) ainsi que de solides intégrations agentiques via Vertex AI / AI Studio. Sur le papier, la plus grande fenêtre de contexte de Gemini 3 est un différenciateur pour des charges très volumineuses en session unique ; des compromis incluent la surface fonctionnelle des outils et l’adéquation à l’écosystème.
- vs Anthropic Claude Opus 4.5 : Opus 4.5 met l’accent sur les workflows d’agent/codage en entreprise et rapporte de solides résultats SWE-bench et une robustesse pour de longues sessions agentiques ; Anthropic positionne Opus pour l’automatisation et la génération de code avec une fenêtre de contexte de 200k et des intégrations agent/Excel spécialisées. Opus 4.5 est un concurrent solide pour l’automatisation d’entreprise et les tâches de code.
À retenir : GPT-5.2 vise un ensemble équilibré d’améliorations (contexte 400k, sorties de tokens élevées, raisonnement/codage améliorés). Gemini 3 vise les contextes en session unique les plus grands (≈1M), tandis que Claude Opus se concentre sur l’ingénierie en entreprise et la robustesse agentique. Choisissez en fonction de la taille de contexte, des besoins de modalité, de l’adéquation des fonctionnalités/outils et des compromis coût/latence.
Comment accéder à et utiliser l’API GPT-5.2
Étape 1 : Inscrivez-vous pour obtenir une clé API
Connectez-vous à cometapi.com. Si vous n’êtes pas encore utilisateur, veuillez d’abord vous inscrire. Connectez-vous à votre CometAPI console. Obtenez la clé API d’accès de l’interface. Cliquez sur « Add Token » dans la section API token du centre personnel, récupérez la clé de jeton : sk-xxxxx et soumettez.
Étape 2 : Envoyez des requêtes à l’API GPT-5.2
Sélectionnez le point de terminaison « gpt-5.2 » pour envoyer la requête API et définissez le corps de la requête. La méthode et le corps de la requête sont fournis dans la documentation API de notre site Web. Notre site propose également un test Apifox pour votre commodité. Remplacez <YOUR_API_KEY> par votre clé CometAPI réelle depuis votre compte. Les développeurs les appellent via les endpoints Responses API / Chat.
Insérez votre question ou demande dans le champ content — c’est à cela que le modèle répondra. Traitez la réponse de l’API pour obtenir la réponse générée.
Étape 3 : Récupérer et vérifier les résultats
Traitez la réponse de l’API pour obtenir la réponse générée. Après traitement, l’API répond avec l’état de la tâche et les données de sortie.
Voir aussi Gemini 3 Pro Preview API