Spécifications techniques de GPT-5.4 Mini
| Élément | GPT-5.4 Mini (estimation d’après sources officielles + recoupements) |
|---|---|
| Famille de modèles | Série GPT-5.4 (variante « mini » économique) |
| Fournisseur | OpenAI |
| Types d’entrée | Texte, Image |
| Types de sortie | Texte |
| Fenêtre de contexte | 400 000 tokens |
| Nombre maximal de jetons en sortie | 128 000 tokens |
| Coupure de connaissances | ~31 mai 2024 (hérite de la lignée mini) |
| Prise en charge du raisonnement | Oui (allégée vs GPT-5.4 complet) |
| Prise en charge des outils | Appels de fonctions, recherche web, recherche de fichiers, agents (déduit de la famille GPT-5) |
| Positionnement | Modèle à haute vitesse et économique, proche de l’état de l’art |
Qu’est-ce que GPT-5.4 Mini ?
GPT-5.4 Mini est une variante de GPT-5.4 à la fois économique et rapide, conçue pour des charges de travail à forte volumétrie et sensibles à la latence. Il apporte une part significative des capacités de raisonnement, de codage et multimodales de GPT-5.4 dans un modèle plus petit et plus rapide, optimisé pour les systèmes à l’échelle de la production.
Comparé aux modèles « mini » antérieurs, GPT-5.4 Mini se positionne comme un petit modèle proche de l’avant-garde, c’est‑à‑dire qu’il approche les performances d’un modèle phare tout en réduisant fortement les coûts et le temps de réponse.
Fonctionnalités clés de GPT-5.4 Mini
- Inférence à haute vitesse : optimisé pour les applications à faible latence telles que les chatbots, les copilotes et les systèmes en temps réel
- Grande fenêtre de contexte (400K) : prend en charge les longs documents, les workflows multi‑étapes et la mémoire des agents
- Solide prise en charge du codage et des agents : conçu pour l’usage d’outils, le raisonnement multi‑étapes et les tâches déléguées à des sous‑agents
- Entrée multimodale : accepte à la fois du texte et des images pour des workflows plus riches
- Mise à l’échelle économique : nettement moins cher que GPT-5.4 tout en conservant de solides capacités de raisonnement
- Optimisation des pipelines d’agents : idéal pour des architectures multi‑modèles où les grands modèles planifient et les mini exécutent
Performances de référence de GPT-5.4 Mini
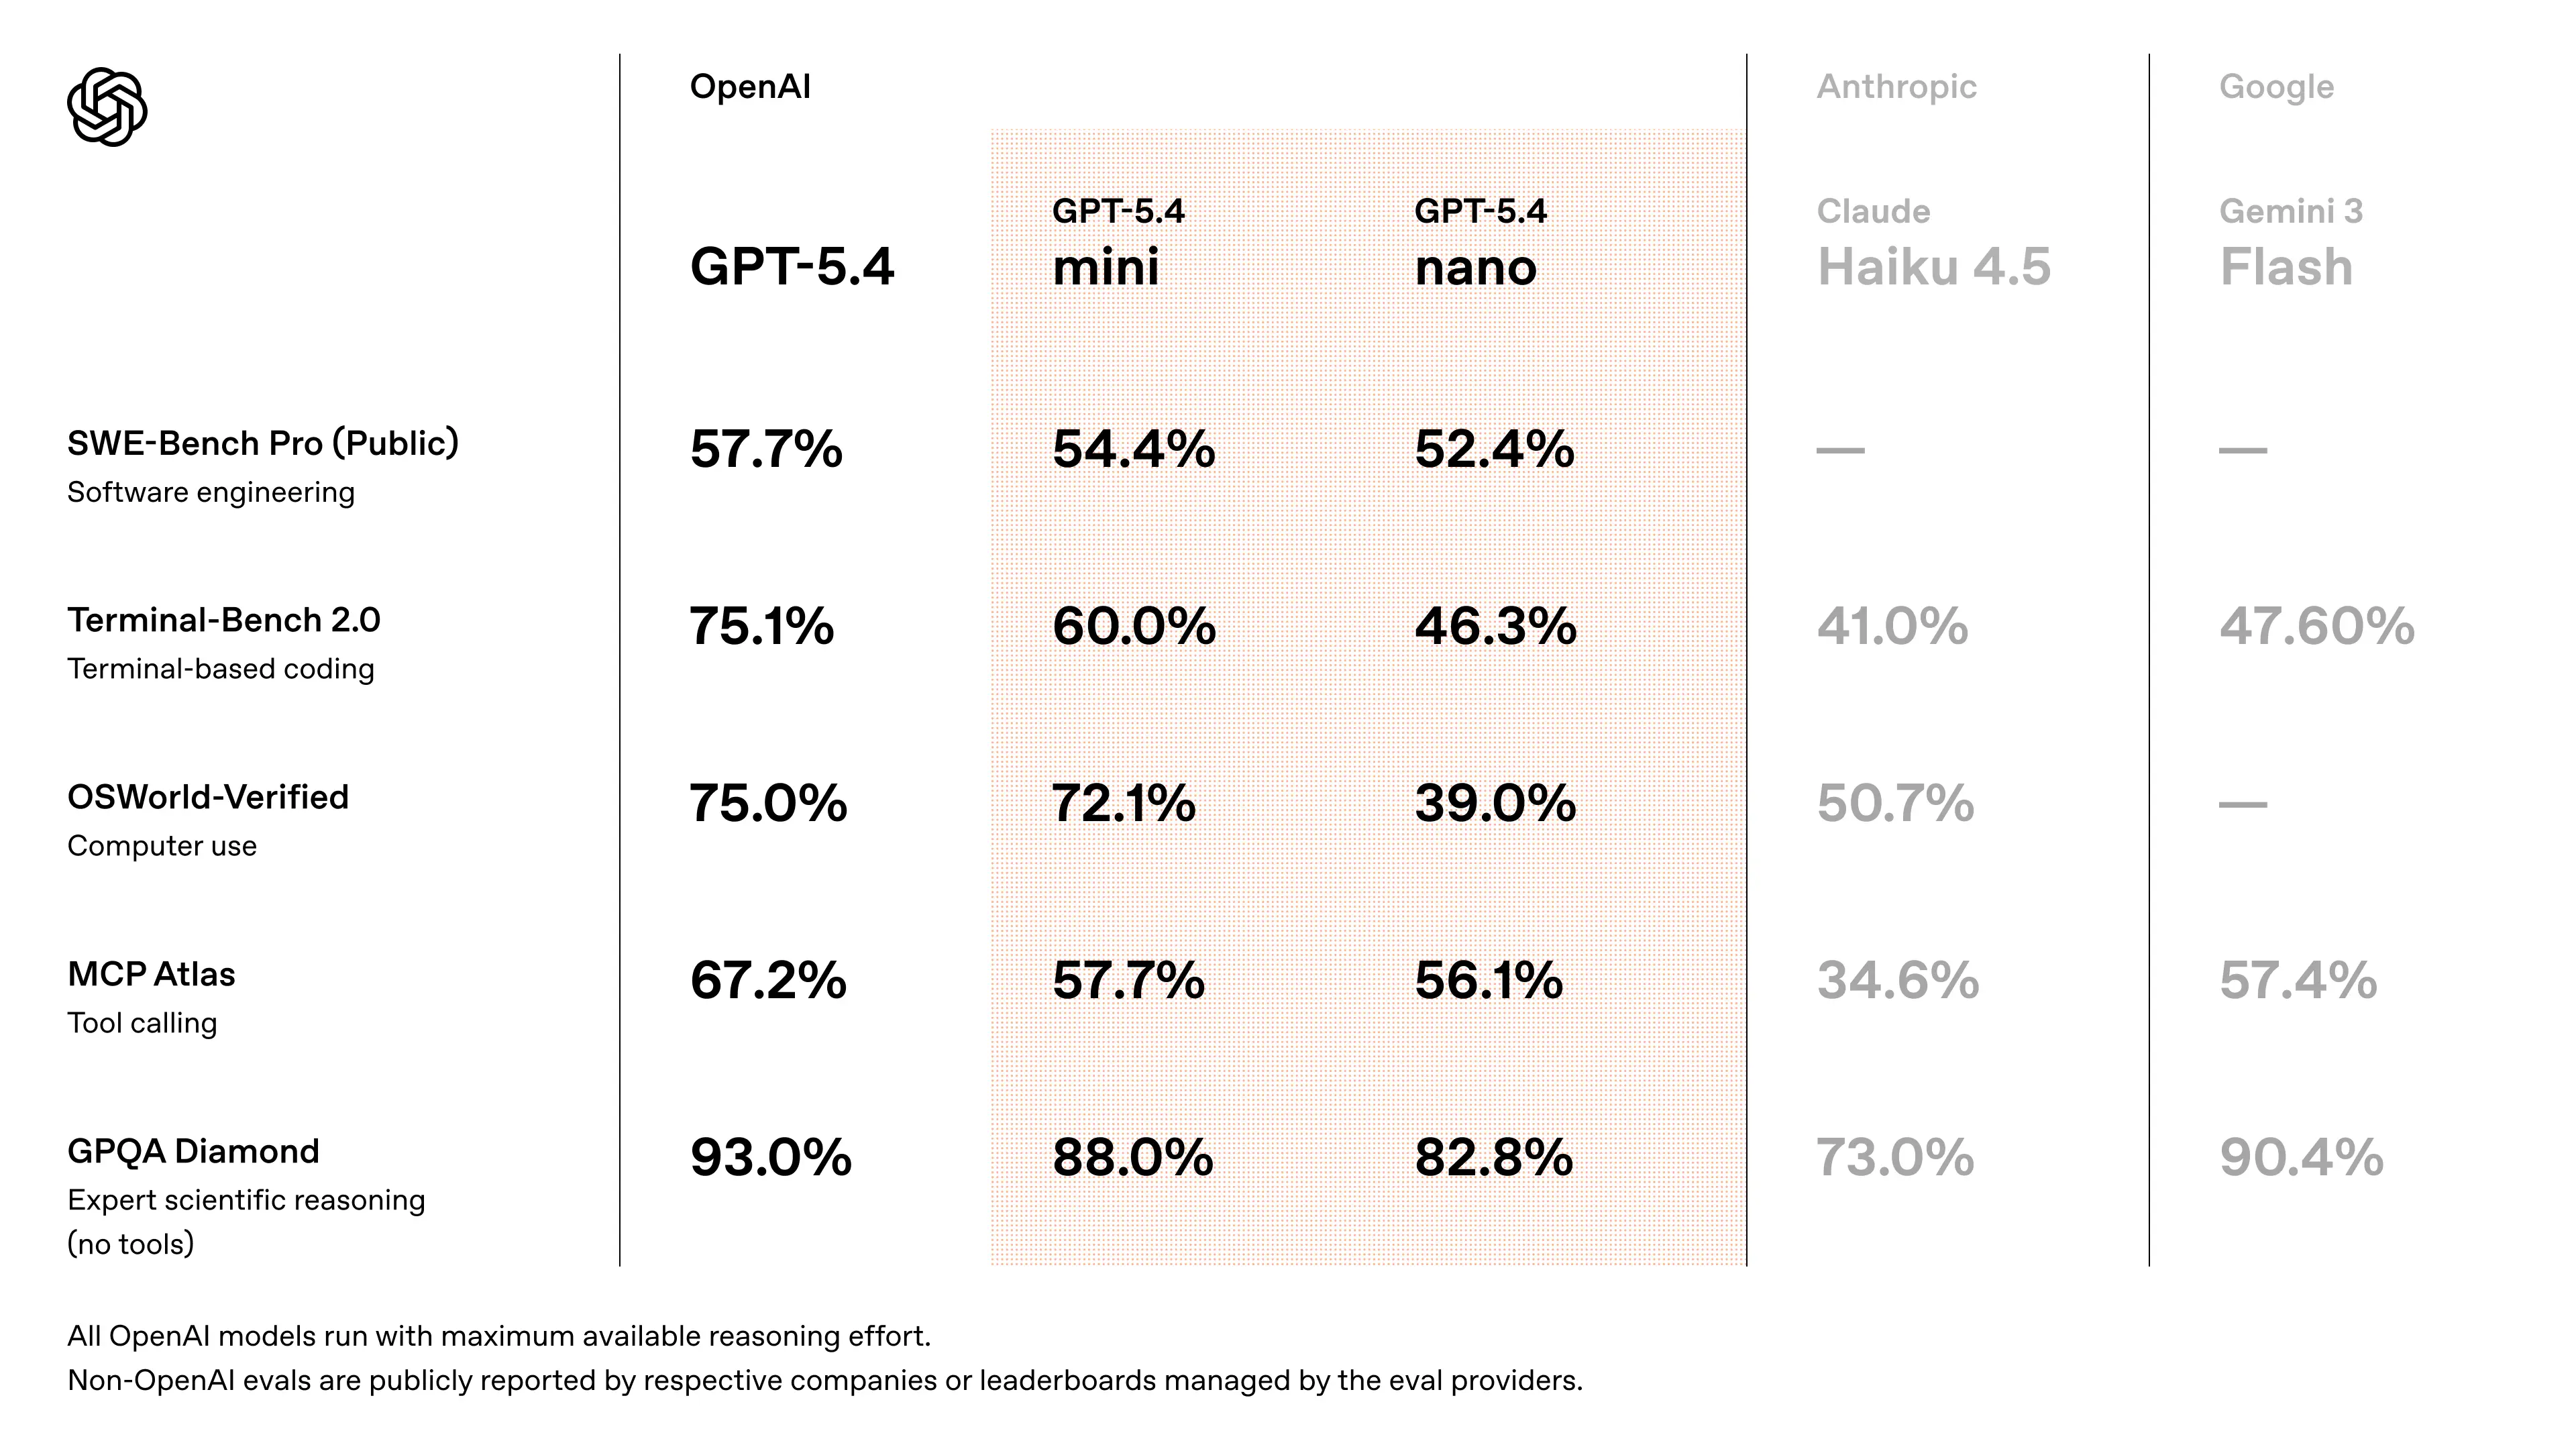
- Se rapproche des performances de GPT-5.4 sur des tâches de codage de type SWE-Bench (~94–95 % des performances du modèle phare) (estimation recoupée à partir des discussions de sortie)
- Améliorations significatives par rapport à GPT-5 Mini sur :
- la précision du raisonnement
- la fiabilité de l’usage des outils
- la compréhension multimodale
- Conçu pour surpasser les générations « mini » précédentes dans les workflows d’agents et les benchmarks de codage
- mesures de vitesse : les premiers testeurs API rapportent ~180–190 jetons/s sur GPT-5.4 Mini (contre ~55–120 jetons/s pour d’anciennes variantes GPT-5 mini selon les modes de priorité).
👉 À retenir : GPT-5.4 Mini offre des performances proches de l’état de l’art pour une fraction du coût et de la latence, ce qui en fait un choix idéal pour des systèmes à l’échelle.
Cas d’utilisation représentatifs
- Assistants et éditeurs de code (plugins IDE, Copilot) : l’analyse rapide du contexte, l’exploration du code et les complétions instantanées rendent GPT-5.4 Mini idéal pour les suggestions dans l’éditeur, où le temps jusqu’au premier jeton est crucial. GitHub Copilot est une intégration précoce.
- Sous‑agents / travailleurs délégués : lorsqu’un agent maître délègue des tâches courtes et rapides (mise en forme, petites étapes de raisonnement, recherches de type grep) à un travailleur bon marché et rapide. OpenAI positionne les mini/nano pour ces rôles.
- Automatisation API à grand volume : génération de code en masse, tri automatisé des tickets, synthèse de journaux à l’échelle, lorsque le coût par appel et la latence sont les principales contraintes. Les chiffres de débit de la communauté indiquent des avantages opérationnels substantiels pour le mini.
- Enrobage d’outils et chaînes d’outils : appels d’outils rapides où le modèle orchestre des appels à des outils externes (search, grep, exécution de tests) et renvoie des sorties compactes et actionnables. La famille GPT-5.4 inclut des capacités « computer use » améliorées.
Comment accéder à l’API GPT-5.4 Mini
Étape 1 : S’inscrire pour obtenir une clé API
Connectez-vous à cometapi.com. Si vous n’êtes pas encore utilisateur, veuillez d’abord vous inscrire. Connectez-vous à votre console CometAPI. Obtenez la clé API d’accès de l’interface. Cliquez sur “Add Token” dans la section API token de l’espace personnel, récupérez la clé de jeton : sk-xxxxx, puis soumettez.

Étape 2 : Envoyer des requêtes à l’API GPT-5.4 Mini
Sélectionnez le point de terminaison “gpt-5.4-mini” pour envoyer la requête API et définir le corps de la requête. La méthode et le corps de la requête sont fournis par la documentation API de notre site. Notre site propose également un test Apifox pour votre commodité. Remplacez <YOUR_API_KEY> par votre clé CometAPI réelle de votre compte. L’URL de base est Complétions de chat et Réponses.
Insérez votre question ou requête dans le champ content — c’est à cela que le modèle répondra. Traitez la réponse de l’API pour obtenir la réponse générée.
Étape 3 : Récupérer et vérifier les résultats
Traitez la réponse de l’API pour obtenir la réponse générée. Après traitement, l’API renvoie l’état de la tâche et les données de sortie.