TL;DR : Alibaba a lancé le 16 novembre 2026 Qwen4-Max, modèle phare de la génération Qwen4. Les évaluations officielles indiquent de meilleures performances sur des tâches industrielles et des coûts d’exécution plus faibles que Qwen3.8-Max, reflétant des gains d’efficacité en jetons et une baisse des tarifs API.
Principaux enseignements
- Taille du modèle : Qwen4-Max compte 2,4 billions de paramètres de base, dont 71 milliards activés par jeton.
- Fenêtre de contexte : Qwen4-Max prend en charge une fenêtre de contexte d’un million de jetons.
- Prise en charge multimodale : Qwen4-Max accepte du texte, des images et de la vidéo et génère du texte.
- Fonctionnalités développeur : Qwen4-Max prend en charge les appels de fonctions, les sorties structurées, la mise en cache du contexte et la recherche web.
- Options d’accès : Les utilisateurs peuvent accéder à Qwen4-Max via les applications Qwen prises en charge, l’API QwenCloud à l’usage et les abonnements Token Plan.
Qu’est-ce que Qwen4-Max ?
Dans l’annonce officielle d’Alibaba, Qwen décrit Qwen4-Max comme un coéquipier IA pour le travail, la création et l’exploration. Ses capacités se concentrent sur la compréhension des objectifs, l’utilisation d’outils, la réponse aux retours d’exécution et la livraison de résultats en plusieurs étapes.
Pour ces flux, le modèle fournit le raisonnement et la coordination. Les applications, outils et environnements d’exécution connectés réalisent les opérations.
Spécifications de Qwen4-Max
La page officielle du modèle QwenCloud liste les spécifications suivantes :
| Spécification | Qwen4-Max |
|---|---|
| Model ID | qwen4-max |
| Paramètres de base | 2,4 billions |
| Paramètres activés par jeton | 71 milliards |
| Fenêtre de contexte | 1 million de jetons |
| Entrée / sortie | Texte, images et vidéo / Texte |
| Limites du mode Standard | Entrée maximale : 991K ; sortie maximale : 131K jetons |
| Limites du mode Thinking | Entrée maximale : 983K ; sortie maximale : 262K jetons |
| Longueur maximale de raisonnement | 262K jetons |
| Capacités développeur | Appel de fonctions, sorties structurées, mise en cache du contexte et recherche web |
| Compatibilité API | Protocoles d’API OpenAI et Anthropic |
La taille de contexte, les limites d’entrée et les limites de sortie représentent des contraintes différentes. Les applications doivent les satisfaire conjointement et réserver une capacité suffisante pour les réponses générées et le raisonnement.
Quelles sont les principales fonctionnalités de Qwen4-Max ?
Les capacités de Qwen4-Max sont particulièrement pertinentes lorsque la tâche s’étend sur plusieurs documents, outils et étapes d’exécution. Un long contexte préserve le cadre de travail, la compréhension visuelle élargit les preuves disponibles, et les capacités d’agent aident à faire avancer la tâche vers la livraison.
Fenêtre de contexte d’un million de jetons et compréhension visuelle native
La grande fenêtre de contexte permet de traiter des éléments liés dans un contexte de travail partagé. Des applications pratiques incluent la comparaison de contrats, l’analyse de dépendances entre fichiers de code et la relecture de rapports aux côtés des documents de référence.
La compréhension visuelle native étend cela aux captures d’écran, schémas, pages scannées et vidéos. Un utilisateur peut fournir un dessin technique ou une capture d’interface et demander au modèle de l’interpréter en parallèle d’exigences écrites.
Pour les tâches à forte composante documentaire, conserver les noms de fichiers, dates et libellés de section aide à organiser les preuves et facilite la vérification de l’analyse résultante.
Programmation et utilisation professionnelle d’outils
Qwen4-Max prend en charge l’appel de fonctions, permettant aux développeurs de le connecter à des bases de données, services de recherche, opérations sur fichiers et systèmes métier. Les sorties structurées aident à transmettre les résultats du modèle aux processus logiciels suivants.
Les démonstrations officielles montrent des workflows logiciels plus larges. En développement de jeux, le modèle utilise des moteurs tels que Unity, Unreal Engine et Godot pour construire des scènes, implémenter du gameplay et affiner les résultats via des tests. Dans Blender, il coordonne géométrie, matériaux, éclairage et rendu.
Reproduire ces workflows nécessite les logiciels, ressources et autorisations d’exécution pertinents. Les démonstrations montrent ce que le modèle peut accomplir dans ces environnements.
Agents à horizon long et Live Delivery
Les longues tâches deviennent difficiles à gérer lorsque les utilisateurs ne peuvent pas inspecter l’avancement avant la fin. L’approche Live Delivery de Qwen4-Max introduit un résultat initial utilisable suivi de mises à jour successives.
Pour un devoir de recherche, un agent peut d’abord livrer des constatations préliminaires et une liste de sources, puis étendre l’analyse et ajouter des graphiques. Les utilisateurs peuvent examiner chaque version et réorienter le travail ultérieur.
Qwen a également publié le Qwen-Live-Delivery-Plugin. Pour des workflows durant des heures ou plus, une livraison par étapes crée des points de contrôle pratiques pour revoir la qualité et corriger la direction.
Architecture et efficacité en jetons
Qwen4-Max introduit plusieurs changements à son architecture sparse mixture-of-experts :
- Gated DeltaNet et Qwen Sparse Attention : combinent compression de l’historique et attention sélective au contexte pertinent, réduisant le calcul sur longues séquences.
- Gated Residual : utilise quatre branches résiduelles parallèles et des portes dynamiques pour améliorer le transfert d’information et la stabilité d’entraînement.
- N-gram Embedding : ajoute 328 milliards de paramètres d’embeddings pour représenter des motifs locaux de jetons via des opérations de lookup, augmentant la capacité avec un surcoût de calcul relativement faible.
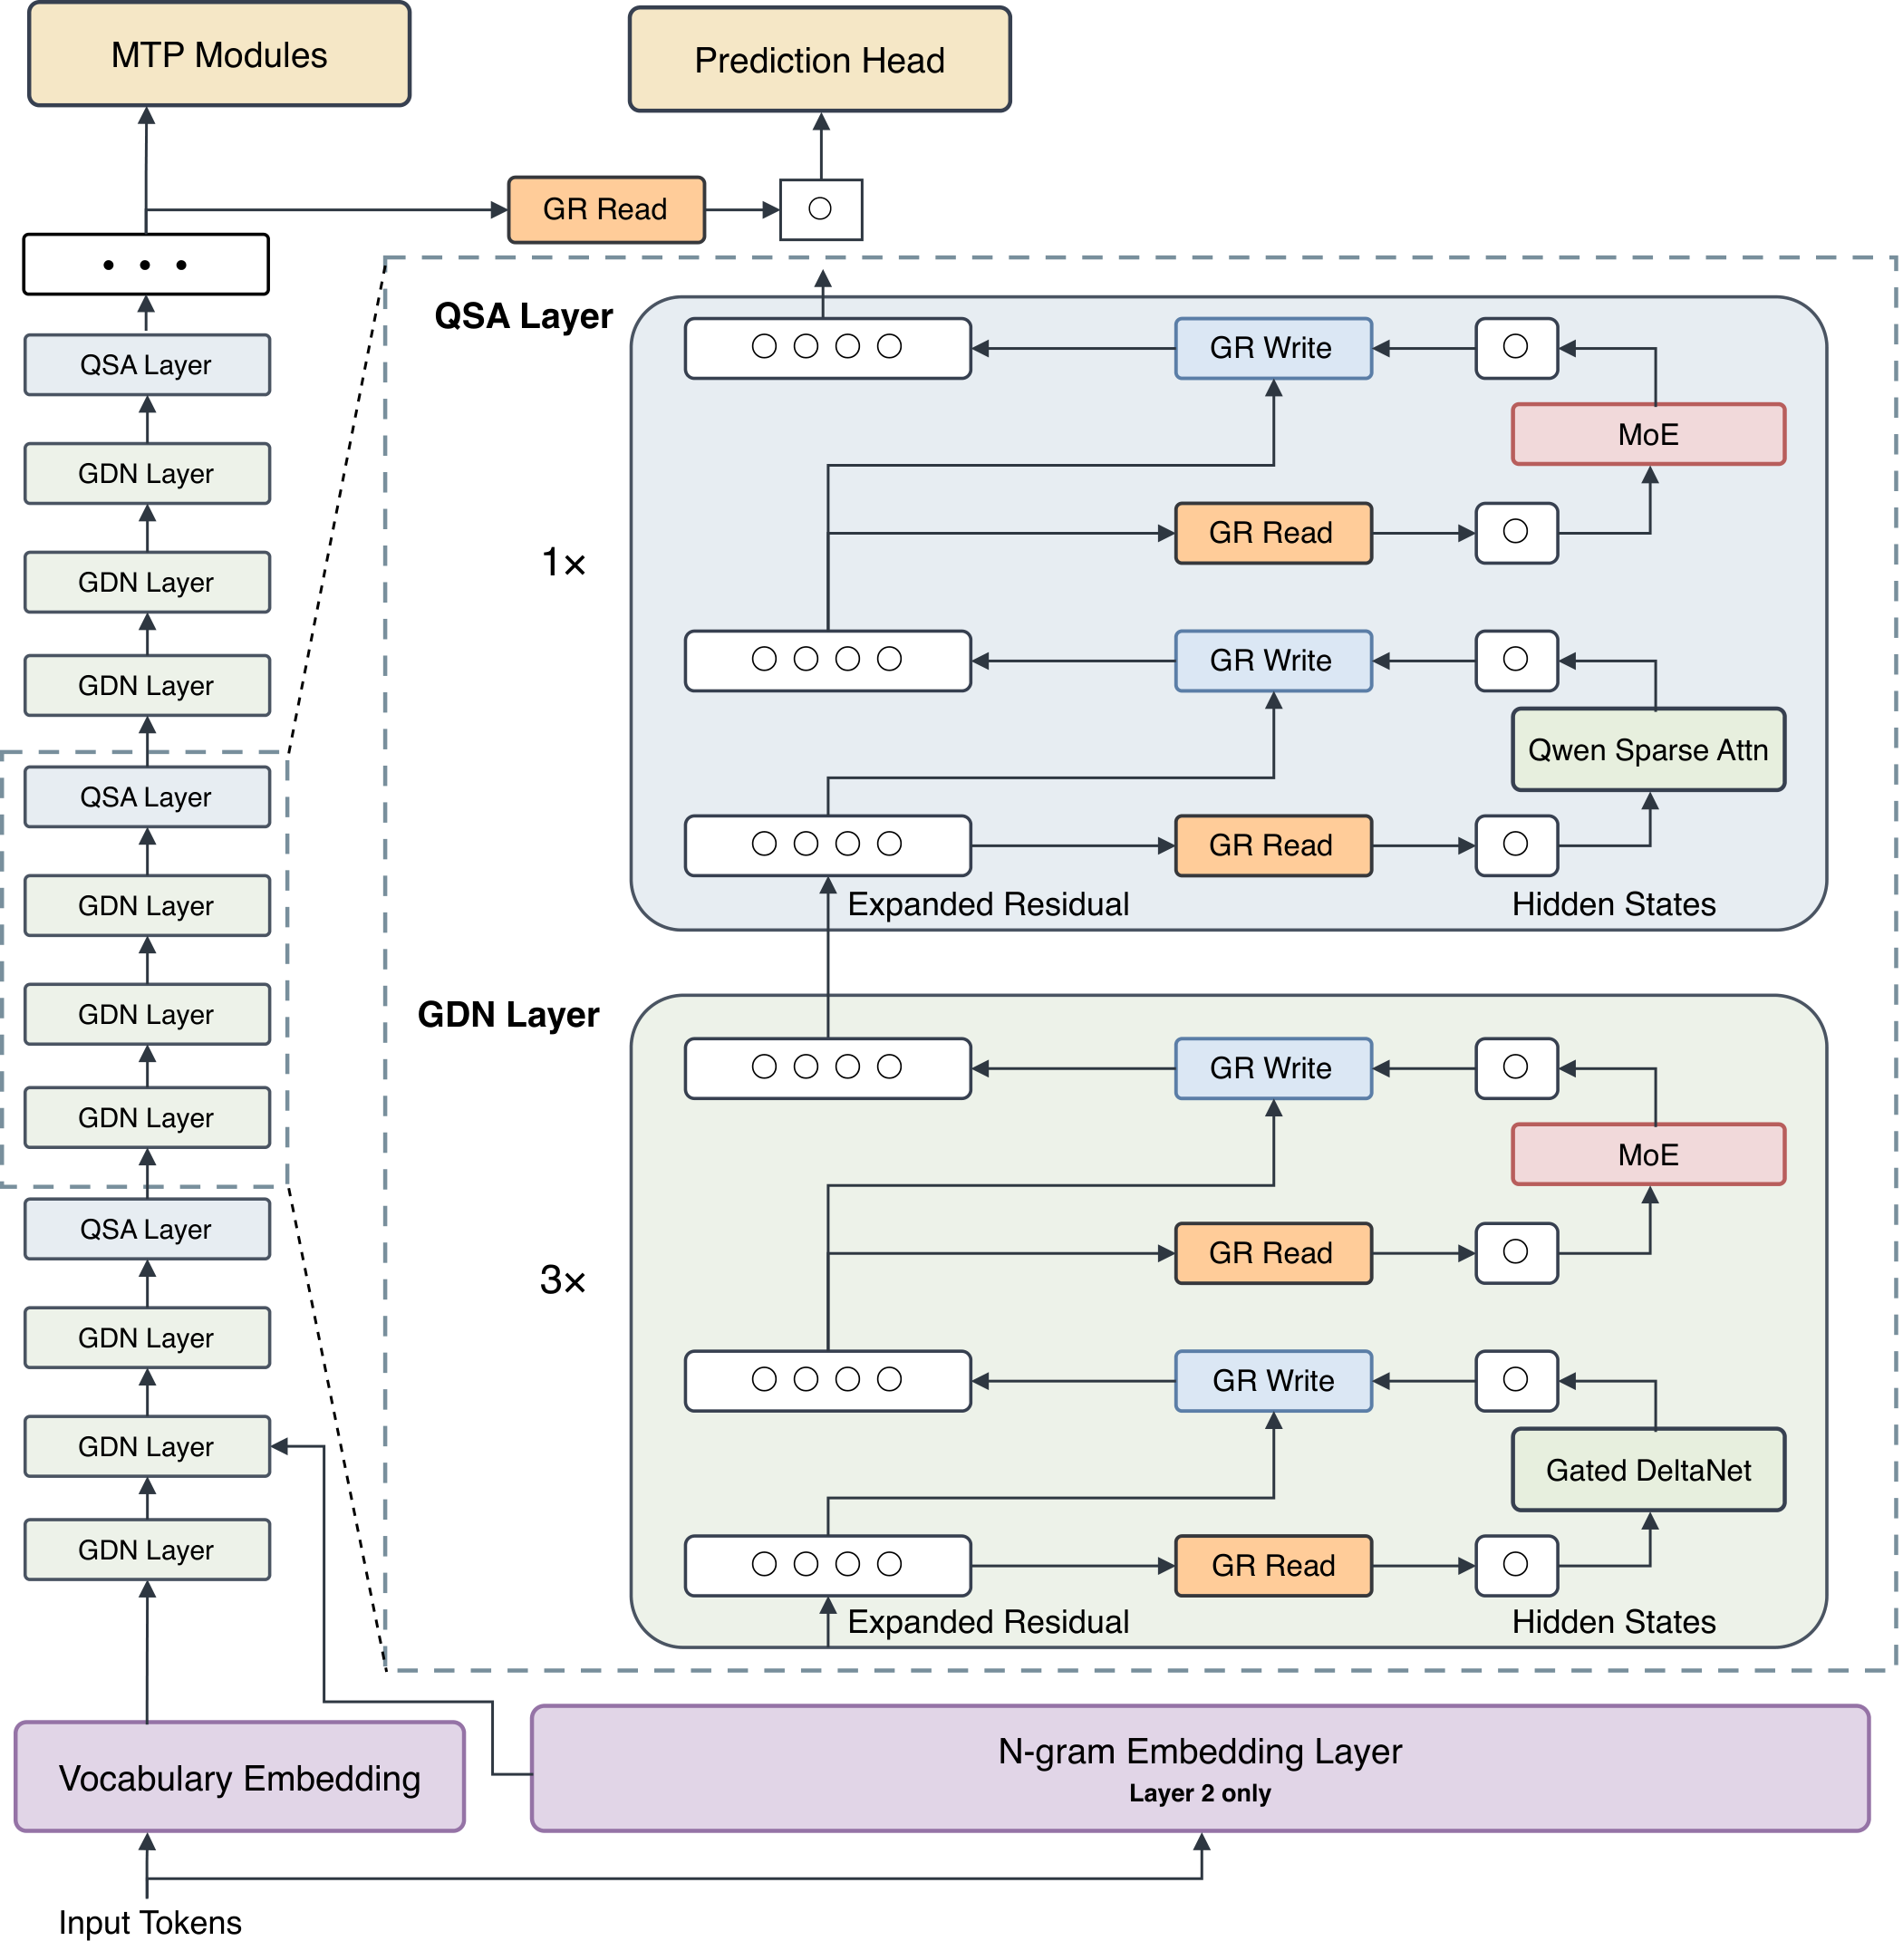
Pour les utilisateurs, l’épreuve pratique est de savoir si ces changements réduisent les ressources nécessaires pour livrer un résultat acceptable. Les mesures publiées par Qwen sur la consommation de jetons apportent des preuves d’améliorations sur les tâches évaluées.
Comment Qwen4-Max se comporte-t-il ? Benchmarks officiels et exemples
Les benchmarks publiés par Qwen mesurent la performance des tâches, la consommation de jetons et les coûts d’exécution, tandis que les démonstrations illustrent des workflows pratiques.
Résultats de benchmark de Qwen4-Max
Les résultats suivants comparent Qwen4-Max à Qwen3.8-Max :
| Indicateur | Qwen4-Max vs. Qwen3.8-Max |
|---|---|
| Score Work360 | Passé de 47.74 à 52.69 |
| Consommation de jetons Work360 | Réduite d’environ 24% en Xhigh et 35% en High |
| Consommation de jetons Terminal-Bench 4.0 | Réduite d’environ 48% en Xhigh et 49% en High |
| Coût moyen par tâche Work360 | Tombé de RMB 26.58 à RMB 11.16, soit environ 58% de moins |
La réduction de coût reflète à la fois une consommation de jetons plus faible et une révision des tarifs API.
Pour les applications qui effectuent des appels d’outils répétés, le coût par tâche complétée avec succès est une comparaison plus utile que les seuls prix des jetons. Une requête moins chère offre des économies limitées si le workflow nécessite de nombreux retries ou des corrections manuelles.
Exemples en recherche financière et fabrication
Plusieurs exemples officiels fournissent des livrables concrets et des résultats mesurables.
En recherche financière, le modèle combine des outils de données de marché et la recherche pour produire des feuilles de travail Excel et des rapports PowerPoint éditables. Des liens sources et des graphiques alignés permettent aux relecteurs de remonter des conclusions du rapport aux données de support.
Dans un exemple de fabrication, le modèle combine modélisation paramétrique, génération de trajectoires d’outil et retours de simulation. Le temps de programmation humaine pour une pièce est passé d’environ 475 minutes à 24 minutes. Ce résultat décrit la pièce et l’environnement d’outillage démontrés et constitue un point de départ utile pour évaluer des processus similaires.
Comment interpréter les résultats
Le score Work360 de Qwen4-Max est passé de 47.74 à 52.69, un gain de 4.95 points. Cela indique de meilleures performances sur les tâches industrielles évaluées, bien que les résultats individuels puissent varier. Les réductions de consommation de jetons offrent une mesure distincte de l’efficacité, avec des économies différentes selon les réglages de raisonnement High et Xhigh.
La réduction rapportée de 58% du coût moyen par tâche Work360 combine une consommation de jetons plus faible et des tarifs API révisés. Pour les développeurs, la question pertinente est de savoir si ces économies se répercutent jusqu’à une tâche complétée avec succès après retries et corrections manuelles.
Les démonstrations d’applications ajoutent des preuves concernant des workflows et livrables spécifiques. Utilisez-les pour identifier des tâches à tester, puis comparez qualité de complétion, effort de relecture et coût total dans des conditions d’outils constantes.
Tarification de Qwen4-Max : coûts API et options Token Plan
Qwen4-Max est disponible via une facturation API à l’usage et des abonnements Token Plan. L’option appropriée dépend de si vous construisez une application ou utilisez un outil d’IA interactif.
Tarification officielle API à l’usage
QwenCloud liste les prix suivants pour la région de Singapour :
| Élément de facturation | Prix par 1 million de jetons |
|---|---|
| Entrée Standard | $1.50 |
| Sortie | $4.50 |
| Entrée via cache implicite | $0.075 |
| Lecture de cache explicite | $0.075 |
La création de cache explicite coûte $1.875 par million de jetons pour un cache de cinq minutes et $3.00 pour un cache d’une heure.
Une tâche utilisant 100,000 jetons d’entrée non mis en cache et 10,000 jetons de sortie facturables coûte $0.195 en frais de jetons de modèle, hors outils ou services supplémentaires facturables.
L’entrée mise en cache est tarifée 95% en dessous de l’entrée standard. Les applications qui envoient à plusieurs reprises les mêmes instructions, définitions d’outils ou préfixes de documents peuvent réduire les coûts d’entrée en améliorant l’utilisation du cache.
Comment fonctionne Token Plan
Token Plan utilise une facturation par abonnement et des déductions de Credits. Il liste actuellement qwen4-max parmi ses modèles pris en charge.
Au 17 novembre 2026, la page de la région de Singapour affiche les plans mensuels individuels suivants :
| Plan | Prix mensuel | Credits mensuels |
|---|---|---|
| Lite | $6 | 20,000 |
| Essential | $10 | 45,000 |
| Standard | $18 | 80,000 |
| Pro | $43 | 200,000 |
La page annonce également une promotion pour nouveaux utilisateurs à partir de $3. L’éligibilité et le montant final sont affichés lors du paiement.
Les Credits sont des unités de facturation d’abonnement plutôt qu’une allocation directe de jetons. La consommation dépend du modèle et des règles d’outil applicables.
Selon la documentation Token Plan, le service est destiné à un usage interactif dans des outils d’IA compatibles et est actuellement disponible dans la région de Singapour.
Comment accéder à Qwen4-Max
Il existe trois voies pratiques : utiliser un produit Qwen, se connecter directement via QwenCloud ou configurer un outil d’IA compatible. Chacune a des exigences d’installation différentes, notamment autour des identifiants et des endpoints.
Utiliser les applications Qwen
L’annonce officielle liste Qwen Studio, l’app Qwen, QwenWork et Qoder comme canaux d’accès.
Ces produits offrent un point de départ pratique pour tester l’analyse de documents, l’assistance au code et les workflows bureautiques. Les développeurs qui doivent contrôler les requêtes, les outils et le traitement des résultats peuvent passer à une intégration directe via API.
Accéder à l’API QwenCloud
Pour accéder à Qwen4-Max, connectez-vous à QwenCloud, obtenez une clé API pour votre région sélectionnée et configurez l’endpoint correspondant avec le Model ID qwen4-max. QwenCloud fournit un accès compatible avec OpenAI. Les utilisateurs migrant depuis la préversion doivent également revoir leurs paramètres de requête et leur configuration de facturation.
Configurer des outils de code et d’agents
La documentation Token Plan fournit des guides d’intégration pour des outils dont Qwen Code, Cline, Cursor et OpenCode.
La configuration nécessite généralement une clé API dédiée, l’URL de base appropriée et le nom du modèle. Token Plan utilise le domaine d’endpoint distinct token-plan.maas.qwencloudapi.com, et ses clés ne sont pas interchangeables avec les clés API à l’usage.
Suivez le guide de l’outil choisi, puis validez la configuration avec une tâche incluant la lecture de matériel, l’exécution d’une opération et la vérification du résultat.
Qui devrait utiliser Qwen4-Max ?
Qwen4-Max mérite d’être évalué lorsqu’un workflow récurrent requiert un contexte étendu, plusieurs outils et un livrable vérifiable.
- Développeurs : peuvent évaluer Qwen4-Max pour des changements de code multi-fichiers, le développement front-end et des agents utilisant des outils externes.
- Équipes bureautiques et de recherche : peuvent l’utiliser pour analyser des documents, organiser des données et préparer des rapports avec sources traçables.
- Équipes design et contenus : peuvent le tester pour la modélisation 3D, des prototypes de jeux et des workflows vidéo connectés à des logiciels professionnels.
- Équipes d’entreprise : peuvent évaluer des processus récurrents avec accès aux données défini, interfaces d’outils et critères d’acceptation.
Pour les workflows financiers, juridiques et médicaux, utilisez-le pour le traitement des preuves et l’appui analytique, avec des professionnels qualifiés pour revoir les conclusions à conséquences.
FAQ
La limite de sortie de Qwen4-Max est-elle d’un million de jetons ?
Non. La fenêtre de contexte et la longueur maximale de sortie sont des limites distinctes. QwenCloud indique des sorties maximales de 131K jetons en mode standard et 262K jetons en mode thinking. Les requêtes doivent également respecter les limites d’entrée et de contexte applicables.
Dois-je choisir l’API Qwen4-Max ou Token Plan ?
Choisissez l’API à l’usage lors de l’intégration de Qwen4-Max dans une application ou un service backend. Token Plan est destiné à un usage interactif dans des outils d’IA compatibles et utilise des Credits d’abonnement. Les deux options nécessitent des identifiants et endpoints distincts.
Puis-je utiliser Qwen4-Max gratuitement ?
L’accès API officiel et Token Plan sont des services payants. L’accès gratuit via des applications Qwen, lorsqu’il est proposé, suit les règles de compte et d’usage de chaque produit ; il n’établit pas d’allocation API gratuite.
Puis-je télécharger Qwen4-Max pour un déploiement local ?
Au 17 novembre 2026, Qwen n’a pas fourni de poids ouverts pour Qwen4-Max, de sorte que la version officielle n’offre pas de modèle téléchargeable pour un déploiement local. Qwen a annoncé l’intention d’ouvrir progressivement des modèles plus petits de la série Qwen4.
Conclusion
Qwen4-Max est un solide candidat pour l’analyse de longs documents, la programmation complexe et des workflows impliquant plusieurs outils. Les évaluations officielles montrent des scores plus élevés et des coûts par tâche plus faibles que Qwen3.8-Max sur les charges rapportées.
Commencez avec une tâche représentative disposant déjà de critères d’acceptation clairs. Comparez la qualité de sortie, le temps de correction manuelle, le temps d’exécution et le coût total. Des améliorations sur ces mesures offrent une base pratique pour étendre Qwen4-Max à des workflows similaires.