Construire avec CometAPIBesoin d'une seule API pour plusieurs modèles ?Testez le workflow dans Playground, puis créez une clé API lorsque le modèle et le coût correspondent à votre cas d'usage.
Comment réduire les coûts en jetons des agents d’IA en production
Réduisez les coûts en jetons des agents d’IA en contrôlant la croissance du contexte, la sortie des outils, les réessais, le raisonnement et les sous-agents. Comprend un exemple de coûts en 12 étapes.
Mia MarenÉquipe de recherche sur les modèles IA et API
Les coûts en jetons des agents IA augmentent quand chaque étape reprocesse les instructions, l’historique de conversation, les résultats d’outils et l’état intermédiaire.
Réduisez le volume de jetons avec des budgets au niveau du run, un filtrage des résultats d’outils, un compactage du contexte, des limites de réessais et un raisonnement contrôlé. Utilisez la mise en cache des prompts pour les entrées stables répétées, mais optimisez la boucle de l’agent avant de passer à un modèle moins cher.
La métrique de production la plus utile est le coût par tâche réussie, mesuré sur l’ensemble du run—pas le prix par requête ni la taille du contexte du dernier appel.
Ce guide se concentre spécifiquement sur les agents IA multi-étapes. Il explique comment le contexte répété se cumule sur un run, comment identifier la plus grande source de gaspillage et quels contrôles implémenter en premier.
Introduction
Un chatbot peut faire une requête modèle par message utilisateur. Un agent IA peut effectuer 10, 20, ou davantage d’appels avant de terminer une tâche.
Revu pour la clarté, l'attribution des sources et la terminologie API actuelle.
Chaque étape peut renvoyer les instructions, l’historique de conversation, les résultats d’outils et l’état intermédiaire. Les réessais, le raisonnement et les sous-agents ajoutent de l’usage, si bien qu’une réponse finale courte peut malgré tout consommer un grand nombre de jetons.
À mesure que l’usage augmente, ces coûts deviennent plus difficiles à prévoir et peuvent rapidement réduire les marges produit. Les abaisser nécessite d’optimiser la boucle complète de l’agent—pas simplement de passer à un modèle moins cher.
Cet article se focalise sur les coûts spécifiques aux agents. Pour un guide plus large couvrant la mise en cache de prompts, la mise en cache exacte des réponses, la mise en cache sémantique, le routage de modèles et la gestion générale des coûts d’API, voir How to Reduce AI API Costs (https://www.cometapi.com/reduce-ai-api-costs/).
Why Do AI Agent Token Costs Compound?
Dans un agent multi-étapes, le coût d’une tâche est la somme de chaque appel modèle—pas seulement la réponse finale.
Les principales sources de consommation de jetons d’un agent sont :
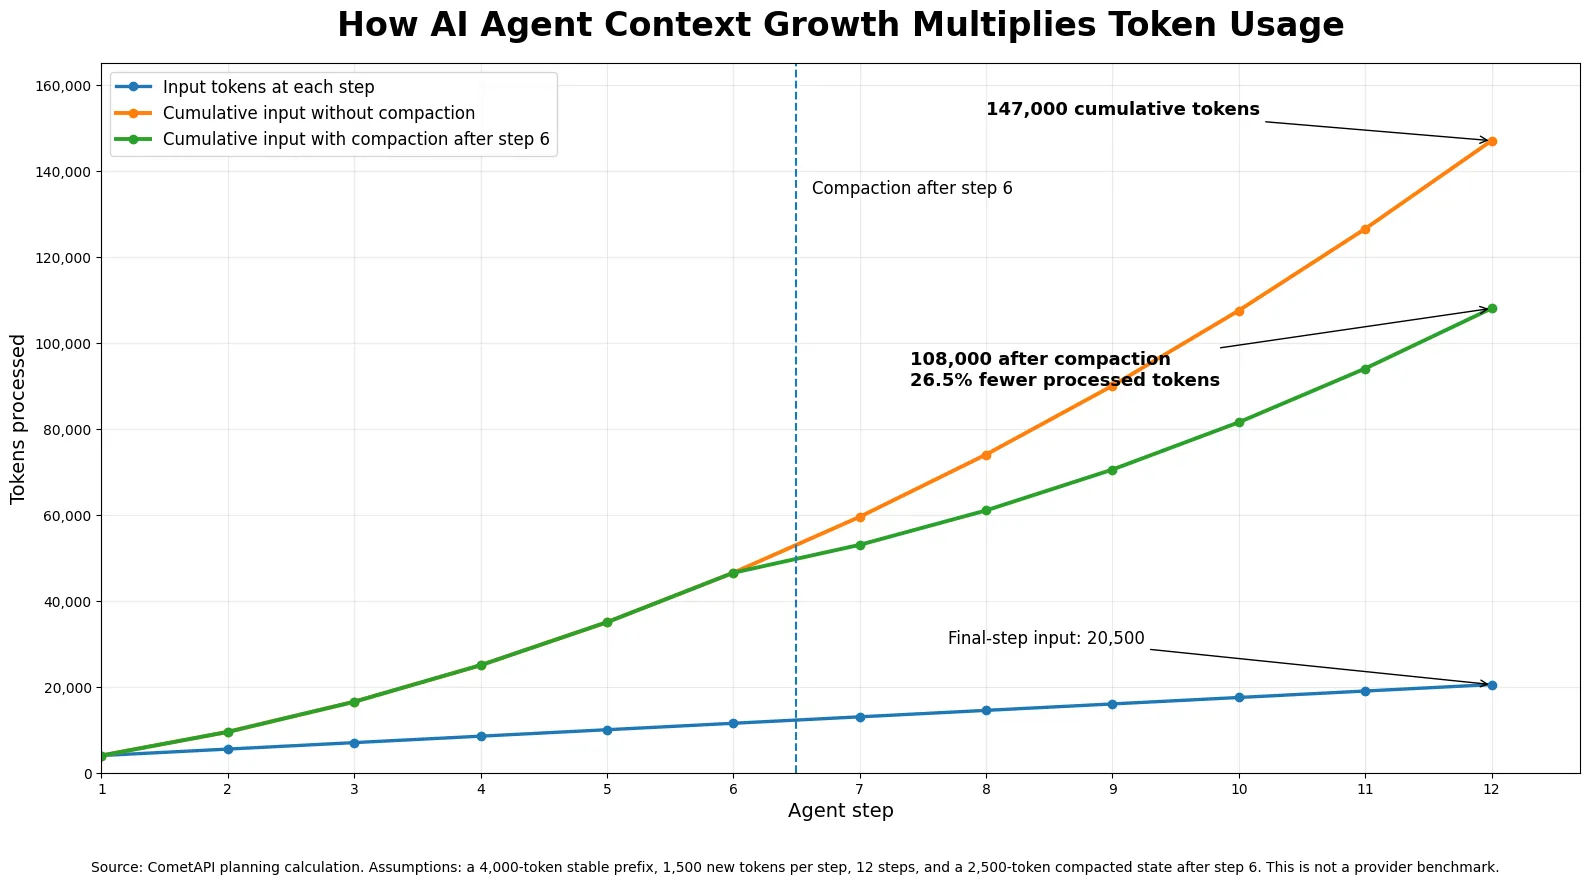
Le dernier appel ne contient que 20 500 jetons d’entrée, mais l’ensemble du run traite 147 000 jetons d’entrée cumulés.
Appliquons maintenant deux contrôles :
Mettre en cache le préfixe stable de 4 000 jetons après le premier appel.
Compacter l’historique après la sixième étape en un résumé d’état de 2 500 jetons.
Scénario
Entrée non mise en cache
Entrée mise en cache
Total des entrées traitées
Changement
Historique complet à chaque étape
147 000
0
147 000
Référence
Préfixe stable mis en cache
103 000
44 000
147 000
Même volume, mix moins cher
Cache + compactage
64 000
44 000
108 000
26,5 % de jetons traités en moins
Il s’agit d’un calcul de planification, pas d’un benchmark fournisseur.
Il suppose que chaque requête inclut l’historique accumulé complet. Les agents qui construisent sélectivement l’état, résument les anciens messages ou ne récupèrent que l’information pertinente peuvent suivre une autre courbe de coûts.
Règle de croissance des coûts : mesurez l’entrée cumulée sur l’ensemble du run. La taille du contexte final ne représente pas le nombre total de jetons traités.
Which Metrics Reveal Agent Token Waste?
Ne commencez pas par changer de modèle. Identifiez d’abord où le workflow dépense des jetons sans améliorer le résultat.
Enregistrez ces champs pour chaque étape de l’agent :
Champ
Pourquoi c’est important
run_id, step_id, parent_step_id
Reconstruit l’arbre de l’agent et des sous-agents
Rendered input tokens
Montre comment le contexte croît entre les appels
Cached and uncached input
Sépare la réutilisation du nouveau contexte
Output and reasoning tokens
Identifie les étapes de génération coûteuses
Tool result size and retained tokens
Montre la quantité de preuves brutes injectées
Retry reason and attempt number
Identifie les échecs répétés
Compaction tokens before and after
Mesure la réduction réelle du contexte
Worker ID and returned tokens
Révèle les travaux de sous-agents dupliqués
Accepted, rejected, or escalated result
Relie le coût à la qualité de la tâche
La métrique principale doit être :
cost per successful task
= total workflow cost
/ accepted tasks
Un run moins cher n’est pas une amélioration s’il provoque plus d’échecs de tâches, d’outils répétés ou de corrections humaines.
Quatre métriques spécifiques aux agents aident à localiser le problème.
Une valeur élevée indique que le contexte antérieur a été traité de façon répétée.
Tool Retention Ratio
tool retention ratio
= tool-result tokens retained in context
/ tokens originally returned by tools
Un ratio élevé peut indiquer que l’agent transporte trop de preuves brutes entre les étapes.
Retry Tax
retry tax
= retry and repair cost
/ total workflow cost
Reasoning Share
reasoning share
= reasoning-token cost
/ total model cost
Mesurez chaque charge de travail séparément. Les agents de recherche, de codage, de navigation web et de support client ne doivent pas partager une base de référence globale.
Six Ways to Reduce AI Agent Token Costs
1. Set a Budget for the Complete Run
Une limite de sortie par requête ne contrôle pas un agent multi-étapes.
Définissez des limites au niveau du run pour :
Le nombre total d’étapes du modèle
Les entrées et sorties cumulées
Les appels d’outils et la taille des résultats d’outils
Les réessais par type d’échec
Les sous-agents
Le temps total écoulé ou le coût estimé
L’exemple Python ci-dessous, indépendant du fournisseur, évalue le run avant chaque appel modèle :
from dataclasses import dataclass
from enum import Enum


class Action(str, Enum):
    CONTINUE = "continue"
    COMPACT = "compact"
    STOP = "stop"


@dataclass(frozen=True)
class Budget:
    max_steps: int = 12
    max_input_tokens: int = 120_000
    max_output_tokens: int = 18_000
    compact_at: float = 0.80


@dataclass
class Usage:
    steps: int = 0
    input_tokens: int = 0
    output_tokens: int = 0


def evaluate_budget(usage: Usage, budget: Budget) -> Action:
    if (
        usage.steps >= budget.max_steps
        or usage.input_tokens >= budget.max_input_tokens
        or usage.output_tokens >= budget.max_output_tokens
    ):
        return Action.STOP

    input_ratio = usage.input_tokens / budget.max_input_tokens

    if input_ratio >= budget.compact_at:
        return Action.COMPACT

    return Action.CONTINUE
Exécutez la vérification avant chaque requête modèle et mettez à jour Usage à partir des données de jetons rapportées par le fournisseur.
À 80 % du budget d’entrée, compactez l’état ou réduisez la prochaine requête d’outil. À 100 %, arrêtez avec une raison structurée.
Erreur courante : limiter chaque réponse tout en autorisant des étapes, des outils et des réessais illimités.
2. Filter Tool Results Before They Enter the Transcript
Ne retournez que les preuves nécessaires à la prochaine décision de l’agent.
N’ajoutez pas en entier :
Une page web
Un fichier de log
Un arbre de dépôt
Une réponse de base de données
Une session terminal
Une charge utile d’API
si la prochaine étape n’a besoin que de quelques champs.
Un outil de recherche pourrait retourner :
{
  "source_id": "search_17",
  "title": "Relevant page title",
  "url": "https://example.com/page",
  "relevant_passage": "A short evidence block"
}
Stockez l’artéfact complet en dehors du prompt et récupérez une section plus étroite ultérieurement.
Règle de filtrage des outils : retournez les champs nécessaires à la prochaine décision—pas tous les champs qui pourraient devenir utiles plus tard.
Erreur courante : tronquer les 1 000 premiers caractères d’une charge utile JSON. Cela peut casser la structure ou supprimer les enregistrements dont l’agent a réellement besoin.
Parsez d’abord la charge utile, sélectionnez les champs de manière structurelle, limitez les tableaux, puis sérialisez un JSON valide.
3. Compact Operational State, Not Just Conversation Text
Le compactage doit préserver l’information requise pour poursuivre la tâche tout en supprimant l’historique qui n’influence plus la prochaine action.
Un état compact utile contient :
L’objectif utilisateur et les critères de réussite
Les décisions déjà prises
Les faits vérifiés et les IDs de sources
Les fichiers ou enregistrements modifiés
Les approches échouées
Les questions ouvertes
La prochaine action
Les contraintes de sécurité et de sortie
Il ne doit pas raconter l’intégralité de la conversation.
OpenAI documente le compactage pour les interactions longues de l’API Responses. Anthropic fournit des contrôles de gestion du contexte pour effacer ou résumer les contenus plus anciens. Ces implémentations diffèrent, vérifiez donc les champs actuels du fournisseur avant intégration.
Règle de compactage : préserver les décisions et le travail non résolu. Supprimer la narration et les preuves récupérables.
Erreur courante : supprimer les IDs de sources, noms de fichiers modifiés, approches rejetées ou contraintes non résolues.
Après ajout du compactage, mesurez si l’agent répète des recherches ou appels d’outils. Un prompt plus court n’est pas moins cher si l’agent doit reconstruire l’état perdu.
4. Keep the Reusable Prefix Stable
Les prompts d’agent contiennent souvent de grands blocs réutilisables :
Instructions système
Schémas d’outils
Politiques de sécurité
Formats de sortie
Matériel de référence partagé
Instructions de dépôt ou produit
Placez ces éléments stables avant les données spécifiques à la requête :
1. System instructions
2. Policies and constraints
3. Tool definitions
4. Stable examples
5. Shared reference material
6. Request-specific data
Évitez de placer des horodatages, IDs de requête, données de session ou valeurs changeant fréquemment au début.
La mise en cache est la plus utile quand le préfixe est long, stable et réutilisé. Elle peut ne pas faire économiser pour des sessions courtes ou des prompts changeant souvent.
Erreur courante : optimiser le taux de hit du cache sans mesurer le coût d’écriture, de lecture ou de stockage du cache.
Pour une comparaison plus large de la mise en cache des prompts, de la mise en cache exacte des réponses et de la mise en cache sémantique, voir How to Reduce AI API Costs (https://www.cometapi.com/reduce-ai-api-costs/).
5. Prevent Retries From Replaying the Same Context
Un réessai est une autre étape d’agent, souvent avec le même prompt volumineux.
Ne répétez pas une requête échouée sans changer la cause de l’échec.
Échec
Meilleure réponse
Sortie structurée invalide
Retourner l’erreur de validation et réessayer une fois
Timeout d’un outil
Réessayer une opération idempotente une fois, puis arrêter ou basculer
Dépassement de contexte
Compacter l’état ou récupérer moins de preuves
Appel d’outil répété
Dédupliquer via un hash d’opération
Limite de débit
Backoff ou route de secours testée
Faible confiance
Demander l’info manquante ou escalader
Utilisez des clés d’idempotence pour les opérations à effets de bord telles que paiements, e-mails, déploiements et écritures en base.
Erreur courante : réessayer plusieurs fois un modèle limité en débit en renvoyant tout le contexte de l’agent à chaque tentative.
Suivez le coût des réessais par type d’échec pour corriger d’abord la plus grande boucle.
6. Limit Reasoning and Subagents to Steps That Need Them
Toutes les étapes d’un agent ne nécessitent pas un raisonnement profond.
L’extraction, le formatage, la classification, la validation et la sélection d’outil routinière peuvent souvent utiliser un effort de raisonnement moindre et des sorties structurées compactes.
Réservez un effort de raisonnement plus élevé pour des tâches telles que :
Planification complexe
Codage difficile
Synthèse multi-documents
Décisions ambiguës
Récupération après exécution échouée
Règle de raisonnement : utiliser l’effort le plus faible qui préserve le taux de tâches acceptées.
Les sous-agents requièrent également une frontière claire. Donnez à chaque worker :
Une tâche étroite
Une tranche de contexte spécifique à la tâche
Une liste autorisée d’outils
Un budget de jetons
Un schéma de sortie compact
L’agent racine a généralement besoin de conclusions, d’IDs de preuves, de confiance et de points non résolus—pas de la transcription complète du worker.
Règle pour les sous-agents : parallélisez le travail indépendant, pas le contexte dupliqué.
Erreur courante : envoyer l’historique complet de l’agent racine à chaque worker avant d’assigner une tâche étroite.
Which Optimization Should You Apply First?
Utilisez la télémétrie de l’agent pour choisir la première intervention.
Les seuils ci-dessous sont des déclencheurs d’investigation, pas des standards universels.
Signal observé
Commencer ici
Amplification du contexte élevée
Compacter l’historique et récupérer l’état sélectivement
La sortie d’outil domine le prompt
Filtrer les champs et stocker les artéfacts complets en externe
Coût des réessais élevé
Corriger la validation, les timeouts et les appels répétés
Part de raisonnement élevée
Diminuer l’effort sur les étapes routinières
Les sous-agents dupliquent les preuves
Réduire la portée des workers et leurs tranches de contexte
Entrée mise en cache faible
Stabiliser le préfixe réutilisable
Coûts encore élevés après nettoyage
Comparer des routes de modèles moins coûteuses
Une séquence d’implémentation sûre :
Mesurer l’entrée cumulée, la rétention d’outils, les réessais et le raisonnement.
Ajouter des limites strictes pour les étapes, outils, réessais et jetons totaux.
Filtrer les grands résultats d’outils.
Compacter l’état ancien à un seuil mesuré.
Stabiliser le préfixe de prompt réutilisable.
Comparer les routes de modèles seulement après nettoyage de la boucle de l’agent.
Changez une variable majeure à la fois et rejouez le même jeu d’évaluation.
Comparez :
Taux d’acceptation des tâches
Coût par tâche réussie
Entrée cumulée
Nombre d’appels d’outils
Coût des réessais
Part de raisonnement
Latence p50 et p95
Temps de revue humaine
Restaurez les changements qui économisent des jetons au prix de la qualité des tâches ou qui suppriment des preuves nécessaires.
Pour la tolérance aux pannes en production, suivez le guide de fallback de modèle CometAPI (https://apidoc.cometapi.com/guides/model-fallback-with-cometapi) afin de changer de route sans répéter les appels d’outils déjà effectués ni perdre l’état validé.
L’accès unifié simplifie la comparaison de modèles et l’intégration du fallback. Les budgets de jetons, le compactage, la validation, le filtrage d’outils, les limites de réessais et les critères d’acceptation restent du ressort de l’application.
FAQ
Why do AI agents use more tokens than chatbots?
Les agents effectuent plusieurs appels au modèle et peuvent renvoyer à chaque étape les messages précédents, résultats d’outils, instructions et état intermédiaire. Cela entraîne un traitement répété du contexte antérieur.
Does prompt caching reduce context-window usage?
Non. La mise en cache des prompts peut réduire le prix effectif ou la latence des entrées répétées, mais les jetons mis en cache comptent toujours dans le contexte traité. Utilisez le compactage, le filtrage ou la récupération sélective pour réduire la taille du prompt.
When should an AI agent compact its context?
Compactez avant que la croissance du contexte n’impacte le coût, la latence ou l’espace de sortie disponible. Vérifiez que l’état compacté préserve les décisions, les IDs de sources, les fichiers modifiés, les questions ouvertes et les contraintes de sécurité.
Do subagents reduce token costs?
Pas automatiquement. Ils peuvent réduire le temps écoulé ou améliorer la couverture pour du travail indépendant, mais le contexte dupliqué et les analyses chevauchantes augmentent souvent la consommation totale de jetons.
What is the best metric for AI agent cost optimization?
Utilisez le coût par tâche réussie comme métrique principale. Diagnostiquez-le avec l’entrée cumulée, l’amplification du contexte, la rétention des outils, le coût des réessais, la part de raisonnement, la latence et le temps de revue humaine.