
TL;DR
Kimi K3.1 Pro apporte de meilleures performances en codage, CAO et recherche financière à la base K3 de Moonshot AI, avec une fenêtre de contexte d’un million de tokens. Son score publié de 65.7% sur Terminal-Bench 4.0 la place près de Claude Opus 5.5 dans la comparaison de Moonshot. Le modèle standard convient aux charges sensibles au coût ; Highspeed offre une vitesse de sortie environ 2–3× supérieure avec les mêmes capacités annoncées.
Les deux sont disponibles via l’API Kimi K3.1 Pro de CometAPI.La tarification standard de CometAPI est de 1,60 $ par million de tokens d’entrée et 8,00 $ par million de tokens de sortie. Ce guide explique les benchmarks, compare les coûts et montre comment appeler l’une ou l’autre version. Les chiffres et les prix ont été vérifiés le 24 octobre 2026.
Principaux enseignements
- Kimi K3.1 Pro est une mise à niveau post-entraînement : elle repose sur la base MoE de K3 et prend en charge une fenêtre de contexte de 1 048 576 tokens.
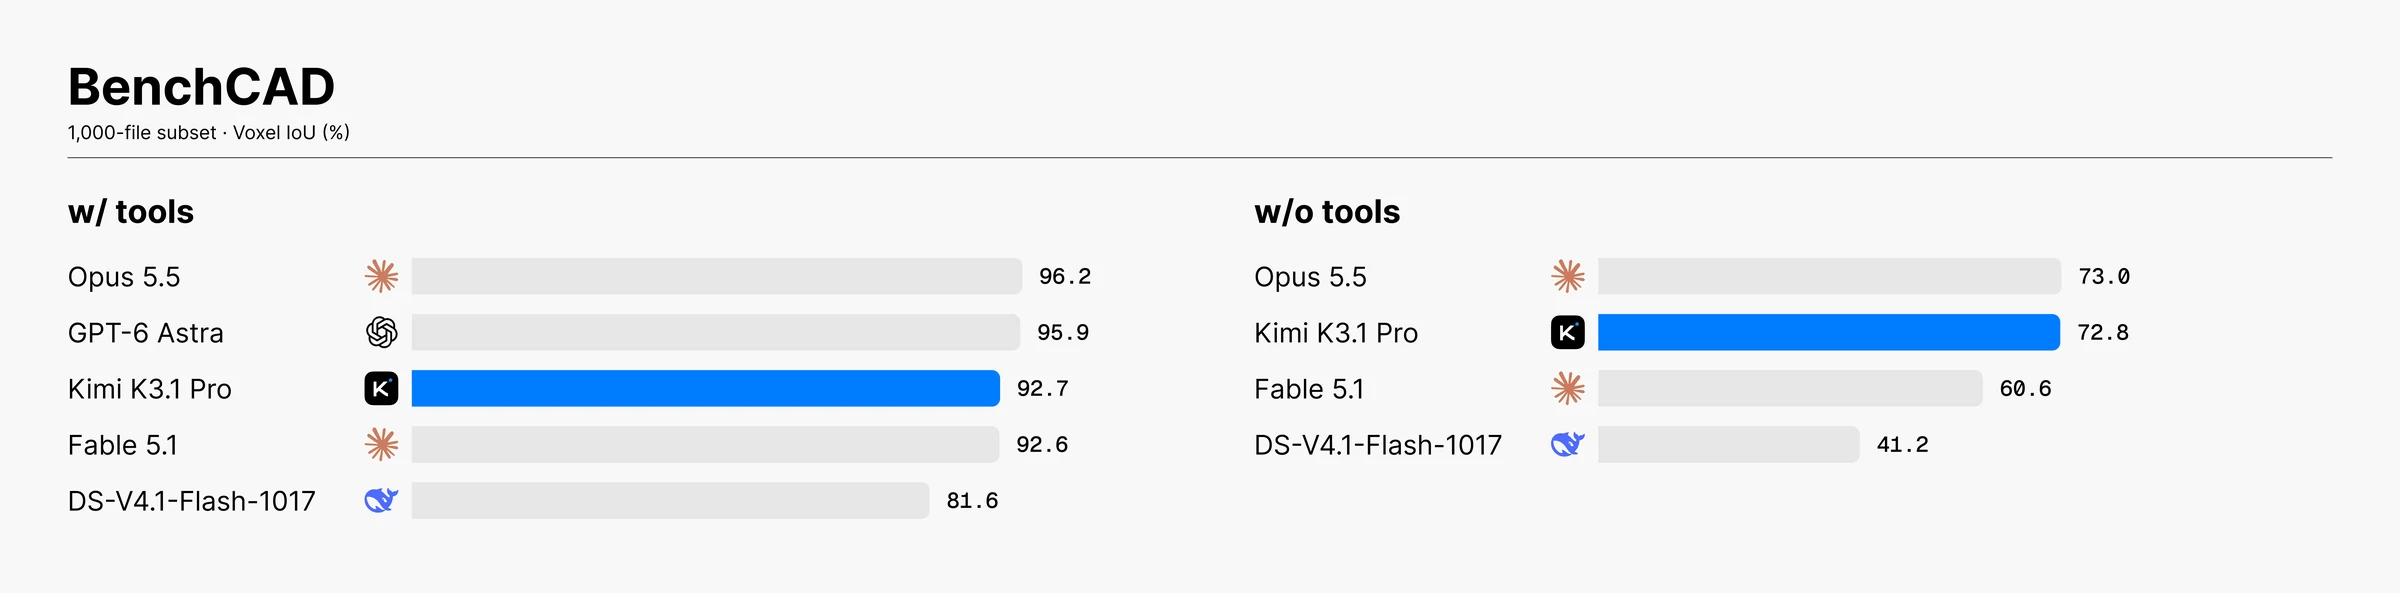
- Kimi K3.1 Pro renforce les workflows d’agent : Moonshot rapporte 65.7% sur Terminal-Bench 4.0 et 92.7% d’IoU voxel sur BenchCAD avec outils.
- Kimi K3.1 Pro Highspeed privilégie la vitesse de réponse : son débit de sortie annoncé est environ 2–3× supérieur à la version standard, avec les mêmes capacités de modèle.
- L’accès API à Kimi K3.1 Pro est disponible via CometAPI : les tarifs standard d’entrée et de sortie sont 20% inférieurs aux tarifs officiels publiés en USD ; la tarification Highspeed nécessite une vérification de compte séparée.
- L’accès hébergé à Kimi K3.1 Pro précède la publication complète des poids : Moonshot prévoit de publier les poids complets d’ici le 4 novembre 2026.
Qu’est-ce que Kimi K3.1 Pro exactement ?
Kimi K3.1 Pro est le modèle de langage de grande taille phare de Moonshot AI (月之暗面), basé à Pékin, publié le 23 octobre 2026. Ce n’est pas un tout nouveau modèle de base. Il s’agit d’une version fortement post-entraînée de l’ancien Kimi K3 (lancé en juillet 2026), utilisant une puissance de calcul de post-entraînement significativement plus importante, axée sur un apprentissage par renforcement conjoint sur des centaines de domaines en aval.
Moonshot le décrit comme « notre modèle open-weight de classe 3T le plus capable à ce jour ». Le modèle conserve la même architecture de base que K3 :
- 2,8 billions de paramètres au total
- 104 milliards de paramètres actifs par token (conception MoE éparse)
- Fenêtre de contexte native d’un million de tokens
- Support multimodal (entrée texte, images et vidéo)
- Raisonnement toujours activé (pas de mode sans réflexion)
Une variante compagnon, Kimi K3.1 Pro Highspeed, offre une vitesse d’inférence 2–3× supérieure à la version Pro standard pour un prix doublé, ce qui la rend adaptée aux applications plus interactives ou sensibles à la latence.
Les poids complets du modèle doivent être publiés d’ici le 4 novembre 2026, ce qui ferait de K3.1 Pro l’un des modèles open-weight les plus puissants disponibles.
Spécifications techniques de Kimi 3.1 Pro
| Spécification | Détails |
|---|---|
| Famille de modèles | Série Kimi K3.1 (premier modèle) |
| Base | Kimi K3 post-entraîné |
| Paramètres totaux | 2,8 billions |
| Paramètres actifs | 104 milliards (MoE) |
| Fenêtre de contexte | 1 048 576 tokens |
| Sortie maximale | Jusqu’à ~944K–1M tokens (configurable) |
| Modalités d’entrée | Texte, Image, Vidéo |
| Sortie | Texte |
| Raisonnement | Toujours activé (niveaux faible/élevé/max) |
| Appels d’outils | Pris en charge |
| Sortie structurée (JSON) | Pris en charge |
| IDs de modèles API | kimi-k3.1-pro, kimi-k3.1-pro-highspeed |
| Poids ouverts | D’ici le 4 novembre 2026 |
imi K3.1 Pro Benchmarks: Coding, CAD, and Finance
Le tableau suivant utilise les évaluations de publication de Moonshot. Il s’agit de résultats de benchmarks rapportés par le fournisseur, et non d’un test inter-fournisseurs reproduit indépendamment.
Les taux d’hallucinations ont chuté fortement : Moonshot indique que les fausses affirmations sont passées de 23.4% sur K3 à environ 8.3% (ou moins dans les tests internes). La modélisation et la recherche liées à la finance se sont également nettement améliorées.
| Benchmark | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | Note |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.7% | 66.4% | 58.2% | Agents de codage sur tâches terminal réalistes |
| BenchCAD, avec outils (Voxel IoU) | 92.7% | 96.2% | 95.9% | Reconstruction 3D / CAO |
| OfficeQA Pro v2 | 64.4 | 62.2 | 54.4 | Tâches documentaires et bureautiques |
| Frontier Finance | 58.6 | 56.7 | 45.0 | Finance |
| SWE-Marathon | 51.7% | 46.3% | 42.5% | Ingénierie logicielle à long horizon |
| Humanity’s Last Exam (avec outils) | 70.0% | 67.7% | 57.2% | Connaissances générales et raisonnement |
| Kimi Hallu Bench Hard, avec outils (plus bas est mieux) | 8.3% | 15.0% | 5.5% |
Les benchmarks de codage montrent des performances d’agent de niveau frontière
Sur Terminal-Bench 4.0, l’écart avec Claude Opus 5.5 est de 0,7 point de pourcentage ; l’avance sur GPT-6 Astra est de 7,5 points. Cela fait de K3.1 Pro un candidat pertinent pour les agents d’ingénierie basés sur terminal, mais la configuration de l’évaluation compte autant que le score principal.
Notez que certains tests indépendants d’agents de codage montrent des résultats plus mixtes selon le harnais exact et la longueur de session, K3.1 Pro produisant parfois des traces de raisonnement plus longues et plus verbeuses.
Kimi K3.1 Pro améliore la création 3D et la vision
BenchCAD mesure la qualité de reconstruction à partir de rendus multi-vues via du code CAO généré. Son score d’IoU voxel mesure le recouvrement géométrique, donc 92.7% ne doit pas être interprété comme un taux de réussite de 92.7% à la tâche. La comparaison « avec outils » de Moonshot utilise un sous-ensemble de 1 000 cas et place K3.1 Pro en dessous d’Opus 5.5 et GPT-6 Astra sur cette métrique.
Il montre également de grands gains par rapport à Kimi K3 sur les tâches vision-langage (par ex., +0.11 mAP50 sur le classement Ultralytics d’auto-annotation) et les examens d’analyse de données (42/43 questions réussies).
Quoi de neuf dans Kimi K3.1 Pro par rapport à Kimi K3 ?
La raison la plus claire d’envisager une mise à niveau est l’amélioration de l’exécution des travaux multi-étapes. Le tableau ci-dessous compare K3 et K3.1 Pro dans les évaluations rapportées par Moonshot.
| Évaluation | Kimi K3 | Kimi K3.1 Pro | Amélioration |
|---|---|---|---|
| Kimi Code Bench 3.0 Long-horizon | 55.95% | 61.2% | +5,25 points |
| Modélisation financière interne | 50.4 | 57.6 | +7,2 points |
| Recherche financière interne | 58.8 | 70.4 | +11,6 points |
| Opérations internes | 8.9 | 37.0 | ~4,2× de performance |
| Kimi Hallu Bench Hard avec outils, erreurs au niveau des assertions | 23.4% | 8.3% | ~64,5% de réduction |
Cependant, il s’agit de comparaisons de benchmarks individuels. Elles ne doivent pas être interprétées comme une amélioration universelle de 4,2× des performances des agents.
Kimi K3.1 Pro réduit les erreurs factuelles
Le graphique sépare les résultats sans outils de l’évaluation plus difficile avec outils ; le chiffre de 8.3% appartient à cette dernière.
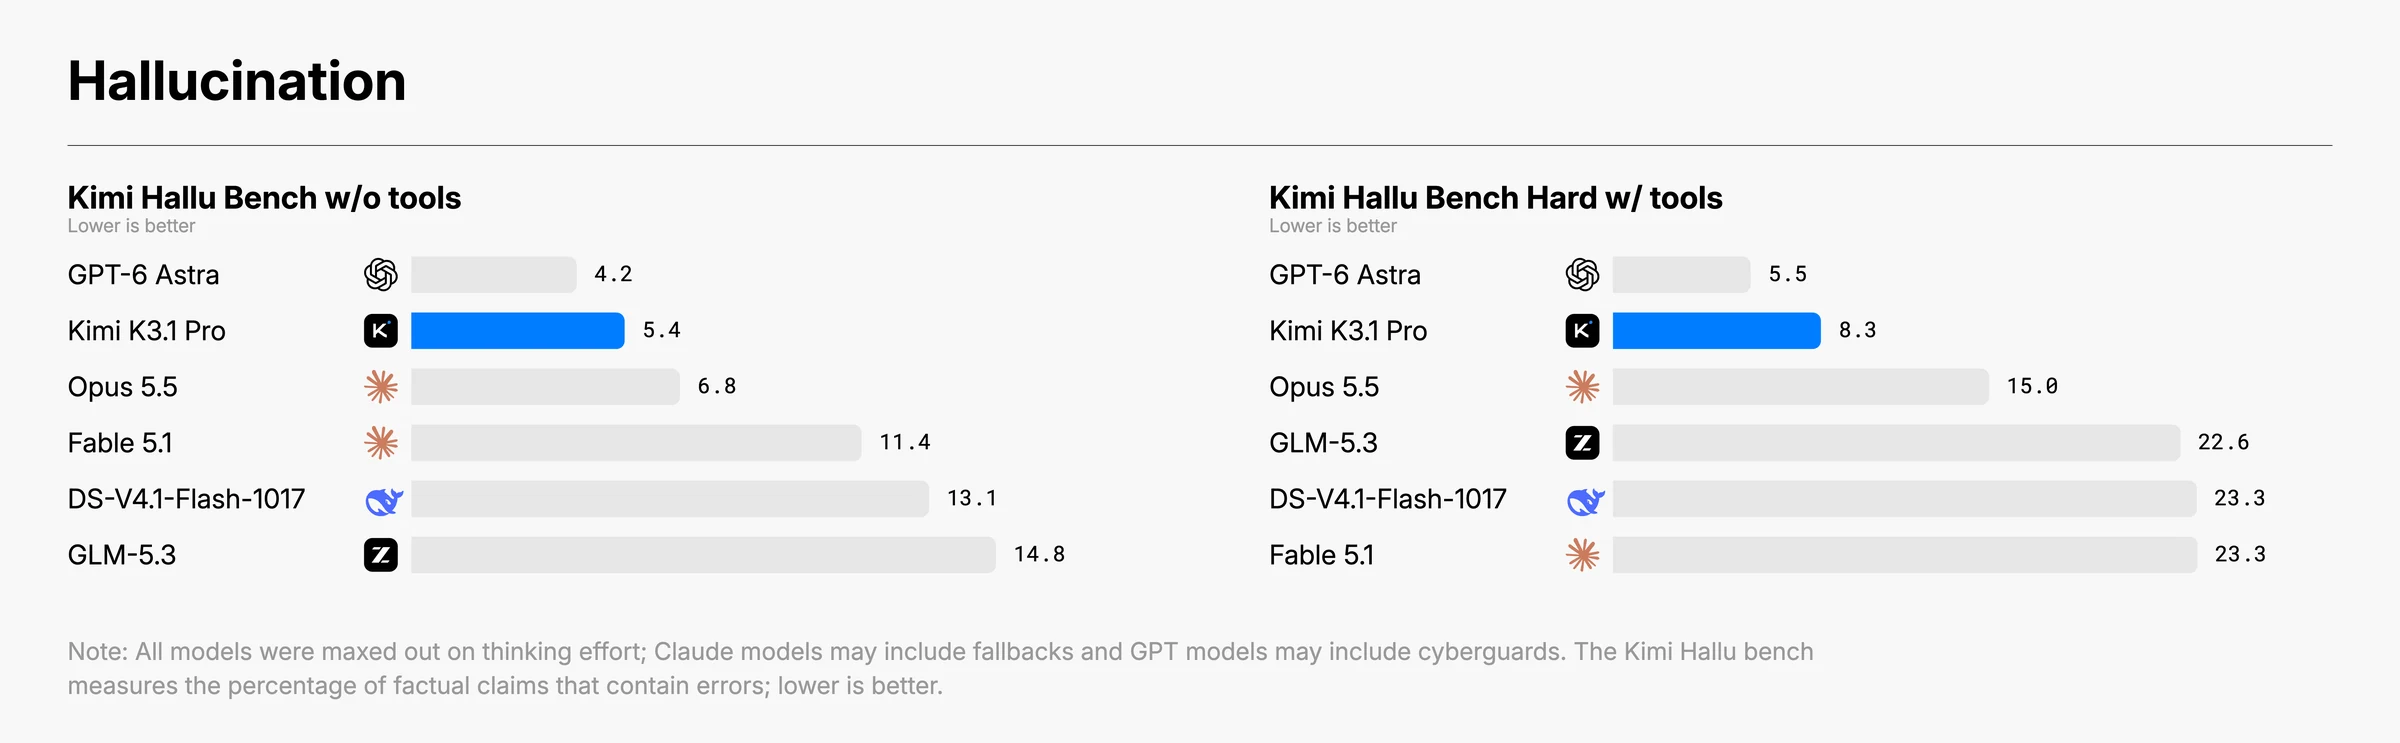
La distinction entre l’exactitude sur benchmark et la fiabilité en conditions réelles est importante. Cette évaluation utilise délibérément des invites difficiles susceptibles d’exposer des erreurs factuelles. Ses résultats ne représentent pas le taux moyen d’hallucination du modèle dans les conversations quotidiennes.
Kimi K3.1 Pro introduit un compromis délibéré en cybersécurité
Moonshot AI a retiré certaines données d’entraînement et tâches d’apprentissage par renforcement liées à la cyber pour réduire les capacités offensives en cybersécurité tout en préservant les performances de codage à usage général.
Dans l’évaluation interne xdev-bench-hard à pass@3 de Moonshot, le checkpoint non restreint a obtenu 90.5% et le modèle de publication 81.0%. Cette différence reflète un choix d’entraînement délibéré, pas une garantie que le modèle publié ne peut pas être mal utilisé. Voir l’évaluation officielle en cybersécurité pour ses conditions et limites.
Kimi K3.1 Pro vs Highspeed : quelle version choisir ?
| Facteur de décision | Kimi K3.1 Pro | Kimi K3.1 Pro Highspeed |
|---|---|---|
| Capacités du modèle | Capacités phares standard | Mêmes capacités annoncées |
| Vitesse de sortie | Référence | Environ 2–3× plus rapide |
| Meilleure charge initiale | Analyse par lots, longs rapports, tâches en arrière-plan | Assistants de codage et de recherche interactifs |
| ID du modèle CometAPI | kimi-k3.1-pro | kimi-k3.1-pro-highspeed |
Utilisez la version standard lorsque le coût compte plus que la sortie immédiate. Choisissez Highspeed lorsque des utilisateurs attendent la génération, puis mesurez l’effet sur les tâches complètes plutôt que de supposer que la vitesse de sortie se traduit directement par le même gain de temps global.
Par exemple, si un agent de codage passe la plupart de son temps à exécuter des tests, installer des dépendances ou attendre des outils externes, accélérer la sortie du modèle peut produire une amélioration de bout en bout relativement faible.
Accédez aux deux versions de Kimi K3.1 Pro via CometAPI
CometAPI fournit l’accès à Kimi K3.1 Pro et Kimi K3.1 Pro Highspeed via son endpoint Chat Completions compatible OpenAI. L’intégration reste la même lorsque vous changez de version ; modifiez l’ID du modèle pour sélectionner la variante.
- Créez une clé API dans votre compte CometAPI et mettez-la à disposition de votre application sous la variable d’environnement COMETAPI_API_KEY.
- Installez le SDK Python OpenAI, puis définissez l’URL de base du client sur
https://api.cometapi.com/v1. - Utilisez kimi-k3.1-pro pour le modèle standard ou kimi-k3.1-pro-highspeed pour Highspeed.
python -m pip install --upgrade openaiimport osfrom openai import OpenAIclient = OpenAI( api_key=os.environ["COMETAPI_API_KEY"], base_url="https://api.cometapi.com/v1",)response = client.chat.completions.create( model="kimi-k3.1-pro", # Or "kimi-k3.1-pro-highspeed" messages=[ { "role": "user", "content": "Suggest three tests for a CSV import feature.", } ],)print(response.choices[0].message.content)
L’exemple shell suivant appelle directement Highspeed. Il utilise la même variable d’environnement COMETAPI_API_KEY.
Tarification API de Kimi K3.1 Pro : tarifs officiels vs CometAPI
Le tableau compare les tarifs publiés en USD par million de tokens pour l’entrée non mise en cache et la sortie générée, vérifiés le 24 octobre 2026. Les tarifs standard de K3.1 Pro via CometAPI sont 20% inférieurs aux tarifs officiels. Vérifiez les tarifs Highspeed actuels de votre compte avant de choisir cette version.
| Modèle | Entrée officielle | Sortie officielle | Entrée CometAPI | Sortie CometAPI |
|---|---|---|---|---|
| Kimi K3.1 Pro | 2,00 $ | 10,00 $ | 1,60 $ | 8,00 $ |
| Kimi K3.1 Pro Highspeed | 4,00 $ | 20,00 $ | Vérifiez les tarifs de votre compte | Vérifiez les tarifs de votre compte |
La remise de la version standard ne doit pas être supposée s’appliquer à Highspeed. Les lectures et écritures de cache, les frais d’outils, les taxes et les réessais sont hors de cette comparaison.
Aux tarifs API officiels, K3.1 Pro est environ 33,3% moins chère que K3 pour les tokens d’entrée et de sortie non mis en cache.
Pour les requêtes sans mise en cache ni services facturables supplémentaires, le coût est :
Coût = (Tokens d’entrée × Tarif d’entrée + Tokens de sortie × Tarif de sortie) / 1 000 000
Par exemple, traiter 100 000 tokens d’entrée non mis en cache et générer 10 000 tokens de sortie coûte environ 0,24 $ via l’API standard K3.1 Pro de CometAPI, contre 0,30 $ au tarif du fournisseur officiel.
Estimez les dépenses de production à partir des tâches réussies, y compris tout réessai ou utilisation de jetons de raisonnement affichés dans vos relevés de facturation. Un tarif de token inférieur ne garantit pas un coût total plus faible si un workflow produit plus de tokens ou nécessite des tentatives supplémentaires.
Mettez Kimi K3.1 Pro au travail : quatre points de départ pratiques
Choisissez un petit workflow avec une sortie que vous pouvez inspecter.
| Workflow | Un premier projet pratique | Contrôles d’acceptation |
|---|---|---|
| Ingénierie logicielle | Corriger un bug reproductible dans un dépôt et ajouter un test de régression. | Les tests pertinents passent ; le correctif traite le problème sans changements non liés. |
| CAO et création 3D | Générer une pièce paramétrique à partir d’un brief dimensionné. | Vérifier les dimensions, la validité géométrique, l’éditabilité et la compatibilité d’export. |
| Recherche financière | Rapprocher des chiffres sélectionnés entre des rapports annuels et un classeur. | Vérifier chaque chiffre par rapport à sa source et contrôler les formules indépendamment. |
| Recherche long contexte | Comparer des exigences à travers une collection de documents techniques. | Vérifier les emplacements des preuves, les versions des documents et la couverture des déclarations contradictoires. |
Pour l’évaluation, le succès des tâches complétées est plus informatif que le nombre de lignes de code générées.
Quelles sont les limites de Kimi K3.1 Pro ?
- Le raisonnement reste activé. K3.1 Pro prend en charge des efforts de raisonnement faibles, élevés et max, le max étant la valeur par défaut documentée. Ne supposez pas qu’un mode sans raisonnement est disponible.
- Les longues entrées ont des coûts opérationnels. Une grande fenêtre de contexte peut augmenter le temps de traitement d’entrée et la consommation de tokens. Sélectionnez le matériel pertinent et évaluez la mise en cache plutôt que d’envoyer par défaut une archive entière.
- Une réponse API n’achève pas un workflow externe. Votre application fournit l’exécution des outils, l’état sauvegardé et la validation de sortie ; un résultat de benchmark avec outils ne signifie pas que ces capacités sont fournies avec un simple appel API.
- L’accès hébergé et les poids téléchargeables sont des jalons différents. Au 24 octobre, la publication complète des poids de K3.1 Pro reste prévue pour le 4 novembre 2026 ; examinez la publication et la licence avant de planifier un auto-hébergement.
Le comportement de l’API est décrit dans le guide Kimi API ; la disponibilité des poids est couverte par l’annonce de publication.
Conclusion
Kimi K3.1 Pro mérite une évaluation lorsque votre application dépend de codage multi-étapes, de recherche documentaire ou de travail assisté par outils. Ses gains rapportés par rapport à K3 et ses tarifs API standard plus bas créent une raison pratique de tester la mise à niveau. Commencez par le modèle standard, mesurez la qualité et le coût des tâches acceptées, et choisissez Highspeed lorsque la génération plus rapide améliore sensiblement l’expérience utilisateur. Utilisez le modèle CometAPI pour vérifier l’accès et la tarification actuelle avant d’intégrer les exemples ci-dessus.