
TL;DR
MiniMax H3 Max n’est pas un tout nouveau modèle de fondation destiné à remplacer MiniMax H3. Il s’agit d’une variante post-entraînée de MiniMax H3 créée par fal Research, utilisant les poids ouverts de H3 et un post‑entraînement supplémentaire axé sur le respect des consignes, l’esthétique visuelle et l’efficacité d’inférence.
Cette distinction explique la plupart des différences entre les deux modèles. MiniMax H3 Max est optimisé pour une inférence de production rapide et un meilleur respect des consignes, tandis que MiniMax H3 reste le système omni‑modal plus large, incluant un conditionnement multimodal plus riche, des poids ouverts H3‑Base, des workflows d’édition vidéo et une sortie jusqu’en 2K via H3‑Regenerate‑2K.
Au 18 septembre 2026, des données de préférence indépendantes indiquent H3 Max à 1227 Elo en texte‑vers‑vidéo avec audio contre 1220 pour H3, et 1195 Elo en image‑vers‑vidéo avec audio contre 1181 pour H3. Les écarts sont suffisamment significatifs pour être suivis, mais pas assez grands pour impliquer une différence de qualité spectaculaire sur chaque consigne.
Key Takeaways
- H3 Max est une variante post‑entraînée de H3, pas H4 ni une architecture H3 plus grande. fal est parti des poids ouverts de MiniMax H3 et a optimisé le modèle et la pile de service ensemble.
- La vitesse est le différenciateur le plus clair de H3 Max. fal annonce environ trois secondes ou moins pour une génération de cinq secondes en 768p sur son infrastructure optimisée.
- H3 Max devance actuellement H3 dans les deux tests de préférence indépendants directement comparables utilisés ici. La dernière capture montre +7 Elo en texte‑vers‑vidéo avec audio et +14 Elo en image‑vers‑vidéo avec audio.
- MiniMax H3 demeure le workflow de modèle de fondation plus large. Il prend en charge des références multimodales plus riches, l’édition, des poids ouverts H3‑Base et la régénération en 2K.
- La résolution est une distinction importante. H3 Max expose la génération 480p/768p plus un affinement latent en 1080p, tandis que H3 peut atteindre 2K via H3‑Regenerate‑2K.
What Is MiniMax H3 Max?
MiniMax H3 Max est un modèle de génération vidéo IA développé par fal Research via post‑entraînement des poids ouverts de MiniMax H3. Plutôt que de remplacer l’architecture H3 sous‑jacente par un tout nouveau modèle de fondation, fal s’est concentré sur le respect des consignes, l’esthétique et le débit d’inférence.
Le mot « Max » peut donc être trompeur s’il est interprété comme un palier conventionnel à plus grand nombre de paramètres. Les documents publics n’établissent pas un Transformer plus grand ni une nouvelle échelle de paramètres pour H3 Max. La différenciation vient principalement du post‑entraînement et d’une pile de service conçue autour du modèle modifié.
fal décrit également de nouvelles données de post‑entraînement substantielles et des boucles d’évaluation centrées sur la qualité visible par l’utilisateur. En pratique, H3 Max s’entend mieux comme une variante de H3 optimisée pour la production plutôt qu’un successeur entièrement repensé.
MiniMax H3 Max specifications at glance
| Specification | MiniMax H3 Max |
|---|---|
| Base model | MiniMax H3 |
| Post-training developer | fal Research |
| Model category | Génération audio‑vidéo |
| Text-to-video | Oui |
| Image-to-video | Oui |
| First/last-frame control | Oui |
| Reference-to-video | Oui |
| Output duration | 5–15 secondes |
| Native generation resolution | 480p / 768p |
| 1080p option | Affinement latent depuis 768p natif |
| Frame rate | 24 i/s |
| Audio | Audio stéréo synchronisé |
| Aspect ratios | 21:9, 16:9, 4:3, 1:1, 3:4, 9:16 |
| Primary optimization | Respect des consignes, esthétique, débit |
| CometAPI model ID | minimax-h3-max |
Le schéma API actuel de fal décrit l’option 1080p comme un affinement latent à partir d’une source 768p native, ce qui est important lorsqu’on compare H3 Max à des systèmes qui régénèrent réellement à une résolution supérieure.
How Does MiniMax H3 Max Work?
Comprendre H3 Max commence par la fondation H3 qui le sous‑tend. MiniMax décrit H3 comme un système génératif omni‑modal plutôt qu’un ensemble de modèles isolés de texte‑vers‑vidéo, image‑vers‑vidéo, audio et édition.
Le workflow H3 complet s’organise autour de H3‑Context‑IR, H3‑Base et H3‑Regenerate‑2K. H3‑Context‑IR interprète des instructions multimodales libres, H3‑Base effectue la génération audiovisuelle de base en 768p, et H3‑Regenerate‑2K réutilise le contexte original plus le résultat en plus basse résolution pour régénérer une sortie en plus haute résolution.
The H3 foundation beneath H3 Max
MiniMax documente H3‑Omni‑Transformer comme un Transformer dense monoflux de 33 milliards de paramètres, avec environ 13B de paramètres dans des branches liées à AdaLN. Le H3‑Encoder utilise des poids préentraînés Qwen3‑VL‑32B, tandis que des VAE visuels et audio distincts encodent leurs modalités respectives avant la génération conjointe.
Le H3‑Omni‑Transformer prédit conjointement les latents vidéo et audio plutôt que de traiter le son comme une étape de post‑traitement séparée. Cette architecture explique pourquoi H3 et H3 Max peuvent produire une sortie audiovisuelle synchronisée.
Architecture officielle du modèle MiniMax H3
What fal changed for H3 Max
fal a post‑entraîné H3 avec des données supplémentaires ciblant la fidélité aux instructions et la qualité visuelle, puis a développé le système d’inférence en même temps que le modèle plutôt que d’optimiser le service après la fin de l’entraînement. L’article de lancement décrit cette co‑conception modèle‑et‑inférence comme la raison principale pour laquelle H3 Max peut déplacer le compromis qualité‑vitesse.
C’est important, car simplement réduire les étapes d’échantillonnage ou la précision peut abaisser la latence tout en dégradant la qualité de sortie. fal indique que les optimisations candidates n’ont été conservées que lorsque les checkpoints résultants résistaient encore dans ses évaluations de préférence.
MiniMax H3 fournit la fondation de génération multimodale ; H3 Max modifie l’endroit où cette fondation se place sur la courbe qualité‑vitesse‑coût.
What Are the Main Features of MiniMax H3 Max?
Stronger prompt adherence
Le respect des consignes a été une cible directe du post‑entraînement. Cela compte pour des consignes structurées combinant plusieurs actions, transitions de scènes, directions de caméra, contraintes temporelles et instructions de style.
Faster-than-video-duration generation
H3 Max est conçu pour une latence de génération inhabituellement faible. fal signale des clips de cinq secondes en 768p en environ trois secondes ou moins sur son infrastructure optimisée, permettant des boucles créatives itératives bien plus serrées.
Native synchronized audio
H3 Max conserve l’approche de génération audio‑vidéo conjointe de H3, de sorte que dialogues, ambiances, effets sonores et mouvement peuvent être produits dans un workflow audiovisuel coordonné.
Multiple generation workflows
La famille H3 Max prend en charge texte‑vers‑vidéo, image‑vers‑vidéo, génération première‑vers‑dernière image et workflows référence‑vers‑vidéo.
Built-in prompt expansion
L’endpoint texte‑vers‑vidéo expose des modes d’expansion de consigne tels que désactivé, équilibré et qualité, permettant aux développeurs d’échanger du temps de prétraitement contre une interprétation de consigne plus riche.
How Does MiniMax H3 Max Perform ?
Benchmarks of MiniMax H3 Max
Les benchmarks opérateur sont utiles pour montrer ce que le post‑entraînement a ciblé, mais des tests de préférence tiers mis à jour en continu sont plus utiles pour comparer H3 Max à H3 original selon la même méthodologie d’arène.
| Benchmark snapshot — Sep. 18, 2026 | MiniMax H3 Max | MiniMax H3 | Difference |
|---|---|---|---|
| Text-to-Video with Audio Elo | 1227 ±9 | 1220 ±8 | +7 |
| Text-to-Video samples | 5,689 | 8,602 | — |
| Image-to-Video with Audio Elo | 1195 ±10 | 1181 ±8 | +14 |
| Image-to-Video samples | 5,569 | 6,949 | — |
| Video Editing with Audio Elo | Non classé dans cette comparaison | 1132 ±6 | — |
Note méthodologique des benchmarks. Les chiffres d’Artificial Analysis sont des instantanés datés d’Elo de préférence humaine à l’aveugle ; cet article rapporte le score, l’intervalle de confiance à 95 %, le nombre d’échantillons, la catégorie et la date de l’instantané. Le résultat n° 1 de fal est mené par le fournisseur sur l’infrastructure de fal, et son graphique de comparaison public ne divulgue pas toutes les consignes, matériels ou paramètres de service requis pour une reproduction indépendante.
L’instantané actuel soutient une conclusion étroite : H3 Max a le score de préférence mesuré le plus élevé dans les deux catégories de génération audio‑vidéo directement comparables. Les intervalles de confiance se chevauchent, donc l’écart ne doit pas être présenté comme un avantage de qualité universel ou spectaculaire.
fal’s own H3 Max evaluation
fal rapporte que H3 Max s’est classé premier sur la préférence globale, la compréhension des consignes et l’esthétique dans son évaluation en confrontation directe contre douze modèles vidéo. Il s’agit de preuves menées par le fournisseur ; elles doivent donc être lues aux côtés des données d’arène indépendantes plutôt que comme un substitut.
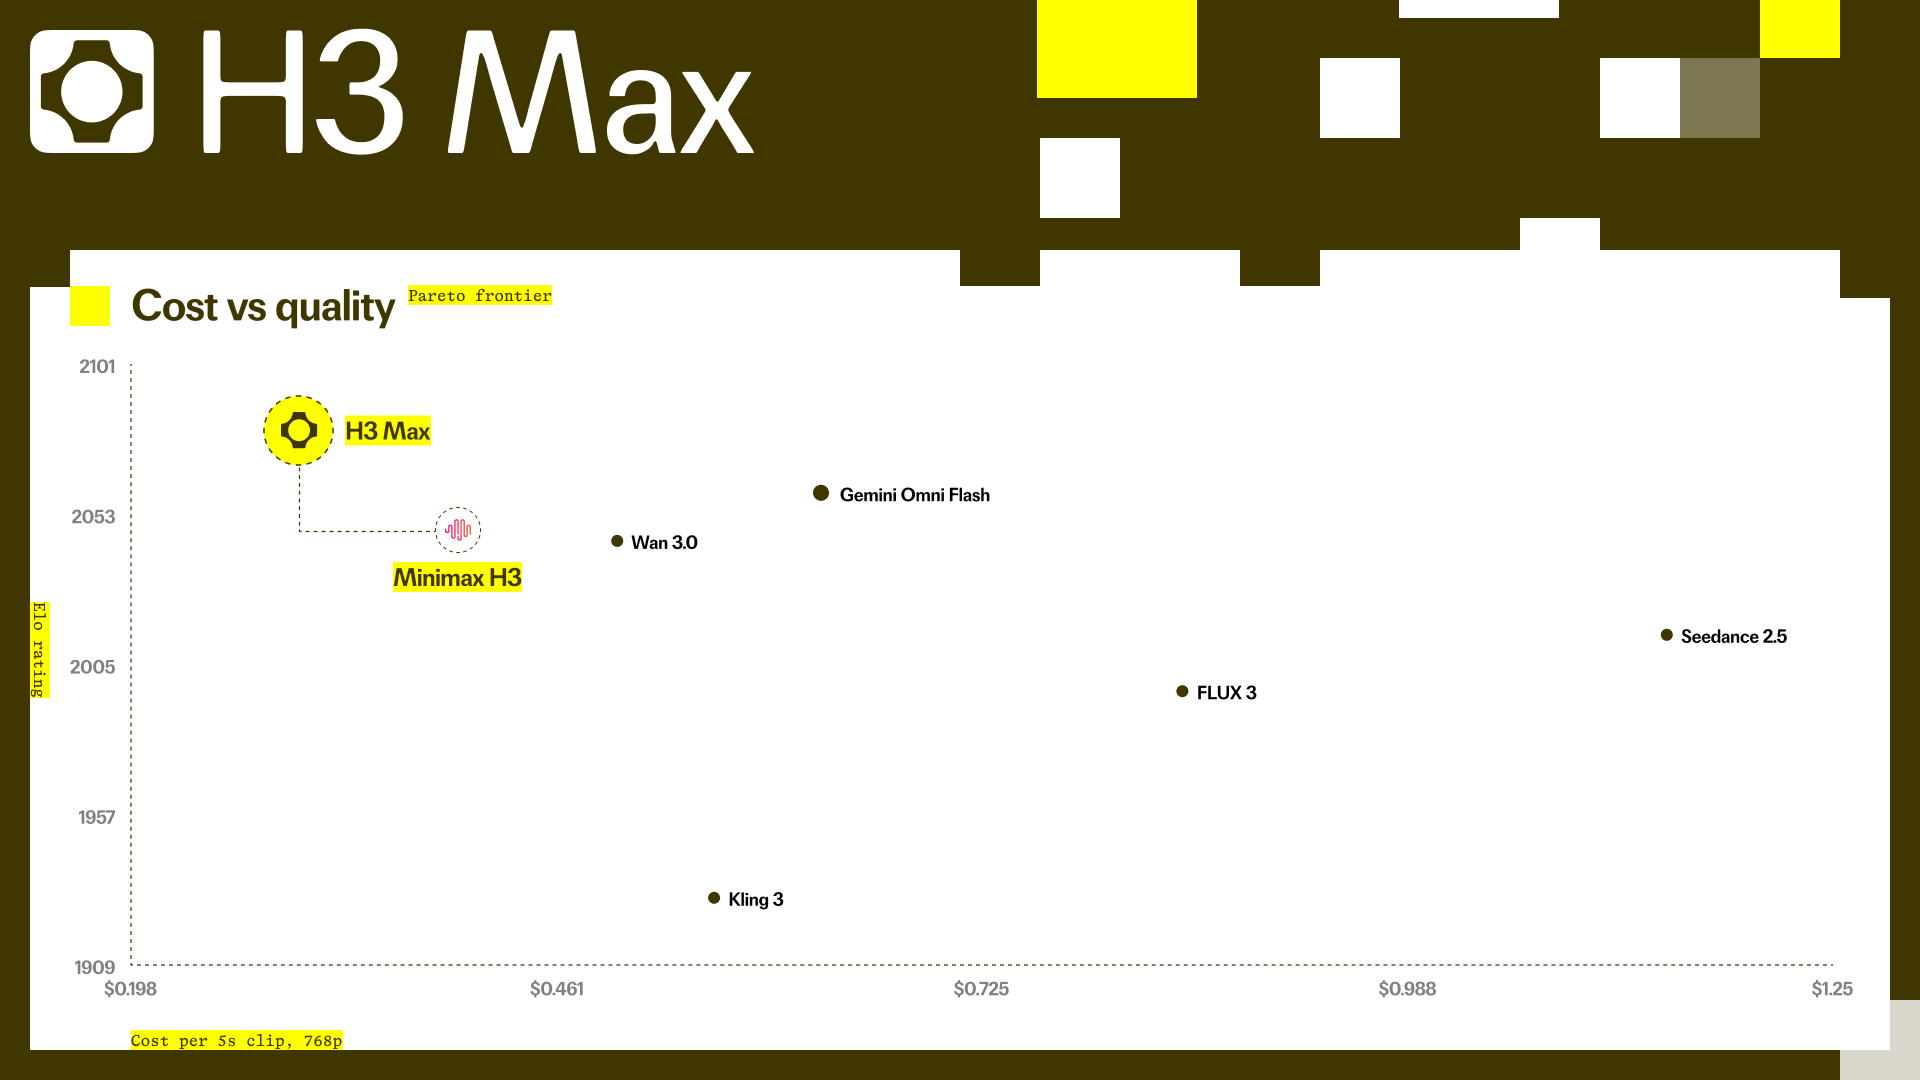
Graphique officiel fal coût‑vs‑qualité H3 Max
L’interprétation la plus utile n’est pas « H3 Max gagne universellement ». C’est que H3 Max améliore de façon matérielle le point d’exploitation vitesse‑qualité de H3 tandis que l’écart de score de préférence indépendant sur H3 reste relativement modeste.
Speed, Quality, and the Trade-off
fal indique que H3 Max génère une vidéo de cinq secondes en 768p en moins de trois secondes sur son infrastructure optimisée — environ 35× le débit de l’endpoint MiniMax H3 officiel dans la comparaison de fal. Traitez ceci comme une preuve d’inférence propre au fournisseur : la mise en file d’attente, le transfert réseau, les contrôles de sécurité et un backend différent peuvent augmenter la latence de bout en bout.
L’avantage de qualité est plus modeste que l’avantage de vitesse. Dans l’instantané indépendant du 18 septembre utilisé ici, H3 Max devançait H3 de 7 Elo pour texte‑vers‑vidéo avec audio et de 14 Elo pour image‑vers‑vidéo avec audio, mais les intervalles de confiance se chevauchent. La conclusion défendable est que H3 Max déplace la frontière vitesse‑qualité ; il ne garantit pas un résultat visiblement meilleur pour chaque consigne.
Choix pratique : utilisez H3 Max pour l’itération rapide, la production à haut débit et les consignes où le respect est important. Préférez H3 standard lorsque le workflow dépend du système multimodal plus large, de l’édition vidéo, du déploiement en poids ouverts ou du chemin H3‑Regenerate‑2K.
How Much Do MiniMax H3 Max Cost?
La tarification a besoin de contexte, car les tarifs des fournisseurs et les promotions peuvent changer indépendamment. L’instantané suivant reflète des tarifs affichés publiquement vérifiés au 18 septembre 2026.
| Pricing source | H3 Max | H3 |
|---|---|---|
| fal 480p | $0.025/sec promotionnel | — |
| fal 768p | $0.04/sec promotionnel | — |
| fal 1080p refinement | $0.08/sec promotionnel | — |
| MiniMax officiel 768p | — | $0.08/sec |
| MiniMax officiel 2K | — | $0.13/sec |
| MiniMax 768p → 2K regeneration | — | $0.05/sec |
| CometAPI starting price | $0.064/sec | $0.064/sec |
fal qualifie actuellement ses tarifs H3 Max de tarification promotionnelle de lancement et indique que la remise se termine le 30 septembre 2026. L’API MiniMax H3 Max dans CometAPI affiche actuellement $0.064 par seconde, tandis que l’API MiniMax H3 dans CometAPI commence également à $0.064 par seconde. La tarification des fournisseurs doit être revérifiée avant de prévoir une grande charge de production.
How to try MiniMax H3 Max
L’API MiniMax H3 Max dans CometAPI est actuellement disponible avec l’ID de modèle minimax‑h3‑max, un endpoint de production sous /v1/videos, une gestion asynchrone des tâches et un prix de départ affiché de $0.064 par seconde.
- Créez une clé API. Connectez‑vous à CometAPI, créez un jeton et stockez‑le en toute sécurité sous
COMETAPI_KEY. - Soumettez une tâche de génération. Envoyez une requête
POSTàhttps://api.cometapi.com/v1/videosavec le modèleminimax-h3-max, une consigne, une durée et une taille de sortie. Ajoutez une URL d’image lors de l’utilisation d’image‑vers‑vidéo. - Sondez la tâche asynchrone. Lisez l’ID de tâche renvoyé et demandez
GET /v1/videos/{task_id}jusqu’à ce que le statut deviennecompletedoufailed. Utilisez un intervalle de sondage au lieu d’envoyer des requêtes continues. - Téléchargez et examinez. Récupérez
GET /v1/videos/{task_id}/content, enregistrez le MP4, et inspectez le respect des consignes, le mouvement, la synchronisation audio et les artefacts visuels avant d’augmenter la charge.
Pour une comparaison équitable H3 Max versus H3, gardez la consigne, la durée, le format d’image, la résolution, les entrées de référence, les paramètres audio et la politique de reprise identiques. Confirmez le schéma en ligne et le prix sur la page du modèle avant la production, car le routage et les paramètres exposés peuvent changer indépendamment du modèle sous‑jacent.
Limitations of MiniMax H3 Max
Premièrement, H3 Max ne remplace pas le workflow de régénération 2K de H3. Son option 1080p actuellement documentée est un affinement d’une sortie 768p native plutôt que la même voie de régénération en contexte 2K utilisée par H3.
Deuxièmement, la latence phare de H3 Max est étroitement liée à la pile d’inférence optimisée de fal ; on ne doit donc pas supposer la même vitesse en temps réel sur un autre backend.
Troisièmement, l’avantage de qualité indépendant sur H3 est actuellement modeste. L’instantané de benchmark du 18 septembre montre +7 Elo en texte‑vers‑vidéo avec audio et +14 Elo en image‑vers‑vidéo avec audio, avec des intervalles de confiance qui se chevauchent.
Enfin, H3 reste le système plus large si « mieux » signifie l’édition vidéo, la profondeur des références multimodales, le déploiement en poids ouverts ou la résolution de sortie maximale plutôt que le débit brut de génération.
Conclusion
MiniMax H3 Max s’entend mieux comme une variante H3 optimisée pour la production, pas comme un successeur plus grand. Le post‑entraînement de fal et la co‑conception de l’inférence créent un point d’exploitation convaincant pour la génération audiovisuelle rapide de formats courts, tandis que l’avantage de préférence indépendant sur H3 standard reste modeste plutôt qu’universel.
Choisissez H3 Max lorsque la vitesse d’itération, le débit et le respect des consignes sont les principales contraintes. Choisissez H3 standard lorsque vous avez besoin du workflow multimodal plus large, de l’édition vidéo, des poids ouverts H3‑Base ou de la régénération 2K. Avant de vous engager dans l’une ou l’autre voie, exécutez un benchmark contrôlé avec des consignes et des paramètres identiques et calculez le coût par clip accepté — pas seulement le coût par seconde générée.
FAQ
Comment les équipes doivent‑elles interpréter l’avance de benchmark de H3 Max lorsque les intervalles de confiance se chevauchent ?
Traitez l’avance comme une preuve directionnelle, pas comme la preuve que H3 Max gagne chaque consigne. Dans l’instantané cité, H3 Max devance H3 de 7 Elo en texte‑vers‑vidéo avec audio et de 14 Elo en image‑vers‑vidéo avec audio, mais les intervalles de confiance se chevauchent. Les équipes doivent donc tester un ensemble de consignes représentatif, rapporter le taux de victoire et les modes d’échec, et éviter de transformer un avantage agrégé modeste en une affirmation de qualité universelle.
Comment les équipes doivent‑elles comparer le véritable coût de production de H3 Max et H3 au‑delà du prix listé par seconde ?
Calculez le coût par clip accepté plutôt que le coût par seconde générée. Incluez les reprises, les sorties rejetées, l’affinement 1080p ou la régénération 2K, le stockage et le transfert, le temps de revue et toute édition en aval. H3 Max peut réduire le coût d’itération grâce à une génération plus rapide et un meilleur respect des consignes, tandis que H3 peut être plus économique lorsque ses capacités d’édition, de contrôles multimodaux ou de workflow 2K évitent des outils et des retouches supplémentaires.
Quelle vitesse de génération les équipes peuvent‑elles raisonnablement attendre, et quels facteurs affectent la latence de bout en bout ?
fal signale moins de trois secondes d’inférence pour un clip de cinq secondes en 768p sur son infrastructure optimisée. Ce n’est pas une garantie universelle de bout en bout : le temps de file d’attente, les mises en ligne d’entrées, l’expansion de consigne, le traitement de sécurité, la résolution, la durée et le routage fournisseur affectent tous la latence observée. Évaluez l’exact endpoint et la configuration que vous prévoyez de déployer.
Quel workflow H3 Max faut‑il utiliser pour des tâches textuelles uniquement, conditionnées par image, contrôlées par images clés ou pilotées par références ?
Utilisez texte‑vers‑vidéo lorsque la scène peut être définie entièrement en langage ; utilisez image‑vers‑vidéo lorsque l’identité, la composition ou le style visuel doivent partir d’une image fournie. Choisissez le contrôle première‑vers‑dernière image lorsque les états d’ouverture et de fermeture sont tous deux importants, et référence‑vers‑vidéo lorsque la cohérence avec plusieurs références visuelles compte. Le bon workflow réduit l’ambiguïté des consignes et doit être fixé avant de comparer H3 Max à H3.
Comment les équipes doivent‑elles choisir entre 480p, 768p, l’affinement 1080p de H3 Max et la régénération 2K de H3 ?
Utilisez 480p pour des brouillons peu coûteux et un filtrage de concepts à grand volume, puis passez à 768p pour l’évaluation normale et de nombreux rendus web. Choisissez l’affinement 1080p de H3 Max lorsque la production rapide reste prioritaire mais que le format de diffusion nécessite plus de pixels. Choisissez la régénération 2K de H3 lorsque le détail maximal et le workflow H3 plus large justifient une latence et un coût plus élevés ; comparez les artefacts finaux à la taille d’affichage réelle plutôt que de sélectionner uniquement selon l’étiquette de résolution.
En quoi la régénération 2K de MiniMax H3 diffère‑t‑elle de l’affinement 1080p de H3 Max ?
Oui. MiniMax H3 standard peut atteindre 2K via H3‑Regenerate‑2K. Il s’agit d’une étape de régénération en contexte qui réutilise à la fois les instructions multimodales originales et le résultat en 768p, lui permettant de reconstruire des détails plutôt que d’appliquer une sur‑résolution conventionnelle. Ce workflow plus large est une raison de préférer H3 à H3 Max pour la résolution maximale.
Quelles parties de MiniMax H3 sont en poids ouverts, et quelles parties nécessitent encore des API hébergées ?
Partiellement. MiniMax a publié les checkpoints H3‑Base FL2VA et Ref2VA sous la H3 Community License, permettant une validation locale de la génération 768p de base. Le système de production complet n’est pas entièrement ouvert : H3‑Context‑IR et H3‑Regenerate‑2K restent des composants hébergés, donc reproduire l’intégralité du workflow officiel 2K nécessite les API MiniMax.
Quand un produit d’API doit‑il choisir H3 Max au lieu de H3 standard ?
Souvent, lorsque l’application valorise une faible latence, une itération créative rapide et un débit de production. Ce n’est pas automatiquement le meilleur choix d’API : H3 standard est préférable pour la régénération 2K, le conditionnement multimodal plus large, l’édition vidéo ou le déploiement en poids ouverts. Exécutez un test d’acceptation et comparez le coût par sortie utilisable avant de choisir.
Que doit mesurer une suite d’évaluation de production avant de passer de H3 à H3 Max ?
Mesurez le respect des consignes, la cohérence du mouvement, les artefacts visuels, la qualité et la synchronisation audio, la cohérence d’identité et le taux d’acceptation des réviseurs. Ajoutez des métriques opérationnelles telles que le taux d’échec des tâches, le taux de reprises, la latence de bout en bout p50 et p95, et le coût par clip accepté. Segmentez les résultats par texte‑vers‑vidéo, image‑vers‑vidéo, durée, résolution, format d’image et complexité de consigne afin qu’une forte moyenne ne masque pas un scénario critique de production faible.