
TL;DR
Muse Ember est le plus petit modèle de raisonnement multimodal de Meta, conçu pour des tâches d’agent à grand volume telles que le routage, l’extraction, les appels d’outils et le codage ciblé. Meta a présenté Muse Ember le 9 novembre 2026.
Sa fenêtre de contexte de 1 048 576 jetons peut accueillir une quantité substantielle de matière source. Meta propose un accès via Model API et Muse Code ; CometAPI répertorie muse-ember, avec l’état d’activation détaillé ci-dessous. Commencez par une tâche répétitive dont vous pouvez vérifier la sortie, puis comparez le coût par résultat réussi, en incluant le raisonnement, les outils et les réessais.
Points clés
- Rôle : Muse Ember est conçu pour l’exécution répétée d’agents, y compris la classification, l’extraction, les appels d’outils et des tâches de codage bornées.
- Entrées et capacité : Muse Ember accepte le texte, les images, l’audio et la vidéo, avec une fenêtre de contexte de 1 M de jetons et jusqu’à 512 K jetons de sortie.
- Performances : Les résultats de Meta favorisent Muse Ember sur plusieurs benchmarks d’agents, tandis que des tests d’analytique indépendants montrent que des prix de jetons bas ne produisent pas toujours le coût de tâche le plus faible.
- Tarification : Les requêtes au-delà de 200 K jetons d’entrée entrent dans un palier de prix supérieur ; le coût total de la tâche dépend aussi du raisonnement et de l’usage des outils.
- Accès : Meta Model API et Muse Code sont disponibles ; la fiche CometAPI marque actuellement le modèle comme Bientôt disponible.
À quoi Muse Ember est-il le mieux adapté ?
Muse Ember gère les étapes d’exécution dans un flux d’agent tandis qu’un modèle plus grand gère la planification. Il convient aux tâches à grand volume avec des entrées claires, une portée limitée et un résultat que votre application peut vérifier. Ses missions principales sont :
- Classification et routage : attribuer des libellés aux demandes et les envoyer à la bonne file ou au bon service.
- Extraction : transformer des documents et des médias en champs structurés avec preuves d’origine.
- Appels d’outils : choisir une fonction et fournir les arguments que votre application exécute.
- Traitement par lots : appliquer une opération répétable à des fichiers ou des enregistrements.
Routage des tickets d’assistance
Un workflow d’assistance pratique peut demander à Ember d’extraire une référence de commande, d’attribuer une catégorie et de signaler les informations manquantes. Votre application peut valider la référence par rapport à ses enregistrements avant de router le ticket. Conservez les remboursements, les changements de compte et autres actions à conséquences derrière les contrôles d’autorisation propres à l’application.
Extraction de documents avec preuve
Pour le traitement de factures ou de contrats, demandez à la fois la valeur extraite et la page ou le passage qui l’étaye. Traitez les champs absents et illisibles comme des résultats explicites au lieu d’inviter le modèle à deviner. Cela produit des enregistrements que les réviseurs peuvent inspecter sans relire chaque document.
Travail de codage ciblé
Donnez à un agent de codage un périmètre de responsabilité restreint : les fichiers qu’il peut modifier, le comportement à préserver et les tests qui définissent l’achèvement. L’exemple de migration de code en parallèle de Meta illustre cette division du travail. L’agent environnant exécute les commandes et vérifie les résultats ; la seule réponse du modèle ne constitue pas une preuve qu’un changement a passé ses tests.
Le visuel de lancement de Muse Ember de Meta accompagne son guide sur la combinaison d’un modèle d’exécution avec un modèle de planification plus grand.
Meta indique que Muse Ember est le premier modèle entraîné avec Muse Wonder Full, prolongeant sa stratégie d’utiliser des modèles plus grands pour développer des modèles spécialisés.
Caractéristiques de Muse Ember
Les caractéristiques de base sont :
| Spécification | Muse Ember |
|---|---|
| Développeur | Meta Superintelligence Labs |
| Date d’annonce | 9 novembre 2026 |
| Catégorie de modèle | Raisonnement multimodal et exécution d’agent |
| Fenêtre de contexte | 1 048 576 jetons |
| Sortie maximale | 524 288 jetons |
| Modalités d’entrée | Texte, images, audio, vidéo |
| Entrées fichiers | Pris en charge via l’API Responses |
| Modalité de sortie | Texte |
| Effort de raisonnement | Minimal, Low, Medium, High, XHigh, Max |
| Effort de raisonnement par défaut | Max |
| Appel d’outils | Pris en charge |
| Sortie structurée | Pris en charge |
| Ancrage par recherche | Pris en charge via la Model API |
Meta n’a pas publié les poids de Muse Ember ni divulgué son nombre de paramètres. Les limites de requêtes et de jetons s’appliquent par équipe, toutes les clés API de l’équipe partageant l’allocation du modèle.
Contexte et entrées multimodales
Pour les workflows PDF, Meta extrait le texte des 100 premières pages et les images des 50 premières, donc scindez les fichiers plus longs avant le traitement. Envoyez le matériau nécessaire à la tâche ; les jetons de raisonnement partagent l’allocation de 524 288 jetons de sortie avec la réponse finale.
Utilisez des captures d’écran lorsque la mise en page compte, des scans pour l’extraction de documents, l’audio pour l’analyse de réunions et la vidéo pour des événements qui se déroulent dans le temps. Une transcription suffit pour un résumé purement textuel. Les fichiers sont pris en charge via l’API Responses, et les résultats sont renvoyés sous forme de texte.
Effort de raisonnement configurable
Muse Ember propose six niveaux de raisonnement : Minimal, Low, Medium, High, XHigh et Max. Meta utilise Max par défaut ; toute valeur non prise en charge renvoie une HTTP 400. Commencez le routage et la classification de routine à un niveau plus bas, puis augmentez-le uniquement lorsque le gain de réponses acceptées justifie la latence et le coût en jetons de sortie supplémentaires.
Appels d’outils et sortie structurée
Muse Ember prend en charge les appels d’outils et la sortie structurée. Les appels d’outils relient les décisions du modèle aux fonctions de l’application, tandis que la sortie structurée facilite la validation des champs extraits et leur passage à l’étape suivante.
Ce résultat illustratif de ticket d’assistance fournit à une application de routage une catégorie, une priorité et un indicateur de relecture :
{
  "category": "billing",
  "priority": "high",
  "requires_human_review": true
}
La Model API de Meta prend également en charge l’ancrage par recherche et les workflows d’utilisation de l’ordinateur. L’application connectée fournit les outils, exécute les actions et contrôle les autorisations.
Comment Muse Ember se comporte-t-il sur les benchmarks ?
Les résultats de lancement de Meta utilisent l’effort de raisonnement maximal. Agents’ Last Exam couvre le sous-ensemble Linux dans l’évaluation interne de Meta, tandis que Terminal-Bench utilise le meilleur harnais publié de chaque modèle. Ils combinent des résultats d’Artificial Analysis rapportés extérieurement avec les évaluations internes de Meta ; le Personal Superintelligence Index est un composite interne de Meta, pas un classement indépendant distinct.
Résultats de benchmark de Muse Ember
| Benchmark | Muse Ember | Claude Haiku 5.5 | GPT-6 Luna |
|---|---|---|---|
| AutomationBench-AA | 37.8 | 13.9 | 20.2 |
| Agents' Last Exam | 61.6 | 57.0 | 57.1 |
| Personal Superintelligence Index | 46.8 | 36.1 | 37.0 |
| Terminal-Bench 4.0 | 40.9 | 39.2 | 16.4 |
| Coding Agent Index-AA | 46 | 37 | 31 |
| FrontierCode 2.0-AA | 27.2 | 34.9 | 25.2 |
| GDP.pdf-AA | 22.8 | 20.8 | 22.8 |
| OSWorld 2.1 (partial score) | 69.5 | 68.9 | 50.5 |
| OSWorld 2.1 (binary score) | 33.8 | 27.8 | 17.0 |
| PerceptionBench (with tools) | 80.6 | 78.6 | 62.8 |
| Artificial Analysis Intelligence Index | 36 | 36 | 28 |
Terminal-Bench 4.0 utilise mini-swe-agent pour Muse Ember, Claude Code pour Haiku 5.5 et Codex pour GPT-6 Luna. Ce ne sont pas des environnements d’exécution identiques. OSWorld 2.1 rapporte à la fois des scores à crédit partiel et binaires, tandis que PerceptionBench inclut des outils. Les résultats de l’Artificial Analysis Intelligence Index proviennent de la version 5 publiée le 9 novembre 2026.
Analyse des benchmarks de Muse Ember
L’exécution d’agent est le point fort de Muse Ember.
Sur AutomationBench-AA, Muse Ember obtient 37.8, contre 13.9 pour Haiku 5.5 et 20.2 pour GPT-6 Luna. Cela soutient le positionnement de Meta de Muse Ember comme modèle pour des workflows métier de bout en bout et des opérations d’agent répétées.
Les performances en codage sont compétitives, mais pas systématiquement supérieures.
Muse Ember obtient 40.9 sur Terminal-Bench 4.0 et 46 sur Coding Agent Index-AA. Cependant, il obtient 27.2 sur FrontierCode 2.0-AA, en dessous des 34.9 de Haiku 5.5. Cela suggère que Muse Ember est un candidat utile pour des sous-tâches de codage bornées, tandis que des travaux d’ingénierie plus difficiles devraient être testés face à des alternatives plus fortes.
Les résultats multimodaux et d’utilisation de l’ordinateur sont prometteurs.
Muse Ember obtient 80.6 sur PerceptionBench avec outils et 69.5 sur OSWorld 2.1 en score à crédit partiel. Ces résultats soutiennent son positionnement pour des workflows impliquant compréhension visuelle et interaction avec l’ordinateur.
L’intelligence générale est comparable à Haiku 5.5.
Muse Ember et Haiku 5.5 arrondissent tous deux à 36 sur l’Artificial Analysis Intelligence Index, devant GPT-6 Luna à 28. Pour une décision de sélection, associez cette comparaison large aux résultats spécifiques à la tâche ci-dessus.
Intelligence de Muse Ember vs. coût par tâche
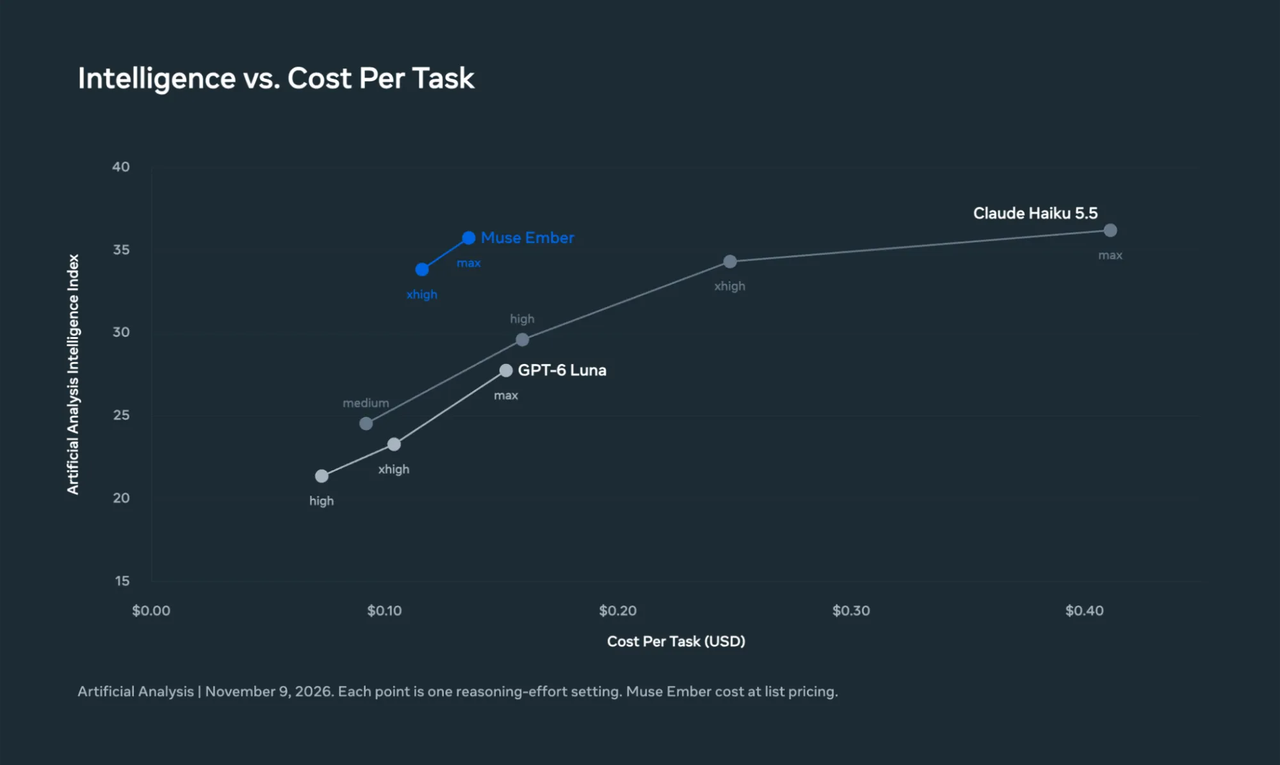
Le graphique de Meta compare les scores de l’Artificial Analysis Intelligence Index avec le coût estimé par tâche à différents réglages d’effort de raisonnement.
À l’effort de raisonnement maximal, Muse Ember obtient 35.8 sur l’Artificial Analysis Intelligence Index pour un coût estimé de 0,136 $ par tâche. Haiku 5.5 obtient 36.2 pour 0,411 $, tandis que GPT-6 Luna obtient 27.8 pour 0,152 $. Sur ce benchmark, Ember se rapproche du score de Haiku pour environ un tiers du coût par tâche et dépasse le score de Luna pour un coût légèrement inférieur.
Ces estimations utilisent la consommation de jetons du benchmark et les prix catalogue. L’évaluation suivante montre pourquoi l’activité d’outils compte lors du choix d’un modèle pour un workflow spécifique.
Résultats indépendants d’analyse de données
L’évaluation d’analyse de données de novembre 2026 de Plotly a testé 43 questions dans Plotly Studio Embedded sur un jeu de données synthétique d’énergie éolienne. Muse Ember a tourné via OpenRouter ; les coûts rapportés utilisent les prix disponibles lorsque chaque modèle a été exécuté. Il s’agit de résultats spécifiques à la charge de travail, pas d’un test de facturation sur l’API native de Meta.
| Indicateur d’évaluation | Muse Ember | GPT-6 Luna | Claude Haiku 5.5 |
|---|---|---|---|
| Questions réussies | 38/43 | 38/43 | 37/43 |
| Coût total du test | 1,04 $ | 0,13 $ | 0,38 $ |
| Temps médian par question | 28 s | 18 s | 14 s |
Pour cette charge d’analyse de données, GPT-6 Luna a délivré le même 38/43 qu’Ember pour un huitième du coût total, avec un temps de réponse médian plus faible. Haiku a été le plus rapide à 14 secondes par question, avec 37/43 réussites. Luna est le meilleur candidat de départ pour un workflow d’analytique similaire sensible aux coûts ; le faible tarif par jeton d’Ember ne rend pas à lui seul le choix moins cher.
Plotly a constaté que Muse Ember effectuait en moyenne 78 requêtes sur des questions impliquant des motifs cachés, contre une médiane de 25 pour l’ensemble des modèles testés. L’activité d’outils supplémentaire a augmenté sa consommation de jetons et son coût total.
Le test a également mis en évidence des points forts : Muse Ember a répondu correctement aux 20 questions d’analytique clairement définies, aux cinq questions ambiguës, aux cinq demandes impossibles et aux trois contrôles de qualité des données. Il a le plus peiné sur les motifs cachés dans les données.
Plotly a exécuté chaque modèle une fois et observé une variation allant jusqu’à trois questions en répétant d’autres modèles. Considérez les 38 contre 37 réussites comme proches ; la différence plus nette ici concerne l’usage des outils et le coût total.
Muse Ember vs Muse Wonder vs Muse Spark
Choisissez un modèle Muse selon la responsabilité qu’il assumera : planification, boucle principale de l’agent ou exécution répétée.
| Dimension | Muse Wonder | Muse Spark 1.3 | Muse Ember |
|---|---|---|---|
| Rôle principal | Raisonnement de pointe et ingénierie complexe | Modèle principal de codage et d’agents | Exécution à grand volume |
| Force principale | Planification, tâches longues, codage complexe | Workflows de codage et d’agents | Sous-tâches répétitives et appels d’outils |
| Charge de travail typique | Ingénierie à l’échelle d’un dépôt | Exécution principale de l’agent | Classification, routage, extraction |
| ID de modèle API | muse-wonder-1.0 | muse-spark-1.3 | muse-ember-1.0 |
| Fenêtre de contexte | 1 M de jetons | 1 M de jetons | 1 M de jetons |
| Raisonnement par défaut | Max | High | Max |
| Prix d’entrée standard / 1 M | 4,00 $ | 1,25 $ | 0,10 $ |
| Prix de sortie standard / 1 M | 20,00 $ | 4,25 $ | 0,50 $ |
Le tableau utilise les prix des jetons en mode Standard de Meta. Les prix d’Ember ici s’appliquent aux requêtes jusqu’à 200 K jetons d’entrée ; Wonder et Spark ne comportent pas la majoration long contexte d’Ember.
Sélection du modèle Muse
Choisissez Wonder pour la planification difficile, l’ingénierie à l’échelle d’un dépôt et la reprise sur de longues séquences d’étapes. Choisissez Spark pour exécuter la boucle principale de codage ou d’agent. Choisissez Ember pour des sous-tâches répétées avec des sorties vérifiables de façon indépendante, telles que le routage, l’extraction et des modifications ciblées de fichiers.
Par exemple, une migration de dépôt peut confier l’analyse des dépendances à un modèle plus grand et un changement de fichier à portée étroite à Ember. Le relais doit nommer les fichiers, le comportement attendu et les contrôles d’acceptation. Cette division n’est utile que lorsque la coordination et la revue des petites tâches coûtent moins cher que d’achever la totalité avec le modèle principal.
Pour les départager, exécutez les mêmes tâches représentatives avec les mêmes contrôles d’acceptation. Rejetez d’abord les configurations qui manquent votre taux de réussite requis ou votre cible de latence. Parmi celles qui passent, comparez la dépense totale divisée par les résultats acceptés, en incluant réessais et appels d’outils. Confiez à Ember les types de tâches où il abaisse ce coût, et renvoyez les cas non résolus vers Spark ou Wonder.
Combien coûte Muse Ember ?
Le tableau associe les tarifs officiels de Meta à une estimation avec remise de 20 % pour CometAPI, en USD par million de jetons. Chaque cellule indique Meta / estimation avec remise. La fiche de CometAPI ne publie pas encore de tarif en direct ; utilisez les chiffres remisés pour la planification budgétaire.
| Usage par 1 M de jetons (Meta / estimation -20 %) | Jusqu’à 200 K jetons d’entrée | Au-delà de 200 K jetons d’entrée |
|---|---|---|
| Entrée | 0,10 $ / 0,08 $ | 0,30 $ / 0,24 $ |
| Entrée mise en cache | 0,004 $ / 0,0032 $ | 0,012 $ / 0,0096 $ |
| Sortie | 0,50 $ / 0,40 $ | 1,50 $ / 1,20 $ |
Le nombre total de jetons d’entrée d’une requête, y compris l’entrée mise en cache, détermine le palier. Une requête au-dessus de 200 K jetons d’entrée utilise les tarifs plus élevés pour l’intégralité de la requête, y compris sa sortie. Avec le previous_response_id de Meta, l’historique de conversation stocké compte dans ce total d’entrée.
Coûts typiques d’une requête Muse Ember
Avec une entrée non mise en cache et 20 K jetons de sortie facturés, raisonnement inclus, une requête avec 200 K jetons d’entrée coûte 0,0300 $ aux tarifs de Meta, ou 0,0240 $ avec 20 % de remise. Porter l’entrée à 220 K fait passer la requête entière dans le palier supérieur : les mêmes 20 K de sortie amènent alors le total à 0,0960 $ aux tarifs de Meta, ou environ 0,0768 $ avec la remise. Ces exemples excluent les frais distincts liés aux outils. Conserver le contexte pertinent dans le palier inférieur peut économiser davantage qu’une remise de 20 % à elle seule.
| Scénario | Jetons d’entrée | Jetons de sortie facturés | Coût Meta | Coût CometAPI |
|---|---|---|---|---|
| Requête standard | 200K | 20K | 0,0300 $ | 0,0240 $ |
| Requête à long contexte | 220K | 20K | 0,0960 $ | 0,0768 $ |
Les jetons de raisonnement comptent comme de la sortie facturée. Pour l’API native de Meta, l’ancrage par recherche web coûte 2,50 $ supplémentaires par 1 000 requêtes, et Ember n’a pas de variante en mode Contributor. La comparaison de prix de jetons ci-dessus n’applique pas la remise de 20 % aux frais distincts des outils.
Comment accéder à Muse Ember
Fiche CometAPI : la page du modèle identifie le modèle comme muse-ember, mais son statut dans le catalogue est Bientôt disponible au 16 novembre 2026. Suivez cette page pour l’activation et la tarification ; pour un accès immédiat, utilisez Meta Model API ou Muse Code.
Via Meta Model API : utilisez muse-ember-1.0 avec https://api.meta.ai/v1. L’API native prend en charge les formats Responses, Chat Completions et Messages. Les entrées fichiers utilisent Responses. Conservez l’endpoint et l’identifiant de modèle de chaque fournisseur ensemble lors de la configuration de votre client.
Limites de l’API native et autres accès : Meta indique 3 000 requêtes par minute et 4 000 000 de jetons par minute par équipe, partagés par les clés API de l’équipe. Muse Ember est aussi disponible dans Muse Code. Vérifiez les limites de la voie choisie lors du dimensionnement d’un lot, et utilisez le guide d’intégration de Meta pour la configuration de l’API native.
Quelles sont les limites de Muse Ember ?
Trois facteurs déterminent si Ember convient à votre prochain workflow :
- L’ingénierie complexe reste dépendante de la charge de travail. Ember est derrière Haiku 5.5 sur FrontierCode 2.0-AA malgré un meilleur résultat sur Terminal-Bench. Un gain étroit en codage n’établit pas une pertinence pour chaque changement à l’échelle d’un dépôt.
- Un long contexte et des prix de jetons bas ne garantissent pas un faible coût par tâche. Les requêtes volumineuses basculent vers un palier de prix supérieur, et l’usage répété d’outils peut consommer assez de jetons pour contrebalancer le faible tarif unitaire.
- La prise en charge des outils nécessite toujours une application. Le système environnant exécute les appels, contrôle les autorisations et valide les résultats. La capacité d’un modèle à demander une action ne fournit pas en soi un workflow fiable.
Conclusion
Adoptez Ember là où les critères d’acceptation sont suffisamment clairs pour être mesurés. Un premier déploiement utile est une étape à grand volume qui possède déjà un résultat connu, comme le routage de tickets étiquetés ou l’extraction de champs depuis des documents relus. Comparez le coût par tâche réussie, les taux d’erreur et la latence par rapport à votre modèle actuel avant d’étendre son rôle. Ces éléments vous diront si Ember réduit le coût de votre workflow tout en préservant la qualité requise.
FAQ
Comment valider les résultats d’extraction de Muse Ember ?
Constituez un ensemble de référence de documents avec réponses vérifiées par des humains, y compris champs manquants, scans illisibles et valeurs conflictuelles. Mesurez la précision par champ plutôt que de considérer chaque JSON valide comme un succès. Vérifiez si chaque valeur extraite est étayée par le passage source cité, et envoyez les divergences en relecture. Cela sépare la fiabilité de formatage de la fiabilité factuelle.
Quand une sous-tâche de Muse Ember doit-elle revenir à l’agent principal ?
Définissez les conditions d’escalade avant l’exécution : un fichier requis est hors du périmètre assigné, les sources sont en désaccord, un contrôle d’acceptation échoue à plusieurs reprises, ou la tâche exige une décision que l’agent n’était pas autorisé à prendre. Renvoyez à l’agent principal les preuves, les étapes tentées et la question non résolue. Un relais clair est plus utile que de permettre à l’agent d’élargir indéfiniment sa mission.
Que devez-vous journaliser lors des tests de Muse Ember en production ?
Enregistrez le fournisseur et l’identifiant du modèle exacts, le réglage de raisonnement, les jetons d’entrée et de sortie facturés, les jetons mis en cache, le nombre d’appels d’outils, les réessais, la latence et le résultat final d’acceptation. Conservez le résultat de validation aux côtés de l’enregistrement d’usage pour pouvoir calculer le coût par tâche acceptée. Comparez séparément des types de tâches similaires ; une moyenne couvrant routage, codage et documents longs peut masquer là où le modèle aide ou ajoute du coût.
Comment éviter les actions en double dans un workflow Muse Ember ?
Faites en sorte que l’application soit responsable de l’identité de l’action et de l’état d’achèvement. Pour une opération telle que la création d’un ticket, assignez une clé d’opération stable, vérifiez si elle est déjà terminée et utilisez la prise en charge d’idempotence de l’API de destination lorsque disponible. Après un délai, inspectez l’état de l’action avant de réessayer. Cette conception évite de traiter une réponse incertaine comme la preuve que l’action initiale n’a jamais eu lieu.