
TLDR: DeepSeek-V4.1-Flash-1017 è un aggiornamento del 17 ottobre 2026, minore ma altamente impattante, del modello V4.1-Flash di DeepSeek. Offre risultati migliori nei benchmark di ragionamento, coding, agentici e visivi, producendo al contempo output più brevi e completando i task più rapidamente—spingendo in avanti la frontiera di Pareto prestazioni-costo.
Punti chiave
- DeepSeek-V4.1-Flash-1017 Rilasciato il 17 ottobre 2026 come upgrade gratuito all’esistente endpoint API
deepseek-flash—nessuna modifica del codice richiesta per gli utenti esistenti. - Incrementi segnalati dal fornitore su tutti gli 11 benchmark elencati rispetto al V4.1-Flash, con i maggiori salti nei task agentici e di coding.
- Architettura: Mixture-of-Experts da 552B parametri con design Causal Encoder-Decoder (≈8B parametri attivi in input/prefill, 16B in decode/output); finestra di contesto da 1M token; fino a 384K token di output; supporto nativo alla visione.
- Prezzi invariati: Off-peak $0.15 / $0.60 per 1M token input (cache miss) / output (le fasce di picco raddoppiano questi valori); cache hit fino a $0.003. CometAPI è prezzata al 20% in meno rispetto alla tariffa ufficiale.
- Nuove API Search & Fetch aperte a tutti gli sviluppatori ($0.75 per 1,000 chiamate; gratis tramite alcuni strumenti server-side fino al 31 ottobre 2026).
- Solide capacità di “wish-driven programming” per la generazione end-to-end di progetti (giochi, scene 3D, repository completi). Competitivo rispetto ai modelli chiusi più grandi nei benchmark agent e coding, rimanendo molto più economico e veloce per molti carichi in produzione.
- Pesi open-source MIT su Hugging Face e ModelScope abilitano self-hosting e fine-tuning.
- Per l’uso in produzione, piattaforme come CometAPI offrono accesso comodo e compatibile con OpenAI ai modelli DeepSeek insieme a oltre 500 altri, spesso con prezzi competitivi e switching semplificato.
DeepSeek continua a spingere i confini dei modelli di AI aperti, efficienti e ad alte prestazioni. Il 17 ottobre 2026 l’azienda ha rilasciato DeepSeek-V4.1-Flash-1017, un aggiornamento mirato del modello V4.1-Flash (originariamente lanciato il 10 settembre 2026). Presentato come un miglioramento sostanziale nelle capacità di ragionamento, coding, agenticità e comprensione visiva—riducendo al contempo i tempi di esecuzione dei task e la lunghezza degli output—questo checkpoint è posizionato come il modello efficiente più potente di DeepSeek ad oggi per carichi agent e di coding nel mondo reale.
Il modello è disponibile sul sito di DeepSeek, nell’app mobile e nell’API (ancora chiamata semplicemente deepseek-flash). I pesi sono rilasciati apertamente sotto licenza MIT, rendendolo una delle opzioni open-weight più forti per gli sviluppatori che desiderano prestazioni da agenti di frontiera senza costi da frontiera.
Che cos’è esattamente DeepSeek V4.1-Flash-1017?
DeepSeek-V4.1-Flash-1017 è un checkpoint datato (“1017” si riferisce al rilascio del 17 ottobre) della famiglia V4.1-Flash. DeepSeek lo descrive come un “aggiornamento minore”, ma i miglioramenti sono ampi e significativi: punteggi più alti in ogni categoria di benchmark riportata, completamento dei task più rapido e output più brevi. L’azienda lo presenta come un vero miglioramento di Pareto—migliori prestazioni e migliore efficienza dei costi simultaneamente.
Erede dell’innovativa architettura introdotta con V4.1-Flash:
- Design Mixture-of-Experts (MoE) con circa 552B parametri totali di backbone (più parametri Engram aggiuntivi in alcuni report). Nuova architettura Causal Encoder-Decoder che attiva solo ~8B parametri per token durante il prefill/elaborazione input e ~16B durante la generazione decode/output.
- KV cache altamente compressa (riduzioni dichiarate di 1/4 della HBM e 1/8 dello storage SSD rispetto alle generazioni precedenti), che riduce drasticamente il costo di interazioni long-context e multi-turn per agenti.
- Supporto multimodale nativo (input testo + immagine → output testo). Finestra di contesto da 1 milione di token e lunghezza massima di output di 384K token (il campionamento consigliato spesso usa ≥256K token massimi).
- Supporto per modalità di thinking/non-thinking, tool calling, output JSON e sforzo di ragionamento regolabile.
Il modello è stato addestrato con tecniche di reinforcement learning potenziate, incluse loop di auto-feedback specificamente orientate a migliorare lo sviluppo end-to-end di progetti. Questo abilita una “wish-driven programming” più affidabile—trasformando obiettivi in linguaggio naturale di alto livello in progetti completi e funzionanti come web game, scene 3D o repository di codice completi.
Per uno sviluppatore di applicazioni, questo cambia la domanda di valutazione. Invece di verificare se il modello può produrre una funzione plausibile, testare se può comprendere una codebase esistente, effettuare modifiche coordinate, eseguire controlli e correggere errori. Una dimostrazione convincente stabilisce una capacità degna di test; non stabilisce l’affidabilità su repository arbitrari.
L’aggiornamento rende inoltre l’efficienza dell’output un aspetto da misurare separatamente dalla qualità della risposta. Una risposta più breve può ridurre il costo di generazione, ma solo se preserva l’implementazione, la spiegazione o l’evidenza richiesta dal task. Rimuovere una validazione utile sarebbe una regressione anche se il conto token diminuisce.
Specifiche API di DeepSeek V4.1-Flash-1017
| Specifica | DeepSeek V4.1-Flash-1017 |
|---|---|
| Identificatore API nativo | deepseek-flash |
| Finestra di contesto | 1M token |
| Output massimo | 384K token |
| Supporto input | Testo e immagini |
| Modalità di ragionamento | Thinking e non-thinking |
| Funzionalità per sviluppatori | Tool calls, output JSON, Responses API |
| Architettura | Causal Encoder–Decoder MoE |
| Conteggio parametri annunciato | 552B |
| Parametri attivi | 8B per input; 16B per output |
Come si comporta DeepSeek V4.1-Flash-1017 nei benchmark?
Test indipendenti iniziali (ad es., affiancato a DeepSeek V4 Pro) hanno mostrato che 1017 eguaglia la qualità su task pratici risultando significativamente più veloce ed economico, oltre ad aggiungere il supporto alla visione che Pro mancava in alcune configurazioni.
I risultati selezionati riportati dal fornitore confrontano il rilascio di settembre con l’aggiornamento del 17 ottobre.
| Risultati benchmark ufficiali | Rilascio di settembre | Aggiornamento del 17 ottobre | Variazione assoluta (punti) |
|---|---|---|---|
| HLE senza strumenti | 36.8 | 42.6 | +5.8 |
| Terminal-Bench 4.0 | 31.2 | 42.3 | +11.1 |
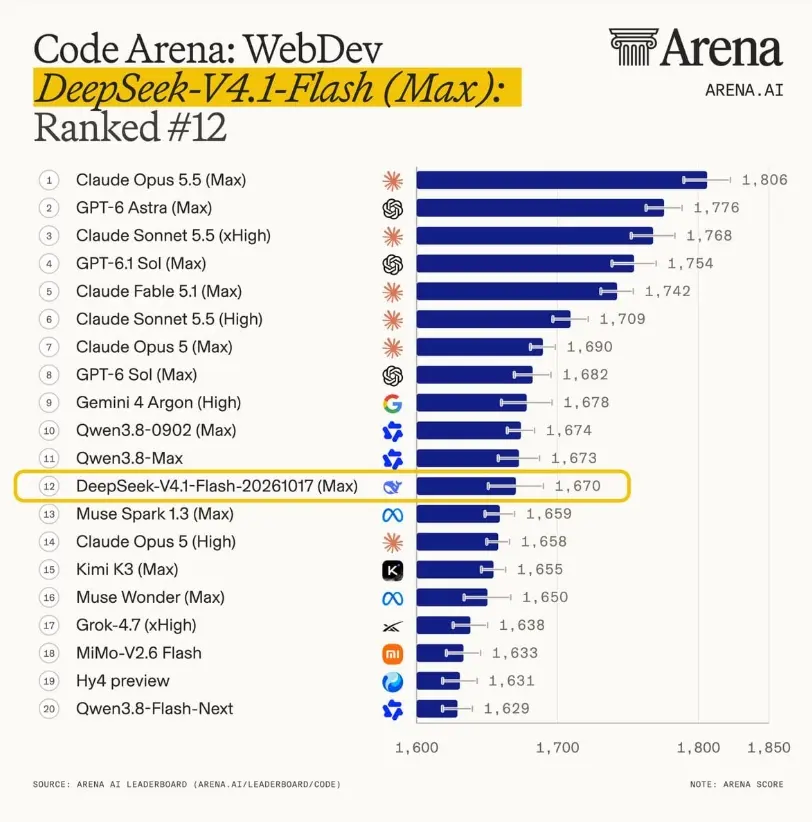
| DeepSWE v1.1 | 74.2 | 77.0 | +2.8 |
| ProgramBench | 20.3 | 29.1 | +8.8 |
| NL2Repo-Bench | 65.4 | 68.2 | +2.8 |
| Automation-Bench v1.0.6 | 54.8 | 60.5 | +5.7 |
| Agents’ Last Exam | 31.8 | 35.4 | +3.6 |
| Apex Bench v1.1 | 64.6 | 72.1 | +7.5 |
| Chartography con strumenti | 78.9 | 83.0 | +4.1 |
Questi sono risultati riportati dal fornitore, non repliche indipendenti. DeepSeek ha utilizzato Claude Code per Terminal-Bench 4.0 e Mini-SWE-V2 per DeepSWE v1.1. HLE è riportato senza strumenti e usa i punteggi principali piuttosto che il sottoinsieme text-only marcato separatamente; Chartography utilizza strumenti. La tabella del rilascio citata non fornisce una configurazione completa per riga per ogni altro benchmark, quindi non si possono assumere budget di ragionamento, hardware e condizioni di stop equivalenti. Le variazioni sopra sono semplici differenze di punteggio, non miglioramenti percentuali relativi.
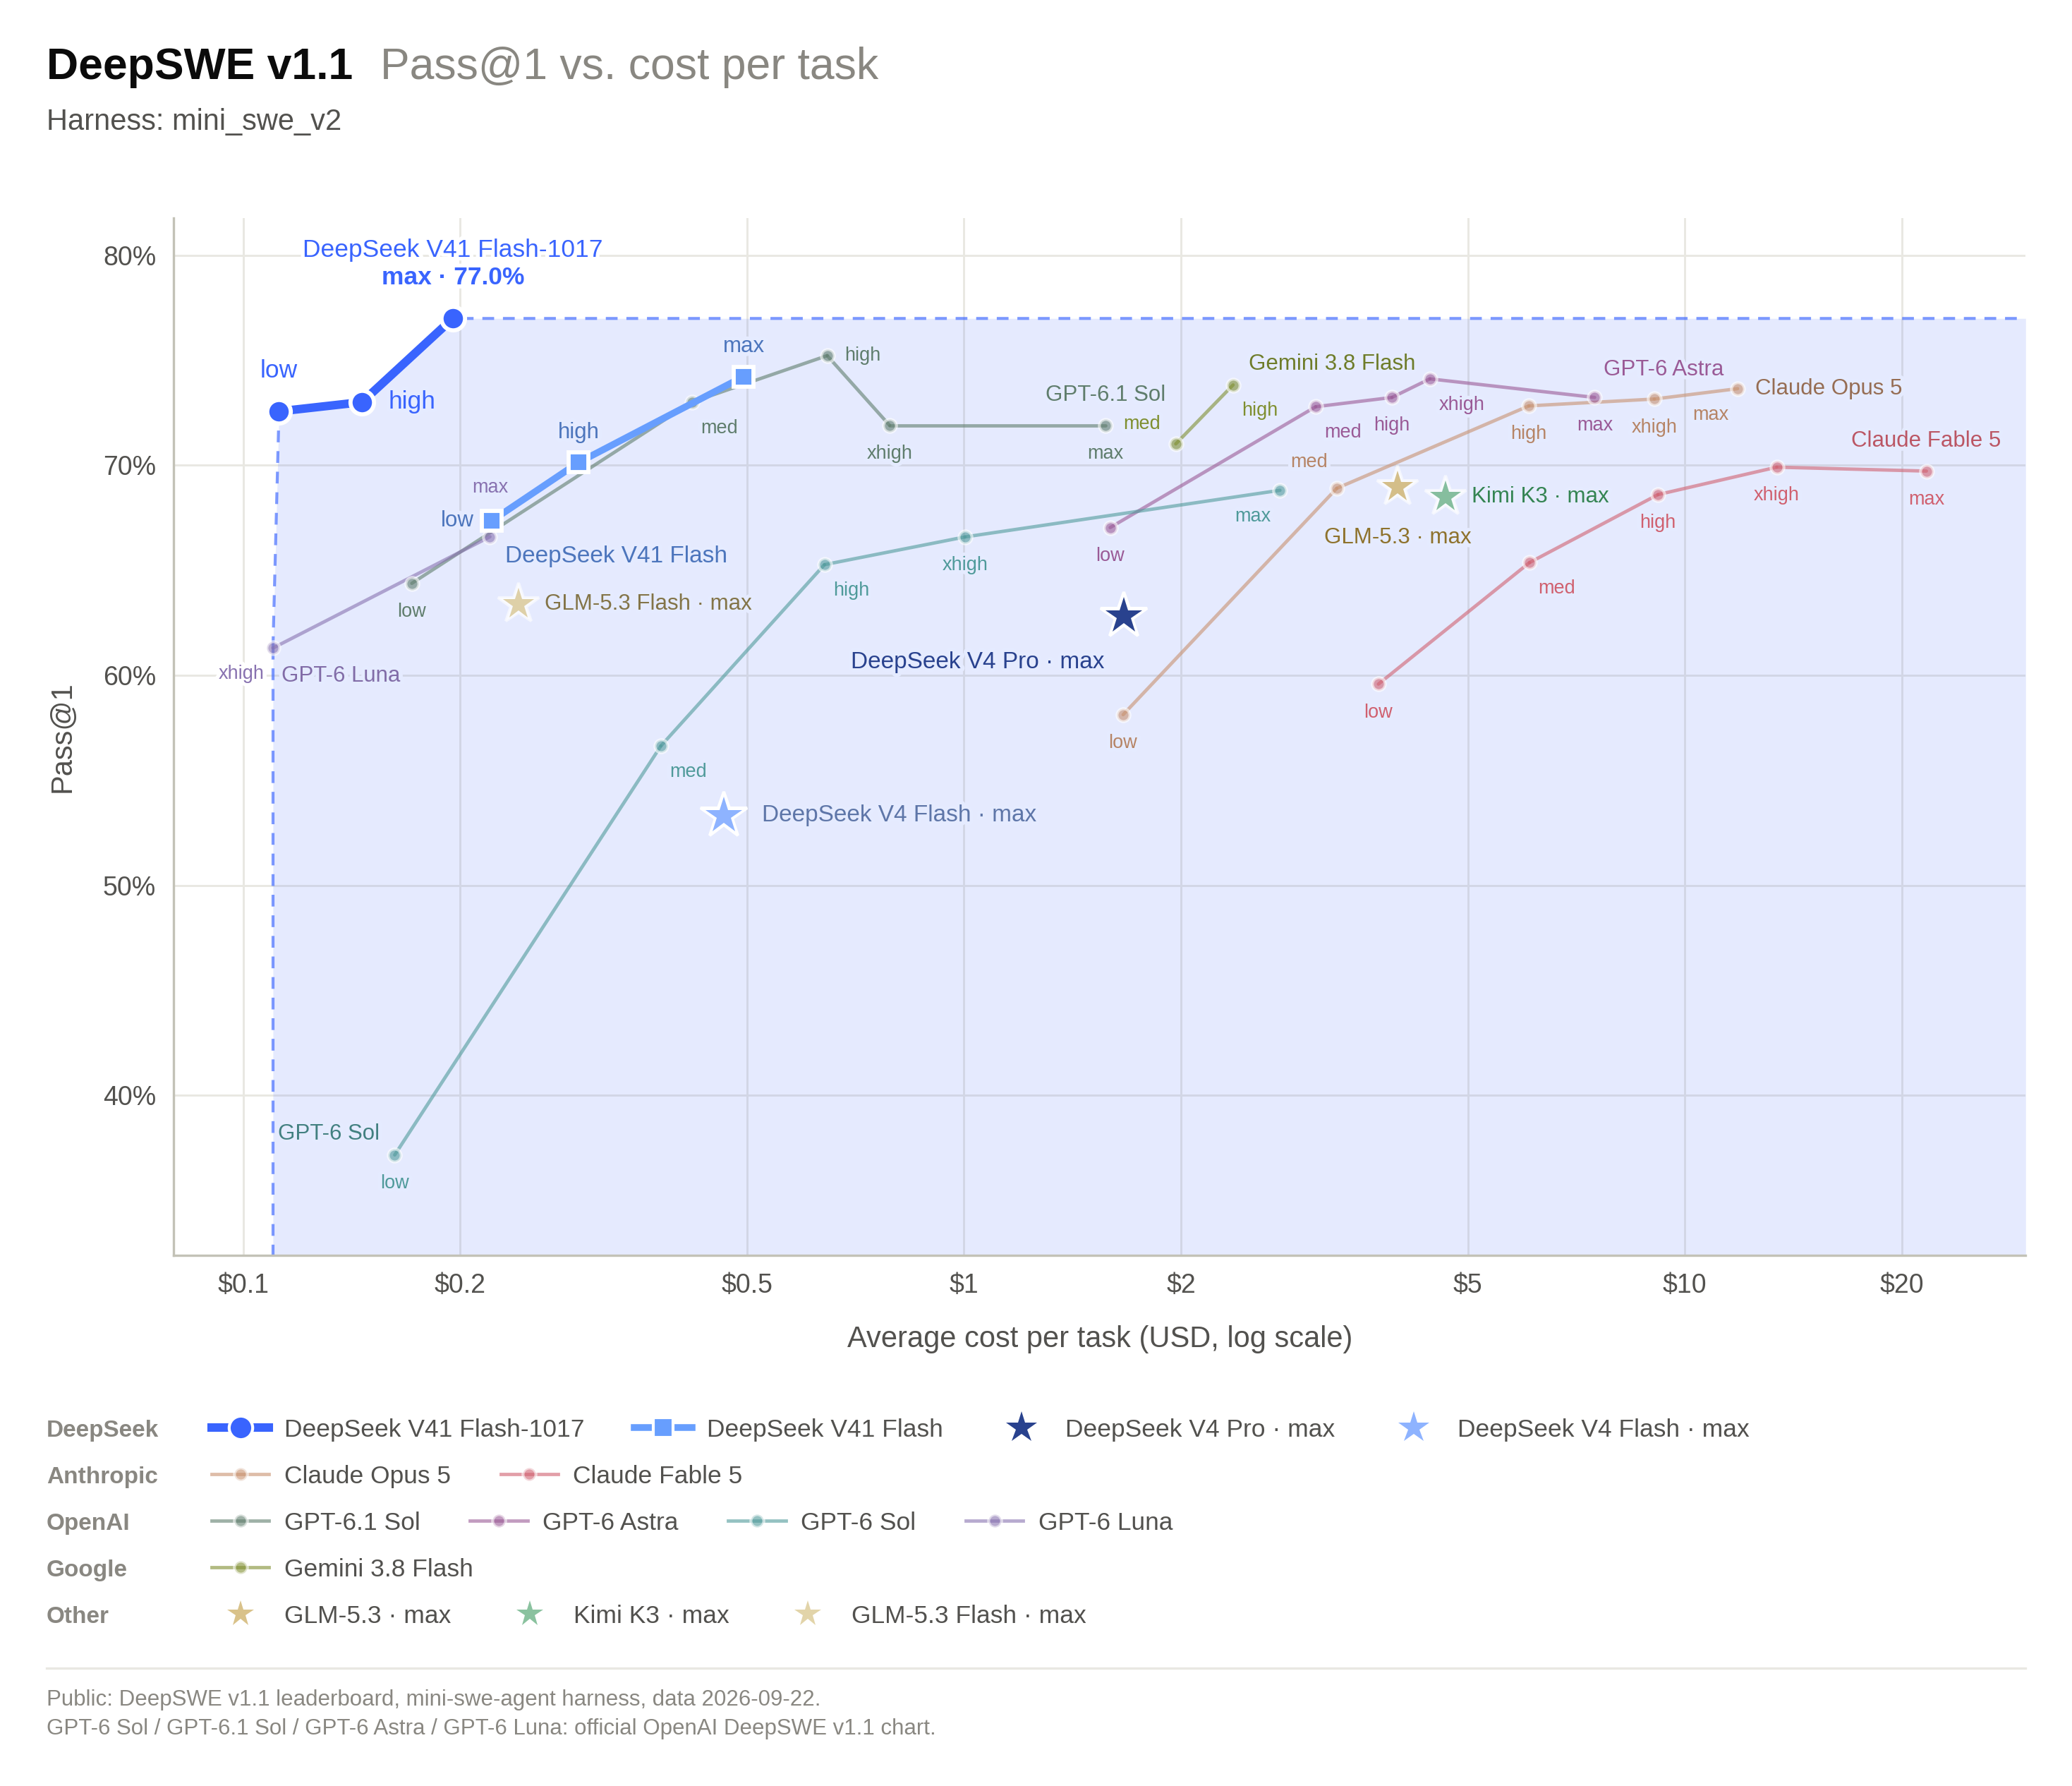
Il grafico prestazioni-versus-costo DeepSWE v1.1 di DeepSeek riporta Pass@1 contro il costo medio del task in USD su un asse logaritmico, usando il framework Mini-SWE-V2. Le diverse impostazioni di ragionamento appaiono come punti separati; confrontare un tasso di successo e una configurazione adeguati prima di trarre una conclusione sui costi.
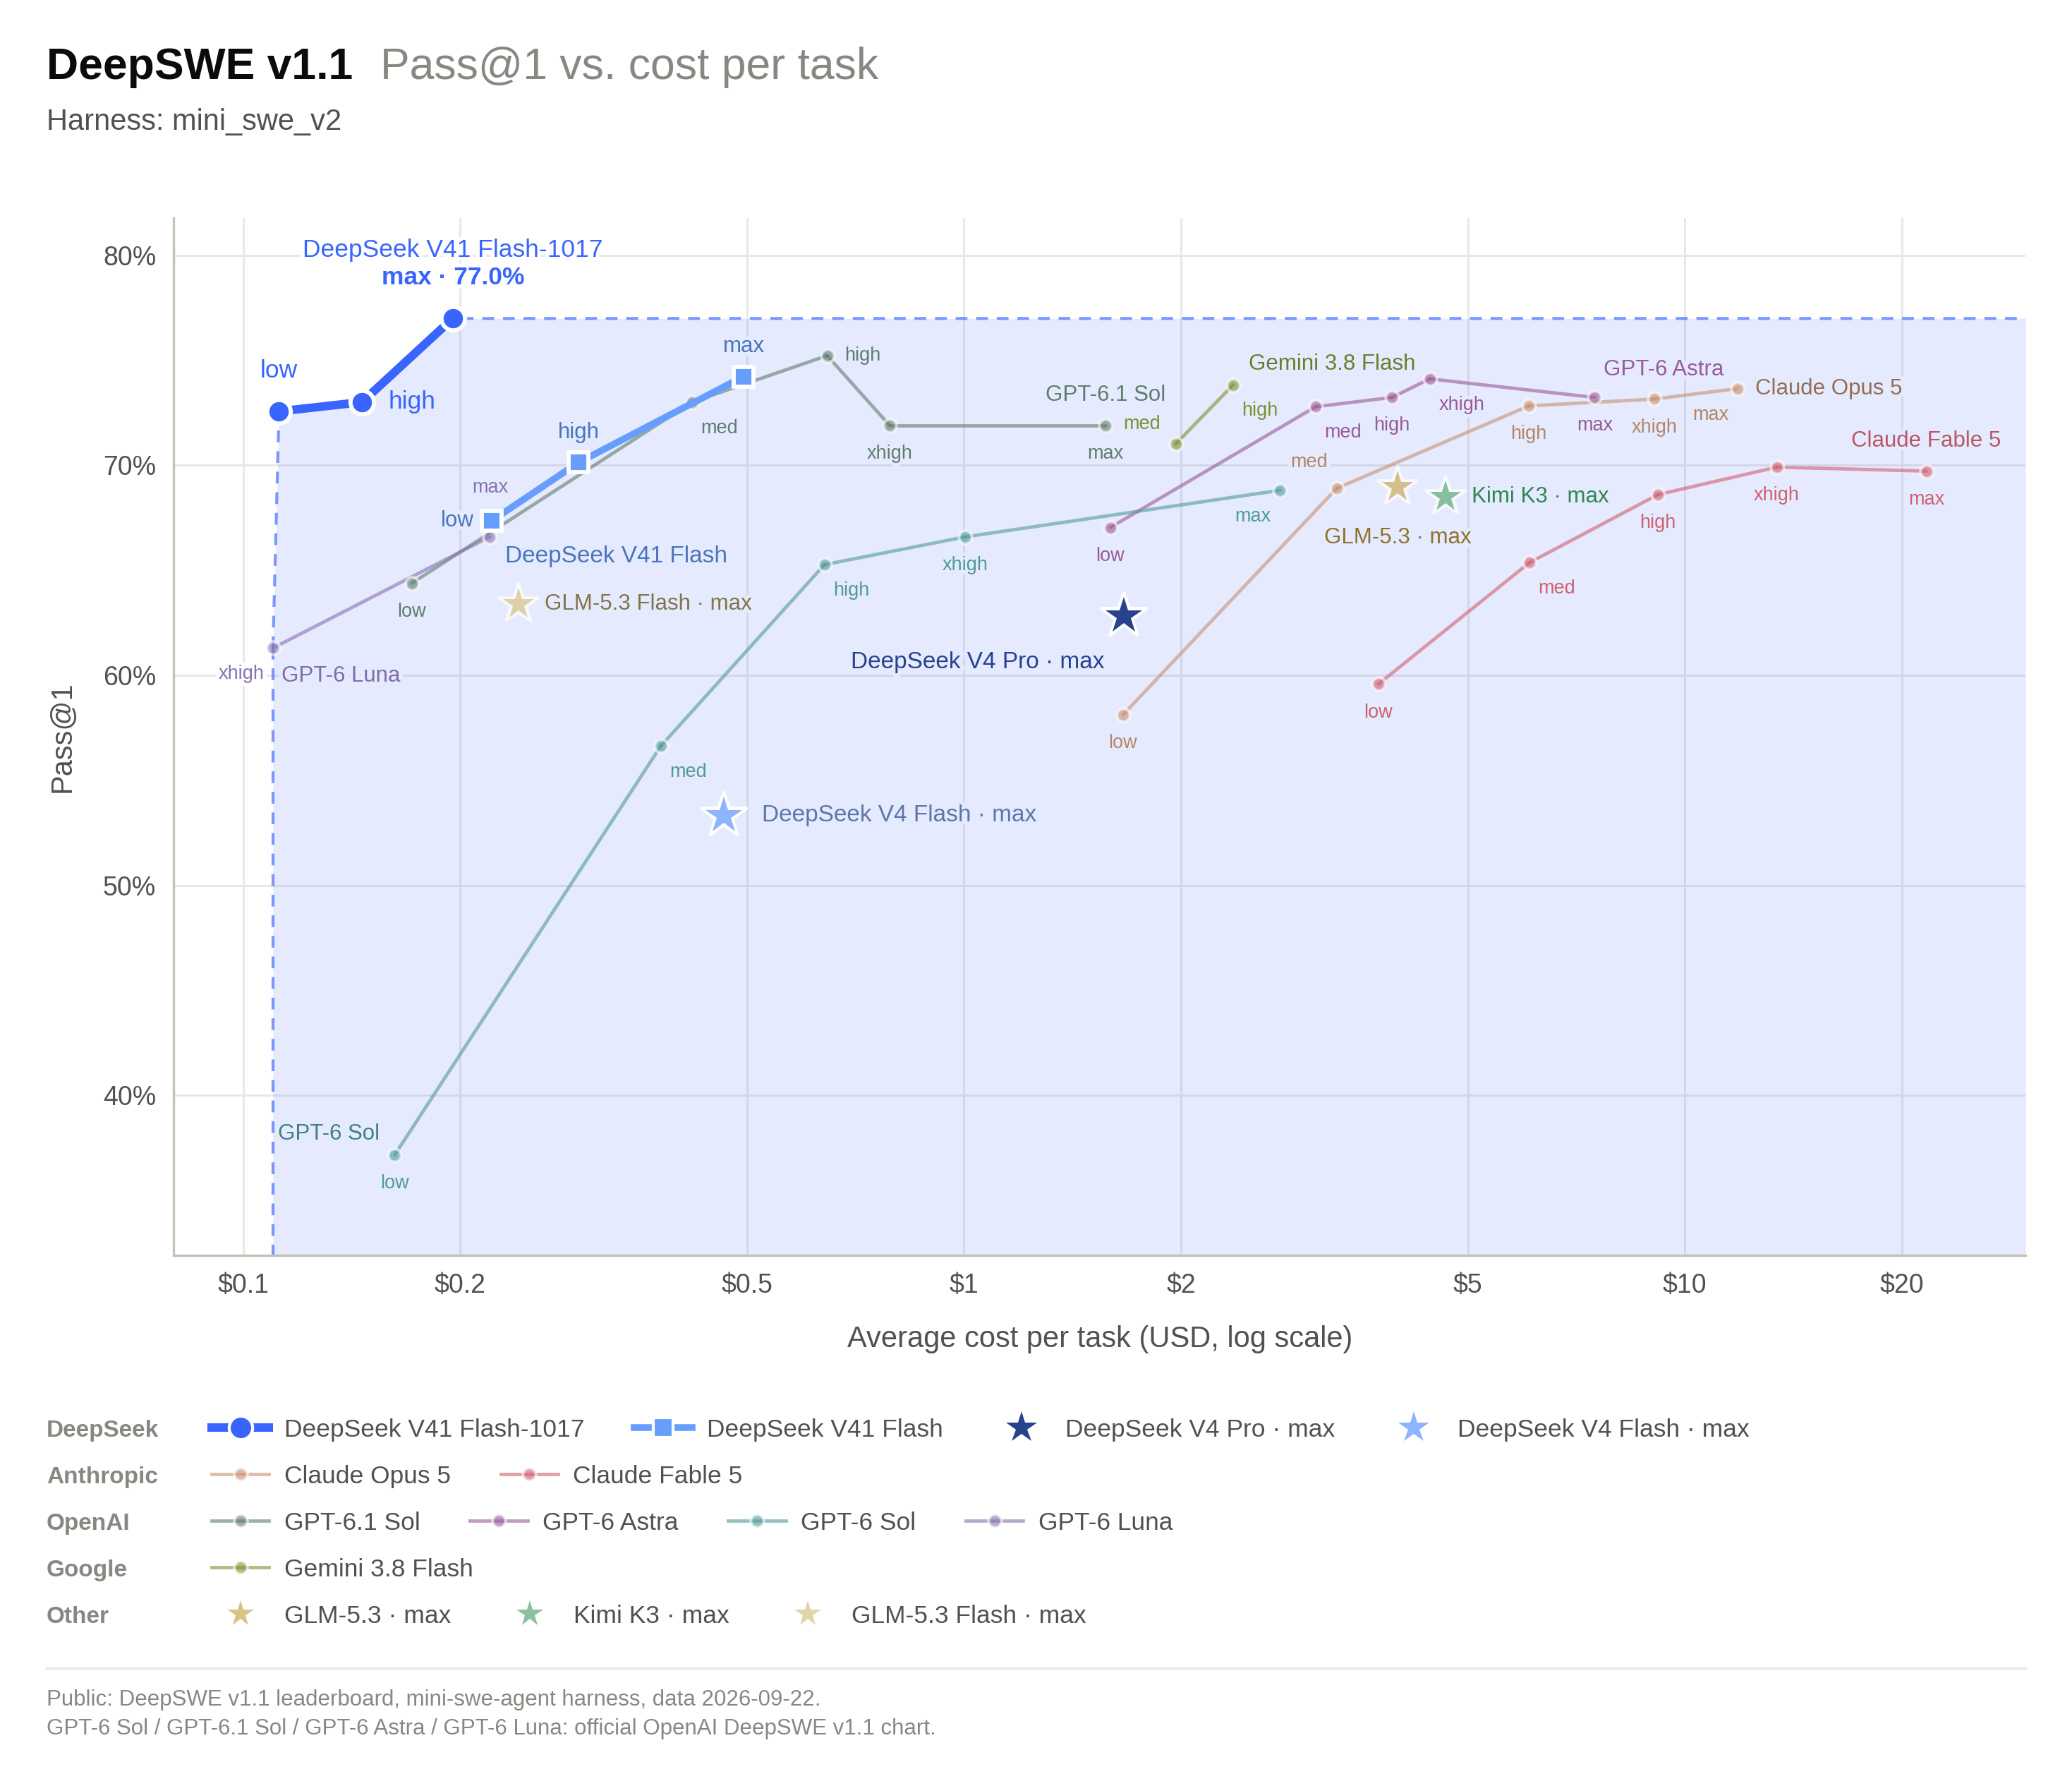
Code Arena: WebDev Leaderboard – Miglior modello open-source
Nel più recente benchmark di frontiera per coding e sviluppo web WebDev, DeepSeek-V4.1-Flash-1017 non solo ha superato il molto apprezzato Kimi K3 (Max), ma ha anche ottenuto un miglioramento di un ordine di grandezza nell’efficienza dei costi di inferenza—con una spesa operativa pari a circa un decimo della controparte. DeepSeek-V4.1-Flash-20261017 (Max) ha ufficialmente conquistato il primo posto nella Code Arena: WebDev leaderboard, guadagnando il titolo di “numero uno tra i modelli open-source”.
Nella classifica complessiva, il modello ha ottenuto il 12° posto con un punteggio di 1670. A questo livello di ranking elevato, supera il principale modello closed-source, Claude Opus5 (High), e ha ridotto il divario con il modello di punta, GPT-6Sol (Max), a meno di 10 punti.
Come si confronta l’aggiornamento di ottobre con il rilascio di settembre?
Rispetto al rilascio di settembre, l’aggiornamento del 17 ottobre mostra i guadagni più evidenti nei benchmark di coding selezionati: Terminal-Bench 4.0 sale da 31.2 a 42.3 (+11.1 punti), mentre ProgramBench aumenta da 20.3 a 29.1 (+8.8 punti). DeepSWE v1.1 migliora da 74.2 a 77.0 (+2.8 punti). Questi risultati riportati dal fornitore supportano la valutazione dell’aggiornamento per i workflow da terminale e i task di programmazione più ampi; non implicano guadagni di produttività equivalenti in ogni codebase.
Il rilascio pone anche maggiore enfasi sullo sviluppo completo di progetti tramite reinforcement learning con auto-feedback. La velocità e i risparmi di token restano dipendenti dal task, come mostrano i due esempi nella sezione successiva. Per le integrazioni native API esistenti, l’identificatore del modello rimane deepseek-flash. La decisione pratica di upgrade dovrebbe quindi basarsi sull’accettazione dei task completati, sul costo totale e sul tempo end-to-end misurati su lavori rappresentativi.
Quanto costa DeepSeek V4.1-Flash-1017?
Il suo vantaggio di costo è enorme: Flash è tipicamente 10–40× più economico per token rispetto ai principali modelli chiusi, e output più brevi amplificano ulteriormente i risparmi per agenti multi-step. Rispetto al suo predecessore, 1017 è strettamente migliore sui metriche riportate mantenendo lo stesso prezzo—rendendolo un upgrade puro.
USD per milione di token, come riportato nell’articolo di origine il 19 ottobre 2026. Le tariffe di picco di CometAPI applicano il moltiplicatore pubblicato 2×.
| Categoria di token | DeepSeek nativo: off-peak | DeepSeek nativo: peak | DeepSeek V4.1 Flash API in CometAPI: base | CometAPI: finestra 2× |
|---|---|---|---|---|
| Input, cache hit | $0.003 | $0.006 | $0.0024 | $0.0048 |
| Input, cache miss | $0.15 | $0.30 | $0.12 | $0.24 |
| Output | $0.60 | $1.20 | $0.48 | $0.96 |
Entrambi i provider indicano finestre di picco nei giorni feriali 01:00–04:00 e 06:00–10:00 UTC. DeepSeek esclude le festività pubbliche cinesi; le condizioni esposte da CometAPI non specificano tale esenzione. Le altre ore utilizzano tariffe off-peak/base. La colonna 2× di CometAPI è calcolata dai suoi prezzi base pubblicati.
Per la DeepSeek API nativa, 10 milioni di token input non in cache più 2 milioni di token output costano:
- Off-peak: (10 × $0.15) + (2 × $0.60) = $2.70.
- Peak: (10 × $0.30) + (2 × $1.20) = $5.40.
Per un budget pilota, dividere tutti i token e le spese per strumenti su tutti i tentativi per task accettati. Includere il riuso della cache e le finestre di picco; riportare separatamente i costi di infrastruttura e revisione umana. Gli esempi sopra coprono solo i token del modello.
Tariffe Search e Fetch
Le API Search e Fetch di DeepSeek costano ciascuna $0.75 per 1,000 richieste riuscite. La loro fatturazione è separata dall’uso dei token del modello; richieste fallite, risultati di ricerca vuoti e timeout non sono addebitati secondo le regole documentate.
Per gli utenti della DeepSeek API, le chiamate server-side Search e Fetch tramite DeepSeek Harness, Claude Code e Codex sono temporaneamente gratuite secondo la policy di fatturazione ufficiale. La fatturazione per tali chiamate inizia il 31 ottobre 2026 alle 16:00 UTC, equivalente al 1° novembre a mezzanotte a Pechino. Questa esenzione limitata non rende gratuite tutte le richieste standalone alle API Search e Fetch.
DeepSeek V4.1-Flash-1017 è sempre più veloce ed economico?
No. Il test su due task di EmpirioLabs ha rilevato tempi e uso di token di output inferiori per un’animazione di acquario, ma valori più alti per un’animazione skyline:
| Test di coding first-hand di EmpirioLabs | Rilascio di settembre | Aggiornamento del 17 ottobre | Risultato osservato |
|---|---|---|---|
| Tempo completamento Aquarium | 162 secondi | 124 secondi | Aggiornamento di ottobre più veloce |
| Token di output Aquarium | 41,833 | 33,149 | Aggiornamento di ottobre ne ha usati meno |
| Tempo completamento Skyline | 163 secondi | 177 secondi | Aggiornamento di ottobre più lento |
| Token di output Skyline | 37,928 | 42,907 | Aggiornamento di ottobre ne ha usati di più |
Entrambe le versioni hanno prodotto animazioni funzionanti in questi test sulla piattaforma API di EmpirioLabs il 18 ottobre 2026. Ogni task ha utilizzato lo stesso prompt e ha richiesto un unico file HTML auto-contenuto con CSS e JavaScript inline, senza librerie o asset esterni. Entrambi i modelli sono stati eseguiti con impostazioni predefinite, thinking abilitato al budget predefinito e un limite di output di 65,536 token. Sono stati eseguiti in parallelo per ciascun task, con un tentativo per modello. I tempi coprono l’intera richiesta; i conteggi dei token di output, inclusi i token di ragionamento, provengono dai report di utilizzo API. Questi due esempi illustrano la variabilità dei carichi piuttosto che stabilire un ranking generale.
Come accedere a DeepSeek V4.1-Flash-1017?
- DeepSeek API ufficiale — Usare il nome del modello
deepseek-flashsu https://api.deepseek.com. - Pesi open — Scaricare da Hugging Face o ModelScope per il self-hosting.
- CometAPI — CometAPI aggiunge DeepSeek-V4.1-Flash-1017 Vedi dettagli del modello ID modello: deepseek-v4.1-flash-1017
Usa la DeepSeek API nativa
La guida rapida API di DeepSeek e CometAPI confermano che deepseek-flash ora serve la versione del 17 ottobre, con metodo di chiamata invariato.
Invia una richiesta di pianificazione di progetto tramite l’API con Python. Installa il pacchetto OpenAI per Python e imposta API_KEY nel tuo ambiente prima di eseguire l’esempio.
import os
from openai import OpenAI
client = OpenAI(
    api_key=os.environ["API_KEY"],
    base_url="https://api.deepseek.com",# https://api.cometapi.com/v1
)
response = client.chat.completions.create(
    model="deepseek-v4.1-flash-1017",
    messages=[
        {
            "role": "user",
            "content": (
                "Design a small issue-tracking application. "
                "Give the data model, implementation plan, "
                "and acceptance tests."
            ),
        }
    ],
)
print(response.choices[0].message.content)
Questo produce una risposta del modello. Per costruire e convalidare un progetto automaticamente, un ambiente agent deve inoltre fornire accesso ai file, esecuzione di comandi, feedback dei test e autorizzazioni adeguate.
CometAPI Raccomandazione: CometAPI elenca già vari modelli DeepSeek ed è un ottimo modo per provare V4.1-Flash-1017 insieme a Claude, GPT, Gemini, Grok e modelli specializzati per coding/visione senza vendor lock-in. Registrati e ottieni una chiave API, quindi punta il tuo SDK OpenAI esistente alla base URL di CometAPI. Questo approccio è particolarmente potente per i framework di agent che traggono beneficio dall’instradare diversi sotto-task verso il modello più conveniente o performante disponibile.
Conclusione
DeepSeek-V4.1-Flash-1017 rappresenta un salto intelligente ed efficiente nelle capacità di AI aperta. Migliorando le prestazioni in benchmark critici di agenticità e coding riducendo al tempo stesso la lunghezza degli output e i tempi dei task—a prezzi bassi invariati—rafforza la posizione di DeepSeek come leader nella corsa prestazioni-per-dollaro. Che tu stia costruendo agenti software autonomi, applicazioni multimodali o sistemi di produzione ottimizzati per i costi, questo modello merita una valutazione seria.
Insieme a layer di accesso comodi come CometAPI, gli sviluppatori possono integrare modelli all’avanguardia come V4.1-Flash-1017 in workflow robusti e multi-provider con attrito minimo. Man mano che emergono valutazioni indipendenti e maturano gli strumenti dell’ecosistema (Harness, CodeBuddy, ecc.), aspettati che questo checkpoint diventi una scelta di default per molti carichi ad alto volume e alta intelligenza nella fine del 2026 e oltre.